ARTICLE · 1300089
DensityAI 深度解析:Dojo 天团出走,要把 AI 算力「密度」做到极致
一、这家公司什么来头?
DensityAI 于 2024 年成立于美国加州山景城,创始人 Ganesh Venkataramanan 是前特斯拉硅片负责人、Dojo 超算项目的灵魂人物。2025 年 8 月特斯拉收缩 Dojo 项目后,超过 20 名 Dojo 核心工程师跟随老领导集体出走,其中包括联合创始人 Bill Chang(Dojo 首席系统架构师,曾主导全球首个量产级晶圆级封装技术)和 Ben Floering。
- 定位:面向机器人、自动驾驶和大规模 AI 推理/训练的数据中心 AI 计算基础设施
- 规模:71 人左右的精干团队,尚无公开产品(stealth 模式)
- 资本:投资方包括 imec.xpand、Dolby Family Ventures 等;2026 年 9 月传出正洽谈接近 100 亿美元估值 的新一轮融资
- 传闻:2026 年 4 月特斯拉披露的「最高 20 亿美元收购一家 AI 硬件公司」交易,业界普遍猜测对象就是 DensityAI(未获官方确认)
一句话总结:这不是一家「AI 应用公司」,而是一家从芯片到数据中心垂直整合的算力基础设施公司。
二、产品与技术:核心是「带宽」和「密度」
DensityAI 的技术路线可以概括为一个判断:AI 算力的瓶颈已经不是算力本身(FLOPS),而是数据搬运(带宽与内存墙)。参考 Dojo D1 芯片的设计理念,他们把火力集中在三处:
1. 新型内存架构
针对大模型推理中「权重搬运耗电、耗带宽」的痛点,DensityAI 围绕一种全新的内存架构设计 AI 加速器,目标是让数据在计算单元附近的驻留时间最大化,减少 HBM 与计算核心之间的无效往返。
2. 3D 堆叠与先进封装
延续晶圆级封装的工程经验,采用 3D stacking(三维堆叠) 把计算与存储在物理距离上压到极限——这就是「高密度」名字的由来。
3. 光互连(Optical Interconnect)
公开专利显示,DensityAI 正在布局微 LED 光互连与多层波导结构的光互连网络。当电互连在带宽密度和能效上逼近物理极限,芯片间/机柜间用「光」替代「铜」是业界共识方向,DensityAI 显然打算把这一层也做进自研体系。
三、优点与短板(理性看)
✅ 优点
⚠️ 短板与风险
四、性能跑分对比:为什么没有数字?
坦率地说:目前没有任何可信的公开 benchmark。公司处于 stealth 阶段,没有 MLPerf 提交记录、没有公开白皮书。
但这不妨碍我们做一张「路线对比图」——用架构理念对标同赛道玩家:
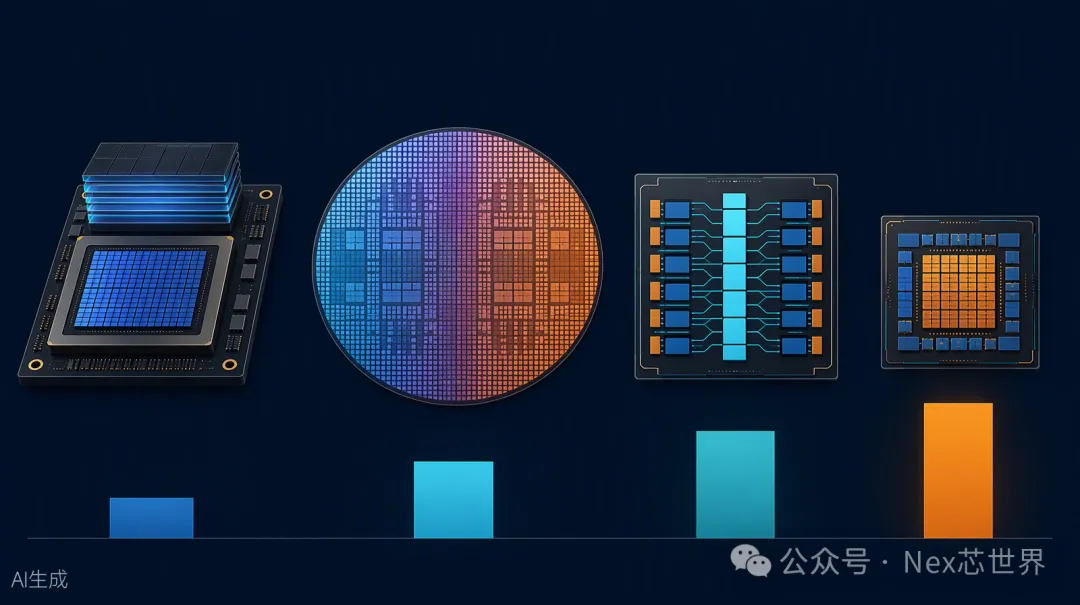
公司 | 核心路线 | 代表指标(公开数据) | 与 DensityAI 的关系 |
|---|---|---|---|
NVIDIA(GB200) | 通用 GPU + HBM + NVLink | Blackwell 机柜级 ~120 PFLOPS FP8 算力、~13.4 TB/s HBM 带宽 | DensityAI 要抢的「假想敌」,赢在生态 |
Cerebras | 晶圆级引擎(WSE-3) | 单晶圆 4T 晶体管、21 PB/s 片上带宽 | DensityAI 创始团队的「前作路线」直接继承者,最像的同类 |
Groq | 确定性数据流 LPU | 数百 token/s 级推理时延优势,HBM 用量极小 | 同样用「近存计算」思路绕开内存墙 |
Dojo D1(前作) | 晶圆级训练芯片 | 单芯片 362 TFLOPS BF16,片内带宽远超 HBM 方案 | DensityAI 团队亲手做过,相当于「Dojo 2.0 民间正统续作」 |
给读者的建议:对这类公司,与其盯着不存在的跑分,不如盯三个里程碑信号——① 首次流片/点亮公告;② 首个付费客户或 pilot 部署;③ MLPerf 或第三方复现的能效比数据。
五、工程师能从 DensityAI 学到什么?
即使不买它的芯片,这家公司的技术叙事也值得每个做 AI 系统的工程师咀嚼:
- 内存墙是新的主战场。大模型推理成本 ≈ 搬数据成本,学会算「每 token 的字节搬运量」比背 FLOPS 更重要。
- 近存计算的权衡艺术:SRAM 大、HBM 小、数据流确定的架构(Dojo/LPU 一脉)提示我们——硬件拓扑应当从「目标算子的数据流」反推,而不是先造芯片再适配模型。
- 光互连的工程化思路:微 LED + 波导不是实验室玩具,关注其专利中的封装集成方式(共封装光学 CPO 是必经之路)。
- 晶圆级设计的系统工程观:良率、供电、散热、测试在超大封装上是数量级更难的问题,垂直整合团队的意义正在于此。
- benchmark 方法论:未来判断这类芯片,用「每瓦 token 数(tokens/s/W)」「每美元 token 数」代替峰值算力,才不容易被 PPT 忽悠。
六、应用与采购注意点
如果你来自车企、机器人公司或数据中心,未来评估 DensityAI(或任何自研加速器厂商)时,请把这份清单贴在会议室墙上:
- 软件迁移成本:现有 PyTorch 模型能否零改动跑通?自研编译器对自定义算子的支持度如何?
- 精度和数值格式:是否原生支持 BF16/FP8?量化精度的损失有没有第三方验证?
- 供货与交付能力:晶圆级/3D 封装的产能爬坡周期极长,合同里要写清交付违约条款。
- 能效比实测:要求用你自己的模型、你自己的数据现场压测,只看「tokens/s/W 实测值」。
- 生态锁定风险:专有编译器 + 专有硬件 = 深度绑定,议价权会随时间流向厂商。
- 地缘政治与出口管制:团队成员与产线涉及美国出口管制(EAR/ITAR)相关岗位,跨境部署需提前做合规评估。
结语
DensityAI 的故事,本质上是「Dojo 团队不甘心」的故事:他们不相信 AI 基础设施只能靠堆更多 HBM 和 GPU 解决,于是用自己的名字向行业宣战——未来的算力竞赛,比的是密度,不是面积。
产品何时落地、跑分能否兑现,现在下结论都为时过早。但有一点可以确定:当一支亲手造过 exaFLOP 级晶圆级系统的队伍决定再来一次,整个数据中心行业都该认真听一听。