ARTICLE · 1302434
用国产AI读长文档和PDF:先要结构,再要出处,最后自己核对
下班前,领导发来一份几十页的制度文件,或者一份行业报告、一份合同,让你“先看看,下班前说说要点”。文件在手机里,翻到一半就眼花;想复制到聊天框,又太长。这个场景,很适合让国产AI先帮你读一遍。
前面聊过AI工具总览、DeepSeek网页版办公入门、写周报、做PPT、改简历,也讲过把常用口令做成模板。这篇往下走一层,专门讲怎么读长文档:AI会漏读,也会说错,所以要让它标出处,自己再回原文核对。
全文分两部分:先讲零基础上手的四步,再讲常见的坑和进阶用法。各家界面经常更新,入口和限制以你实际看到的为准;文中示例文档为虚构,只用来演示怎么问。文中截图为作者实际操作截图,示意图为自制示意。
一、零基础上手:四步读完一份长文档
读长文档,不建议上来就问“帮我总结一下”。总结很容易,漏了什么你也不知道。更稳的顺序是:先让AI交出结构,再沿着结构问细节,每个细节都要出处,最后自己抽查。
第1步:先把文件准备好
在传文件之前,先把自己的需求想清楚:这次是要找要点、查条款,还是做对比?给谁看?要一段话,还是列清单?需求越清楚,后面的口令越好写。
再确认文件能选中文字。在电脑或手机上打开PDF,试着选中一段正文。能选中、能复制,通常说明有文字层;怎么点都只是一整张图,多半是扫描件或拍照件。
能选中文字的文件,AI读起来通常更稳。扫描件怎么处理,后面“踩坑”部分会单独讲。如果某种格式传不上去,可以另存为PDF或常见的Word格式再试。
上传前,把不该外传的内容处理掉。身份证号、银行卡号、手机号、签名页,公司未公开的数据、客户名单、内部报价,能删就删,能打码就打码。只问条款,就别把带个人信息的附件一起传。另存一份“干净版”,不要改原文件。
可直接复制的口令:
我准备上传一份【文件名称】,大概【页数或篇幅】。我是【你的身份】,这次主要想弄清楚【你的目标,比如:报销流程有哪几步、合同里我要承担哪些责任】。请先记住这个目标。等我上传后,先给结构概览,不要展开细节,也不要提前下结论。
第2步:上传,先要一份“目录式概览”
以DeepSeek网页版为例,地址是chat.deepseek.com。点输入框旁的附件按钮,或者把文件直接拖进输入框。作者2026年11月2日实测时,鼠标停在上传按钮上,提示写的是“上传文件,支持各类文档和图片 / 最多 50 个,每个 100 MB”。界面会更新,以你看到的为准。文件传上去后,等界面提示解析完成再提问;没解析完就追问,容易得到半截答案。
也可以用Kimi。Kimi官方帮助中心写明,支持PDF、Word、Excel、PPT、图片、TXT、视频等常见格式,单个文件不超过100MB,单次上限50个文件。这是官方帮助页写的数字,实际以你看到的界面为准。
这一步要的不是内容,是结构。让它先列目录,每部分一句话,不确定的标“原文未写明”。这样你能看出它有没有读全。
可直接复制的口令:
请先不要总结全文。请按文档原来的顺序列出结构,列到一级标题即可;每个部分用一句话说明主要讲什么,不要展开。遇到看不清、缺失或你不确定的地方,写“原文未写明”,不要猜。列完后告诉我:你实际读到了文档的哪一部分,最后一段大概是什么内容。如果文档本身有目录,请对照目录检查有没有漏掉的部分。
拿到概览,先对照原文目录看章节对不对。如果它列出原文没有的章节,或者漏了后面的章节,先别问细节,重新上传或换个问法。
第3步:带着问题追问,让每个结论都有出处
有了结构,再问具体问题。一次问一个,不要一口气列十个。问题越具体,越不容易被套话糊弄。
比如不要问“报销制度怎么样”,而是问“出差住宿的报销标准是什么,超标了怎么处理”。再把关心的角度带上:是流程、金额、责任,还是时间节点。
关键动作:每个结论都要标章节或页码,并引用原文一句话。页码要说明是PDF阅读器显示的页码,还是文档印刷的页码,这两个有时对不上。
可直接复制的口令:
请只回答下面这个问题:【你的问题】。回答时遵守三条:1)每个结论后面,标出依据所在的章节名或页码;2)每个结论引用原文一句话,用引号括起来;3)原文没有写的,直接写“原文未写明”,不要根据常识推测,也不要把其他文件的内容补进来。如果同一件事在文档里有不止一处说法,请都列出来,分别标明位置。
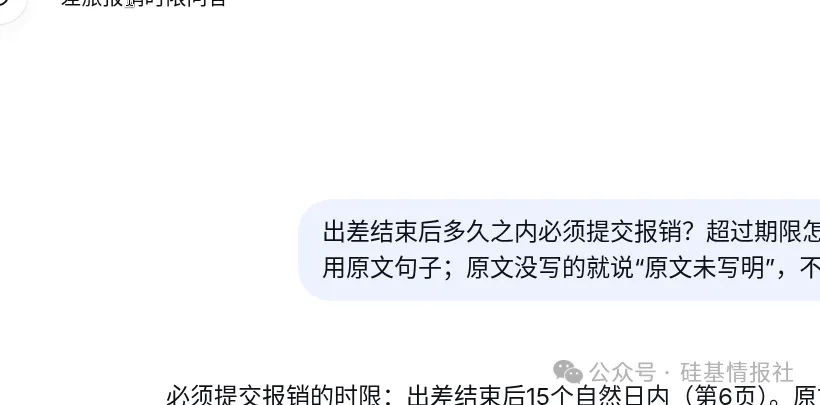
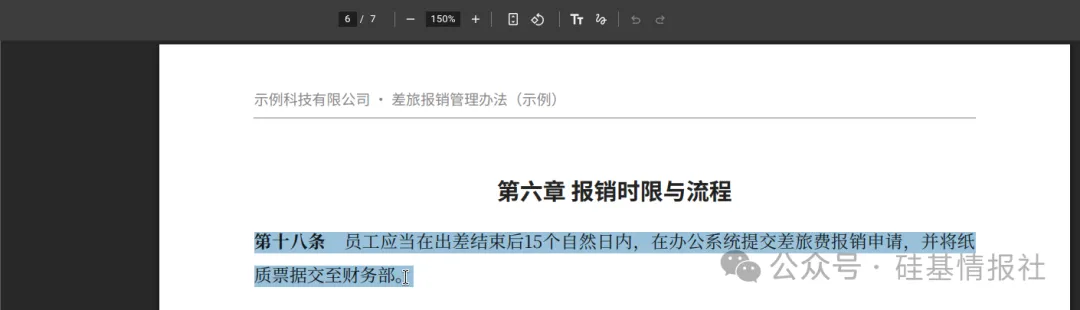
作者用一份7页的虚构报销制度试过,问“出差结束后多久内要提交报销、超期怎么办”,它给出了第6页,并原样引用了第十八、十九条,回原文核对,这次页码和引文都对得上。但这只是一次示例,文档更长、或是扫描件时,页码和引文仍可能对不上,下一步的核对不能省。网页回答下方也有一行“内容由 AI 生成,请仔细甄别”的提示。
如果它只给概括、没有引原文,就追一句:“请把支撑这个结论的原文句子找出来,并标出页码;找不到就说明找不到。”愿意回去找,说明还有得核对;开始绕圈子,这条就要打问号。
第4步:自己回原文核对
这一步不能省。AI给的页码和引文是线索,不是让你直接相信的答案。
优先核对四类:数字、日期、金额、责任条款。按页码打开原文,找到那句话,前后各看一段。确认三件事:引文是不是原文真有;数字和单位有没有被改;主语和条件有没有被换。特别是“可以”和“应当”、“不超过”和“不少于”、“包含”和“不包含”,很容易在转述时被说反。
对不上,就把页码和疑问一起丢回去,让它重新定位。不要问“你是不是错了”,而是问“请重新在全文里找,找不到就说找不到”。
可直接复制的自查口令:
请把你上面所有结论逐条列成一份核对清单,每条包含:结论、依据的章节或页码、原文引用、你对该条的把握程度(高/中/低)、需要我人工确认的地方。不要新增结论,也不要修改之前的说法。找不到原文依据的,单独列在“未找到原文”下面。
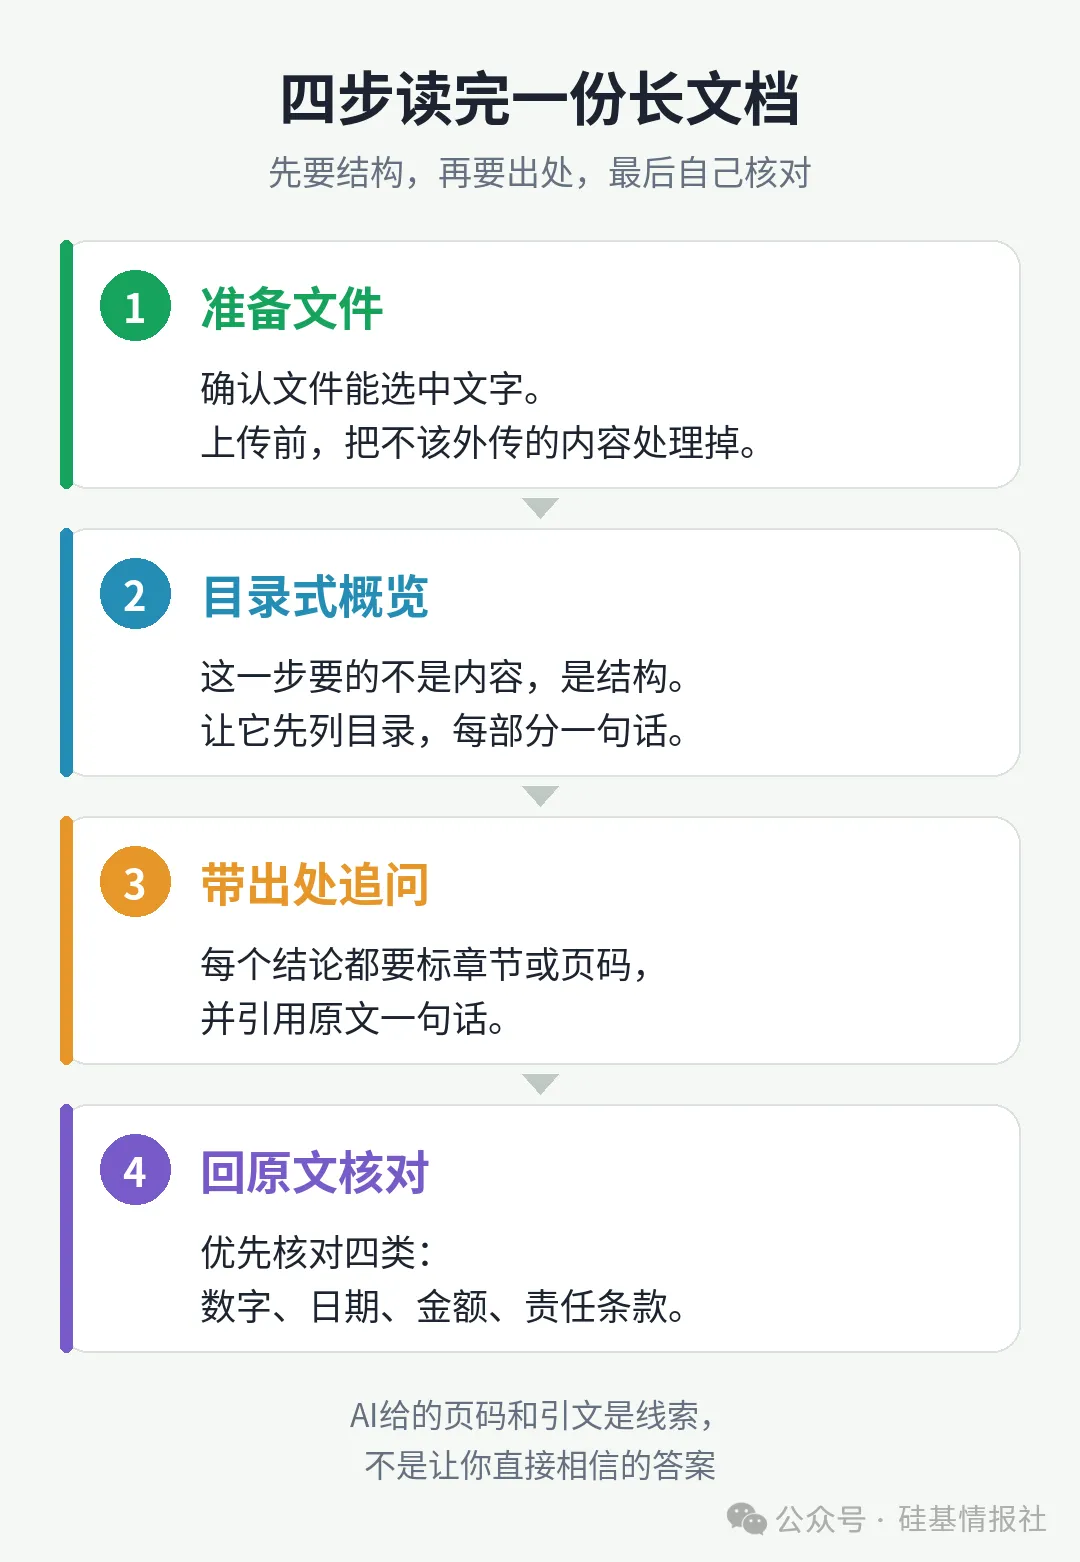
四步走完,你手里应该有一张结构图、几条带出处的结论、一份自己核对过的清单。再写汇报、做判断,会踏实很多。
二、踩坑和进阶
1. 扫描件、拍照件读不出来,怎么办
扫描件和拍照件本质上是图片。DeepSeek网页版的上传提示写的是支持文档和图片,但扫描件能识别成什么样,取决于清晰度、排版和工具本身。稳妥的做法仍是:先用文字识别功能把需要的页面转成文字(不少手机相册、截图工具都带“提取文字”一类的功能,名称和位置以你的设备为准),再粘到新文档里上传。
转完要校对。常见错字:0和O、1和l、未和末、已和己、人和入、元和无。数字、日期、金额、姓名、公司名要逐字看。制度里的“工作日”和“自然日”,合同里的“定金”和“订金”,错一个字,意思可能就变了。
2. 文件太长,AI可能只读了前半部分
AI一次能“看”的内容有上限。超过上限,就可能出现后半部分没读到、或者只读了一部分的情况,而它不一定会主动告诉你。Kimi官方帮助中心写明,其K2.6模型的单轮上下文约为128K token,约5-6万汉字;其他工具的上限各不相同,以官方说明为准。这个量不算小,但上百页的报告、带附件的合同,仍可能超。
判断有没有读全,问两句:“你读到了哪一页或哪一章?”“文档最后一段大概是什么?”答得出来,说明至少碰到了结尾;答不出来,或开始含糊,就考虑拆分。
按章节拆,或按页码拆,比如“合同_第1到20页”“合同_第21到40页”,一个文件一次问。每段用同一套口令,要求标页码、引原文。最后汇总时,只用各段已经核对过的结论,不要让AI在汇总时自由发挥。
3. 两个文件对比,别让它“合并着说”
两版合同、两份报价、两个版本的制度,放在一起对比,也是读长文档时常遇到的需求。常见的问题,是AI把两份文件“揉”成一份说,最后分不清哪句话来自哪一份。
上传时把文件命名清楚,比如“合同_A版”“合同_B版”。提问时明确:逐条列差异,每条都要有A的出处和B的出处。某一份没写的,就写“该文件未写明”,不要默认两份一样。
可直接复制的口令:
我上传了两份文件:【文件A名称】和【文件B名称】。请逐条列出它们之间的差异,每条写清:差异点、A文件的写法及出处(章节或页码)、B文件的写法及出处(章节或页码)。只列确实不同的地方,相同的不用展开。如果某一份没有写到,写“该文件未写明”,不要默认相同。最后单独列出“可能影响判断的差异”,并说明理由,但不要给法律意见。
对比完,仍要回到两份原文各抽几条核对。金额、期限、违约责任、付款条件,这些地方容易“看串”。
4. 说得顺,不等于说得对
AI很会把话说圆。原文没写的,它可能顺着上下文补出来;你问得急,它也可能给一个听起来合理的答案。这不是它故意骗你,可以大致理解为:它擅长顺着上下文“接着往下说”,说出来的不一定都在原文里。
办法不是让它“保证准确”,而是让它交出处。每个结论后面要有章节或页码,要有一句原文。拿到引文,回原文搜一下,能搜到再往下看;搜不到,这条先放下。
也可以让它自己分类:“请把你接下来的回答分成三类:原文明确写了的、根据原文推断的、原文未写明的。三类分开写,不要混在一起。”这样一眼能看出哪些是文件里的,哪些是它加的。
5. 隐私这件事,上传前先想一遍
合同、病历、身份证、银行卡、公司未公开的资料,不要原样上传。先问三个问题:需要整份传吗?能不能只传相关几页?姓名、电话、账号、金额能不能先删掉或打码?
只问“对方有哪些责任”,可以去掉双方名称、金额、签字页,只留条款。只问“制度怎么规定”,可以把公司名、部门名、人名换成“某公司”“某部门”“某人”。替换后自己读一遍,别把关键条件也替没了。
上传前看清各家的用户协议和隐私设置,以你看到的版本为准。对话记录删除后数据怎么处理,各家说明不一样,以官方隐私政策为准。拿不准的文件,就不要上传;宁可自己摘几段文字去问。
豆包、通义等国产助手也有上传文件的入口,本文没有逐一实测,具体支持什么格式、能传多大、怎么处理数据,以各自界面和说明为准。
写在最后
用AI读长文档,难的不是“上传”这个动作,而是控制它的发挥:先要结构,知道它读了什么;再带出处追问,知道每个结论从哪来;最后自己核对,知道哪些能信、哪些要改。三步里少一步,省下来的时间,后面可能都要还回去。
这里是硅基情报社,用大白话聊AI工具和新鲜事。
参考来源
· Kimi 官方帮助中心「Kimi 能做什么?」(支持格式、文件大小和数量、上下文长度),2026年11月2日核对:https://www.kimi.com/help/others/capability
· DeepSeek 网页版入口:https://chat.deepseek.com
· DeepSeek网页版上传按钮提示、回答页码:作者2026年11月2日实测(示例文档为虚构)
本文仅为使用教程,不构成任何产品推荐。本文在AI辅助下整理,内容经人工核对。用国产AI读长文档和PDF:先要结构,再要出处,最后自己核对