ARTICLE · 1303742
《从源码搭建嵌入式软件框架》05|先统一接口:类型、错误码和句柄为什么重要
参数能装多大的数?返回
0是成功,还是没有数据?传进去的指针,谁来释放?🤔
这些约定没有说清楚,函数名字再整齐,也容易接错。
这次从三件小东西入手:类型说清数据,错误码说清结果,句柄挡住内部细节。
下文名称已通用化,示例保留接口形状与关键行为;公共声明和使用片段分开展示,不是完整的独立程序。
一、基础类型:先说清楚,这个数是什么
公共头文件集中定义了无符号整数、有符号整数、布尔值以及指针相关整数等类型。把部分名称通用化后,可以看到这样的定义:
typedef unsigned char byte_t;typedef unsigned short count16_t;typedef unsigned int count32_t;typedef signed int status_t;typedef unsigned char bool_t;
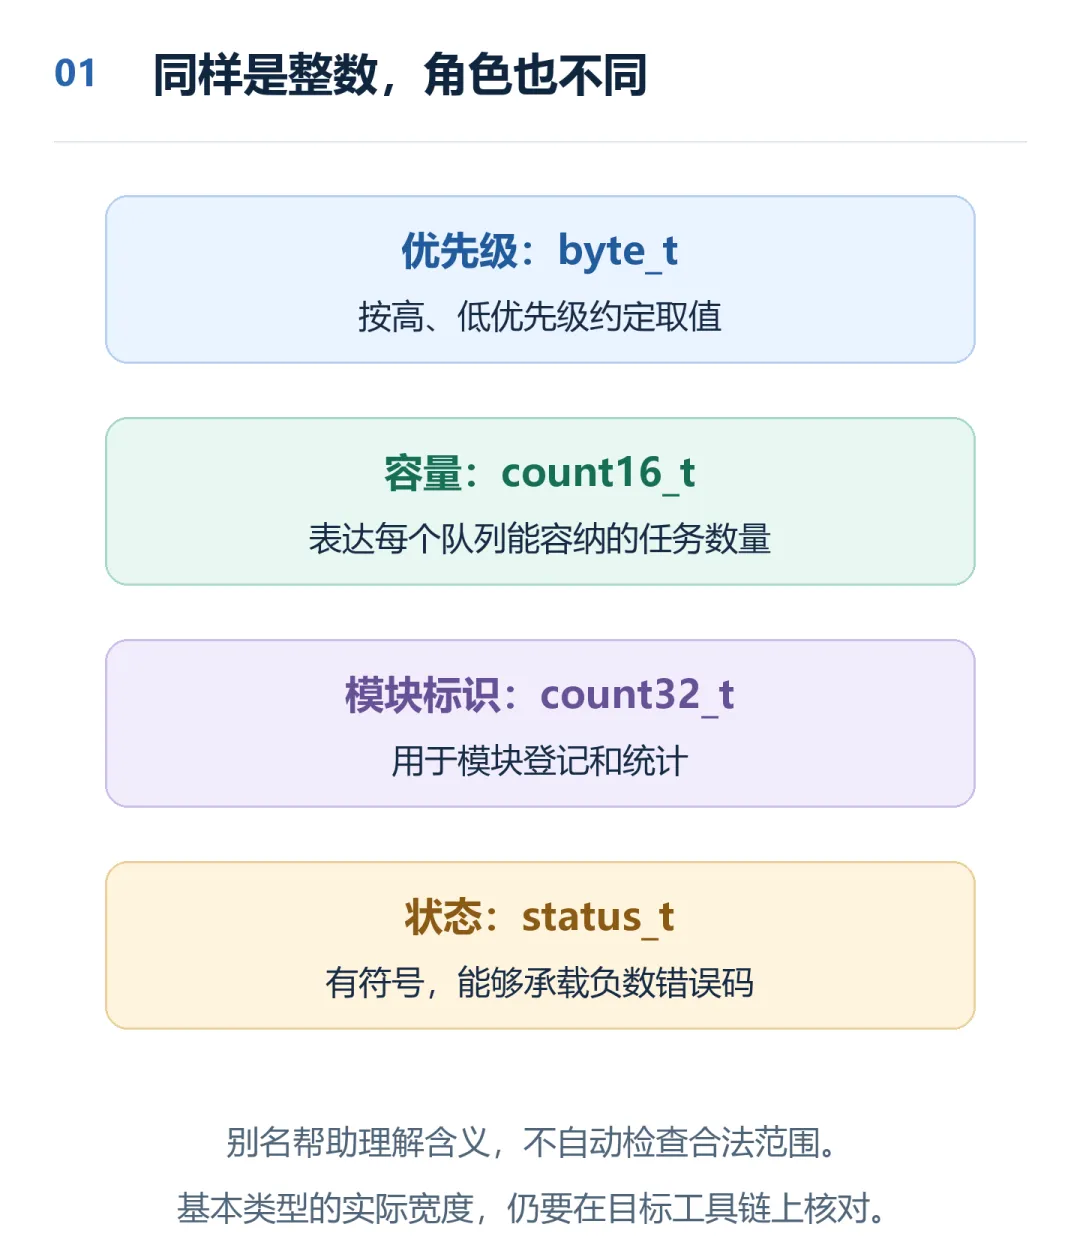
在对应目标工具链上,前三种分别用于表达 8、16、32 位无符号数,status_t 用于承载有符号状态值。
它们让接口的意图更容易看懂:
byte_t priority; /* 任务优先级 */count16_t queue_capacity; /* 每个队列的容量 */count32_t module_id; /* 模块标识 */status_t submit_status; /* 提交状态,可承载负数错误码 */
这里有两个边界:
别名不等于范围检查。 优先级用了一个字节,不代表这个字节里的每个数都是合法优先级。 别名不等于自动跨平台。 底层仍是 short、int等基本类型;换编译器、换平台,需要重新核对宽度。
指针相关整数也被单独区分,并随目标位宽选择定义。不要因为一个普通整数“看起来够大”,就拿它保存任意指针。
二、错误码:不能只告诉别人“失败了”
公共错误码给常见问题分了类别。例如:
0 | |
-100 | |
-101 | |
-200 | |
-210 | |
-500 |
调用方拿到这些值,才有机会区分“参数传错了”和“暂时没有资源”。
使用时应通过名字表达含义,不要到处抄数字:
#define STATUS_OK 0#define ERR_NULL_POINTER (-101)#define ERR_ALLOCATION_FAILED (-210)
但有一张公共错误码表,不代表每条调用链都完整保留了错误原因。
以任务提交为例:申请队列席位失败时,上层会把返回状态改为“分配失败”。
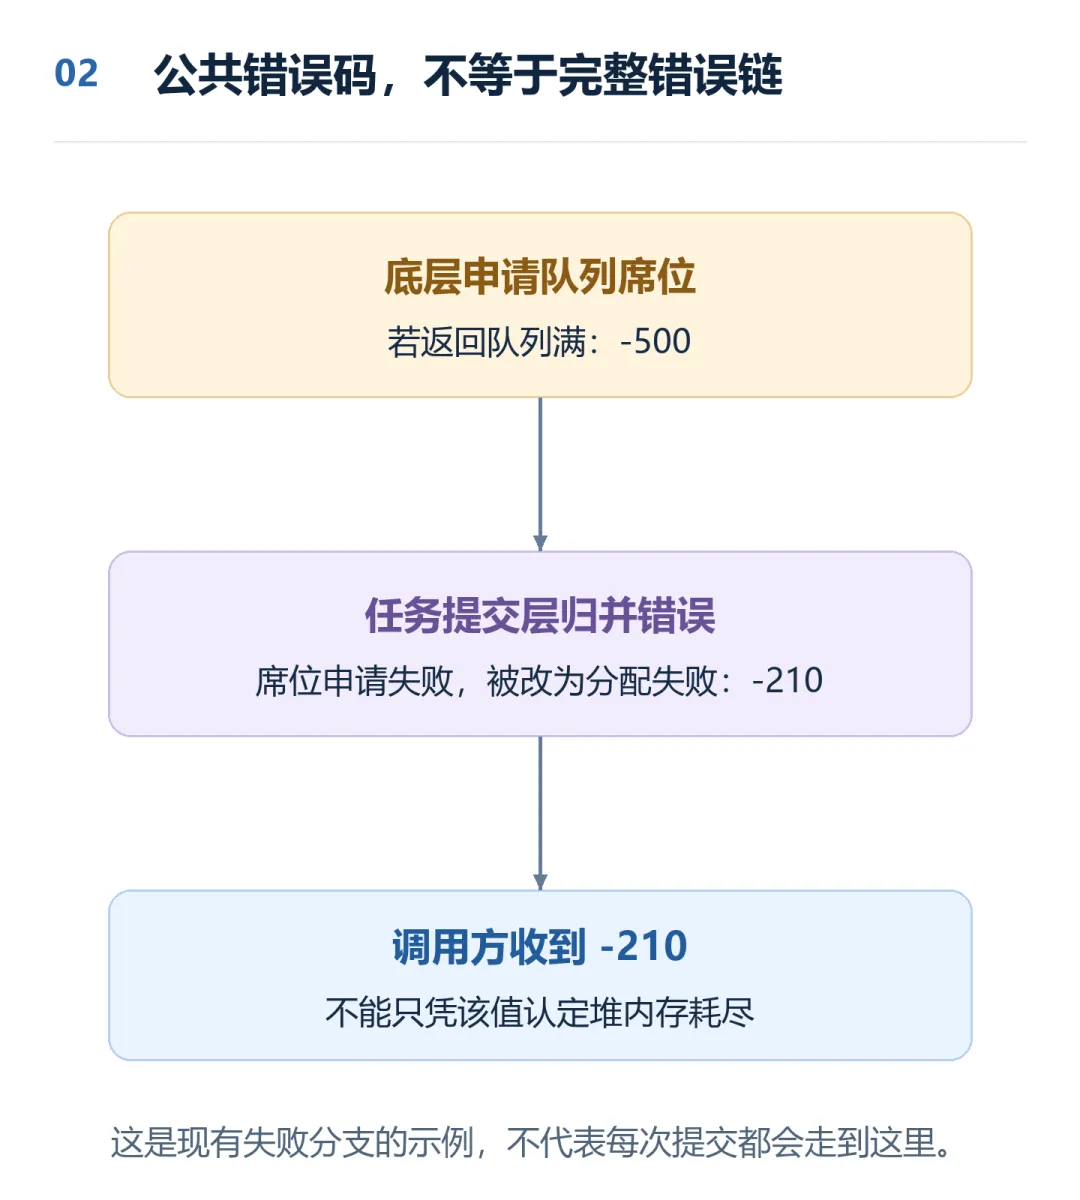
如果底层返回“队列满”,调用方最后可能只看到 -210,不能再仅凭这个值断定“堆内存用完了”。排查时还需要结合失败位置和日志。
专用模块也有自己的错误码段。统一的公共定义已经存在,但完整、一致的错误传递还不能想当然。
还要防止两种误判:
公共约定中存在“操作完成,但设备硬件退化”的正值告警,不能一律把非零当失败。 有个内存模式查询接口用 0表示动态内存、-1表示静态内存。此处-1是一种查询结果,并不表示查询失败。
所以,判断方法最终要服从具体接口的约定,不能只看数字的正负。
三、句柄:给你一个入口,不把内部结构交给你
任务执行环境对外提供句柄,通用化后是:
typedef void *executor_handle_t;调用方通过创建或查找取得它,再用它操作对象,不必知道内部线程、队列、锁和监控数据怎样排列。
例如,假设线程属性 thread_attr 已经配置好:
executor_handle_t worker = executor_create(16, thread_attr);if (worker == NULL) {/* 创建失败:此时不能继续使用 worker */return;}
这里的 16 是每个队列的容量。创建失败返回 NULL,它可能来自参数问题,也可能来自资源创建失败;只凭空句柄,不能拿到全部失败原因。
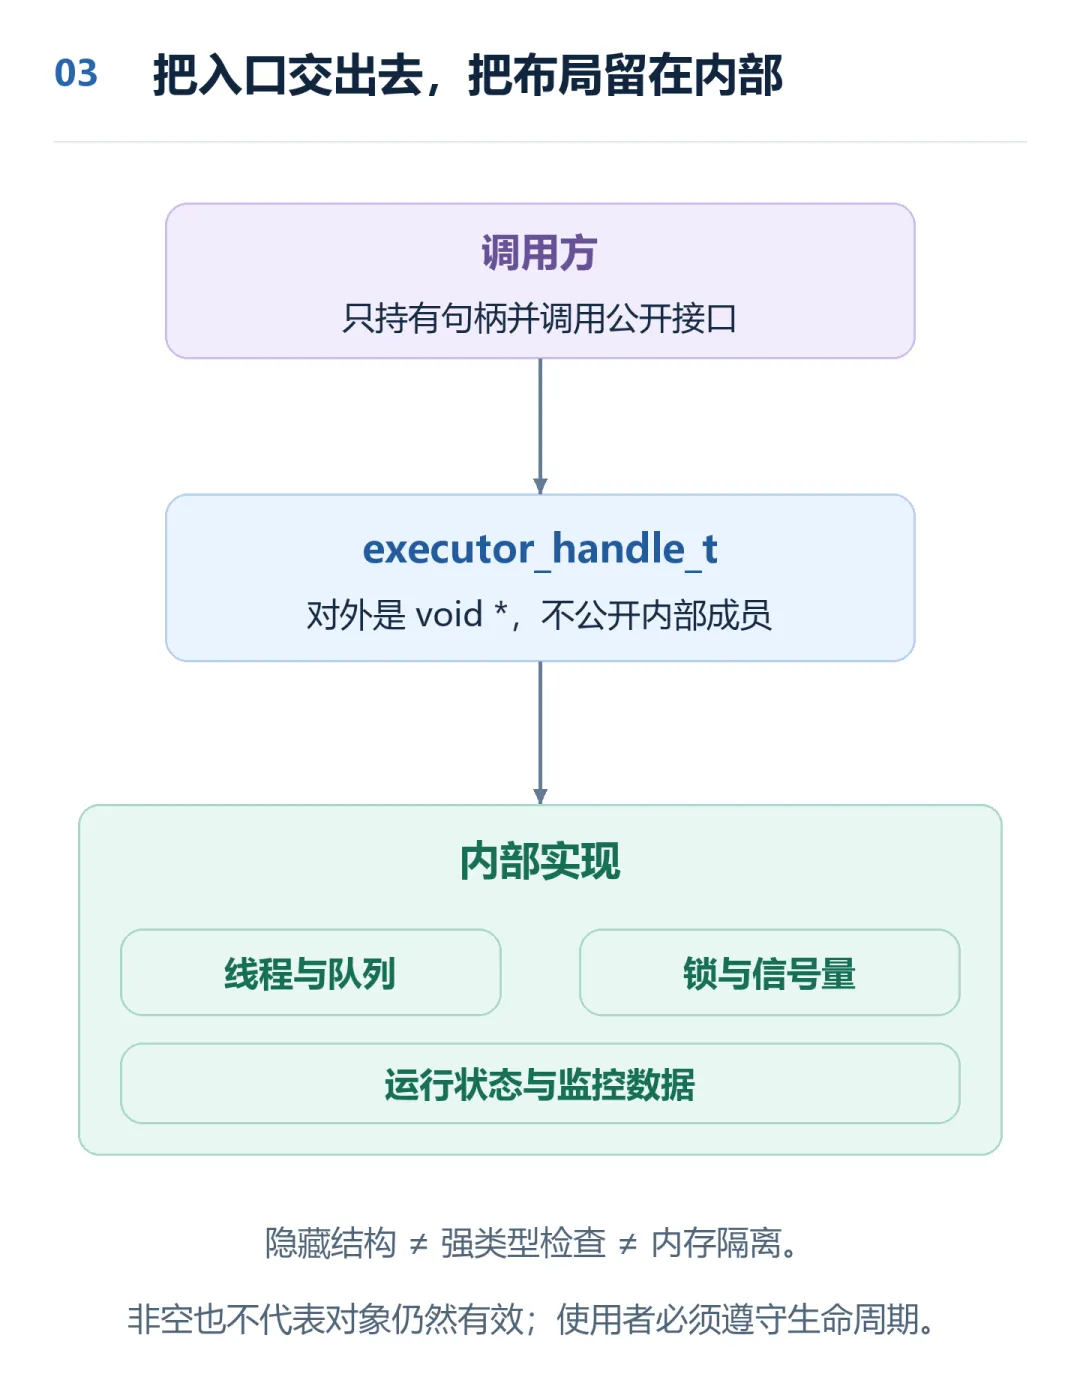
🔑 句柄像一把钥匙:你用它开门,不必知道锁芯里面有几片零件。
但这里的句柄本质上是 void *,也有代价:
多种句柄都用 void *时,编译器不一定能拦住类型混传。非空不代表对象一定仍然有效,销毁后的旧句柄不能继续使用。 它隐藏布局,不提供内存隔离,也不会自动管理生命周期。
四、读一个接口,要看清输入、输出和可选项
普通任务的描述很简单:执行哪个函数,以及把什么参数交给它。
/* 示例用标准 intptr_t 表达随平台选择的任务返回值类型。 */typedefintptr_t(*job_fn_t)(void *arg);typedef struct {job_fn_t func;void *arg;} job_t;
任务提交接口则形如:
status_texecutor_run_job(executor_handle_t executor,byte_t priority,count32_t module_id,job_t *job,joback_t *joback);
joback_t 是公共头文件提供的回执描述类型。把参数逐个翻译,就很清楚:
executor | |
priority | 0、1 |
module_id | 0 不登记、不统计 |
job | |
joback | NULL |
目的地由句柄指定,不是由module_id指定。只提交普通任务时,job 不能省略;job 和 joback 同时为空,会返回空指针错误。
对这个提交接口,0 表示提交成功,非零表示提交失败。
void *arg 也不是“什么都不用约定”。提交方和执行函数仍要知道它指向哪种数据,以及这份数据能活多久。
五、具体一点:异步打印任务编号 42
下面假设执行环境已经准备好,并在任务处理完前保持有效。示例需要标准头文件 、、 以及前述公共声明。
先定义参数与执行函数:
typedef struct {count32_t task_id;} print_param_t;staticintptr_tprint_task(void *arg){print_param_t *param = arg;printf(”任务编号:%u\n”, (unsigned)param->task_id);free(param); /* 本例约定:任务执行后释放参数 */return STATUS_OK;}
再提交任务:
status_tsubmit_print(executor_handle_t worker){print_param_t *param = malloc(sizeof(*param));if (param == NULL) {return ERR_ALLOCATION_FAILED;}param->task_id = 42;job_t job = {.func = print_task,.arg = param};status_t rc = executor_run_job(worker, 1, 0, &job, NULL);if (rc != STATUS_OK) {free(param); /* 提交失败,仍由提交方释放 */}return rc;}
参数没有放在函数内的局部结构体里,是因为:任务提交接口只复制函数入口和参数指针,不会自动复制指针指向的数据。
局部的 job 描述可以在提交后结束生命周期;它指向的 param 则必须留给任务使用。
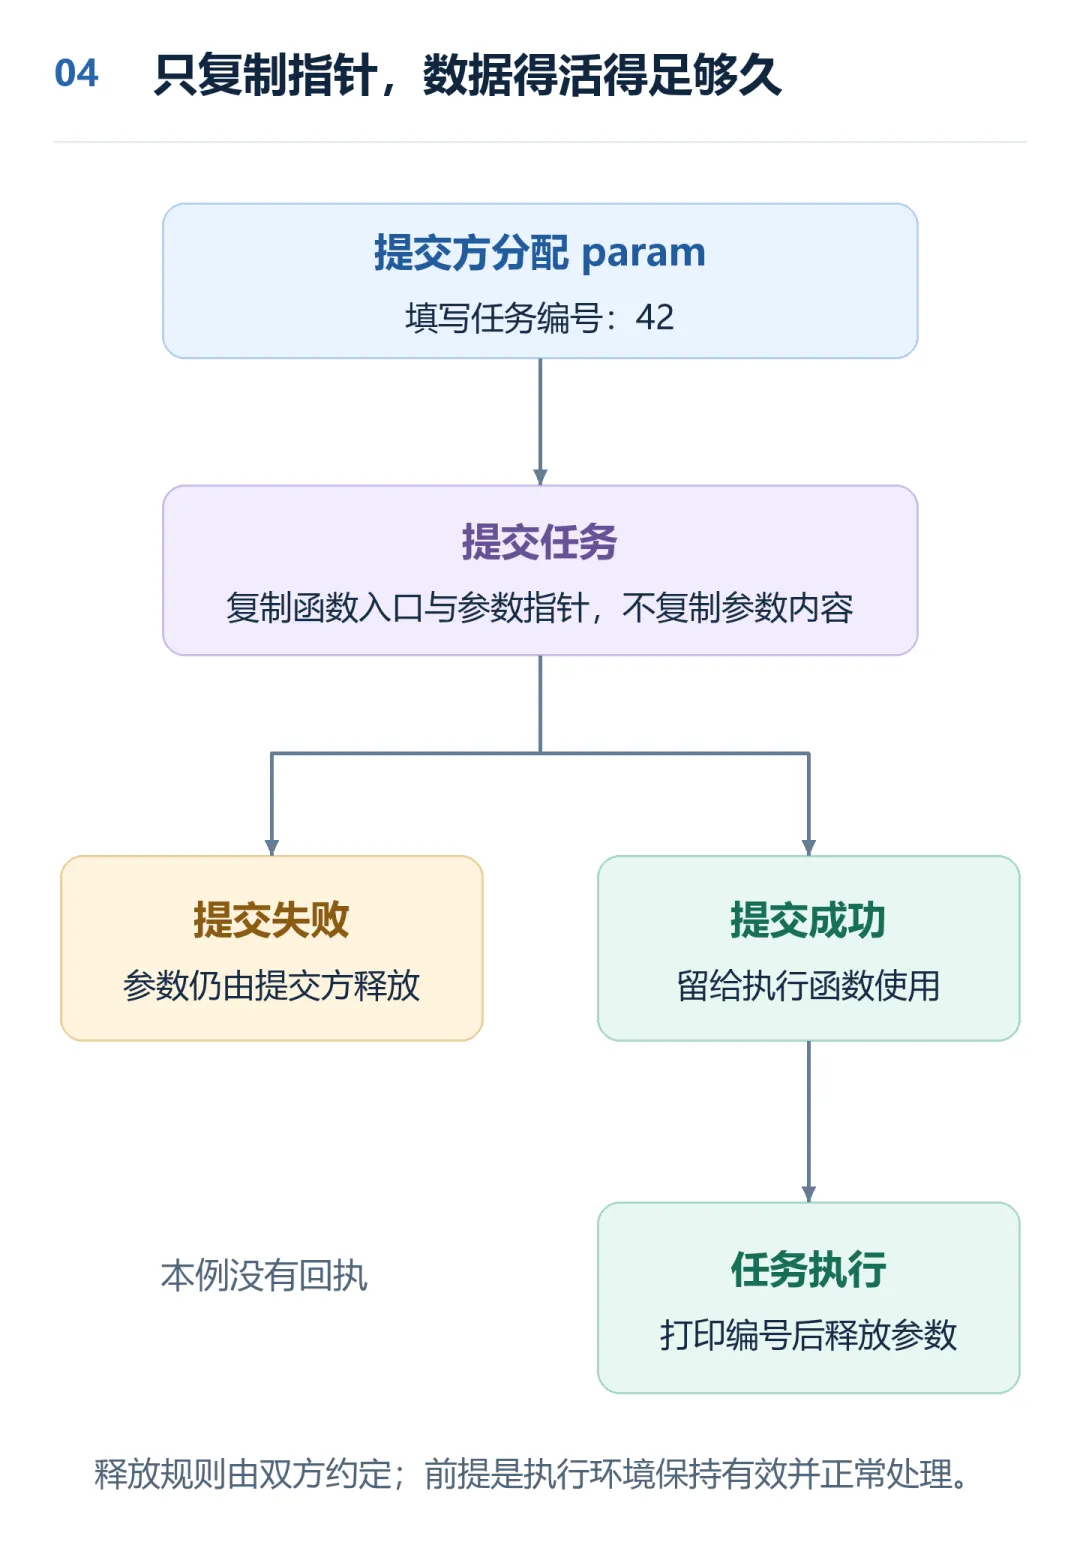
这里的释放规则是调用方与执行函数共同遵守的约定,不是框架看到 void * 就会自动完成的事情。示例也没有覆盖强制销毁执行环境时的清理问题。
六、返回成功,到底是哪一步成功?
上面的调用有两个不同的返回值:
executor_run_job()的返回值:这次任务提交是否成功。 print_task()的返回值:任务真正执行后产生的结果。
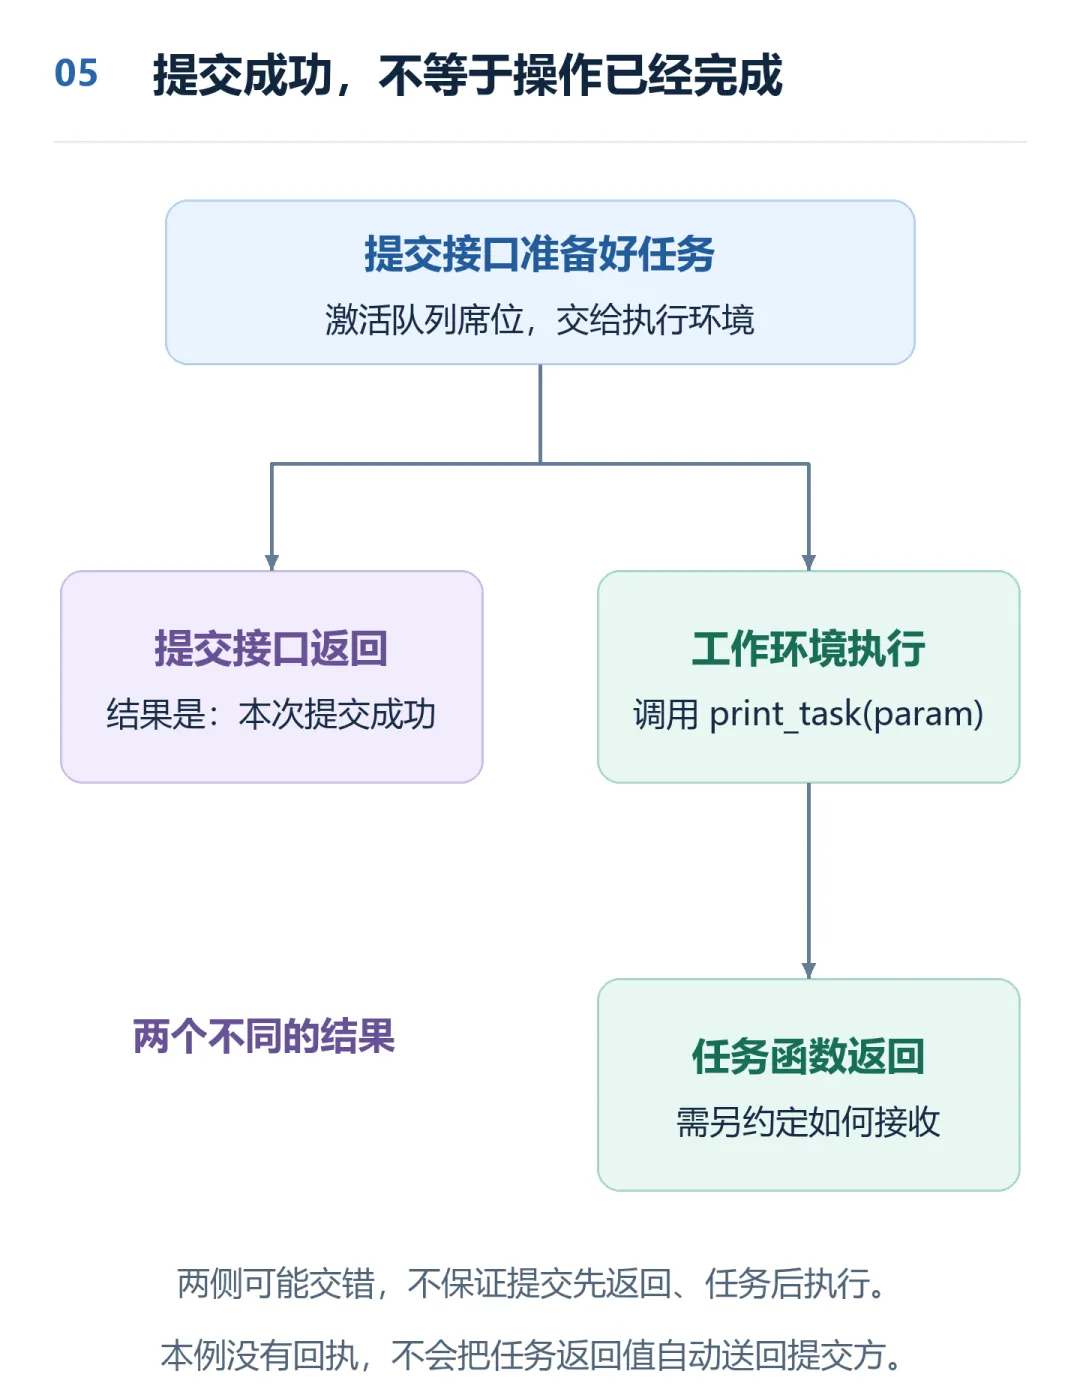
拿到提交成功,不能直接认定“已经打印了 42”。任务可能尚未执行,也可能已经执行;提交返回与任务执行可以交错发生。
这个例子没有提供回执,因此任务返回值不会自动送回提交方。需要最终结果时,应另外配置任务回执,不能把提交状态当成执行结果。
另外,异步执行不等于提交过程一定不等待:队列容量不足时,内部申请席位可能等待。
小结:统一接口,统一的是使用约定
类型让数据含义更清楚,错误码让问题更容易分类,句柄让内部实现可以藏在接口后面。
但要真正用对,还得说清:什么值合法、谁拥有数据、何时可以释放、返回成功代表哪一步。
这些约定,比给所有函数加上同一个前缀更重要。🙂
下一篇:换了操作系统,线程、锁和定时器都不同,为什么上层代码还能少改一点?我们沿着公共接口,去找真正干活的平台适配层。