ARTICLE · 1306085
微软把AI编程账单砍了23.6%:3694星TokenEconomizer我读完论文,两个组我劝别装
# 微软把AI编程账单砍了23.6%:3694星TokenEconomizer我读完论文,两个组我劝别装
先摆一个让我改了判断的数字:微软研究院和 UC Berkeley 上周放出的 TokenEconomizer,在 SWE-Bench 的 277 个任务上把 AI 编程的平均成本压了 18.4% 到 30.9%。看到这个数我先嘀咕了一句「又是实验室数据」,直到我翻到它的统计口径:5 组 agent 加模型的组合、6 个仓库、30 个仓库乘组合的格子里全部变便宜,而且成本算上了插件自己调模型的开销。我上个月刚拆过自己 504 块的 AI 编程账单,83% 是思考、超时重试、重复喂料这些「不干活的钱」,这个插件砍的正好是这三样。但把它的机制读完,我反而要先泼冷水:它省的钱来自「跨会话学习」,你要是每个任务都换仓库,它一分钱都省不下来。
口径先说清:TokenEconomizer,microsoft/TokenEconomizer,Apache-2.0,星数我按 11 月 2 日凌晨拉的 GitHub API 算是 3694 星,10 月 13 日建仓,13 个 open issues,最近一次推送 10 月 31 日。论文挂在 arXiv 2610.22732,作者是 Aaron J. Li 那一串 UC Berkeley 加微软研究院加微软安全的人,不是社区爱好者攒的玩具。
01
PART
先算三笔账:它到底砍掉了什么
SAVE
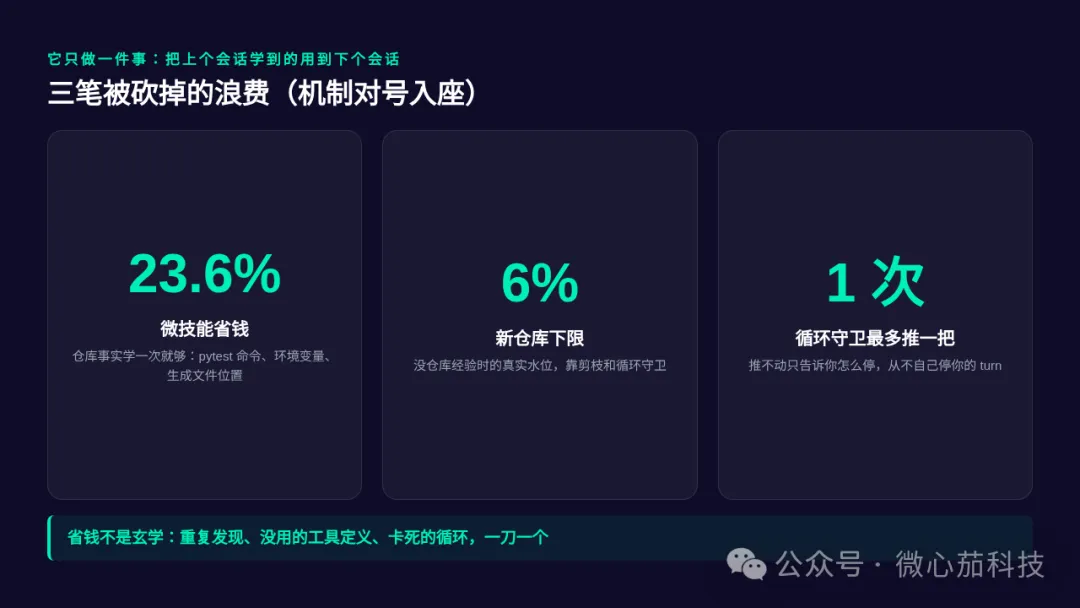
它的出发点跟我拆账单时的结论撞上了:coding agent 是为「干完活」设计的,不是为「省钱」设计的。每个 turn 你都在重复付三笔钱——指令重读、加载了但没用的工具定义、以及上文历史。你在同一个仓库里反反复复用同一个 agent,这三笔钱就反反复复地重复付。TokenEconomizer 不动模型、不动权重、不动 agent 本体,它只做一件事:把上一个会话学到的东西用到下一个会话。三个机制对应三笔浪费:
✨ 微技能(micro-skills):仓库里的事实只该被发现一次。python -m pytest 在这个仓库里才有用、某个命令要先设环境变量、生成文件在哪——这类事实从「跨会话重复的失败」和「每 3 个会话一次的模型复盘」里学出来,3 个会话确认过才写进会话开头,后来的会话反驳了就删掉。
✨ 工具剪枝(tool pruning):每个加载的工具的定义都随每次请求发出去。一个工具在 10 个 prompt、跨至少 2 个会话里都没被用到(或者连续 5 个会话没用到),就从后续会话里拿掉。一条命令能还回来。
✨ 失败循环干预(loop guard):一个 turn 反复撞同样的错,判定模型确认它卡住了(置信度 0.7 以上),就往上下文里加一句「换个思路试试」,一个 turn 最多推 1 次。推不动它只告诉你怎么停,它从不自己停你的 turn。
注意第三个机制的分寸感,这是我读完对这个项目好感度最高的地方:劝一句就收手,停不停是你的事。对比一下那些直接把 agent 杀掉重来的「省钱工具」,这个设计把决定权留在人手里。
02
PART
论文里的数字,我把口径核了一遍
MONEY
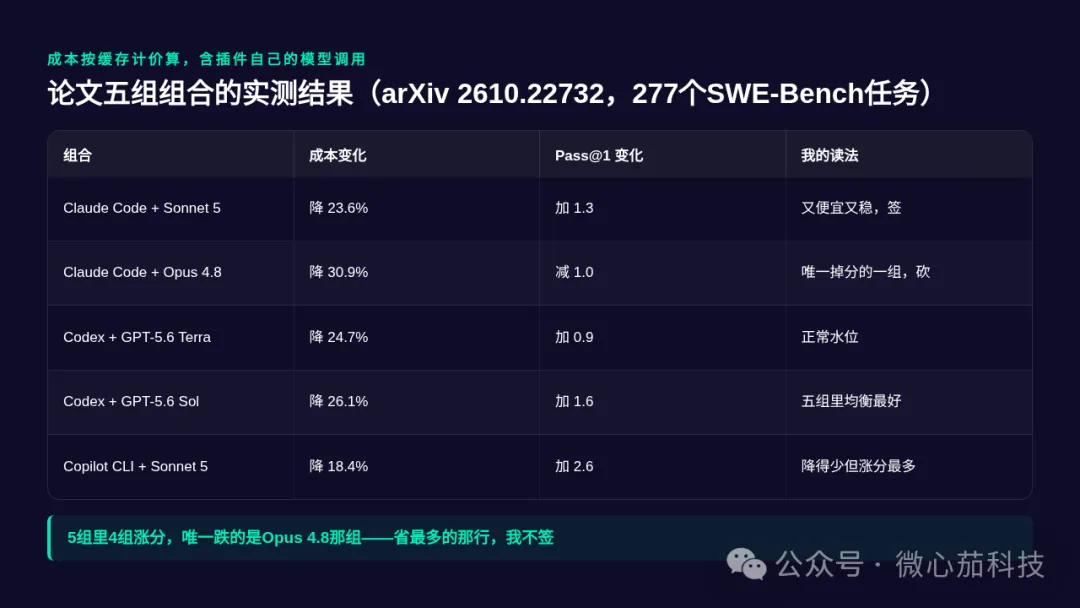
277 个 SWE-Bench 任务、6 个仓库、5 组 agent 加模型的组合,每个任务一个会话,同一个仓库的任务按顺序跑,从零开始学。成本按缓存计价算——这一点很实在,因为会话里大部分 token 是缓存重读,按原价算就是虚报节省。我把五组组合的结果摆出来:
| 减 1.0 | ||
5 组里 4 组 Pass@1 是涨的,唯一跌的是 Claude Code 配 Opus 4.8 那组,跌了 1.0。30 个仓库乘组合的格子里成本全部下降,单仓库单组合的降幅在 5% 到 40% 之间。另外两组验证也做了:Web-Bench 上便宜 16% 到 21%,两个安全审计类基准(特点是每个任务都在新仓库里)便宜 6% 到 20%。
等等,「每个任务都在新仓库」还能省 6% 到 20%?跨会话学习在新仓库里学不到东西,那省的是什么?我回头又看了一遍机制,想明白了:靠的是工具剪枝和失败循环干预,这两个不吃仓库经验。但 6% 这个下限也说明了没仓库经验时它的真实水位。这个数字我算完不信,又核了一遍论文的汇总页,没抄错。
03
PART
管理账:三分钟装完,但你要接受三件事
JUDGE
安装走各家的插件市场,以 Claude Code 为例,三条命令:
CODE
git clone https://github.com/microsoft/TokenEconomizer.git
claude plugin marketplace add "$PWD/TokenEconomizer"
claude plugin install tokeneconomizer@tokeneconomizer
装完跑 /tokeneconomizer:status 看状态块,每台机器再跑一次 /tokeneconomizer:toolprune refresh-catalog 把工具目录记下来。日常不用管它,它每个动作在会话里报一行。想动它的时候,命令在四个 agent 上同名,只是敲法不同:
CODE
/tokeneconomizer:status # 这个仓库里它学了什么、做了什么、花了多少
/tokeneconomizer:toolprune # 剪掉了哪些工具、证据是什么
/tokeneconomizer:toolprune restore # 还回来,且不会再被剪
/tokeneconomizer:config set microskills=on # 微技能默认是关的,要自己开
作为管过团队工具链的人,我签一个进团队主干前看三样东西:默认行为可逆、失败不拖累干活、管理成本可量化。它三条都占:事实被后来的会话反驳就删、任何一部分出错你的会话照常跑、学到的东西只存本机 ~/.tokeneconomizer。但有三件事你得先接受:
✨ 版本锁得很紧。Claude Code 只支持 2.1.300 到 2.1.310,Codex 0.153.1 到 0.164.0,Copilot CLI 1.0.83 到 1.0.102,Pi 1.2.0 到 1.3.0,新版本没测过。团队里 agent 版本一乱,就有人的插件在裸奔。
✨ 微技能默认关闭,因为它自己的模型调用也要花钱,省多少看仓库和工作性质。它的报告把这部分开销算进去,诚实,但也说明白了:不是开了就赚。
✨ 剪枝是「写 deny list」这种黑盒动作,落在各家自己的配置文件里(Claude Code 是 .claude/settings.local.json,Codex 是 .codex/config.toml,Copilot CLI 是整个 MCP server 不加载)。它只加自己的条目,不动你写的规则,还把自己创建的文件挡在 git 外面——这些细节都对,但排障的时候你要知道去哪看。
04
PART
我的判断:五种人,三种签两种砍
DECIDE
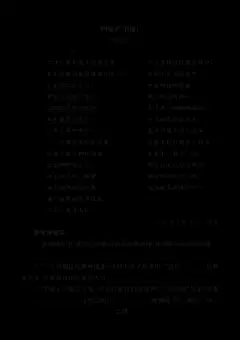
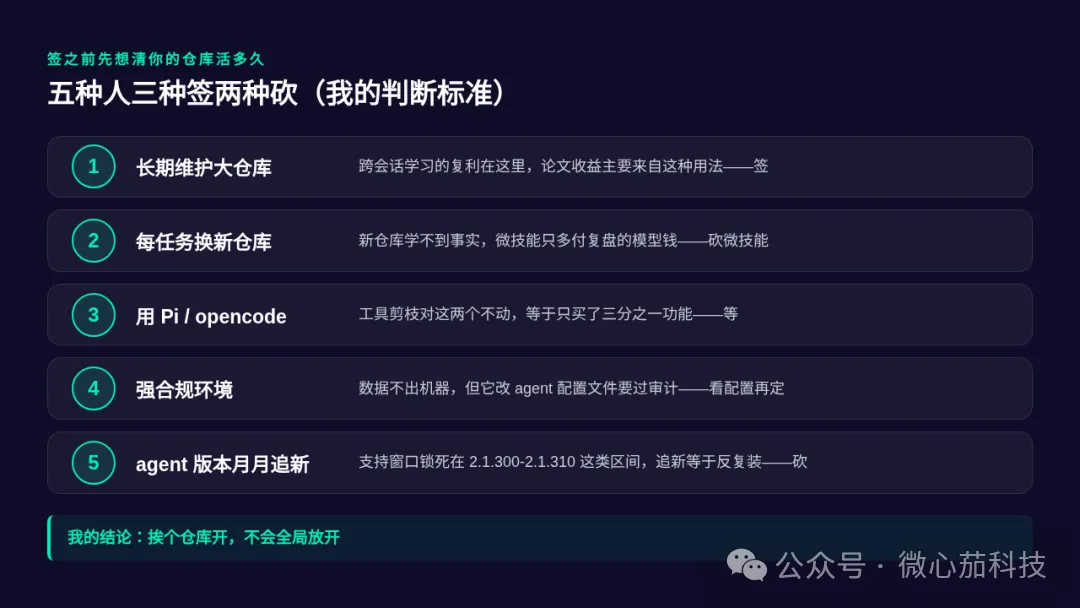
结论我先放前面:这个东西我会装,但我会挨个仓库开,不会全局放开。下面是我给团队的判断标准。
| 签 | ||
还有一句更不客气的:如果你的 AI 编程开销本来就低,别折腾它。省 23.6% 是乘法,基数小的时候,你花在盯插件上的时间比省下的钱贵。
05
PART
这篇给不了什么
EPILOGUE
我讲的都是论文口径和仓库文档的结论,没有在自己的大仓库里做长期对照,哪个机制贡献最大只有论文的拆解。基准里也没有中文代码库。
你那边 AI 编程的账单里,「不干活的钱」占几成?如果你也拆过一次账,评论区把你的数字摆出来,我下个月把我的实测对照也放进来。
你那边AI编程的账单里,「不干活的钱」占几成?
觉得有用,欢迎点赞、在看、转发
THANKS FOR READING