ARTICLE · 1315866
从零复现本地RAG文档问答系统:Ollama + BGE-M3 + Qwen2.5 3B实战|获取资料见末尾链接
从零复现本地 RAG 文档问答系统:Ollama + BGE-M3 + Qwen2.5 3B 实战
本文基于实测代码、演示文档和两张原始技术图整理,涵盖本地部署、RAG检索流程、问答实验与结果分析。
一、项目简介
本项目基于 GitHub 开源项目 rag-from-scratch-python 进行复现,主题是大语言模型应用中的检索增强生成(Retrieval-Augmented Generation,简称 RAG)。
项目实现了一个本地 PDF 问答流程:用户导入文档后,可以用自然语言提问;系统从文档中检索相关片段,再将片段和问题交给大语言模型生成回答,并显示命中的来源内容。
该项目关注的是如何把大语言模型接入外部知识,不涉及模型训练或微调。
二、项目功能
系统主要包含以下功能:
- PDF 文本提取
:使用 pypdf读取 PDF 中可复制的文字。 - 文本切分
:将较长的文档拆分为较小片段,默认每段约 800 个字符,相邻片段重叠约 100 个字符。 - 文本向量化
:使用 BGE-M3 将文档片段和用户问题转换为向量。 - 相关内容检索
:根据向量余弦相似度排序,选取最相关的片段作为回答上下文。 - 大模型生成
:使用 Qwen2.5 3B 根据检索到的内容组织答案。 - 来源展示
:输出答案的同时显示命中的片段及相似度分数,便于核对回答依据。
三、系统运行原理
系统分为文档入库和问题问答两个阶段。
文档入库阶段:PDF 经文本提取后被切分成多个片段;BGE-M3 为每个片段生成向量;文本、向量和来源信息随后保存在本地向量存储中。
问题问答阶段:系统将用户问题转换为向量,与已保存的片段向量计算相似度;按相似度取回前 4 个片段;随后将这些片段和用户问题组合成提示词,交给 Qwen2.5 3B 生成答案。程序最后返回答案和检索来源。
整个过程可以概括为:
PDF 文本提取 → 文本切分 → 向量编码 → 本地存储 → 相似度检索 → 大模型生成 → 返回答案与来源
项目系统流程图
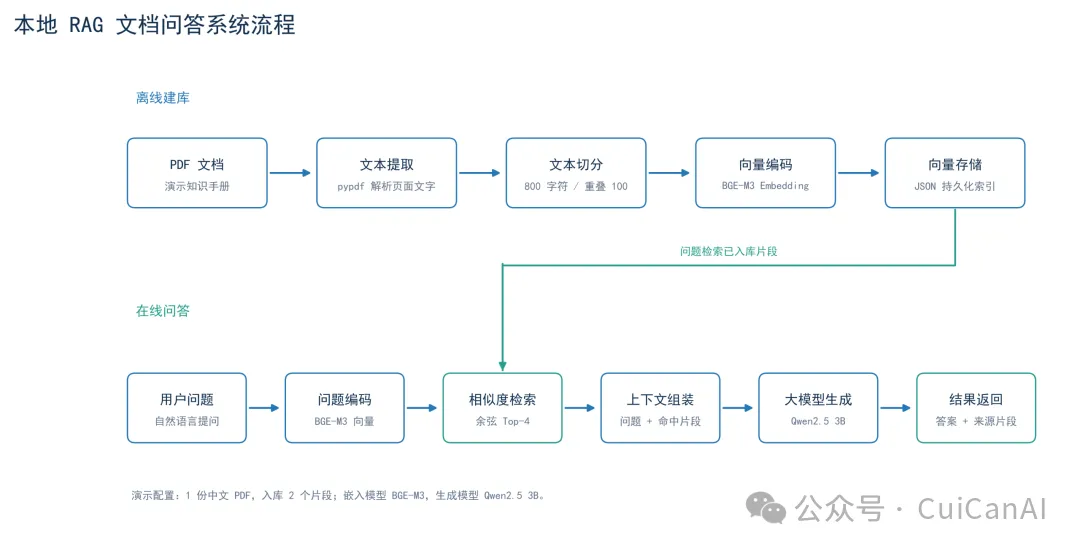
图1:离线建库及在线问答两条流程,涵盖PDF解析、BGE-M3编码、Top-4检索和Qwen2.5 3B生成。
四、复现环境与适配说明
操作系统:Windows Python:3.15.2 推理服务:Ollama 向量模型:BGE-M3 生成模型:Qwen2.5 3B 演示文档: demo_assets/星河智能客服_演示知识库.pdf
GitHub 原项目使用 ChromaDB,并在 README 中以 nomic-embed-text 和 llama3.2 作为默认模型。本次复现环境只有 Python 3.15,原项目的 ChromaDB 依赖无法正常安装,因此将向量存储适配为本地 JSON 文件,同时改用适合中文演示的 BGE-M3 和 Qwen2.5 3B。PDF 解析、切分、检索、提示词构造和模型生成的主要流程仍按原项目实现。
JSON 向量存储适用于本次小规模复现,不适合替代生产环境中的专业向量数据库。
五、复现步骤
在项目目录打开 PowerShell,确认 Ollama 服务可用,并已安装 BGE-M3 和 Qwen2.5 3B。若尚未下载模型,可执行:
ollama pull bge-m3ollama pull qwen2.5:3b
安装项目运行依赖:
.\.venv\Scripts\python.exe -m pip install -r .\requirements-reproduction.txt设置源码路径并导入演示 PDF:
$env:PYTHONPATH = "src"\.venv\Scripts\python.exe -m rag.cli --persist-dir ".\demo_assets\vector_store" ingest ".\demo_assets\星河智能客服_演示知识库.pdf"
导入成功后,可执行以下命令体验问答:
\.venv\Scripts\python.exe -m rag.cli --persist-dir ".\demo_assets\vector_store" ask "人工客服的服务时间是什么?"\.venv\Scripts\python.exe -m rag.cli --persist-dir ".\demo_assets\vector_store" ask "知识库多久更新一次?"\.venv\Scripts\python.exe -m rag.cli --persist-dir ".\demo_assets\vector_store" ask "扫描版 PDF 能直接导入检索吗?"
六、实际运行结果
演示 PDF 成功完成文本提取、切分和向量入库,共生成 2 个文本片段。之后使用本地模型完成了以下三条问答:
三条回答均与演示文档中的内容一致,并且终端返回了对应来源片段。上述结果来自单份演示文档和三条人工设计的问题,用于说明功能链路已跑通,不代表系统在一般问题集上的准确率或正式基准测试结果。
向量检索相似度可视化
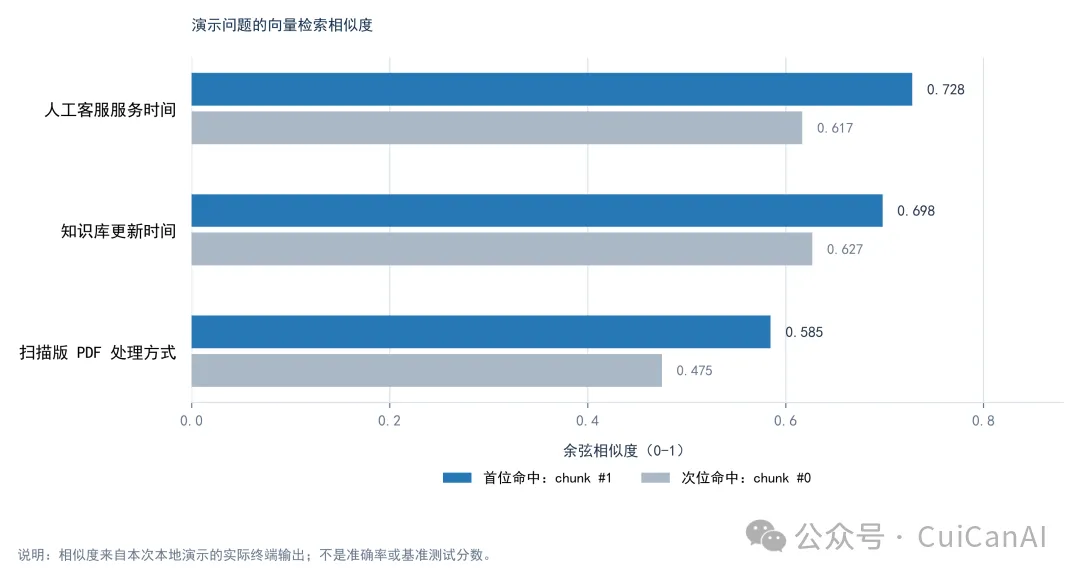
图2:三组问题的首位与次位命中相似度(分别为0.728/0.617、0.698/0.627、0.585/0.475),来自本地演示日志,不代表正式评测分数。
七、项目特点与限制
- 本地推理
:问题和文档内容通过本地 Ollama 模型处理,运行问答时不依赖云端大模型 API。 - 答案可核对
:系统展示检索到的来源片段,用户可以检查答案是否有文档依据。 - 输入类型有限
:当前读取的是 PDF 可复制文本;扫描图片型 PDF 需要先接入 OCR。 - 检索能力有限
:演示使用小型 JSON 向量文件和固定 Top-K 检索,未加入重排序、低相似度拒答阈值或系统化评测。 - 模型能力有限
:Qwen2.5 3B 适合本机演示,复杂问题上的回答质量仍受模型规模和检索内容影响。 - 演示数据为虚构
:星河智能客服的业务资料是专门制作的样例,不对应真实企业信息。
八、总结
本次复现完成了从 PDF 导入到模型回答的完整 RAG 链路,展示了大语言模型结合外部知识库进行问答的基本方法。项目适合作为理解 RAG 基础流程和本地大模型应用的入门示例。若继续扩展,可增加更多文档与问题样本,比较不同切分策略,并使用 Recall@K、答案忠实度等指标进行正式评估。
九、项目素材与复现资料
本次整理以 2026 年 11 月 5 日的原始项目素材为依据:
RAG文档问答.md | |
rag-from-scratch-python.zip | |
星河智能客服_演示知识库.pdf | |
2026-11-04 20-31-41.mp4 | |
注意:素材文件列出不等于已经提供公开下载地址。需要资源文件时可通过下方联系方式咨询;演示 PDF 的内容为虚构样例。
十、关于菏泽云澜元谱信息科技有限公司
菏泽云澜元谱信息科技有限公司专注于人工智能算法研发、科研实验技术服务、Python 软件开发与数据分析,为企业及研发团队提供定制技术解决方案。
八大技术服务方向
五大主营业务入口
- 人工智能算法开发
:计算机视觉、深度学习、医学 AI 和遥感应用。 - 科研实验与算法复现
:公开算法复现、模型改进、实验设计与验证。 - Python 软件开发
:自动化工具、算法软件和数据可视化系统。 - 大模型与 AI 智能体
:RAG 知识库、智能体、工作流、模型微调。 - 数据分析与智能预测
:数据清洗、统计建模、分类与回归预测。
项目咨询与商务合作
支持远程技术合作、定制开发与项目需求咨询。具体需求、周期与交付方式可根据项目协商。
官网与联系方式:https://wyj.life/docs/contact/#services