ARTICLE · 1324676
DIA-NN 引擎源码考古 · 1.7.12 · 第五回 · 干扰踢出局,定量端上桌 ~
上一回 《DIA-NN 引擎源码考古 · 1.7.12 · 第四回 · 打分不算完,越揉越靠谱 ~》,咱们把打分之后的下半场走完了:学权重、算 q 值、做校准,三个部件装进 process() 的循环里转了 12 圈。转完之后手里是什么?一份按可信度盖好戳的名单。
可小编在上一回收尾就留了话:分打完了,机器转完了,事儿还没完。先交代个前提:一次分析喂进来的往往不止一个数据文件,一个样本一次进样就是一个 Run,前面那套打分判峰是各个 Run 分头跑的,每个 Run 各出一份自己的定性结果、各量一份自己的定量数。可最后吐给用户的是一张总报表,得先把这几个 Run 的结果综合到一起。
综合之前,有两笔账得先结:名单里可能混着浑水摸鱼的,各个 Run 报出来的数字口径也还不齐。这一回就是这台机器吐出结果之前的最后一道工序,也是本系列主线的最后一棒,就是一道除渣工序,一套交账体系。
除渣,是把抢了别人信号通道的候选挤出局;交账,是把各个 Run 量出来的数拉平对齐,再从单条肽段一路算到蛋白和基因层,落成报表。写完这一篇,“怎么找、怎么判、怎么出定量结果” 这条三段路就走到头了。
本篇范围
这一篇只讲打分之后的收官:干扰怎么精修、定量怎么产出、报告怎么落盘。
起手:名单有了,账还没结
先对对账。前四回排下来的路是这样的:数据进门报到、建库下锅(第一回、第二回),一条候选找位置、认峰、打分、选峰(第三回),打完的分再折算成可信度,机器循环校表(第四回)。
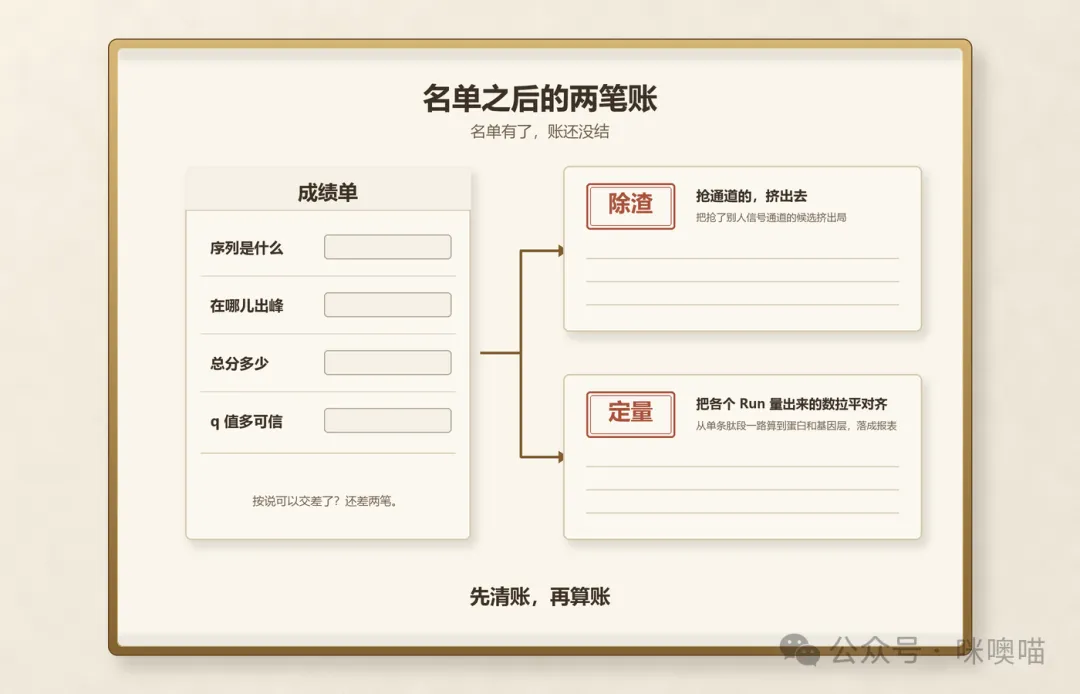
到这一步,每条候选都有了自己的成绩单:序列是什么、在哪儿出峰、总分多少、q 值多可信。按说可以交差了?还差两笔。
第一笔是浑水摸鱼的问题。干扰大体从哪儿来?跟几个文件没关系,就在单次进样内部、碎裂那一步:几条共洗脱的前体又落进同一个隔离窗(共隔离),被一起打碎,碎出来的信号天然叠在同一批碎片通道上,你中有我,分不开。于是一条候选顶着 “可信” 的戳,不代表它出的那个峰真是它自己的:同一次进样里两条不同的候选共用了一条信号通道,分数高的那条把光都占了,分数低的那条其实是在蹭信号,却也混进了名单。
第二笔是数字口径的问题。哪怕名单干净了,单条肽段的信号强度是各样本在自己的那次进样里分别量出来的:这个样本上样多、那个样本上样少,不同进样之间仪器的响应也对不齐。同一个肽段,样本 A 量出一个数、样本 B 量出另一个数,差距里混着技术差异,不拉平就没法比,拉平了才叫定量结果。
这两笔账就是本篇的两个主角。先清账,再算账。顺带垫一句:这是咱讲故事的顺序,引擎里这两件事其实咬合成环,精修的判据得先有数才算得出,清完账数字还要重算,后文会看到这环怎么转。
除渣:抢通道的,挤出去
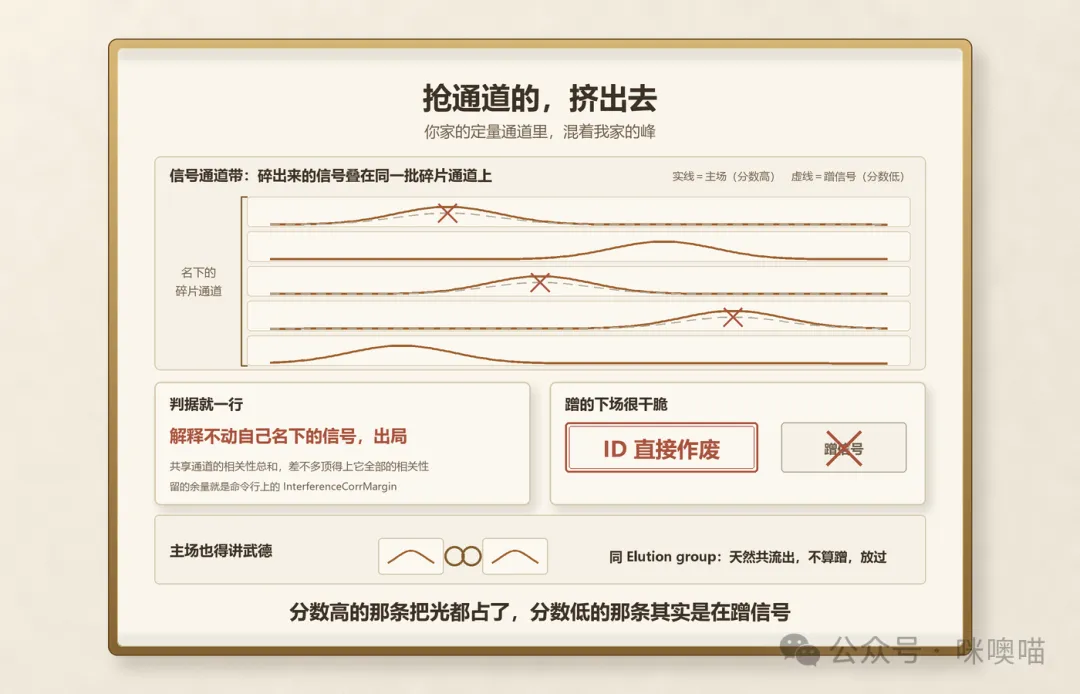
先说除渣。它的主刀是 remove_ifs()(L9135),全名大意是 “移除干扰碎片的受害者”;外面还套着一层调度的 refine_ids()(L9185)。这爷俩干的事儿,说白了,判据就一行,白纸黑字写着一条候选如果解释不动自己名下的信号,那就该怀疑它压根是来蹭信号的,出局。
怎么判定 “蹭信号”
想象两条肽段共洗脱(在色谱上挨着出峰)、又共隔离,碎出来的离子撞了车:你家的定量通道里,混着我家的峰。谁是主谁是客?引擎的办法很朴素。拿高分那条当 “主场”,把它名下的碎片通道全列出来,再去看排名比它靠后的每一条候选(L9131 按分数排的队,主场永远从高分看起)。
如果后来者的碎片跟主场的通道对得上,不光是对得上,连它那个峰的形状相关性都能被这些共享通道解释得七七八八(判据是一行算术:共享通道的相关性总和,差不多顶得上它全部的相关性,留的余量就是命令行上那个 InterferenceCorrMargin,默认 3.0,L9175–L9177),那它就没什么自己的东西了,全是蹭的。
蹭的下场很干脆:ID 直接作废(L9178–L9180)。这里头还有个细节,主场也得讲武德:如果两条本来就在同一个洗脱峰群里(同 Elution group),那真有可能是天然共流出,不算蹭,放过(L9143)。
从本窗口挤到邻窗口
refine_ids()(L9185)是调度层。它先在同一个采集窗口里来一遍(L9194),再把眼光放远:向前后各看 MaxIfsSpan 个窗口(默认 4,L178),凡是质量窗口罩得住主场质量(含同位素偏移)的邻窗口,也进去挤一遍(L9197–L9201)。
不过邻窗口的候选跟主场不排在同一个队里,谈不上谁排名靠后,主客就换个比法,直接比分数,分数压过主场的一个不碰,只往弱里挤(L9142)。道理跟本窗口一个样,归根到底看谁的证据更硬:分数是从峰形、共流出这些原始证据里攒出来的,两条候选抢同一份信号,谁的分高,谁更像那个真峰,信号就判给谁。被清出去的永远是分数更低、又解释不动自己名下信号的那条,不然反客为主,倒把真峰给清了。
还有一个开关叫 StrictIntRemoval(默认关,L207):打开的话,就顺着主场的质荷比往前后继续追,凡窗口罩得住主场的邻窗都进去挤,前后各最多再追 “主场峰宽” 的 1/4 那么多的窗口(L9204–L9212),挤得更狠。
挤完还得重排队
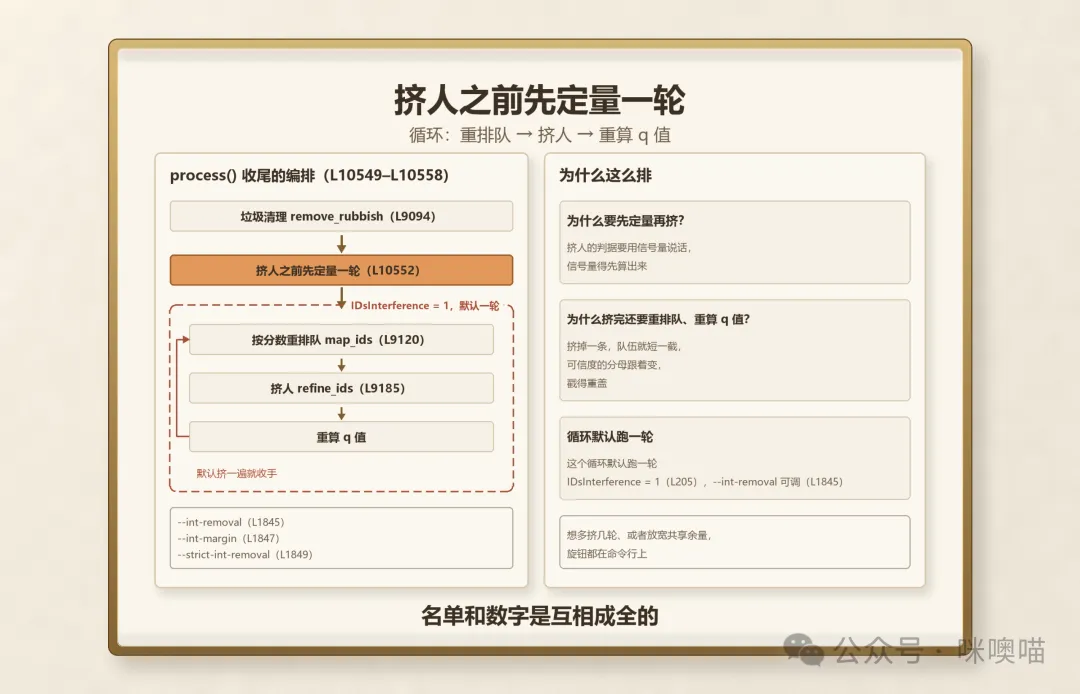
挤人这件事儿不是一锤子买卖。整条编排在 process() 的收尾(L10549–L10558):先来一遍垃圾清理(remove_rubbish(),L9094),然后来了个很多人想不到的重头戏,就是挤人之前先定量一轮(L10552),定量完才开始循环 “按分数重排队(map_ids(),L9120)→ 挤人(refine_ids())→ 重算 q 值”。
为什么要先定量再挤?因为挤人的判据要用信号量说话,信号量得先算出来。为什么挤完还要重排队、重算 q 值?因为挤掉一条,队伍就短一截,可信度的分母跟着变,戳得重盖。名单和数字是互相成全的,不是先出名单后出数字的单向流水账。
这个循环默认跑一轮(IDsInterference = 1,L205,命令行 --int-removal 可调,L1845),也就是说默认 “挤一遍就收手”。想多挤几轮、或者放宽共享余量,旋钮都在命令行上(--int-margin,L1847;--strict-int-removal,L1849)。
交账:定量怎么产出
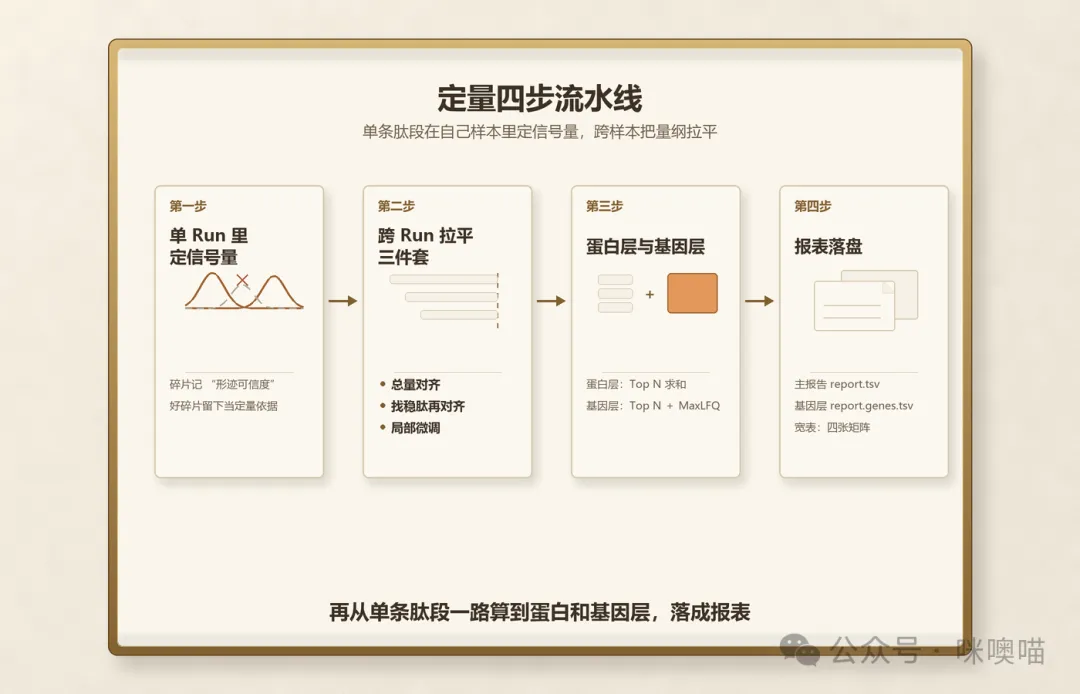
除完渣,名单干净了,该算账了。定量这块儿的活分四步走:单条肽段在自己样本里定信号量,跨样本把量纲拉平,再汇总到蛋白和基因层,最后把报表落盘。
第一步:单 Run 里,肽段的信号量怎么定
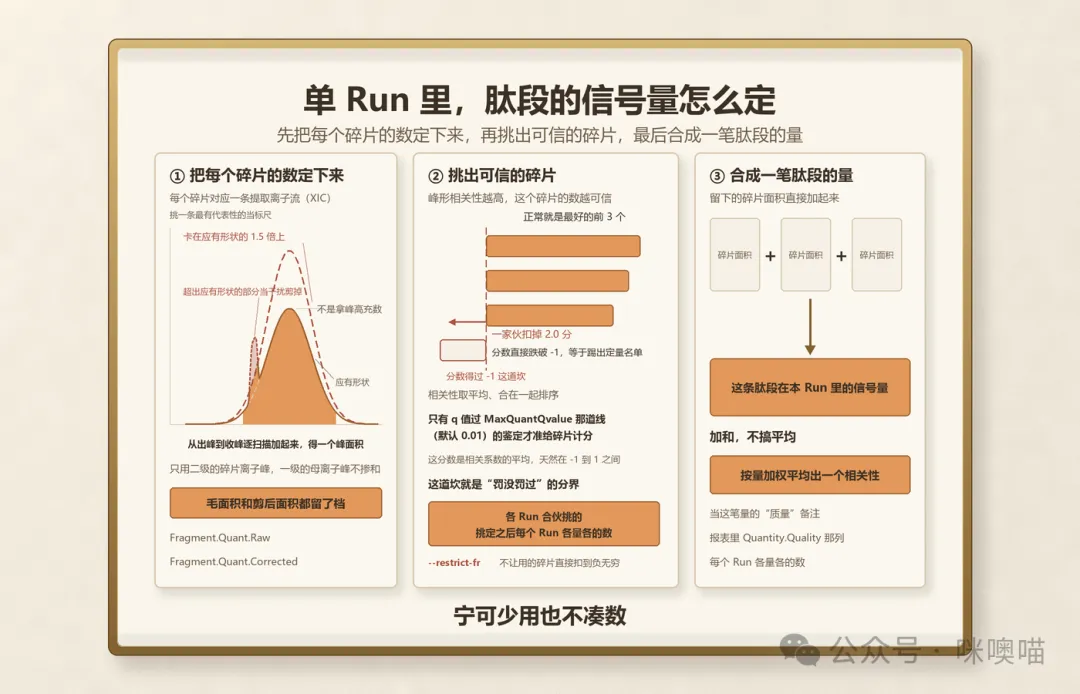
管这摊活的是 quantify()(L4086)。一条肽段碎成一二十个离子,可不是条条都记账:库里的碎片按峰高排着队(L3572),进定量账本的只有排头的几条,最多 6 条封顶(TopF,L776、L7813)。定信号量这事儿分三步走:先把每个碎片的数定下来,再挑出可信的碎片,最后合成一笔肽段的量。
先把每个碎片的数定下来
每个碎片对应一条提取离子流(XIC):从二级谱里把这个碎片的信号按质荷比挑出来,顺着出峰顺序连成一条曲线(L7249–L7252);定量就取认下的那个峰,从出峰到收峰逐扫描加起来,得一个峰面积,不是拿峰高充数(L7910、L7945–L7949)。这笔账只用二级的碎片离子峰,一级的母离子峰不掺和,引擎只另记一笔 MS1 面积(L7892),不进这条肽段的定量。
曲线里还可能混着共隔离带进来的杂信号,冒头的尖刺会把面积吹大。引擎默认留了个心眼:挑一条最有代表性的当标尺,就是峰形跟其他碎片最合拍的那条(L7466–L7472),别的碎片照着比例封顶,超出应有形状的部分当干扰剪掉,封顶的线也不卡死,卡在应有形状的 1.5 倍上(FilterFactor,L246、L7949),剪剩下的面积才入账(L7919–L7951;--no-ifs-removal 可关,L2093)。
剪除归剪除,底账都留着:每个碎片其实记两笔数,毛面积和剪后面积都留了档(qTotal 和 qFiltered,L2912–L2915);想复核的人翻默认报表就看得到,Fragment.Quant.Raw 和 Fragment.Quant.Corrected 两列就是(L5819、L5898–L5899)。
再挑出可信的碎片
给每个碎片记一笔 “形迹可信度”:峰形相关性越高,这个碎片的数越可信(L4098–L4106)。这里头有道入场券:只有 q 值过 MaxQuantQvalue 那道线(默认 0.01)的鉴定才准给碎片计分,信不过的 Run 不投票(L223、L4098)。同一条碎片在各个 Run 里的相关性取平均、合在一起排序,这个平均值就是下文排队择优用的分数。
排好队就择优:卡一道分数线,线以上的碎片拿来当定量依据,正常就是最好的前 3 个(L4138–L4141)。不过入选有个前提:分数得过 -1 这道坎。为什么偏偏是 -1?这分数是相关系数的平均,天然在 -1 到 1 之间,再差也高过 -1,可扣过分的必然跌到坎下,所以这道坎就是 “罚没罚过” 的分界,扣法待会儿就讲。于是第三好的那个要是被扣过,就只用前 2 个;第二好的也被扣过,就只用最好的那条,宁可少用也不凑数(L4139)。
挑碎片这一步是各 Run 合伙挑的,挑定之后每个 Run 各量各的数。不想要这道择优也有开关 --no-fr-selection,可引擎自己都说不推荐(L2094);另有 --restrict-fr,库里注释不让用的碎片直接扣到负无穷,一票否决(L4130–L4134、L2095)。
还有个讲究:如果这个碎片跟邻居(同洗脱峰群里的其他肽段)共用通道,它量出来的数就不纯。引擎把这种 “共享碎片” 找出来,一家伙扣掉 2.0 分(L4124),分数直接跌破 -1(L4139),等于踢出定量名单。配置开关 ExcludeSharedFragments 管着这道闸(L4108–L4128,--no-fr-exclusion 可关,L2096)。跟除渣那节同一个哲学,用一句话说就是名下要有自己说得清的信号,量出来的数才算数。
最后合成一笔肽段的量
合起来的办法是加和,不搞平均:留下的碎片面积直接加起来,就是这条肽段在本 Run 里的信号量(L4152);另外按量加权平均出一个相关性,当这笔量的 “质量” 备注(L4153–L4156),报表里 Quantity.Quality 那列就是它(L5878)。
第二步:跨 Run 拉平,三件套
每个样本里的信号量都有了自己的 “小九九”,可这几个数出自不同的进样,口径不齐,不拉平没法比。接下来是跨 Run 拉平(L4266 起),把各样本的量纲拉到一把尺上。这一步在 那份源码观察报告 里就点过名:跨样本那几步里有一笔 “归一化”,这一节把它拆开讲透。
门槛和开关先交代
这一步不需要任何 “匹配 Run” 之类的开关:翻遍 1.7.12 的引擎和 GUI 源码,压根没有 “Match between runs” 这个选项。它只认一个条件:多个 Run 合出一张总报表,就拉平。反过来,单 Run 分析,或者各个 Run 各出各的报告(--individual-reports,L2055),这步直接跳过(L4266)。
GUI 里管这一步的旋钮只有一个:“Cross-run normalisation” 下拉框,一共 3 档(GUI 源码 Form1.cs L705–L716)。Global 只跑前两件,对应 --global-norm;默认的 RT-dependent 再加上按出峰时间的局部微调;RT & signal-dep. (experimental) 连按信号强度那轮也打开,对应 --sig-norm。它选的是 “怎么拉”,不是 “拉不拉”。
这批开关在命令行上另有入口,GUI 和命令行两套参数怎么对照,早前 命令行参数那篇 里盘过。
另一个容易看混的选项是 “Unrelated runs”:勾上它,拉平照跑不误。它管的是另一摊:质量精度和 RT 扫描窗不再全实验共用一套,改成每个 Run 各自推断(勾上后引擎收到 --individual-mass-acc --individual-windows,L2053–L2054)。进门报到的仪器参数归它,交账的拉平不归它。
三件套把量纲拉平
回头看拉平本身,引擎做的是三件事。
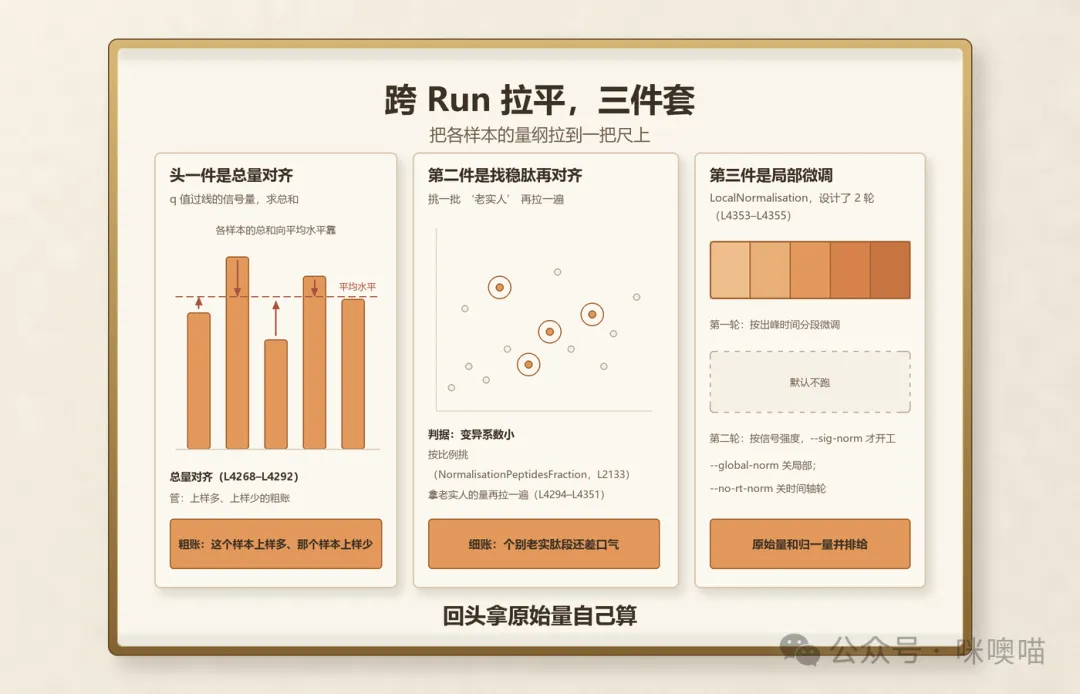
头一件是总量对齐。拿所有可信鉴定(q 值过 NormalisationQvalue 那道线;q 值是什么、怎么算的,第四回 里结过账)的信号量求个总和,各样本的总和向平均水平靠(L4268–L4292)。这一步管的是 “这个样本上样多、那个样本上样少” 的粗账。
第二件是找稳肽再对齐。全体肽段里挑一批 “老实人”,判据是变异系数小(信号波动除以均值,L4309 一带算的),按比例挑(NormalisationPeptidesFraction,L2133),拿老实人的量再拉一遍(L4294–L4351)。这一步管的是 “总量看着齐了,但个别老实肽段还差口气” 的细账。
第三件是局部微调,叫 LocalNormalisation,设计了 2 轮(L4353–L4355):第一轮按出峰时间(RT-dependent)在时间轴上分段微调;第二轮按信号强度再校一遍,但这轮默认不跑,得喊 --sig-norm 才开工(L2138)。要关也关得掉:--global-norm 把局部微调整步关掉,只留前两件(L2136),--no-rt-norm 专关时间轴那轮(L2137)。
拉平归拉平,原始量不丢:报表里原始量和归一量并排给,Precursor.Quantity 旁边就是 Precursor.Normalised(L706–L707),蛋白、基因层同款(L691–L694)。嫌这三件套拉得不合适,回头拿原始量自己算就行。
三个 RT,最后一回对表
到这里,“RT” 这个词在本系列出现过三次,正好借本篇收个总账。第一次是校准对表(第四回:把库 iRT 折算成本次进样时间轴的样条);第二次是 RT/iRT 预测模型(进数据之前报理论出峰位置);第三次就是这节的 RT-dependent normalisation(定量归一里按出峰时间分段微调)。三者管的都是 “时间”,但一个管对表、一个管预测、一个管拉平定量,别混。
第三步:从肽段到蛋白,再到基因
蛋白的量怎么来
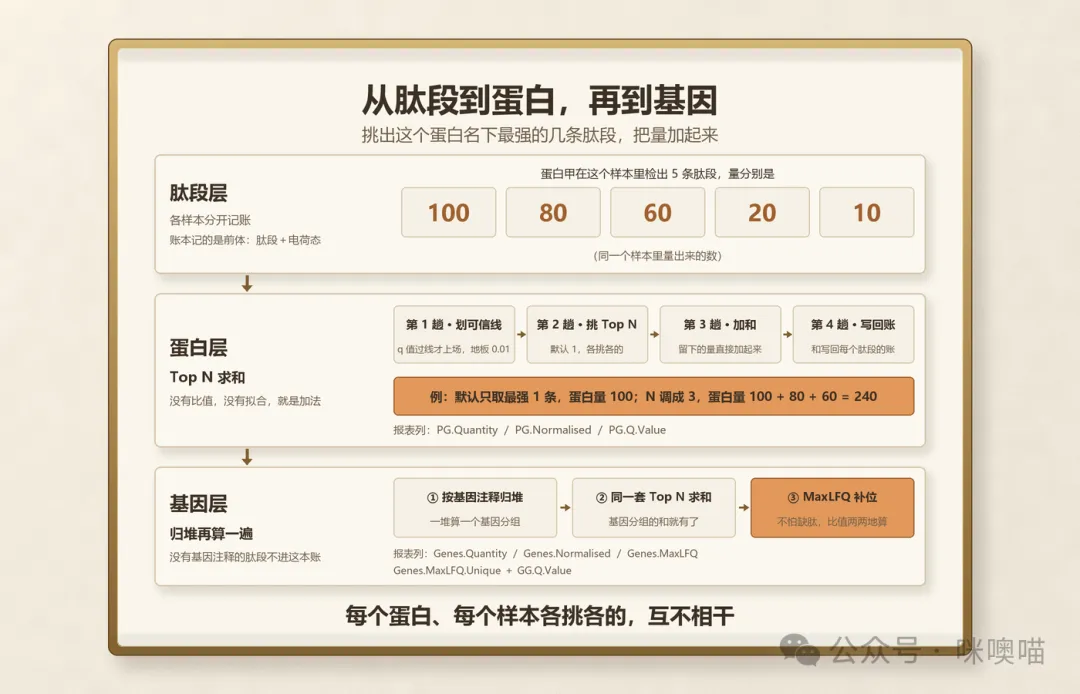
先说答案:从肽段到蛋白,引擎说白了就干一件事,就是挑出这个蛋白名下最强的几条肽段,把量加起来,这个和就是蛋白量。 这套办法就叫 Top N 求和(quantify_proteins(),L5590),没有比值,没有拟合,就是加法。
举个例子:蛋白甲在这个样本里检出 5 条肽段,量分别是 100、80、60、20、10。默认只取最强的 1 条,蛋白量就是 100(TopN 默认 1,L234);把 N 调成 3,蛋白量就是 100 + 80 + 60 = 240。N 由命令行 --top N 说了算(L2080–L2081),就这么直白。
不过这个 “挑” 有讲究:每个蛋白、每个样本各挑各的(L5626–L5637)。蛋白甲在样本 A 里最强的是那条 100,到了样本 B 里最强的可能是另一条,各挑各的,互不相干。挑的时候比的是归一量(L5623);挑定之后原始量、归一量各加一笔和(L5639),报表里 PG.Quantity、PG.Normalised 两列就是(L691–L692)。
挑强之前其实还有一道粗筛,就是可信线,它不是一刀切:先看这个蛋白在这个样本里最好的 q 值,它比 0.01 好,线就按 0.01 算;它比 0.01 差,线就抬到它的水平(L5630–L5631)。这条 0.01 的地板就是 ProteinQuantQvalue,命令行 --protein-quant-qvalue 可调(L224、L2077)。q 值不过线的没资格进 Top N 竞争:鉴定硬的蛋白,过 0.01 的全都上场;鉴定软的,就只有最好那拨 q 值的上场(L5633)。
顺带交代两个名头:说 “肽段” 时,账本上其实记的是前体,也就是 “肽段+电荷态”,报表一行一条;说 “蛋白” 时,默认其实是推断出来的蛋白组(InferPGs,L331),PG.Quantity 里的 PG 就是 protein group 的意思(L691)。
把这套动作排开,就是源码里的 4 趟扫描(L5606–L5646):第 1 趟划可信线,第 2 趟挑 Top N,第 3 趟加和,第 4 趟把和写回头上每个肽段的账里。蛋白的账,到这儿就结完了。
基因的量怎么来
这层不是另起炉灶:先把蛋白按基因注释归堆,一堆算一个基因分组(generate_gene_groups(),L5328–L5346),没有基因注释的肽段不进这本账(L5616–L5618);然后拿同一套 Top N 求和原样再跑一遍,基因分组的和就有了(L5641),落在 Genes.Quantity、Genes.Normalised 两列(L693–L694)。
缺了怎么办:MaxLFQ 补位
可光求和有个软肋:某条肽段在这个样本里恰好没检出,和就瘸了。还拿蛋白甲说事,5 条里缺了 2 条,加出来的和就比别的样本系统性地小一号,缺得越多亏得越多。基因层的招牌解法是 MaxLFQ,默认开着(L233,--no-maxlfq 可关,L2079),蛋白层可没这待遇(L5648)。它的思路一句话能说明白,白话讲就是真实量是多少说不清,但同一个基因分组在两个样本里的比值,可以拿共同检出的肽段两两地估出来。
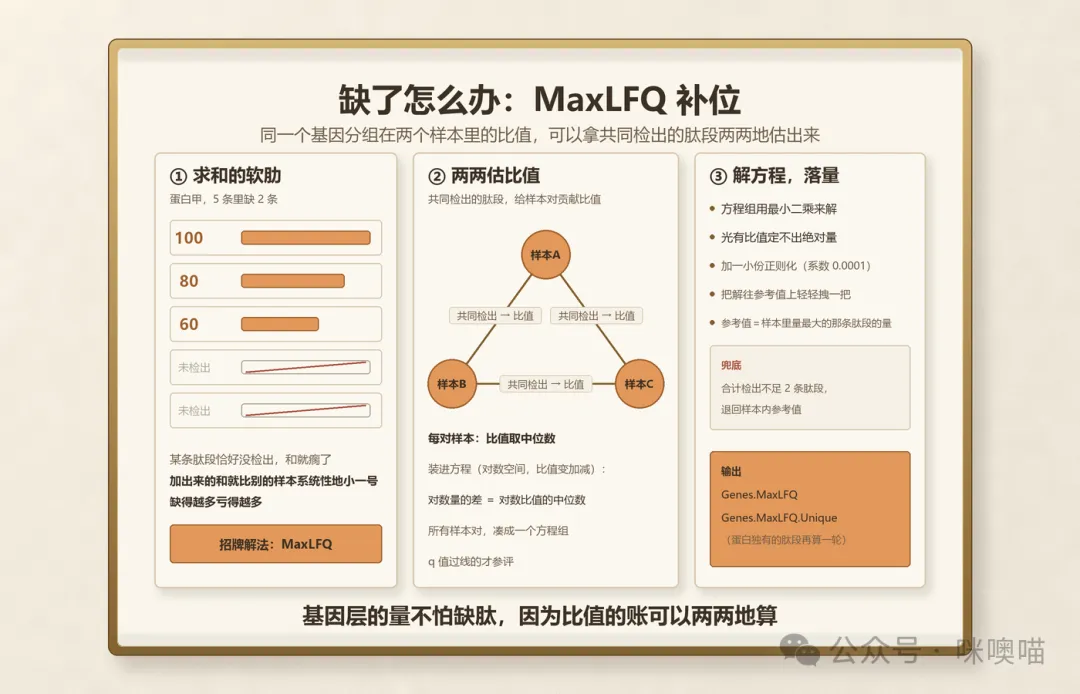
先说说它的出身。MaxLFQ 出自一篇专门的方法论文(Cox 等,Molecular & Cellular Proteomics,2014),说的是一套挺复杂的非标定量校准方案,招牌做法是 “延迟归一+最大肽段比值”。方法是公开发表的,谁都能实现,不少软件都在用,MaxQuant 只是其中最有名的一种。
说回这一版的实现:参与估算的量是归一量取对数(L5380),q 值过线的才参评;两个样本共同检出的肽段,才给这两个样本贡献一个比值(L5412)。所有样本两两的比值凑成一个方程组:每对样本的比值先取中位数(L5413–L5419),再装进方程(L5421–L5428),解出来的那组量,既互相自洽,又不怕个别肽段缺失。
这里有个小机关:光有比值定不出绝对量,全体平移一把,比值纹丝不动。源码的办法是给方程加一小份正则化,把每个样本的解往它的参考值上轻轻拽一把(系数 0.0001,L5430–L5434),量纲这才落了地。参考值就是这个样本里量最大的那条肽段的量(L5385–L5391),所以 MaxLFQ 的量跟肽段量是同一把尺。
细节上还有两个兜底。一是全程在对数空间里算,比值变加减,稳健;二是整个基因分组合计检出的肽段不足 2 条,就不进方程组,各样本直接退回样本内参考值(L5394–L5397),宁可粗一点也不瞎解。方程组本身用最小二乘来解(L5437)。
这套方程组在基因层跑了 2 轮:先按基因分组算一轮,检出的肽段都进账;再算一轮 “基因独有” 版,只让蛋白独有(Proteotypic,一条肽段只对应一个蛋白)的肽段进方程组(L5648–L5663、L5379),结果落在 Genes.MaxLFQ.Unique 列(L696)。还有个提醒:样本数超 2000 个的话这段会慢得感人,源码里自己都写了警告(L5649–L5650)。
那句警告还有个坑:日志文案把 MaxLFQ 写成了 protein quantification,其实它站在基因层的分支里(L5648、L5650)。查这种事得看接线,不能信字面。
再记一条考古注脚:1.7.12 这一版,MaxLFQ 只接在基因层,蛋白层只有 Top N 求和;后来的版本报表里多出了 PG.MaxLFQ 一列,蛋白层也能给 MaxLFQ 量了。本文的账只对 1.7.12 源码负责,新版本就点到为止。
算完量,可信度戳也顺手盖好:蛋白组、基因分组各有各的 q 值(group_qvalues(),L5463,收尾调用 L5666),报表里 PG.Q.Value、GG.Q.Value 两列就是(L703–L704)。
第四步:报表落盘
账都算完了,最后是交账清单。默认的主报告就是那个熟悉的 report.tsv(L256),由 report()(L5802)落笔;基因层另有 report.genes.tsv(gene_report(),L5976),里面 Top N 量、MaxLFQ 量并排给:Genes.Quantity、Genes.Normalised、Genes.MaxLFQ、Genes.MaxLFQ.Unique,外加一枚 GG.Q.Value 戳(L6001)。
想要宽表的话,还有四张矩阵:前体级、蛋白组级、基因分组级、基因独有级各一张(L5669、L5719,调用处 L5969–L5972)。别看都是宽表,装的量各有各的来路:前体级装前体归一量(L5688),蛋白组装 Top N 归一量,基因分组装 MaxLFQ 量,基因独有装 Unique 量(L5763–L5765),各自按各自的 q 值戳过线进表。
矩阵默认不出,得开 --matrices(L1834),各 Run 各出报告的模式下也不出(L5968);进表还有 q 值过滤线 MatrixQValue,命令行 --matrix-qvalue 可调,钳在 0.001 到 0.05 之间(L1885–L1886)。
统计类的还有三件套:stats_report(L6023)、tic_report(L6055)、XIC_report(L6066)。蛋白层的可信度戳也在收尾前统一盖好(calculate_protein_qvalues(),L10045)。
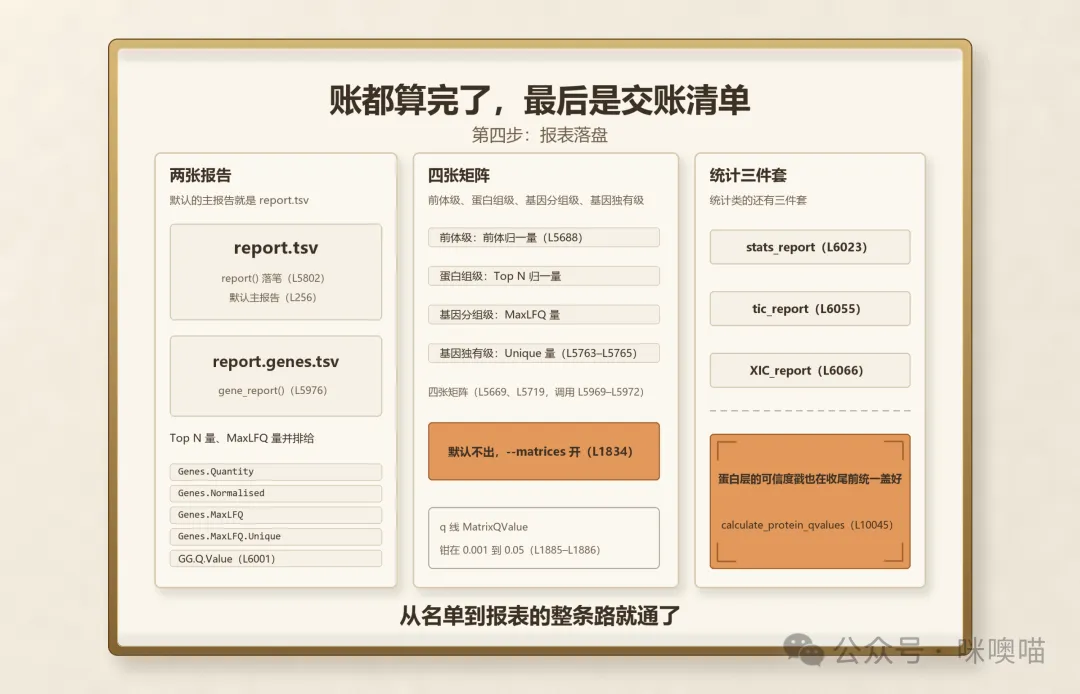
到这里,从名单到报表的整条路就通了。回头看一眼全流程的咬合点:除渣之前先定量一轮,挤完人重排队重盖戳,最后收尾时再定量一轮,开着 TranslatePeaks 就再补一轮(L10585–L10586)才出报告。名单和数字一路互相成全,谁也不是谁的附庸。
写在最后
这一回走下来,最有意思的还是那个老味道:处处讲证据。蹭信号的要出局,因为解释不动自己名下的信号;定量的碎片要择优,因为名下要有说得清的信号;基因层的量不怕缺肽,因为比值的账可以两两地算。道理都不复杂,复杂的是把道理一丝不苟地落进一万多行代码里。
源码考古的主线,到这一篇收官。三段路全部走完:怎么找(进门报到、建库下锅、找峰打分),怎么判(学权重、算 q 值、做校准、循环转圈),怎么出定量结果(除渣、拉平、汇总、落盘)。一台质谱数据分析引擎,从原始文件进来到报表出去,里头的账就是这么一笔一笔结清的。
如果这一系列文章对各位观众老爷有价值,请伸出您尊贵的小手点个赞 ~
相关文章
• 《DIA-NN 最新源码里能看到什么、能学到什么:一份公开仓库的观察报告》(本系列的起因) • 《DIA-NN 引擎源码考古 · 1.7.12 · 第一回 · 先把引擎的 「地层」看个全貌 ~》 • 《DIA-NN 引擎源码考古 · 1.7.12 · 第二回 · 数据进门先报到,名单出炉再下锅 ~》 • 《DIA-NN 引擎源码考古 · 1.7.12 · 第三回 · 候选排队过堂,证据都在峰里》 • 《DIA-NN 引擎源码考古 · 1.7.12 · 第四回 · 打分不算完,越揉越靠谱 ~》(本篇的上一回)
配套参考(跟本篇配套的两篇):