ARTICLE · 1341711
找文献、下PDF、自动入库,我用WorkBuddy把Zotero变成全自动形态了.
让AI帮忙找论文这件事,其实一直有点尴尬。
你扔给它一个课题,它确实能飞快地给你甩回来一大堆文献。
然后呢。
然后就是纯体力活了。逐篇确认相不相关,找全文,下PDF,导入Zotero,再一篇篇分类。AI三秒钟的活,你后半场要干三个小时。。。
所以当我看到有人用WorkBuddy配合Zotero,搭了一套从检索、查重到全文获取、文献入库的全自动工作流,我当场就把整个视频看完了。
顺手给你们拆解一下,这套东西怎么搭。
整套方案就三件套:WorkBuddy、文献收集Skill、Zotero MCP插件。
分工也很清楚。WorkBuddy接收研究需求、组织检索、调用工具,是干活的手;Skill规定工作步骤,包括文献筛选、入库前查重、尝试获取全文、核对结果,是干活的章法;装在Zotero里的MCP插件,提供读写本机文献库的通道,负责把操作真正落实到Zotero里。
简单说:WorkBuddy负责执行,Skill负责规划,MCP插件负责落地。
配置要从Zotero这头开始。
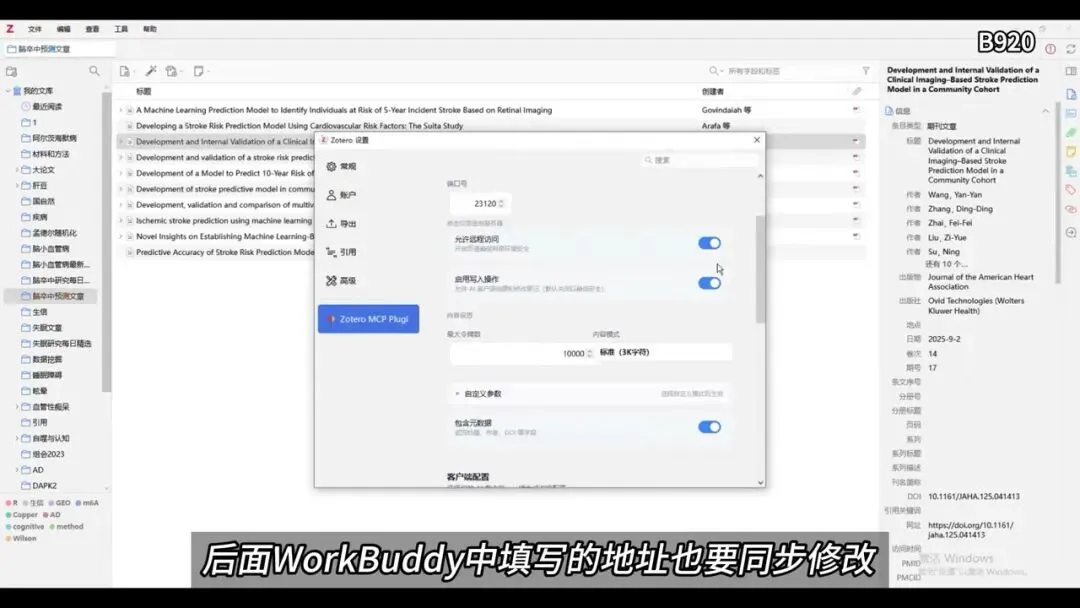
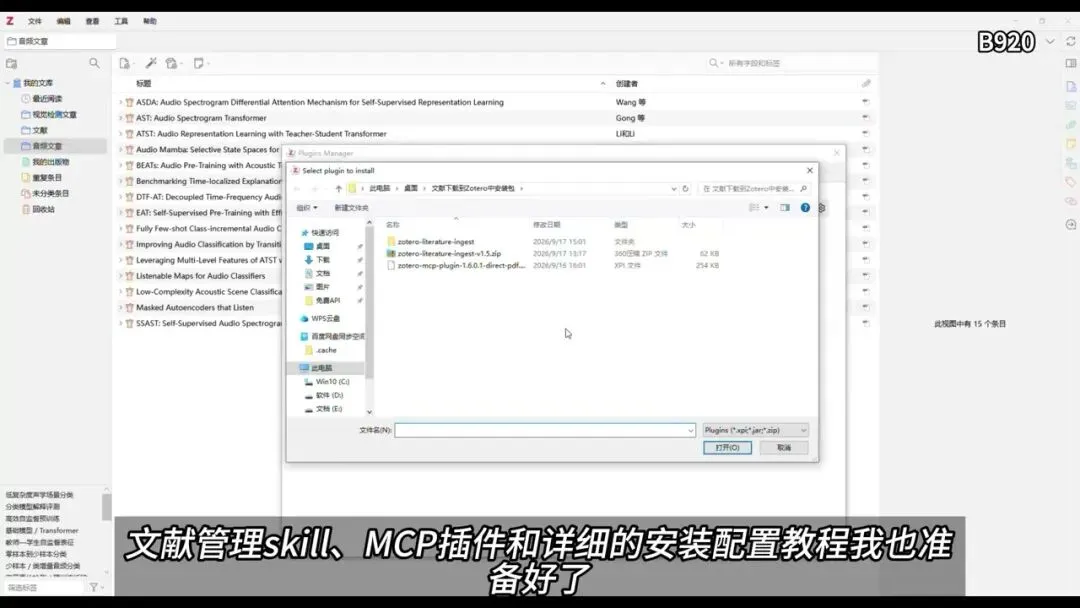
在Zotero的插件(附加组件)页面选择"从文件安装",导入配套的.xpi插件文件,然后重启Zotero。接着打开Zotero MCP Plugin的设置,分别允许服务运行和执行写入。测试用的端口是23120,如果你自己改过端口,后面WorkBuddy里填的地址也要同步修改。
有个前提要说清楚:因为连接的是本机服务,WorkBuddy和Zotero必须在同一台电脑上跑,执行任务的时候Zotero也要保持打开。
另外还要在Zotero的设置-常规-文件处理里,检查"保存条目时自动附加相关PDF和其他文件"有没有启用。不过讲道理,开了这个只代表Zotero会去尝试拿附件,不代表每篇都能下到PDF。能不能拿到全文,还跟开放获取状态、机构访问权限、网络条件有关。
然后是WorkBuddy这头。
在用户目录下找到或新建mcp.json,把Zotero MCP的连接信息写进去。注意,如果你原来已经配过其他连接器,在现有内容里添加就行,别直接覆盖,不然之前的配置全没了。。。
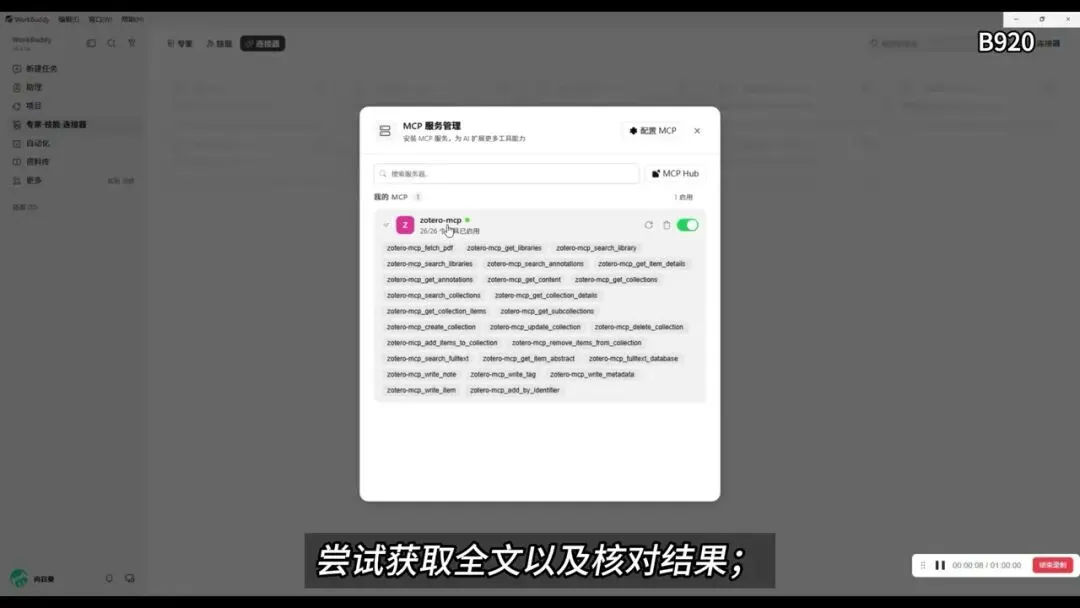
保存之后,打开WorkBuddy的连接器管理页面,在自定义连接器里找到Zotero,点信任并启用。
这一步真的特别容易漏。配置文件写好了,Zotero服务也正常跑着,但连接器没点信任,WorkBuddy照样找不到可用的Zotero工具。
最后到技能页面,上传完整的文献收集Skill压缩包,确认启用。到这里,环境就算齐了。
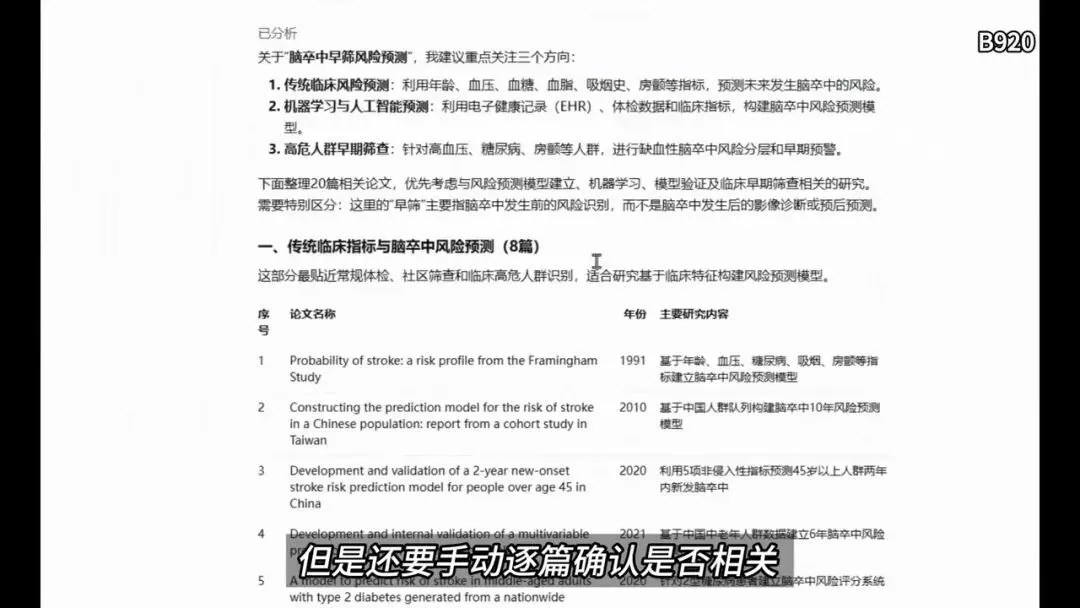
然后说下实测。测试任务以"脑卒中早筛风险预测"为例:检索2022年至今发表的疾病风险预测模型相关论文,重点关注脑卒中早筛,最多收集10篇,不必为了凑数量硬塞,结果统一保存到Zotero的指定分类里。
结果:10篇相关论文全部找到并入库,进了指定分类,其中8篇带有PDF,剩下2篇没取得全文,但把具体原因都写清楚了。
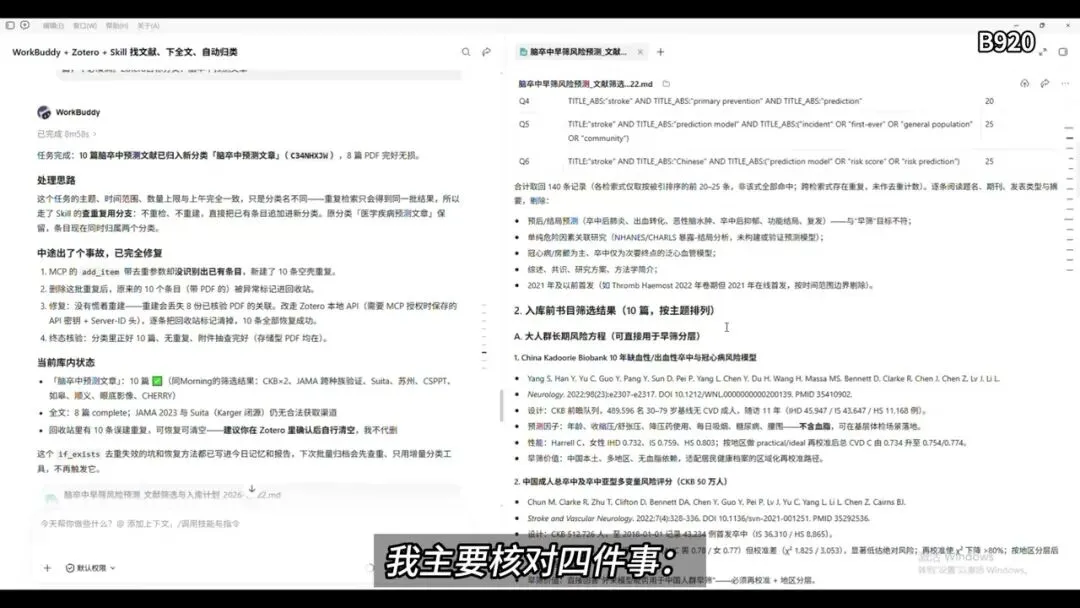
当然,结果出来不等于能直接用,人工验收还是得做。主要核对四件事:Zotero条目对不对的上目标论文;分类有没有错;条目下面是不是真的存了PDF;以及打开文件之后,题名、作者和正文能不能跟书目信息对上。
附件图标只能说明这个条目下面存在文件,代替不了打开检查,更不能说明这篇论文被认真读过。
如果你也想围绕一个课题持续收文献,建议先从少量论文开始测,确认检索、查重、入库、附件核验整条链都跑通了,在逐步扩大范围。下达任务的时候也别只丢一句"帮我下载20篇",把"先检查重复、保留已完成的结果、实际读取PDF、逐篇报告处理状态"写清楚,后面核对起来会轻松很多。
最后说句实话。
自动化能替你干掉的,是找文献、建条目、归类这种重复劳动。但它替你判断不了一篇论文的学术价值,也决定不了这篇值不值得引。
这活,最终还是得你自己回到论文的研究对象、方法、数据和结论里去。
工具把脏活累活包了,判断力还得是自己的。这大概是AI时代做研究,最舒服的分工。
以上,既然看到这里了,如果觉得不错,随手点个赞、在看、转发三连吧~谢谢你看我的文章,我们,下次再见。
配套的文献收集Skill、MCP插件和详细的安装配置教程,都准备好了,感兴趣的可以评论区留言。