ARTICLE · 1344607
IMERG 与 CMORPH 卫星降水下载教程:两段可直接运行的脚本
QUOTE
同样是卫星降水,IMERG 和 CMORPH 的下载路径完全不同;把两套流程写成可以直接跑的脚本,再用一场暴雨检验它们的日累积。
—— 气象数据实战
做降水研究,卫星降水是绕不开的资料。最常用的两支是 NASA 的 IMERG 和 NOAA 的 CMORPH。这篇不做产品综述,只解决两件事:
一是 怎么把数据下下来——两段完整脚本,复制就能跑;二是 它们对同一场暴雨的刻画差在哪——用 2021 年河南「7·20」的日累积做对比。
本文看点
01
两种产品的差异
02
两段可运行脚本
03
7·20 暴雨对比
01
DATA
先分清两种产品
两者都是全球 60°S–60°N、长序列、免费;差别主要在分辨率、认证和获取方式。
NOTE
两套日产品单位都是 mm/day,时间段都是 UTC 00:00–23:59,可以直接比较。跨日分析记得换算北京时间。
02
IMERG
下载 IMERG(需两步认证)
IMERG 的门槛只有认证:一次配好,之后就是普通 HTTP 下载。
把 Earthdata 账号写进 ~/.netrc,然后 chmod 600 ~/.netrc。
machine urs.earthdata.nasa.gov
login 你的邮箱账号
password 你的密码
浏览器登录 Earthdata 后打开授权页,点同意(每个账号一次):https://urs.earthdata.nasa.gov/approve_app?client_id=e2WVk8Pw6weeLUKZYOxvTQ
下面这段就是完整下载脚本,保存为 imerg_download.py 即可运行。支持逐日与半小时、断点续跑、失败重试。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""IMERG Final V07B 下载(逐日 df / 半小时 hh),可直接运行。
准备(一次性):
1) ~/.netrc 写入 Earthdata 账号并 chmod 600:
machine urs.earthdata.nasa.gov
login 你的邮箱
password 你的密码
2) 浏览器登录 Earthdata,授权 GES DISC 应用:
https://urs.earthdata.nasa.gov/approve_app?client_id=e2WVk8Pw6weeLUKZYOxvTQ
用法:
python imerg_download.py --product df --start 20210720 --end 20210720 --out ./imerg
python imerg_download.py --product hh --start 20210720 --end 20210720 --out ./imerg --proxy http://127.0.0.1:7890
"""
import argparse
import os
import time
from concurrent.futures import ThreadPoolExecutor, as_completed
from datetime import date, datetime, timedelta
import requests
BASE = "https://gpm1.gesdisc.eosdis.nasa.gov/data/GPM_L3"
MAGIC = b"\x89HDF\r\n\x1a\n" # HDF5/NetCDF4 文件魔数,用来识别“登录页假文件”
def make_session(proxy=None):
s = requests.Session()
s.trust_env = True # 自动读取 ~/.netrc
if proxy:
s.proxies = {"http": proxy, "https": proxy}
s.headers["User-Agent"] = "imerg-download/1.0"
return s
def urls_of_day(d: date, product: str):
"""逐日:1 个文件;半小时:48 个文件,目录按 年/年内日序(DOY) 组织。"""
if product == "df":
fn = f"3B-DAY.MS.MRG.3IMERG.{d:%Y%m%d}-S000000-E235959.V07B.nc4"
return [(f"{BASE}/GPM_3IMERGDF.07/{d:%Y}/{d:%m}/{fn}", fn)]
doy = d.timetuple().tm_yday
out = []
for i in range(48):
t0 = datetime(2000, 1, 1) + timedelta(minutes=30 * i)
t1 = t0 + timedelta(minutes=29, seconds=59)
fn = (f"3B-HHR.MS.MRG.3IMERG.{d:%Y%m%d}-S{t0:%H%M%S}-E{t1:%H%M%S}"
f".{30 * i:04d}.V07B.HDF5")
out.append((f"{BASE}/GPM_3IMERGHH.07/{d:%Y}/{doy:03d}/{fn}", fn))
return out
def fetch(sess, url, dest, retries=3):
"""先写 .part,校验魔数后原子改名;已存在则跳过。"""
if os.path.exists(dest) and os.path.getsize(dest) > 0:
return "skip", dest
part = dest + ".part"
for k in range(1, retries + 1):
try:
with sess.get(url, stream=True, timeout=300) as r:
r.raise_for_status()
with open(part, "wb") as f:
for chunk in r.iter_content(1 << 20):
f.write(chunk)
with open(part, "rb") as f:
if f.read(8) != MAGIC:
raise RuntimeError("不是 HDF5(可能是登录页,检查 .netrc 与授权)")
os.replace(part, dest)
return "ok", dest
except Exception as e:
if os.path.exists(part):
os.remove(part)
if k == retries:
return f"fail: {e}", dest
time.sleep(2 * k)
def main():
ap = argparse.ArgumentParser()
ap.add_argument("--product", choices=["df", "hh"], default="df")
ap.add_argument("--start", required=True, help="YYYYMMDD")
ap.add_argument("--end", required=True, help="YYYYMMDD")
ap.add_argument("--out", default="./imerg")
ap.add_argument("--workers", type=int, default=4)
ap.add_argument("--proxy", default=None, help="直连慢时再给,如 http://127.0.0.1:7890")
a = ap.parse_args()
d0 = datetime.strptime(a.start, "%Y%m%d").date()
d1 = datetime.strptime(a.end, "%Y%m%d").date()
sess = make_session(a.proxy)
tasks = []
d = d0
while d <= d1:
for url, fn in urls_of_day(d, a.product):
tasks.append((url, os.path.join(a.out, f"{d:%Y}", fn)))
d += timedelta(days=1)
os.makedirs(a.out, exist_ok=True)
print(f"共 {len(tasks)} 个文件 -> {os.path.abspath(a.out)}")
stat = {}
with ThreadPoolExecutor(max_workers=a.workers) as ex:
futs = [ex.submit(fetch, sess, u, p) for u, p in tasks]
for i, f in enumerate(as_completed(futs), 1):
st, path = f.result()
key = st.split(":")[0]
stat[key] = stat.get(key, 0) + 1
if key == "fail":
print("[FAIL]", os.path.basename(path), st)
if i % 20 == 0 or i == len(futs):
print(f"{i}/{len(futs)}", stat)
print("完成:", stat)
if __name__ == "__main__":
main()
运行:
# 逐日(1 个文件/天,单位 mm/day)
python imerg_download.py --product df --start 20210720 --end 20210720 --out ./imerg
# 半小时(48 个文件/天)
python imerg_download.py --product hh --start 20210720 --end 20210720 --out ./imerg
# 直连慢时再加代理(默认直连)
python imerg_download.py --product df --start 20210720 --end 20210720 --out ./imerg \
--proxy http://127.0.0.1:7890
NOTE
NASA 是靠 session cookie 放行文件的。脚本用 requests.Session() 自动维持会话;如果用 curl 手搓,必须 -c/-b cookies.txt,否则会在登录重定向里死循环。脚本里的魔数校验就是为了防止把登录页 HTML 当成数据存下来。
03
CMORPH
下载 CMORPH(免注册)
CMORPH 没有任何认证,URL 是规则拼接,直接下就行。脚本默认优先直连,直连失败才降级走代理——这是省流量又不牺牲成功率的最稳做法。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""CMORPH V1.0 下载(逐日 dly / 半小时 hh),无需注册,可直接运行。
策略:优先直连(省代理流量),直连失败自动降级走代理(--proxy)。
用法:
python cmorph_download.py --product dly --start 20210720 --end 20210720 --out ./cmorph
python cmorph_download.py --product hh --start 20210720 --end 20210720 --out ./cmorph \
--proxy http://127.0.0.1:7890
"""
import argparse
import os
import time
from datetime import date, datetime, timedelta
import requests
BASE = ("https://www.ncei.noaa.gov/data/"
"cmorph-high-resolution-global-precipitation-estimates/access")
MAGIC = b"\x89HDF\r\n\x1a\n"
def urls_of_day(d: date, product: str):
"""逐日:1 个文件;半小时:24 个文件(每文件含 2 个半小时步)。"""
if product == "dly":
fn = f"CMORPH_V1.0_ADJ_0.25deg-DLY_00Z_{d:%Y%m%d}.nc"
return [(f"{BASE}/daily/0.25deg/{d:%Y}/{d:%m}/{fn}", fn)]
out = []
for h in range(24):
fn = f"CMORPH_V1.0_ADJ_8km-30min_{d:%Y%m%d}{h:02d}.nc"
out.append((f"{BASE}/30min/8km/{d:%Y}/{d:%m}/{d:%d}/{fn}", fn))
return out
def _try(url, dest, proxy, timeout=120):
part = dest + ".part"
sess = requests.Session()
sess.trust_env = False # 默认忽略系统代理 = 直连
if proxy:
sess.proxies = {"http": proxy, "https": proxy}
with sess.get(url, stream=True, timeout=timeout) as r:
r.raise_for_status()
with open(part, "wb") as f:
for chunk in r.iter_content(1 << 20):
f.write(chunk)
with open(part, "rb") as f:
if f.read(8) != MAGIC:
raise RuntimeError("不是 NetCDF4/HDF5 文件")
os.replace(part, dest)
def fetch(url, dest, proxy=None, retries=2):
if os.path.exists(dest) and os.path.getsize(dest) > 0:
return "skip", dest
os.makedirs(os.path.dirname(dest), exist_ok=True)
last = ""
for k in range(1, retries + 1):
for mode, px in (("直连", None), ("代理", proxy)):
if mode == "代理" and not proxy:
continue
try:
_try(url, dest, px)
return ("ok" if mode == "直连" else "ok-proxy"), dest
except Exception as e:
last = f"{mode}: {e}"
p = dest + ".part"
if os.path.exists(p):
os.remove(p)
time.sleep(2 * k)
return f"fail({last})", dest
def main():
ap = argparse.ArgumentParser()
ap.add_argument("--product", choices=["dly", "hh"], default="dly")
ap.add_argument("--start", required=True, help="YYYYMMDD")
ap.add_argument("--end", required=True, help="YYYYMMDD")
ap.add_argument("--out", default="./cmorph")
ap.add_argument("--proxy", default=None, help="直连不通时才用,如 http://127.0.0.1:7890")
a = ap.parse_args()
d0 = datetime.strptime(a.start, "%Y%m%d").date()
d1 = datetime.strptime(a.end, "%Y%m%d").date()
tasks = []
d = d0
while d <= d1:
for url, fn in urls_of_day(d, a.product):
sub = "daily/0.25deg" if a.product == "dly" else f"30min/8km/{d:%Y}/{d:%m}/{d:%d}"
tasks.append((url, os.path.join(a.out, sub, fn)))
d += timedelta(days=1)
print(f"共 {len(tasks)} 个文件 -> {os.path.abspath(a.out)}")
stat = {}
for i, (u, p) in enumerate(tasks, 1):
st, path = fetch(u, p, a.proxy)
key = st.split("(")[0]
stat[key] = stat.get(key, 0) + 1
if key == "fail":
print("[FAIL]", os.path.basename(path), st)
if i % 10 == 0 or i == len(tasks):
print(f"{i}/{len(tasks)}", stat)
print("完成:", stat)
if __name__ == "__main__":
main()
运行:
# 逐日 0.25°(1 个文件/天)
python cmorph_download.py --product dly --start 20210720 --end 20210720 --out ./cmorph
# 半小时 8km(24 个文件/天,每文件含 2 个半小时步)
python cmorph_download.py --product hh --start 20210720 --end 20210720 --out ./cmorph
NOTE
三个容易踩的点:逐日变量名是 cmorph(别用 data_vars[0],会取到 time_bounds);经度是 0–360,用前先换算到 −180~180;半小时文件每天 24 个,不是 48 个。
关于代理:卫星降水站多在境外,先直连试试;直连能跑就别挂代理,速度慢到影响进度时再加 --proxy。两段脚本都按这个原则写的。
04
CASE
同一场暴雨,两种画法
各取 2021-07-20(UTC) 的日累积——对应北京时 7 月 20 日 08 时至 21 日 08 时,正是河南「7·20」最强的一天。
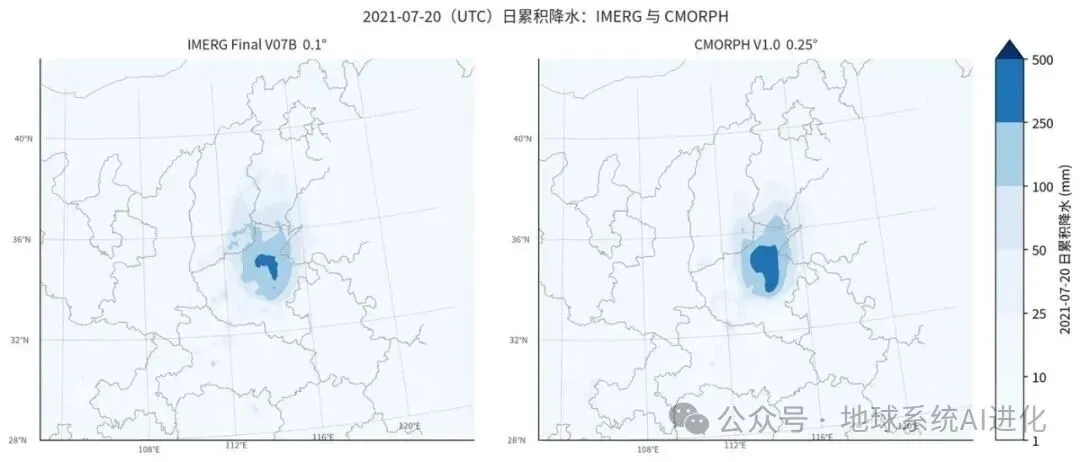
— 2021-07-20 日累积降水:左 IMERG(0.1°),右 CMORPH(0.25°)
两张图放在一起,能读出三个结论:
① 落区高度一致。强降水中心都锁定在河南中部、郑州一带,说明大尺度雨带的判断没有分歧。
② 量级与形态不同。河南区域最大日累积 CMORPH 约 415 mm,IMERG 约 313 mm;但 CMORPH 是 0.25° 网格,强中心更连片平滑,IMERG 0.1° 能勾出暴雨核心的精细结构。
③ 整体偏差不大。河南及周边逐格点相关约 0.95,RMSE 约 30 mm,相对 300 mm 级的暴雨属于可接受区间。
要暴雨的精细结构,用 IMERG(0.1°);要 1998 年以来的长序列、又不想折腾账号,用 CMORPH;做定量评估,两者交叉验证最稳。
∞
EPILOGUE
写在最后
IMERG 难在认证,一次配好就顺;CMORPH 难在没有门槛,反而要注意经度和变量名。两段脚本都可以直接拿走用,换日期就能跑自己的个例。
我是 气象数据实战,持续分享气象数据获取与处理实战。
如果这篇对你有用,欢迎点赞、在看、转发三连,我们下篇见。