ARTICLE · 1346681
从Val Town 停服看,代码能下载,不代表项目能搬家
平时喜欢写点轻量工具、做点自动化脚本的独立开发者,很多都在用 Val Town。它是一个极简的云端代码托管与运行平台,不用买云主机,也不用自己折腾复杂的部署流水线,打开网页写几行 TypeScript 或 JavaScript,就能立刻跑起一个对外服务的 HTTP 接口,或者挂一个定时执行的脚本。平台还内置了开箱即用的 SQLite 数据库和对象存储,平时拿来接个第三方 Webhook、做个消息推送机器人非常顺手。
然而,2026 年 11 月 10 日官方发布了服务关停公告,将逐步停止运营并计划后续开源。很多开发者看到消息后的第一反应,是赶紧登录后台把代码文件导出到本地。但真正动手就会发现,把源码下载下来仅仅完成了搬家的一小部分。那些留在平台数据库里的历史记录、后台配置的密钥、每天准时触发的定时任务,还有正在接收外部请求的旧链接,只要有一环没接上,小应用离开原平台就无法正常工作。
这篇指南就站在实际操作的视角,理清楚官方的停服时间表,逐项拆解离开原平台必须带走的五类底层依赖,并提供一套可落地的本地演练与切换验收方案。
Val Town 什么时候停服?先分清三个关键日期
平时喜欢写点小工具的独立开发者,大多对 Val Town 不陌生。它是一个非常轻量的在线代码托管平台,不用折腾服务器和复杂的部署配置,打开浏览器写几行 JavaScript 或 TypeScript,就能直接跑起一个 HTTP 接口、定时脚本或者自动化工作流。平台还顺带把 SQLite 数据库和对象存储都配齐了,平时拿来接个 Webhook、做个消息机器人特别顺手。
但就在 2026 年 11 月 10 日,官方发布了关停公告。把项目托管在上面的开发者,现在都得着手准备 Val Town 迁移工作了。
先看一眼官方给出的停服时间线,把几个关键节点理清楚:
| 2026 年 11 月 10 日 | |
| 2026 年 12 月 10 日 | |
| 2027 年 1 月 10 日 | |
| 2027 年 2 月 1 日 |
翻完官方公告和迁移文档,有两个细节直接决定了我们搬家的先后顺序:
第一,12 月 10 日进入只读,不代表线上应用当天就挂了。 那天之后我们确实没法再上平台改代码,但已经跑起来的应用、SQLite 数据库读写以及 Blob 存储都还能正常撑一个月,直到 2027 年 1 月 10 日才会彻底停机。至于 2027 年 2 月 1 日的开源,目前还只是官方的一个计划。
第二,如果要留住旧链接,必须在 12 月 10 日前动手。 官方明确规定,val.run 的重定向规则只能在 2026 年 12 月 10 日之前添加和修改。到了当天,所有设置好的重定向就会直接锁死变成永久生效。也就是说,需要保留旧入口的项目,赶在 12 月 10 日前就得把新环境搭好并完成验证。
在计划搬家的时候,很多人的第一反应是去后台把源码打包下载下来。但实际上,真正需要带走的除了编辑器里的代码,还有让它持续运转的整套底层依赖。
为什么拿到源码和项目能迁走之间还有距离?
关停消息出来后,社区里讨论很热闹。在 Hacker News 的原始前 30 采样里,这个话题排在第 8 位(299 分、77 条评论)。大家聊商业模式,也聊手头的项目怎么善后。
平时用这种高度集成的平台有多爽,搬家时拆解起来就有多琐碎。把代码下载到本地也就是几秒钟的事,但代码一脱离原平台就跑不起来。为了把这中间的断层说明白,我们不妨用一个常见的合成案例来贯穿全文:
合成案例:假设我们在线上跑着一个自动化小项目——先用一个 Webhook 接口接收外部推送的事件,把记录写进平台自带的 SQLite 数据库,然后再靠一个定时任务,每天凌晨汇总前一天的数据。
就这么一个小工具,光拿到源码文件是没法直接在新地方跑起来的,我们马上会撞上五个很实际的问题:
- 1
运行环境:离开原平台的云端运行时之后,代码的依赖包和启动方式怎么解决?
- 2
数据恢复:之前攒在 SQLite 里的历史记录,还有存放在 Blob 对象存储里的文件,怎么完整搬过去?
- 3
密钥管理:原来配在平台后台的环境变量和第三方密钥,在新环境里由谁提供?
- 4
任务触发:每天跑一次的汇总脚本,没了原平台的定时器,找谁来按时唤醒?
- 5
外部入口:外部系统还在往旧的
val.run地址发请求,切换的时候怎么不断联?
这五个问题,刚好对应了官方迁移文档里列出的代码、数据库、对象存储、配置、定时任务以及域名这几个大项。只有把这五类依赖全接上,项目才算真正活了过来。
Val Town 迁移清单,逐项处理五类依赖
为了防止搬家过程中漏掉东西,我们可以按“盘点什么、怎么迁、留什么验收证据”的思路,对手头的项目做一次彻底清理。
| 代码 | ||
| 数据 | ||
| 环境变量 | ||
| 调度 | ||
| URL |
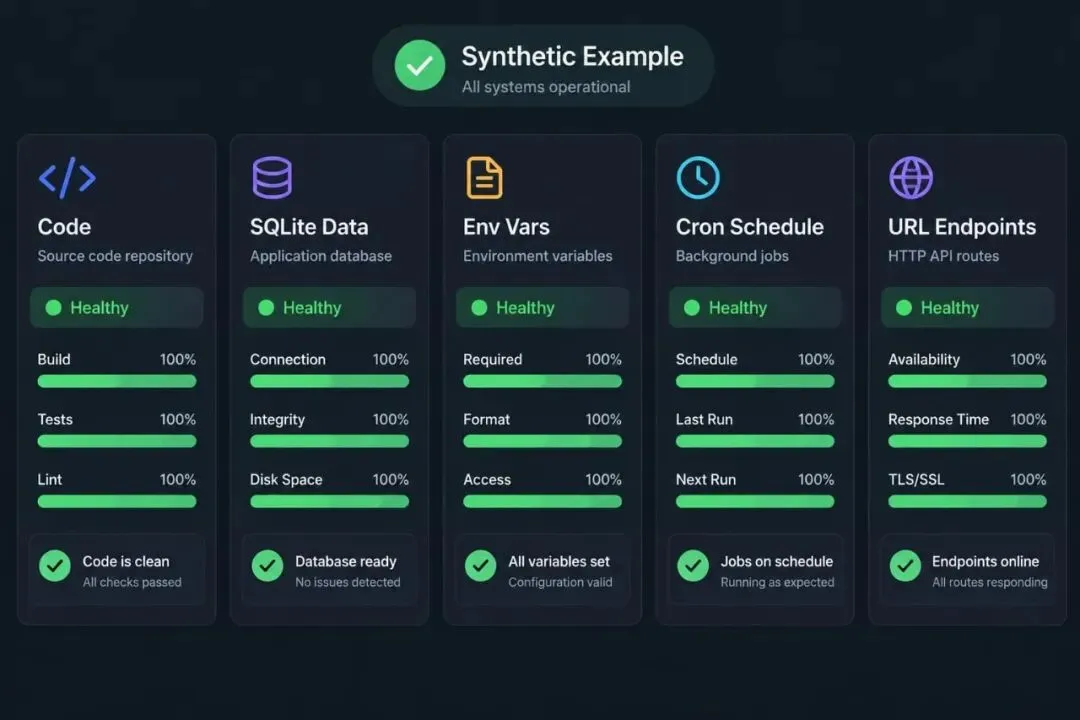
◇ 代码改造与解耦◇
- ◆
盘点什么:翻一下源码,看看有没有用到平台专用的 API,或者直接通过 URL 远程引入的第三方库。
- ◆
如何迁移:把单文件脚本改成标准的项目结构,补上依赖管理文件锁定版本号,再给原来的处理函数套一层标准的 Web 服务入口。
- ◆验收证据:记下项目的本地启动命令,用同一组固定请求分别打向旧接口和新接口,把两边返回的状态码和响应字段放一起比对。
- ◆
◇ SQLite 数据迁移与对象存储◇
- ◆
盘点什么:查清楚项目用到了哪些 SQLite 表、表结构定义、索引,以及 Blob 存储里的文件列表和元数据。
- ◆
如何迁移:照着官方的 SQLite 数据迁移指南操作,先核对好准确的数据库范围,做一次完整导出,再导入到新数据库里。
- ◆验收证据:这里最容易踩坑,千万别看终端里导入没报错,就觉得数据迁成功了。 官方文档也特别提醒要核对导入后的记录。稳妥的做法是把新旧库每张表的行数拉出来对比,再随机抽查几条记录的关键字段,以及核对 Blob 文件的数量和体积,确保没丢数据也没乱码。
- ◆
◇ 环境变量与密钥◇
- ◆
盘点什么:梳理代码里用到的所有环境变量名、各自的用途,搞清楚这些密钥当初是从哪个平台申请来的。
- ◆
如何迁移:本地留一份去掉敏感信息的配置清单模板,然后把真实的密钥逐个填进目标托管平台的配置面板里。
- ◆
验收证据:保留一份脱敏的配置清单,并在新环境里故意用对的密钥和错的密钥各测一次,确认鉴权逻辑真正起了作用。
◇ 定时任务迁移◇
- ◆
盘点什么:确认定时脚本的执行频率、使用的时区,以及万一任务重复执行会不会把数据搞乱。
- ◆
如何迁移:把定时逻辑拆成独立的脚本或内部接口,交给新平台的调度服务去触发,注意把时区对齐。
- ◆
验收证据:保存新平台的任务配置、首次触发的执行日志,并核对跑出来的业务结果跟以前是不是一致。
◇ URL 与外部入口◇
- ◆
盘点什么:把所有对外暴露的 Webhook 地址、公开分享链接、自定义域名以及填在第三方后台的回调地址全列出来。
- ◆
如何迁移:做一张旧新 URL 对照表,按调用方的特性分批替换。
- ◆
验收证据:留存对照表,并在切换后观察新入口的访问日志,确认外部请求已经顺利接进来。
Val Town 迁到哪里?
现在市面上能选的 Val Town 替代方案不少,官方博客和文档里也给出了 Cloudflare、Vercel、Netlify、Render 等平台的迁移指南。我们没必要把所有平台都罗列一遍,这里只拿前文的合成案例来走一条具体的路线,看看选型时到底要考虑什么条件:
合成案例路线:代码仓库 → Render Web Service → 托管 SQLite(如 Turso) → Render Cron Job*
为什么这个案例要专门接一个像 Turso 这样的外部托管 SQLite,而不是直接在 Render 上挂一块本地磁盘存数据库文件?
这完全是由项目结构决定的。在我们的案例里,接收 Webhook 的 Web 服务和做每日汇总的定时任务,需要读写同一份 SQLite 数据库。
翻看官方的 Render 迁移指南就能发现一个硬性限制:在 Render 上,本地 SQLite 依赖的持久磁盘(Persistent Disk)是没法在 Web Service 和独立的 Cron Job 之间共享的。如果图省事直接把数据库文件搬上磁盘,定时任务跑起来的时候根本读不到 Webhook 写进去的数据。所以遇到这种多组件共享数据的情况,就得选外部托管的 SQLite 服务。
当然,每个人的项目情况不同。如果手头的项目不需要跨服务共享数据库,或者用了别的对象存储和任务机制,完全可以按自己的实际需求,去翻看官方提供的 Cloudflare、Vercel 或 Netlify 迁移文档来定方案。
怎样验证迁移成功?
选好目标平台后,不建议直接拿线上环境和真实客户数据开刀。最稳妥的办法是在本地先做一次离线演练。下面整理的是一套待执行的演示方案,用来说明正式切换前怎么在本地把验证闭环跑通。
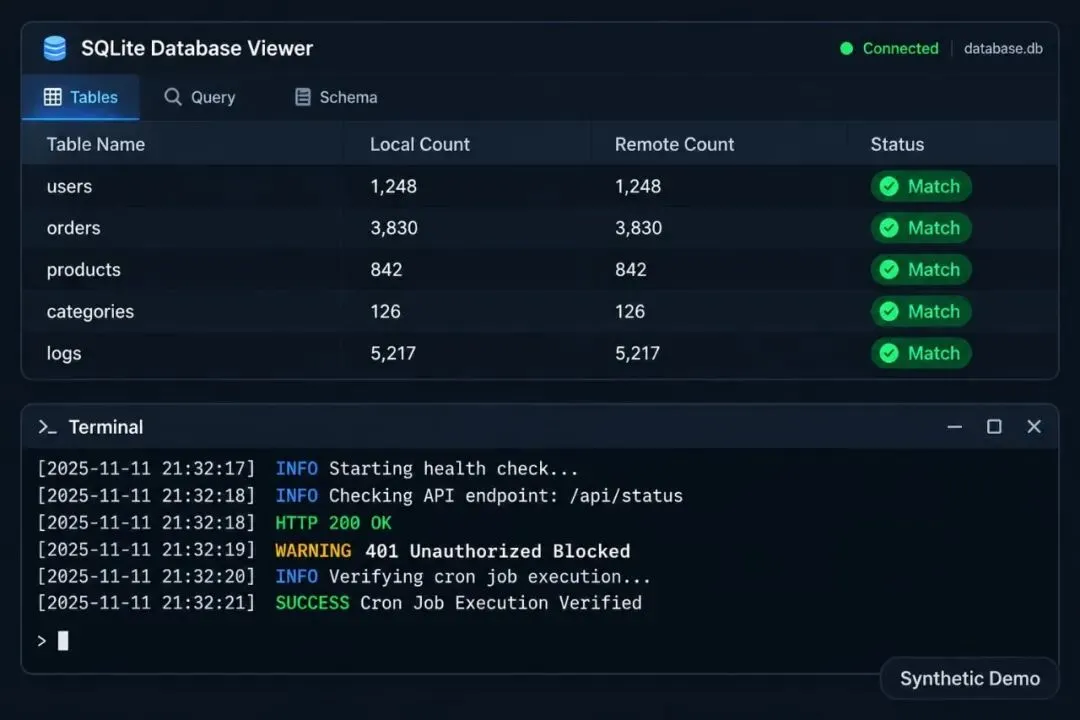
◇ 待执行的本地验证步骤◇
- ◆
准备测试物料:先造一批合成事件、一个测试用的 SQLite 数据库,以及一组固定的请求集合。
- ◆
本地拉起服务与数据库:在本地把改好的 HTTP 接口和 SQLite 跑起来。在这一步,我们可以用 ServBay 来充当本地运行与 SQLite 验证环境。ServBay 作为一个本地AI开发管理工具,内置了现成的运行环境和 SQLite 3 管理支持,拿来在本地快速拉起服务、导入并检查 SQLite 测试库非常顺手,不用自己在电脑上零散地配一堆环境。
- ◆
重放固定请求集:往本地接口依次打入正常请求、带错误密钥的无效鉴权请求,以及一模一样的重复事件。参考测试命令如下:
# 发送正常合成事件curl -i -X POST http://localhost:3000/webhook \ -H "Authorization: Bearer test_valid_token" \ -H "Content-Type: application/json" \ -d '{"event_id": "demo_01", "action": "created"}'# 发送错误鉴权请求curl -i -X POST http://localhost:3000/webhook \ -H "Authorization: Bearer wrong_token" \ -H "Content-Type: application/json" \ -d '{"event_id": "demo_02", "action": "created"}'- ◆
比对结果与落库记录:检查接口返回的状态码、关键响应字段对不对,再去本地 SQLite 里看一眼表行数有没有增加、业务记录准不准、重复事件有没有被拦住。
- ◆
手动跑一次汇总任务:手动触发定时脚本,核对生成的汇总输出是不是跟预期完全一样。
- ◆
上云做最终测试:等本地这套流程跑通了,再把代码部署到目标平台的测试环境里,去验证真实的云端定时调度和公网访问。
这里也得把边界说清楚:本地演练跑通,只代表我们在本地把代码逻辑和数据库验证过了;像 ServBay 这类工具帮我们解决的是本地验证环境的问题,等到真正上了目标云平台,云端的调度器、权限配置和公网入口依然需要单独验收。
最后再切换入口,Webhook 和旧链接怎么处理?
等新平台的服务、数据库和定时任务全都验证无误了,最后一步才是动外部入口。这一步如果顺序搞反了,很容易在切换期间漏掉外部请求。
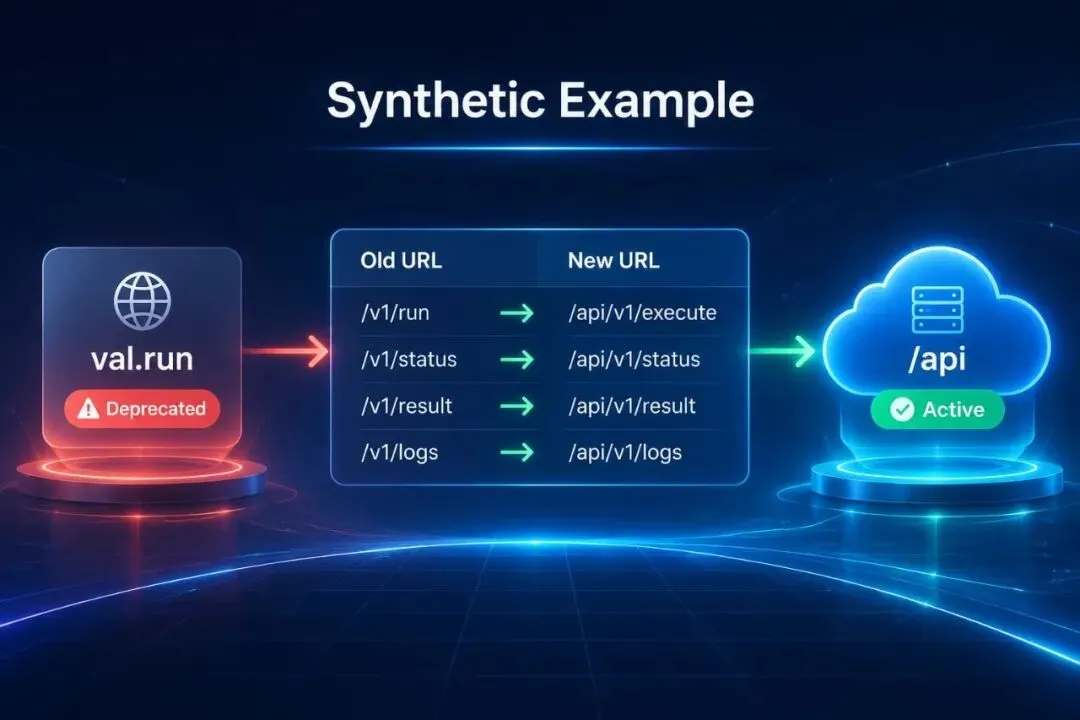
根据官方的重定向迁移文档,处理 Webhook 迁移和旧链接时,有四件事要按顺序办好:
- 1
先验新服务,再改旧入口:确认新服务和数据都妥当了,再去动线上的地址。
- 2
注意
val.run重定向的切断效果:官方文档写得很明白,一旦给某个项目设置了val.run重定向,原来的 val 实例就不再接收任何请求了。而且记得必须在 2026 年 12 月 10 日前把重定向设好。 - 3
Webhook 最好直接在发送方改地址:很多第三方平台的 Webhook 默认是不跟随重定向的。指望靠
val.run重定向来转发 Webhook 很容易丢事件,最稳妥的做法是直接去调用方后台,把目标地址换成新平台的 URL。 - 4
自定义域名去改 DNS:如果以前绑了自己的域名,直接去域名服务商后台修改 DNS 解析记录,指向新平台即可。
总结
回顾整套迁移流程,核心逻辑可以收敛为四个动作:
- ◆看准时间线:认清 2026 年 12 月 10 日锁定只读和重定向、2027 年 1 月 10 日停机断开服务的节奏,把旧入口配置提前到 12 月初完成。
- ◆带走全套依赖:把代码、SQLite 与 Blob 存储、环境变量、Cron 调度配置、外部 URL 五个模块一次性盘点清楚,不留遗漏。
- ◆选对数据架构:针对多组件读写同份数据的场景,优先考虑分离部署托管型 SQLite,绕开平台磁盘无法共享的技术约束。
- ◆先本地后线上:借助 ServBay 等本地环境完成接口与数据库的离线重放验收,最后再去线上直接更新 Webhook 地址,确保服务平稳过渡。
托管平台带来了极佳的开发便利,但面对平台调整,平时的轻量最终都需要一份扎实的退出方案作为保障。趁着停服前的窗口期,建议尽早为手头的项目梳理一份完整的依赖清单,在本地做好恢复演练,确保数据和业务能够稳妥平移到新的宿主环境中。
立即下载ServBay,加速你的工作效率