ARTICLE · 1353821
DeepSeek拆App,搜索5元千次
11 月 13 日晚,DeepSeek 把整个 App 拆成了接口:在 Messages、Responses、Chat Completions 里打开对应参数,V4.1-Flash 就能自动联网搜索、在思考链里多步检索并阅读链接、解析 PDF、Office 与图片,还带输入输出风控开关。搜索、抓取、OCR、语音识别、语音合成另有独立接口。官方说可以 1:1 复刻完整 App,并开源了一个能导入历史对话的前端 Demo(来源:IT之家,2026-11-13)。
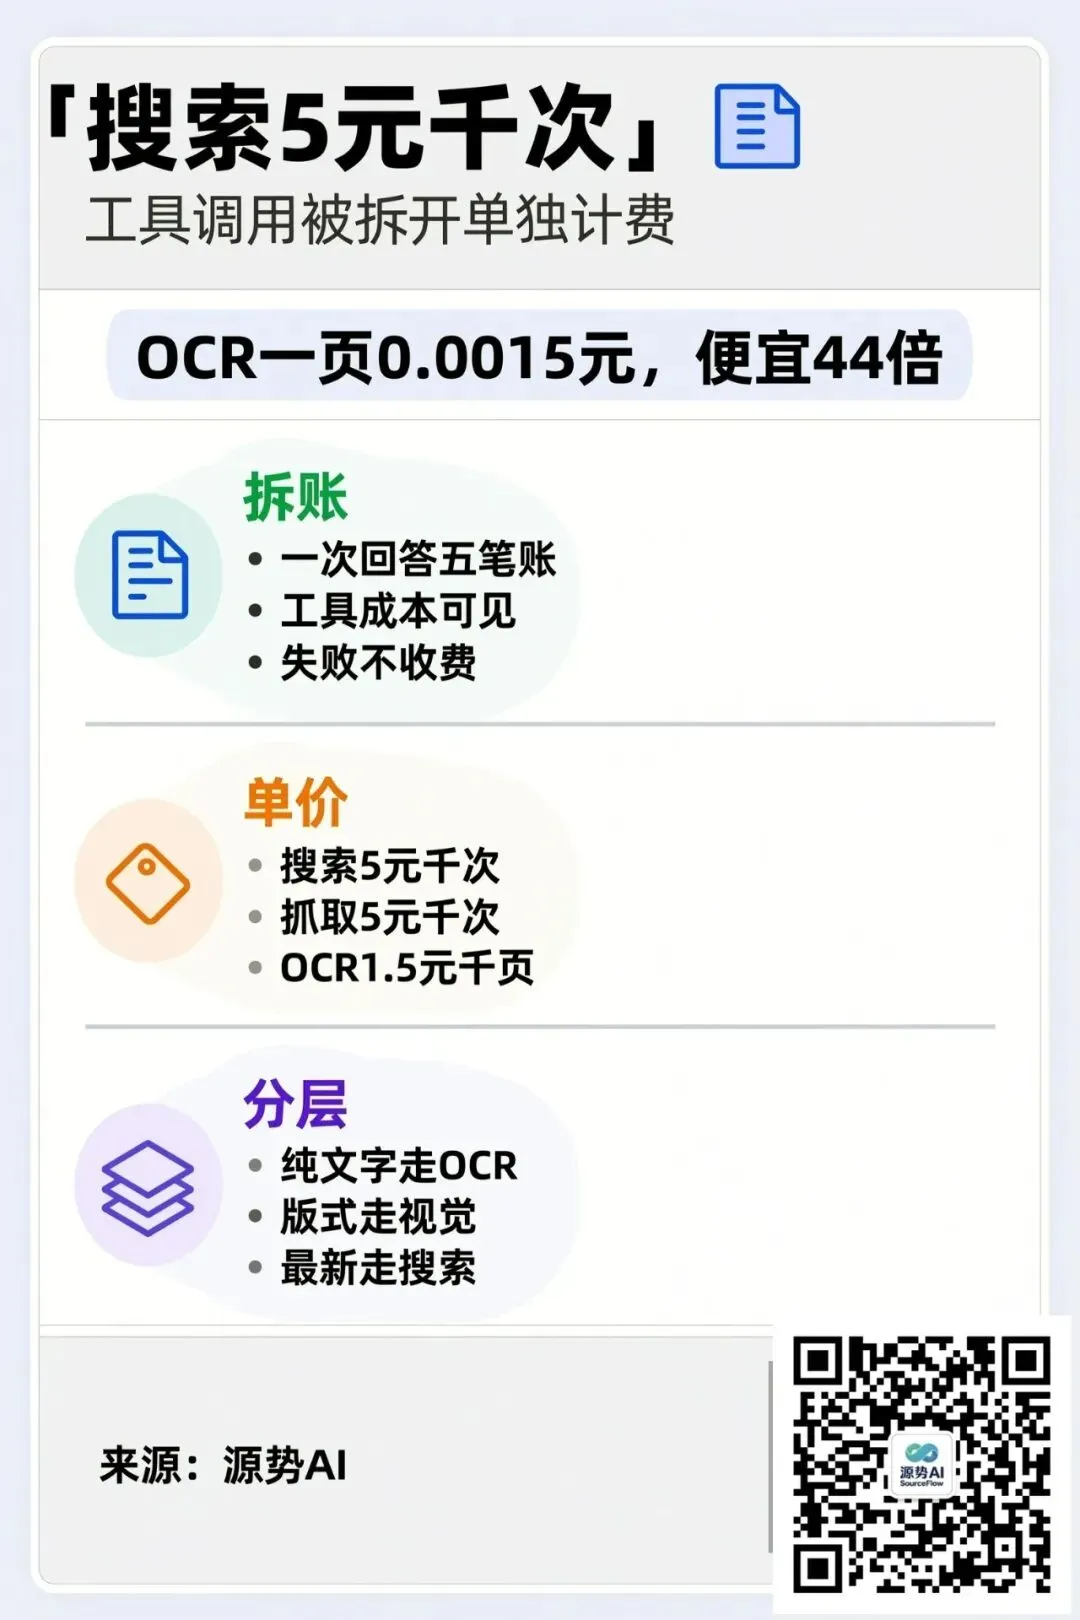
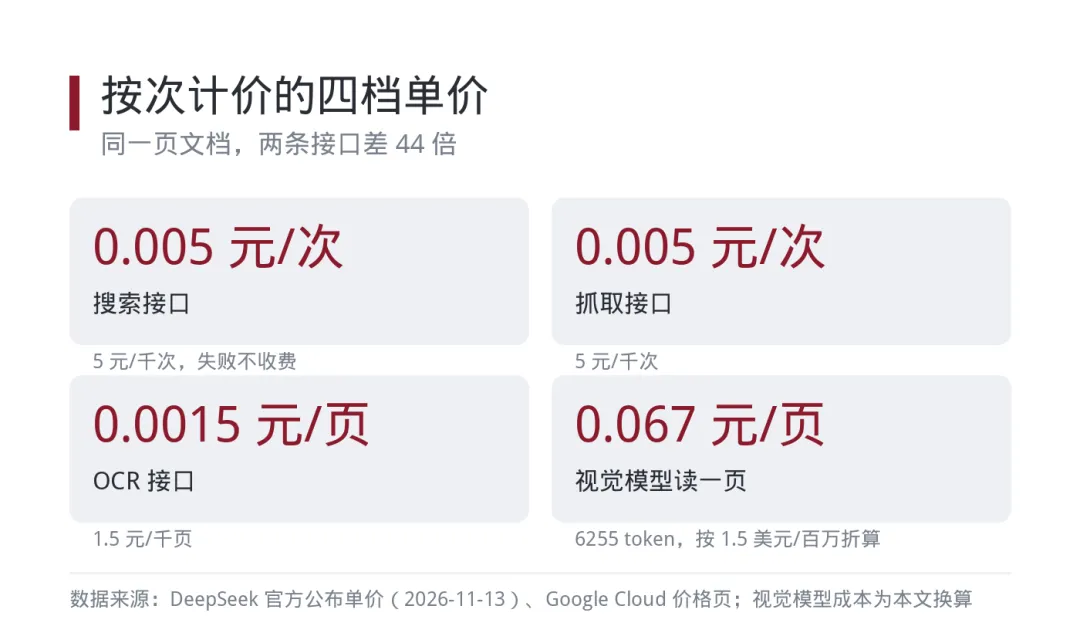
工具调用单独计费:搜索与抓取每千次 5 元,OCR 每千页 1.5 元。
按次计价这件事,DeepSeek 一个月前已经试过一次:10 月 17 日放出 Search 与 Fetch,按成功请求收费,每千次 5 元,免费期到 10 月 31 日,11 月 1 日起在 Harness、Claude Code、Codex 里经服务端调用开始收费(来源:钱江晚报,2026-10-17)。这次是把 OCR、语音这些也纳进同一套计价。
一、一次回答,变成五张账单
以前调用一个大模型,账只有一行:输入 token 加输出 token。
现在一次"帮我查一下这个政策、把附件读一遍、再念给我听"的请求,可能拆成五笔:模型 token、搜索 0.005 元、抓取 0.005 元、OCR 每页 0.0015 元、语音合成按量。
这笔账的意义不在单价高低,在可见性。工具成本从"隐式塞进输入 token"变成"独立列出来",采购方第一次能看清一次任务里哪一段最贵。
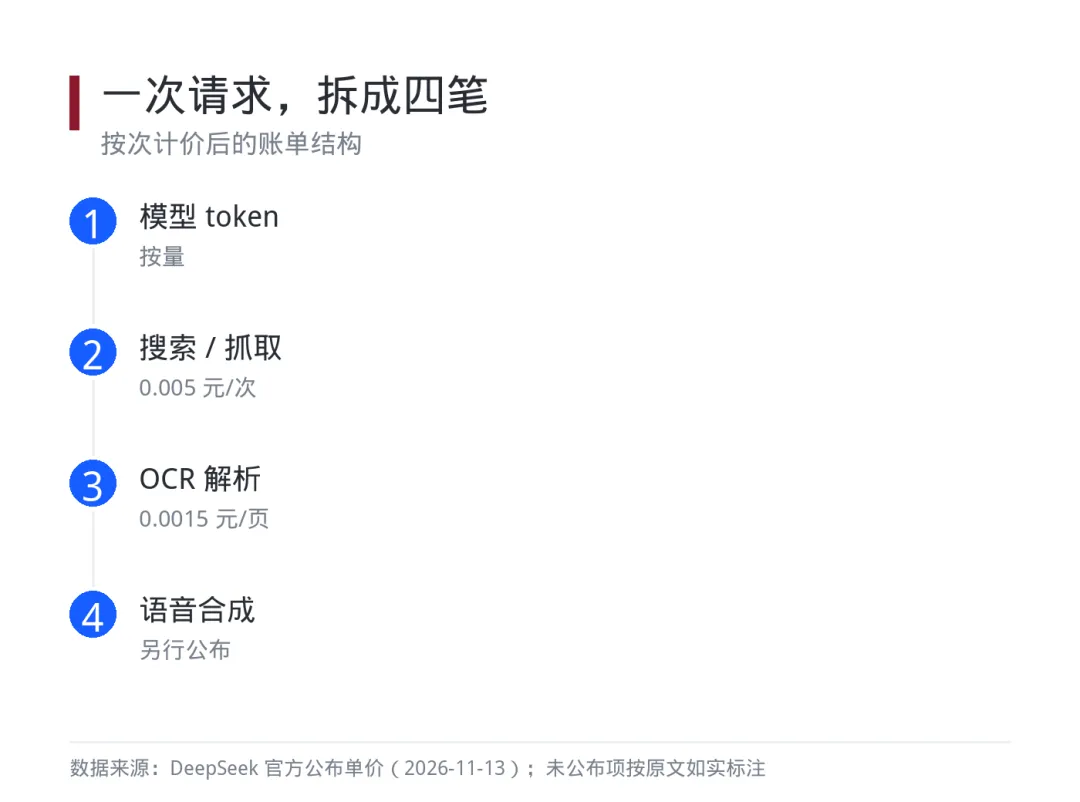
图注:同一句"查政策、读附件、念出来",在按次计价下拆成模型 token、搜索抓取、OCR、语音四笔,只有前三笔有公开单价。数据来源:DeepSeek 官方公布单价(2026-11-13)。
与之对照的是另一条口径。Google 的价格页上,图像输入早就按固定档计价:Gemini 3 每张图 258 个 token,不随分辨率变(来源:Google Cloud 模型价格页,2026-11 查询)。也就是说,一部分厂商在把复杂输入压成可预测的固定值,另一部分厂商在把复杂流程拆成可计价的独立单元。两条路都在做同一件事:让账单可算。
二、0.005 元一次搜索,贵不贵看抓回多少字
5 元一千次,单次 0.005 元。这个价格本身说明不了贵还是便宜,要看一次搜索抓回多少内容、这些内容原本要以什么形式计费。
旧口径下,抓回的网页会变成巨量隐式输入 token 计入账单(来源:《大模型 API 定价策略定量分析框架与成本测算》,研究报告/11-AI-Fundamentals)。一次搜索抓回三万字网页,中文按约 1.5 字一个 token 粗算,是两万个 token;按输入价 1.5 美元每百万 token 折算是 0.03 美元、约 0.21 元。同一件事按次计费是 0.005 元,差 40 倍。
所以按次计费省的不是"搜索本身",省的是两件事:一是长网页、多轮检索的场景,二是失败重试的浪费。前者按内容量算本来就贵,改成按次就便宜;后者在按成功计费的规则下,失败请求不收费。
反过来说,高频短查询会变贵。一个每天跑十万次、每次只查一句话的场景,按次计费是每天 500 元,而这些查询在 token 口径下可能只值几十元。
图注:同一批查询在两种口径下的成本随单次抓回内容量变化:内容越长,按次越划算;查询越短越频繁,按 token 越划算。示意图按公开单价与 1.5 美元每百万 token 的输入价换算,实际账单还受缓存与重试影响。
三、OCR 一页 0.0015 元,比视觉模型便宜 44 倍
这条参数最容易被忽略,但它可能是这次更新里对企业最实际的一条。
0.0015 元一页,等于 100 万页 1500 元。同样一页 A4 扫描件,如果直接送进视觉模型,按 300dpi、2480×3508 像素、Claude 口径算是 6255 个 token,按 1.5 美元每百万 token 折算是 0.067 元一页。
差 44 倍。
当然两者不等价:OCR 只给文字,不给版式理解、不给版面结构、不给"这张图里画的是什么"。能替代的场景是纯文字提取——发票号码、合同条款、身份证信息,这些只需要字对。
差 44 倍这件事的真正含义是:把任务按能力分层的价值,远大于在单一模型上省 token。该用 OCR 的用 OCR,该用视觉模型的用视觉模型,混着用就是给简单任务付复杂能力的钱。
这条思路在检索侧也成立。香港科技大学(广州)的 PRIME 论文指出,检索优化的注意力几乎都在查询侧,语料侧被简化成"分块";他们在索引之前做元数据合成与层级检索,达到结构感知分块的检索质量,同时把嵌入计算降低 45.8 倍、索引向量数降低 22.4 倍(来源:《PRIME:面向结构化文档检索的预检索索引建模》,arXiv:2610.13296)。同样是"分层做对",省下的是数量级。
四、两种定价哲学,对着干
把 DeepSeek 和 Google 放在一起看,会发现两家在往相反方向走。
一家把复杂输入压成固定值:每张图 258 个 token,不管你传的是缩略图还是扫描件。另一家把复杂流程拆成独立单价:搜索一次多少钱、OCR 一页多少钱、语音一秒多少钱。
前者的好处是账单可预测,坏处是复杂输入被打折处理;后者的好处是每段成本可见,坏处是结算复杂、失败判定容易扯皮。
对采购方,这两条路的应对方式不同。走固定档的,要盯"我的输入有没有被压得看不清";走按次的,要盯"什么算一次成功"。
DeepSeek 这次把"失败、无结果、超时三类不收钱"写进了文档,边界比多数同类产品清楚。真实业务里的"半成功"——抓回来一页营销软文、一段与问题无关的正文——按哪类算,还得看实际账单。
五、对企业意味着什么
第一,先拉一次工具调用基线。把线上的搜索、抓取、OCR、语音调用量按天统计出来,乘上单价,估一遍月度账单。没有基线的团队,等免费期一过才发现成本结构变了。
第二,按任务分层选接口。纯文字提取走 OCR,需要理解版式的走视觉模型,需要最新信息的走搜索。分层的收益不是几个百分点,是几十倍。
第三,把重试率当成一等指标。按次计费下,重试就是钱;按 tokens 计费下,重试藏在输入里看不见。两种口径都需要统计"一次成功需要几次调用",这个数字决定真实单价。
第四,别只比标价。0.005 元一次的搜索,如果 30% 的请求抓回的内容与问题无关,真实成本是 0.007 元一次;而一个贵一点但命中率高的通道,总账可能更便宜。
未知与边界
能力边界:官方称可 1:1 复刻完整 App,这是产品口径;工具链在长尾站点上的稳定性、对反爬页面的处理、对复杂 PDF 的解析成功率,都需要自有数据实测。
价格边界:本次公布的单价是搜索抓取 5 元每千次、OCR 1.5 元每千页,语音类单价未在文中给出;免费额度与阶梯折扣是否延续,官方未说明。
口径边界:本文的成本换算是按公开单价与固定假设做的粗算,不含缓存命中、批处理折扣、重试与失败请求,实际账单会更高。汇率按 7.1 折算,仅用于量级比较。
源势AI观点
按次计费对企业的真正价值,是把"我到底为哪一步付钱"这个问题摆到桌面上。以前一次调用的账单是一团,现在至少能拆成模型、检索、解析、语音四段。
我们做统一网关时把这件事做在计量层:每一次调用记录模型、工具、耗时、token 与工具次数,按业务线出账。客户因此能看到"这个月检索花了多少、解析花了多少、哪个团队用得最多"。账单拆得开,优化才有的放矢;拆不开,就只能砍总量,最后砍掉的是最该保留的那部分。
来源说明:本文数据线索来自当日行业汇编《AI行业24小时_20261114_10》第 10 条与知识库既往定价笔记;DeepSeek 工具单价为官方公布口径,1:1 复刻 App 为官方表述,未获第三方验证。
话题标签:#按次计费 #OCR #工具调用
源势AI · 企业级 AI 基础设施服务商
AI 能力的连接器,企业增长的源动力
AI Infra:算力、模型与 Token 的统一调度治理
Agent Infra:智能体的编排、安全与规模化落地
共享统一网关 · 身份 · 计量 · 审计
官网 www.srcflow.cn | 邮箱 business@srcflow.cn
关注我们 · 获取更多 AI 前沿洞察
推荐阅读