ARTICLE · 1355510
网上说 AI 读长 PDF 会漏后半段:我造了 67 页文件试了一遍
网上说 AI 读长 PDF 会漏后半段:我造了 67 页文件试了一遍网上关于 AI 读 PDF,流传最广的一句差评是:读长文件会漏,后半段的信息悄悄丢。 有博主说拿几十页的 PDF 让 AI 提取关键信息,逐段核对后发现后半部分条款被遗漏,还出现了编造的内容。 这个说法是真的吗?我决定不转述,直接试。 要验证「漏没漏」,得先知道标准答案。我的做法: 造一份67 页的《智能设备售后服务协议》,在其中 5 个位置埋入互不相同的检查点条款,从前到后均匀分布: 第 2 页:违约金上限为合同总金额的 3% 第 16 页:维修周期最长 45 个工作日 第 33 页:数据备份责任由用户承担 第 49 页:延保服务每年 199 元 第 64 页:2026 年 11 月 1 日生效,有效期两年 这 5 条散在四千多行正文里,前后各半。如果「后半段会漏」是真的,第 49、64 页那两条必然失踪。 然后让 WorkBuddy 提取这份 PDF 里涉及金钱和期限的条款。 从开始提取到拿到结果,不到 2 秒。 5 个检查点,全部提取到位——包括最靠后的第 64 页那一条。「后半段会漏」这件事,在这份文件上没有发生。 而且它提取的不是关键词匹配那种粗暴抓取:违约金条款带出了「超出部分甲方有权拒绝支付」,维修条款带出了「超期按每日千分之五支付滞纳金」——上下文是完整的。 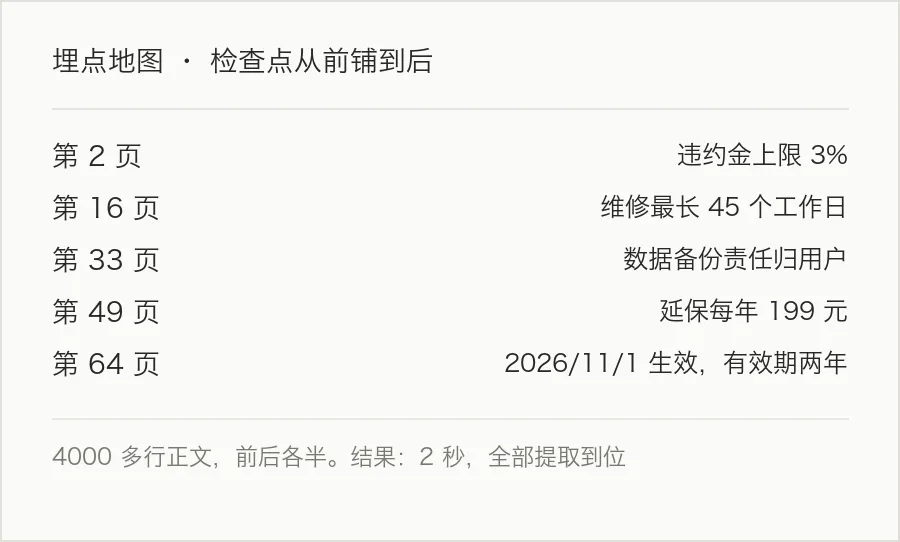
我的实测没漏,不代表那些吐槽是编的。对得上号的解释有三种: 第一,PDF 分两种,很多人拿到的是「假 PDF」。文字型 PDF(能选中复制文字的)提取很稳;扫描型 PDF(拍照、扫描转的,本质是一张张图片)没有 OCR 引擎就读不出字——WorkBuddy 的说明里明确写了:当前不自带 OCR,遇到扫描页会报错。很多人的「漏了」,其实是「根本读不了」,只是报错被当成了空白。 第二,AI 的确会「补全」。跨段落传递信息时,上下文被稀释,AI 会补一段它认为合理、其实没依据的内容。这不是读漏,是幻觉——发生在「总结」环节,不是「提取」环节。数字、条款这类硬信息,永远要回原文核对。 第三,工具自己都不打包票。WorkBuddy 的说明文档原话就写着:提取结果可能遗漏文字或打乱顺序;重要结论应能定位到原 PDF。一个工具敢在说明里写自己的短板,比拍胸脯说「100% 准确」的可信。 第一步,先验明正身。打开 PDF 试着选中一段文字。能选中 → 文字型,放心交给 AI;选不中 → 扫描型,先过 OCR,或者干脆人工看。 第二步,用「提取」别用「总结」。让它把涉及金额、日期、责任的条款原样列出来并标注位置,而不是「帮我总结要点」。提取可核对,总结不可核对。 第三步,关键数字抽验。提取结果里挑两三个最要命的数字(违约金、期限、金额),翻到原 PDF 那一页对一眼。这一步花的两分钟,是 AI 时代对重要文件的基本尊重。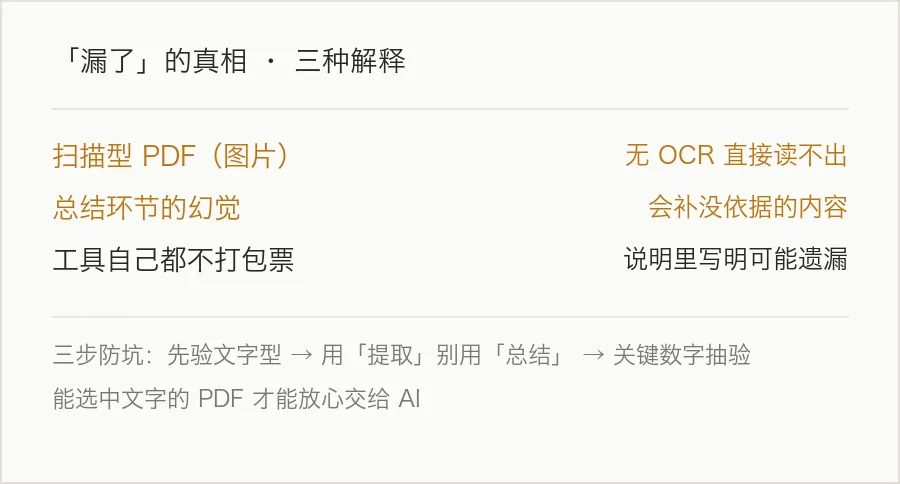
最后 「AI 读长 PDF 会漏」这句话,对了一半: 漏的不是页数,是你没确认它是文字型、没做关键数字抽验。 工具替你读四千行,你替工具核四个数——这笔分工,划算。
本文实测环境:WorkBuddy 桌面版,测试文件为 67 页文字型 PDF(约 4000 行、含 5 个预埋检查点),提取端到端耗时 2 秒。扫描型 PDF 表现受本机 OCR 环境影响,以你实际使用为准。
一、造一份「带答案」的 PDF
二、结果:2 秒,5 条全中
三、那「漏了」的吐槽是哪来的
四、实用建议:三步让 AI 读 PDF 不坑你