ARTICLE · 1358163
读完 OpenAI Symphony 源码:AI 编程的差距,正在模型之外拉开
读 Symphony,最容易先被“工单自动变成代码”吸引。顺着实现往下看,我反而更在意一个小细节:worker 正常退出以后,调度器并不认为事情已经做完,还会在约一秒后回来看一眼。
这个处理很能说明 Symphony 在做什么。模型结束了一轮对话,和团队完成了一项工作,中间还隔着测试、审查、工单状态,以及一堆可能出错的外部操作。让 Agent 启动一次并不难,难的是把这些边界管住。
OpenAI 的原始博客也不是从模型能力讲起的。Alex Kotliarskyi、Victor Zhu 和 Zach Brock 写道,团队已经把仓库做成了适合 Agent 工作的环境,接着遇到的新瓶颈是 context switching——人忙着在几个会话之间切换。每个 Agent 都在干活,工程师却成了负责派活、催进度和转发消息的人。
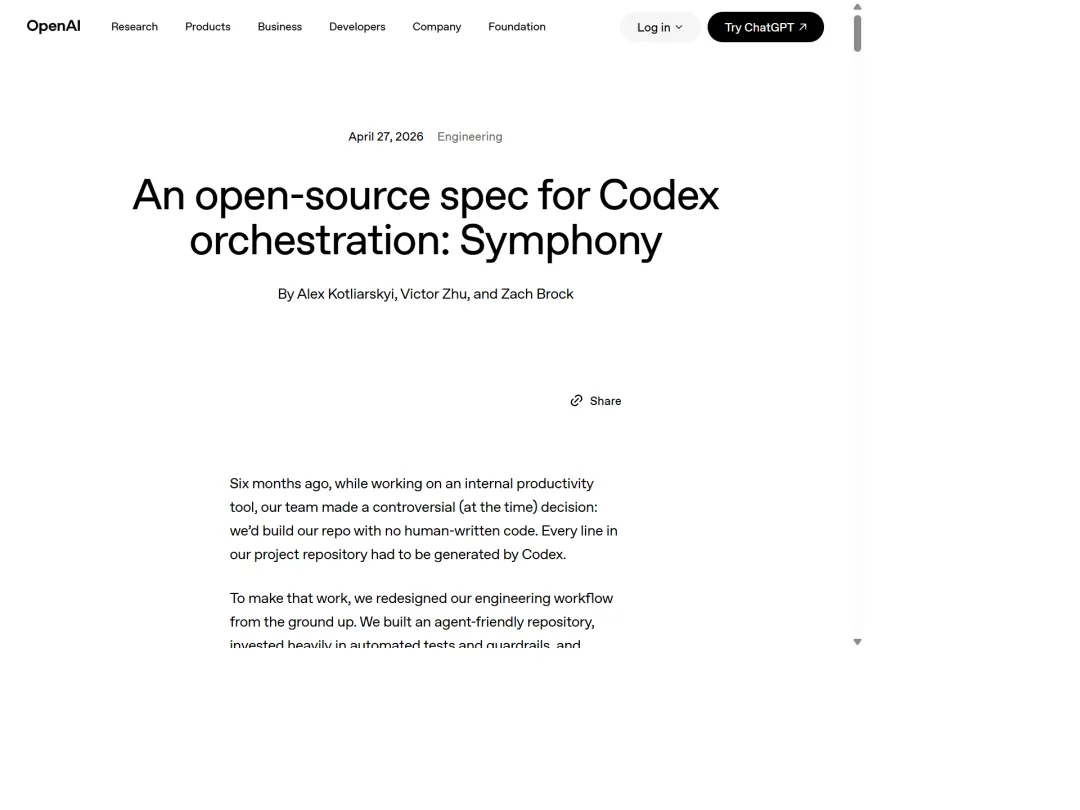
原始材料 A:OpenAI 博客实拍,保留标题、2026-04-27 发布日期和三位作者署名。来源:Symphony 原始博客,截图于 2026-11-15。不是本文制作的观点卡片。
Symphony 的办法,是让任务看板接管“谁该开始、谁还在做、谁应该停”的调度。至于怎么修代码、怎么测试、什么时候贴 PR,大量细节仍由 Codex 按仓库工作流执行。它不是一个包办研发决策的超级 Agent,更像接在编码工具外面的常驻调度服务。
我对这套设计的判断是:它把人的操作习惯拆成了明确的生命周期,但没有把“任务执行结束”偷换成“交付已经正确”。 后面值得细读的代码,几乎都与这个区别有关。
这篇沿用 be10a1b79df7 的 Elixir 实现:提交日期 2026-09-15,源码于 11 月 11 日获取,11 月 15 日补充原始材料与评论。分析基于静态调用链和仓库测试阅读,没有连接真实 Codex、工单系统,也没有运行上游测试。 博客讲团队经验,代码说明该版本怎么做,本文判断另行标明。
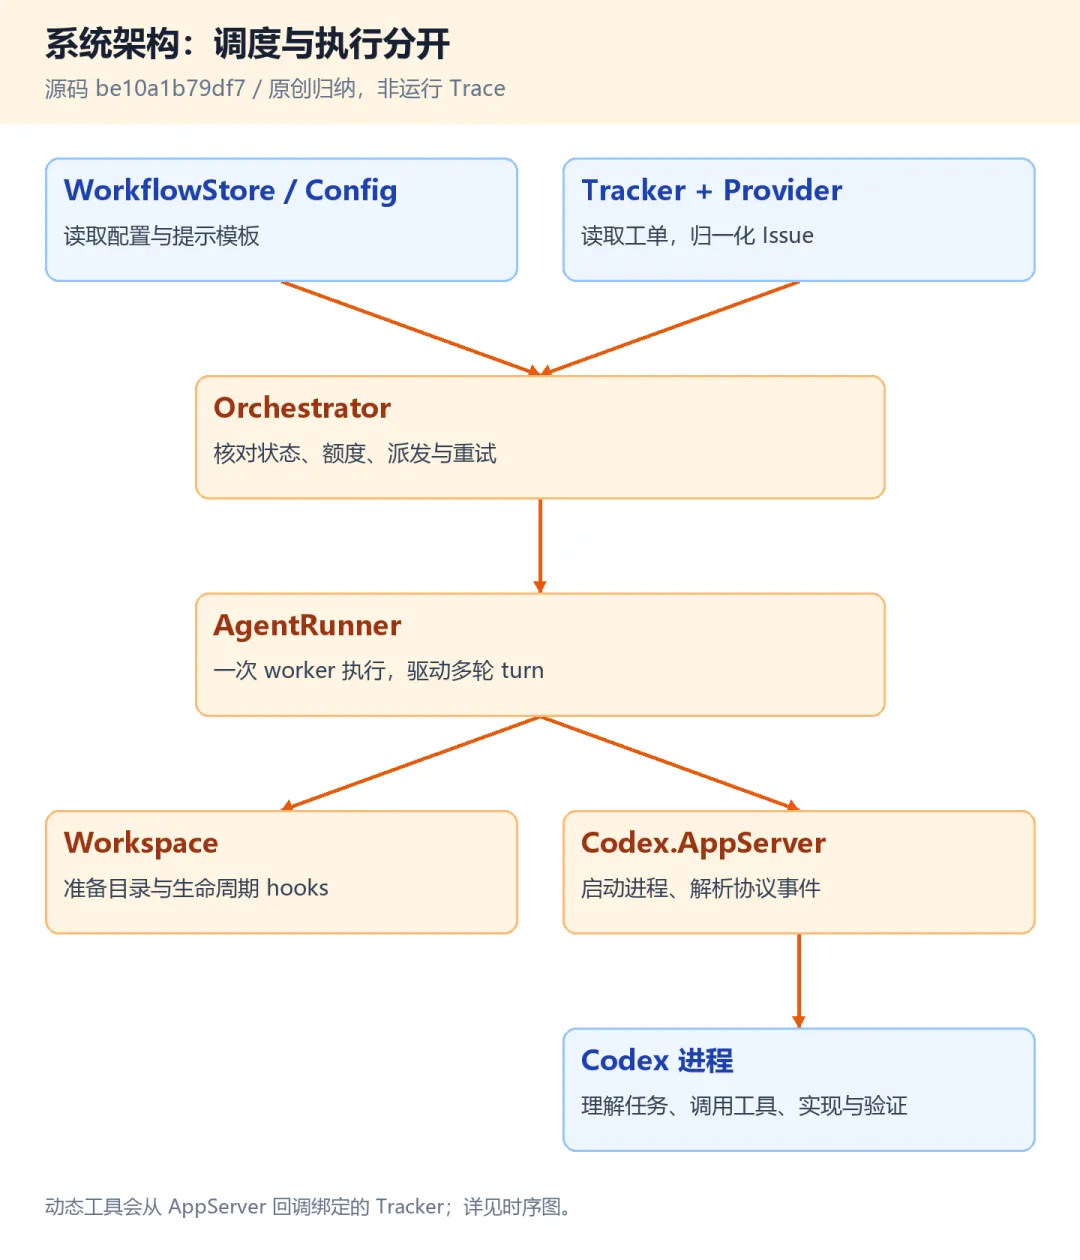
图 1:主干调用架构。实线表示调用或派发,图中省略日志与展示组件。Tracker 既提供读取边界,也能为 Agent 暴露原生工具;不能据此把调度器理解成所有业务动作的执行者。
本文目录
一、代码地图:先认清各文件负责什么 二、启动与监督树:为什么不是所有进程都单独重启 三、一次调度:先核对,再抢工位,再派发 四、工作区生命周期:隔离、复用和 hooks 五、AgentRunner:一张工单里的两层执行循环 六、Codex 协议:不是抓终端文字,而是处理结构化事件 七、退出、重试、阻塞:真正的调度状态机 八、业务工作流:Human Review 为什么能让 Agent 停下来 九、配置热更新与可观测性:如何让常驻服务可运营 十、把作者的判断放回源码,哪些成立,哪些还要自己补
一、代码地图:先认清各文件负责什么
我建议从入口和调度器读起。先弄清服务如何活着,再去读提示词里希望 Agent 做什么;这两件事不总是一回事。
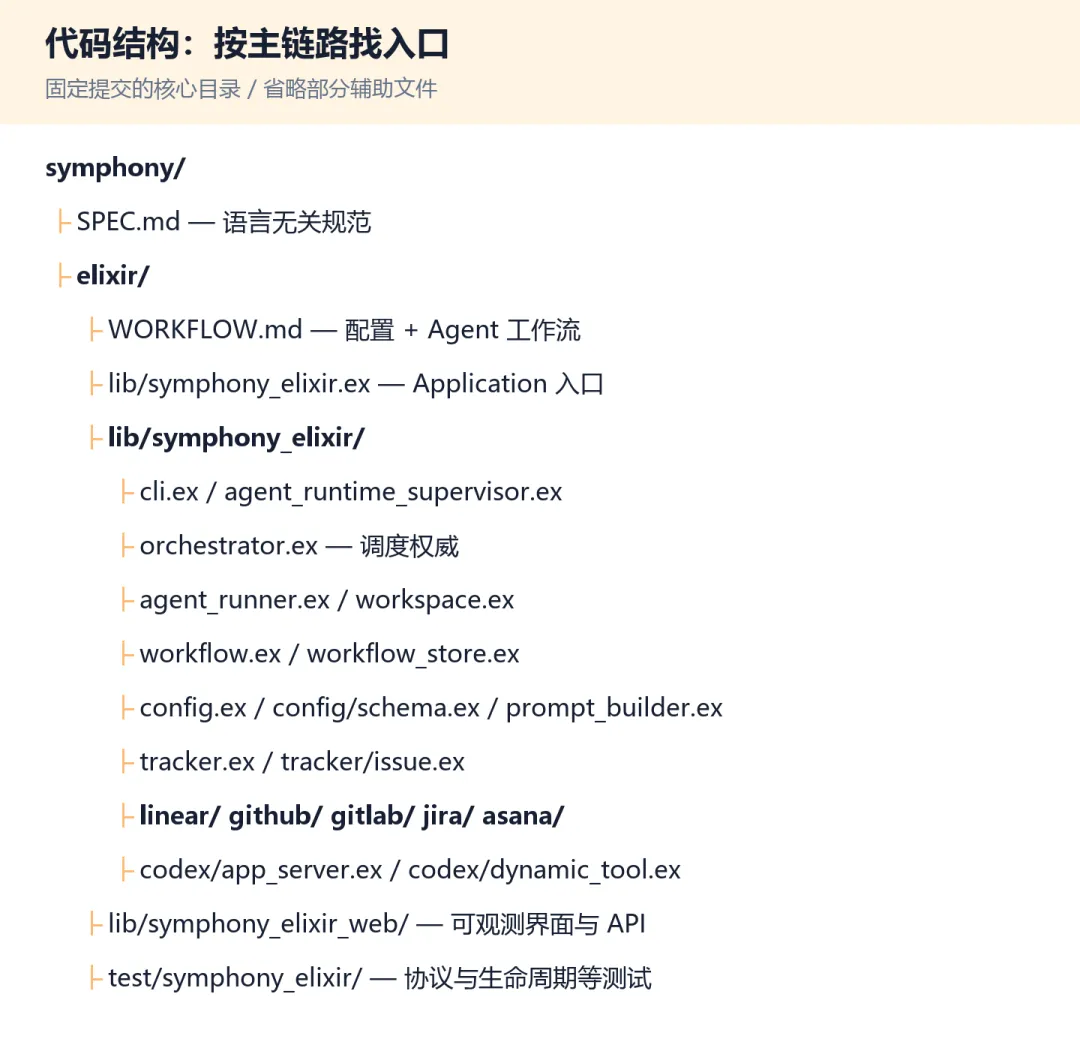
图 2:与主链路相关的代码结构,省略静态资源、部分辅助模块和 provider 内部文件;不是完整目录清单。图中目录层级对应固定版本。
evaluate/2 | ||
maybe_dispatch/1 | ||
run/3 | ||
create_for_issue/2 | ||
start_session/2run_turn/4 | ||
fetch_issues_by_ids/1 |
另外三块不要漏掉:Workflow 负责拆 YAML 与正文,WorkflowStore 缓存最后一份有效工作流,PromptBuilder 用 Solid 模板把工单数据填进提示词。
当前版本并非只有 Linear:Tracker 注册了 Linear、GitHub、GitLab、Jira、Asana,以及用于测试等场景的 Memory 适配器。后文用 Linear 举业务例子,但调度核心依赖的是统一 Issue。
一个容易找错的位置:Application 模块定义在顶层的 symphony_elixir.ex,不是单独的 application.ex。
二、启动与监督树:为什么不是所有进程都单独重启
常见 escript 路径是 CLI 解析参数、确认工作流文件,然后启动 OTP Application。CLI 还要求一个明确的工程预览风险确认开关;本文不建议把它当作生产安全配置。
应用监督树使用 one_for_one,下面包括 WorkflowStore、AgentRuntimeSupervisor、可选 HTTP 服务、状态展示与 PubSub。
真正关键的是第二层:
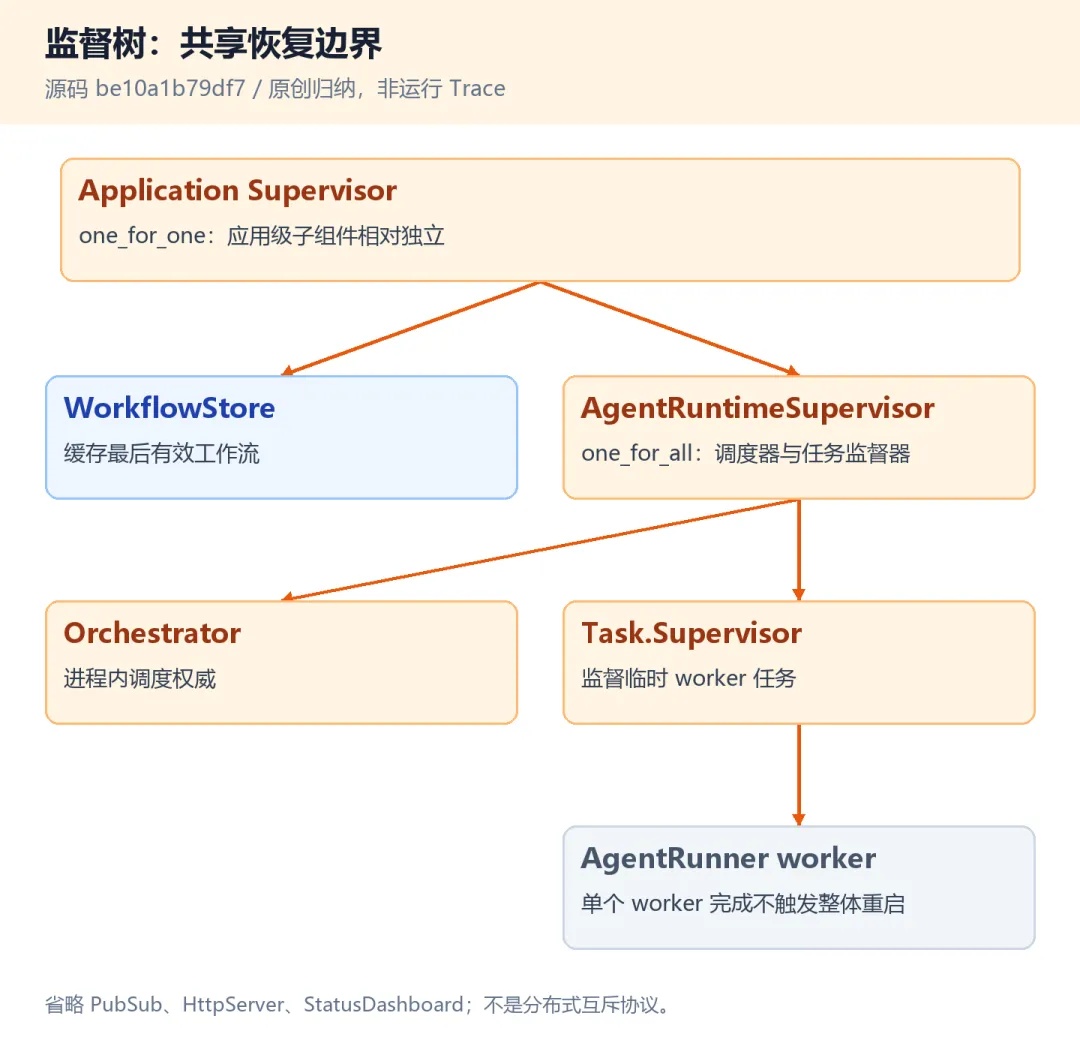
图 3:应用层为 one_for_one;AgentRuntimeSupervisor 内部为 one_for_all。TaskSupervisor 下的临时任务不会因为某个 worker 正常完成就整体重启。图中省略展示与 PubSub 的内部进程。
AgentRuntimeSupervisor.init/1 将 Task.Supervisor 与 Orchestrator 放在 one_for_all 下。
为什么?Orchestrator 的 running 和 claimed 在内存里。如果它崩溃重启,旧任务却继续活着,新调度器又从看板发现同一张工单,就可能重复执行。
把两者放进相同恢复边界,是为了避免“新调度器失忆,老 worker 还在干活”。仓库的 重启测试 会杀掉调度器,检查任务监督器也换成新进程,旧 worker 退出,并且重新派发时不出现重叠。
这比“Elixir 适合并发”这个泛泛的评价具体得多。这里用 OTP 解决的是所有权问题:调度器失去记忆以后,不能还留着一群它已经不认识的执行者。
不过,保护范围到当前运行树为止。如果两套 Symphony 同时盯同一块看板,进程内的 claimed 不是分布式锁;旧任务已经发出去的评论、PR,也不会随着 worker 退出自动撤回。
三、一次调度:先核对,再抢工位,再派发
Orchestrator 是一个 GenServer。它接收 tick,执行轮询,再为下一轮安排定时消息。这个循环的开头有点反直觉:先不急着捞新任务,而是检查旧任务还该不该继续。
maybe_dispatch/1 的开头就体现了这个优先级:
state = state |> reconcile_running_issues() |> reconcile_blocked_issues()随后才验证配置、获取候选工单、检查全局额度,并选择任务。
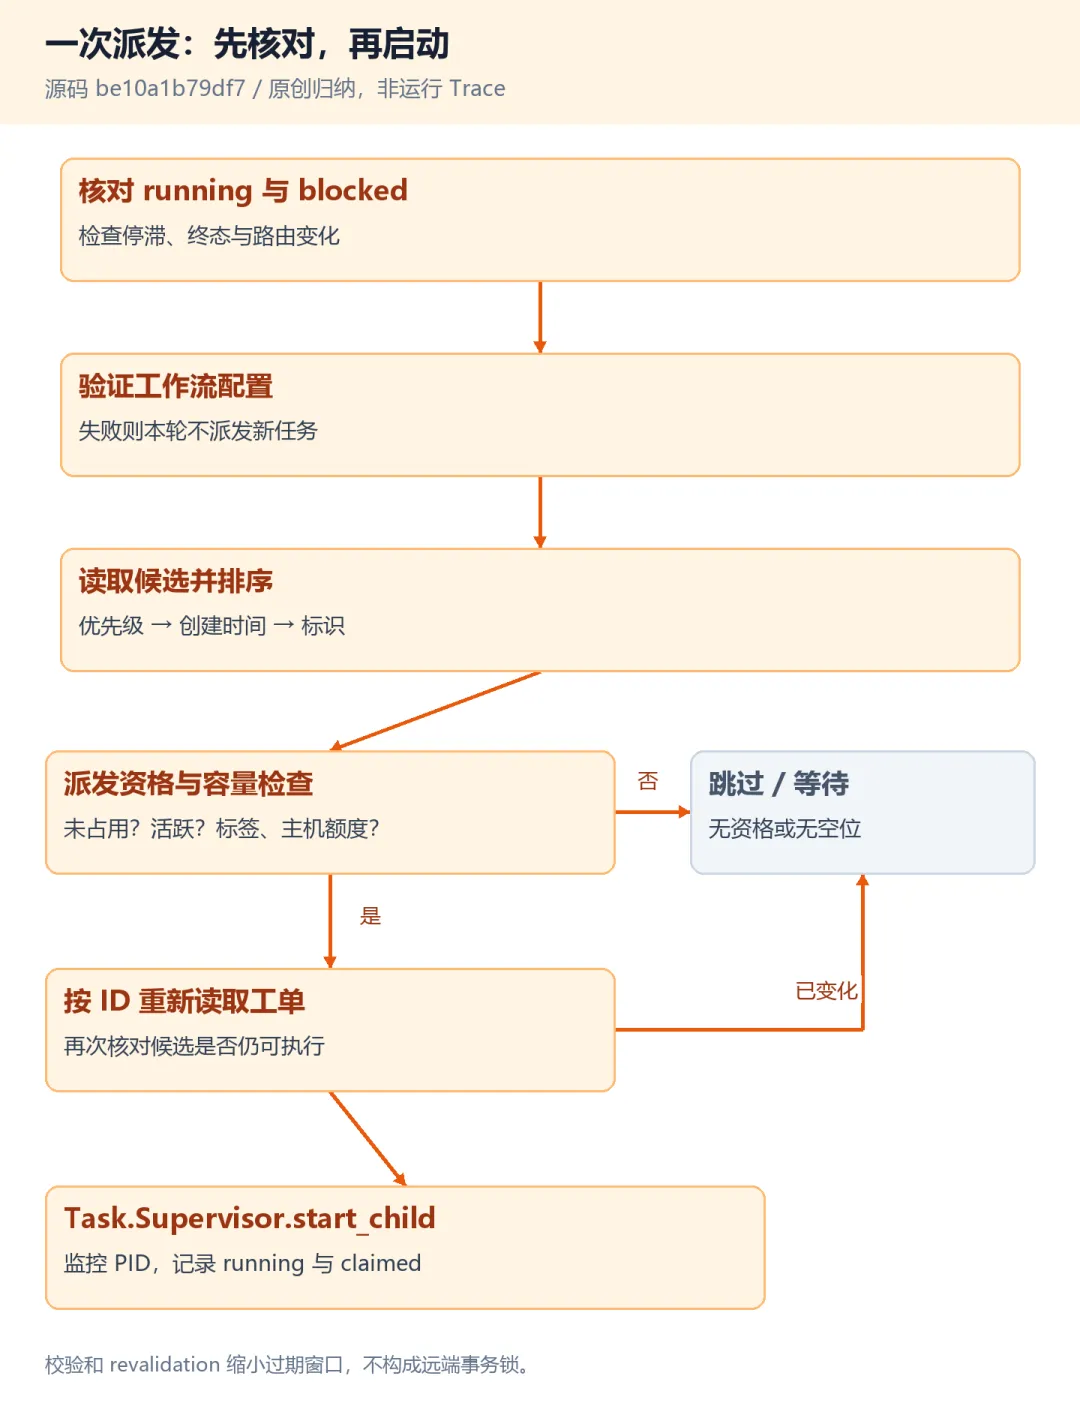
图 4:轮询主路径与跳过分支。派发前还有一次按 ID 读取的 revalidation;图中“等待下一轮”表示不派发该候选或该轮不继续派发,不代表已经运行的 worker 必然停止。
3.1 为什么要重复读工单?
第一次列表查询与真正启动之间,工单可能已经被取消、转移负责人、拿掉标签,或者进入审查。
因此,dispatch_issue 并不直接启动 worker,而是先调用 refresh_issue_for_dispatch。后者重新按 ID 读取,再检查是否仍为可派发候选。
想一个具体场景:调度器刚读到 Todo,人已经把它改成“暂不处理”;如果马上启动 Agent,它就会花钱做一件已经不需要做的事。再读一次是在减少这类浪费,不是给远端工单系统加事务锁。检查之后状态仍可能变化,后面还得继续 reconcile。
3.2 “能派发”不只等于 Todo
should_dispatch_issue?/4 还检查:
必要字段是否完整,状态是否活跃且非终态。 dispatchable与必需标签是否匹配。 是否已被 claimed、正在 running,或停在 blocked。 全局、对应业务状态、worker 主机是否还有额度。
候选按优先级、创建时间、标识排序。代码将 1—4 视为有效优先级,其余排在后面,并不是任意整数越小越优先。
依赖关系的处理也要看适配器。Linear.Client 把负责人和 blocker 情况折算成 dispatchable,其中未结束的 blocker 对 Todo 派发有特别检查。不能据此宣称 Orchestrator 内建了通用 DAG 引擎。
dispatchable 是 provider 的判断,容量和占用是调度器的判断。这就是适配器边界的价值。
四、工作区生命周期:隔离、复用和 hooks
派发成功后,Orchestrator 通过 Task.Supervisor 启动 AgentRunner,监控其 PID,并把工单写进 running 和 claimed。
AgentRunner 首先调用 Workspace。目录 key 由工单的可读 identifier 派生:正常字符可直接使用;需要替换特殊字符时,再追加原始 identifier 的短哈希,减少不同标识清洗后撞名的风险。
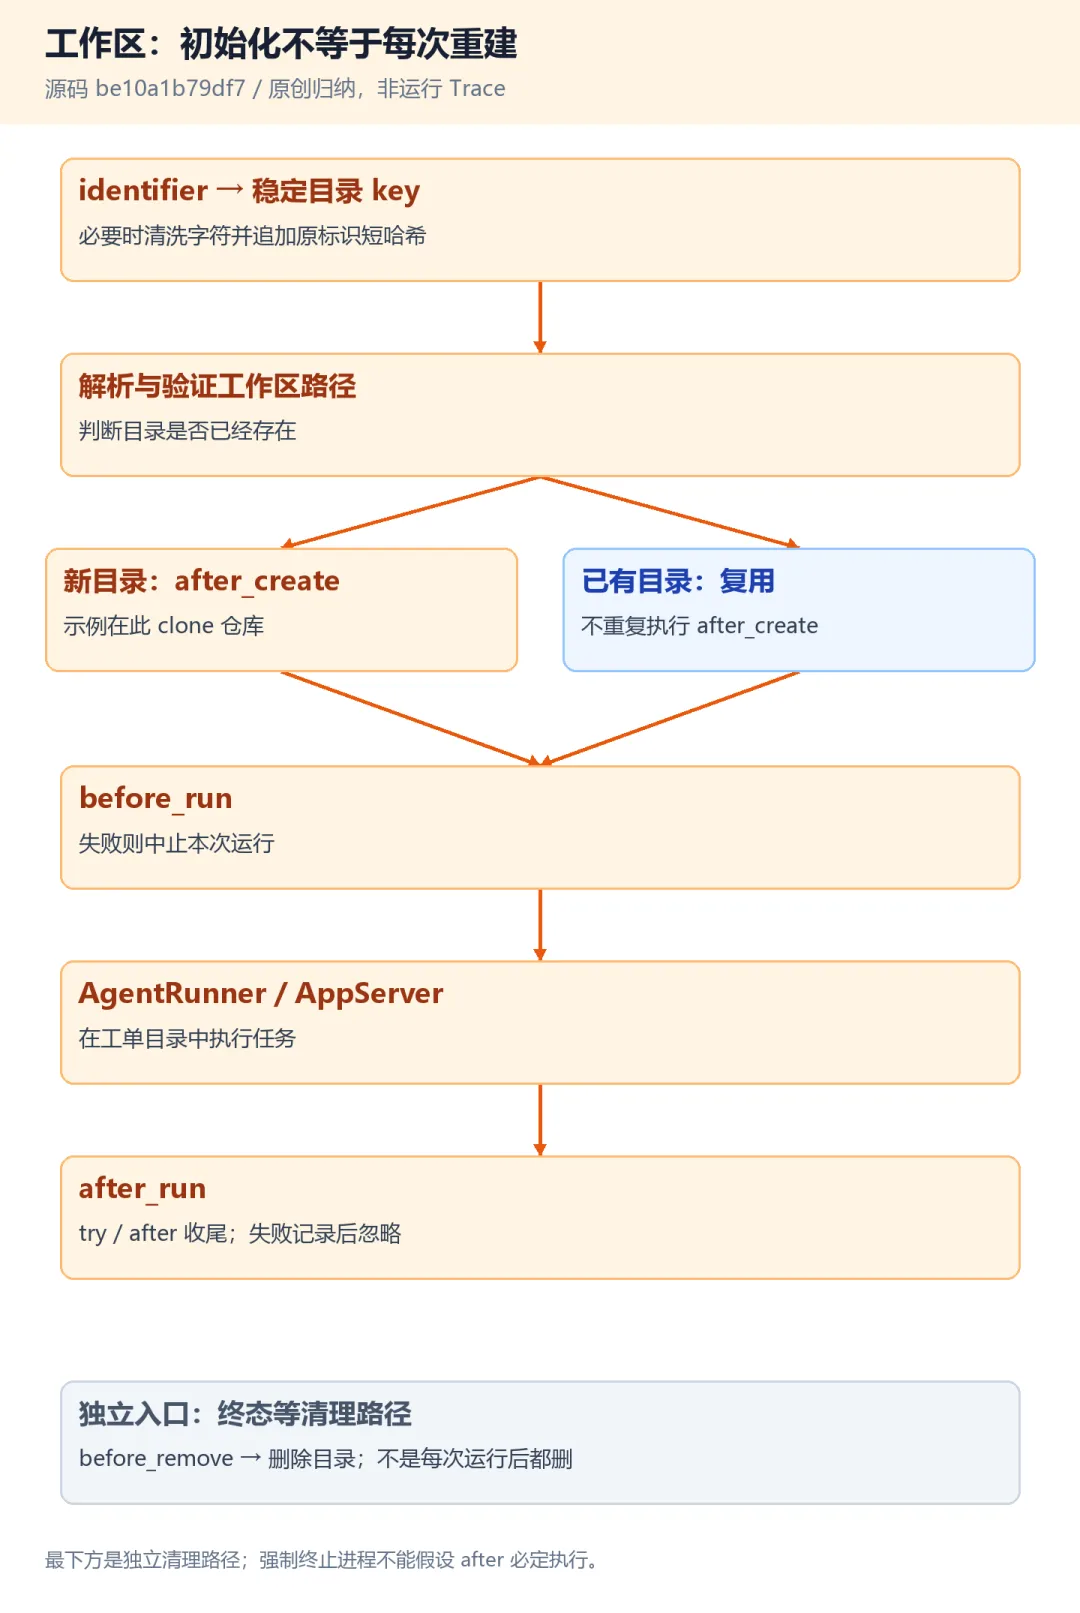
图 5:工作区初始化、每次运行与最终清理是不同生命周期。after_create 只在新建时执行;终态清理是另一条路径,不能画成每次运行结束都删目录。
读这段时,有两件事容易被“隔离工作区”这个名字带过去。
第一,框架本身不替你决定怎么 checkout 仓库。 示例是在 after_create hook 里 git clone。因此,这里的独立工作区不应一律描述成 git worktree。
第二,后置清理不等于删除工作区。 AgentRunner 用 try ... after 调用 after_run;它通常承担一次执行后的收尾。真正的目录清理发生在终态等清理路径,并可调用 before_remove。
表 1:依据 Workspace 与 AgentRunner 的调用关系整理;进程被强制终止等情况,不应假设语言级 after 总能执行。
路径检查也不只靠字符串前缀。本地路径会 canonicalize,AppServer 启动前还会核对工作目录,处理符号链接逃逸等情况。
但目录隔离不等于进程权限隔离。审批、Codex 沙箱、网络与凭据策略仍有独立配置;不能把 Workspace 当作容器安全边界。
五、AgentRunner:一张工单里的两层执行循环
这一节是理解常驻执行的关键。对模型来说,一轮输出可以结束;对工单来说,代码也许还没合并。Symphony 没有强迫两者同时结束。
AgentRunner 创建一次 AppServer session,然后连续执行 turn。每次 turn 正常完成,都会刷新工单状态与路由资格。
只要工单仍活跃且当前 turn 数尚未达到 max_turns,它就使用同一个 app_session 继续。第一轮使用工单模板提示词,后续轮使用较短的 continuation 提示,提醒从当前工作区和 workpad 接着做。
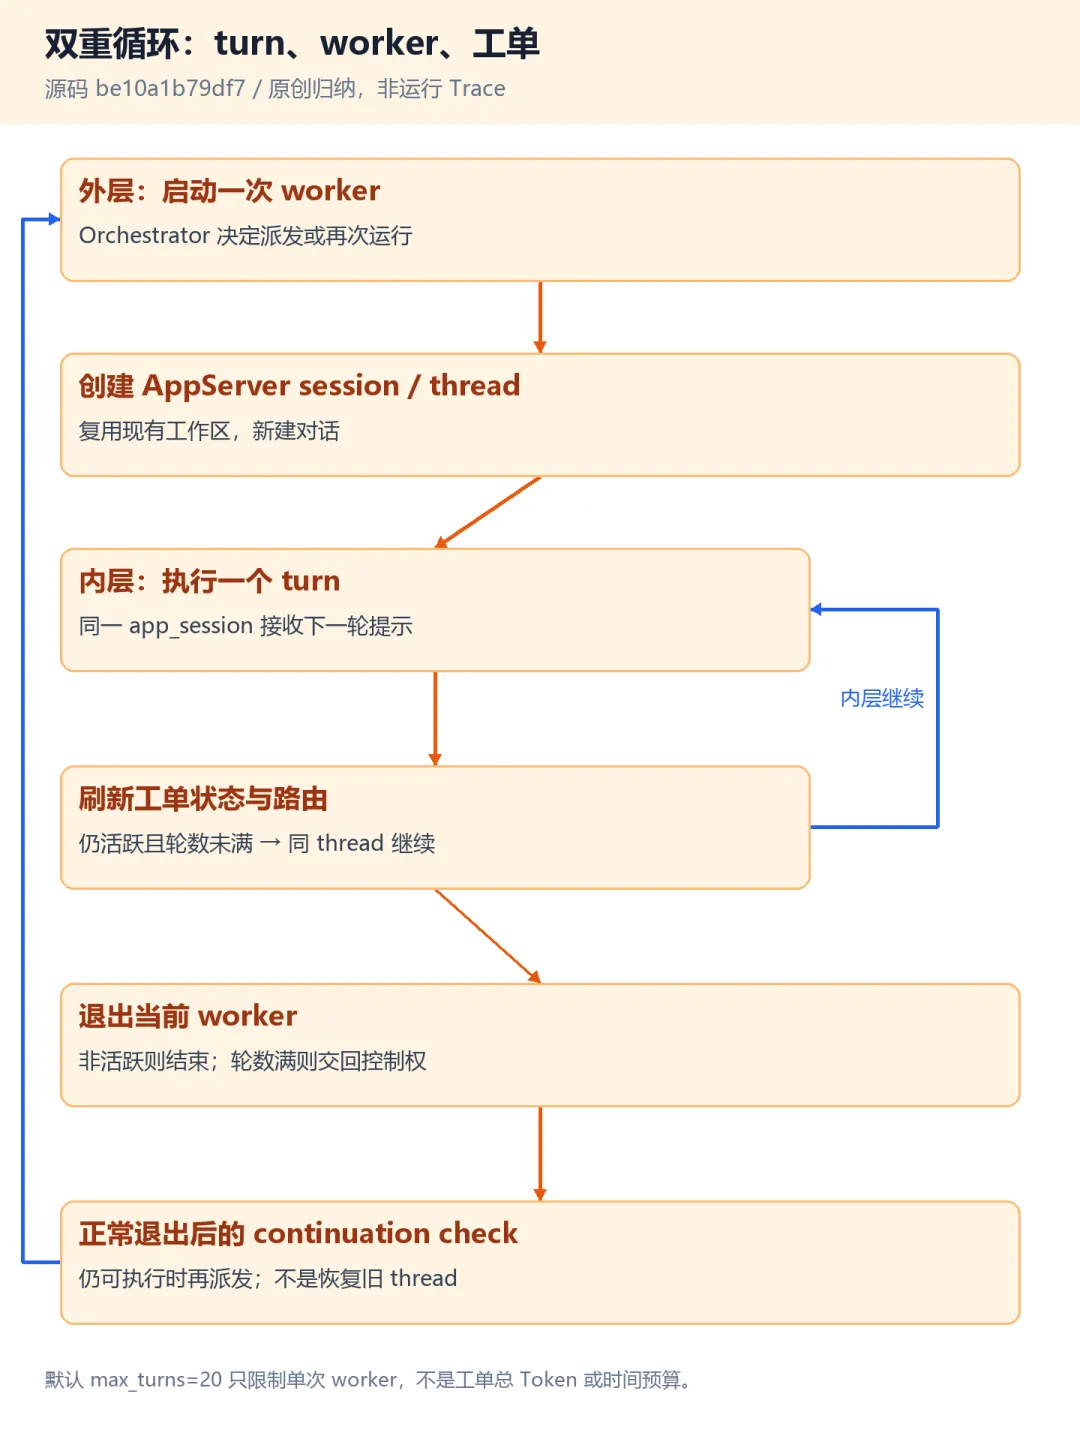
图 6:内层在同一 AppServer session/thread 继续 turn;外层由 Orchestrator 决定新建 worker。新 worker 会新建 session/thread,但保留的工作区可以复用,不是恢复旧对话。
当达到 max_turns,即使工单仍活跃,AgentRunner 也会正常返回,把控制权交回调度器。
但调度器收到正常退出后,会安排约一秒后的 continuation check;若工单还可执行,仍可再次启动 worker。
所以,默认 20 个 turn 是单次 worker invocation 的上限,不是工单一生最多只能跑 20 轮,更不是 Token、费用或总运行时间预算。
这解释了为什么“常驻”不需要一个无限长的对话。持久工作区与工单记录能承接任务,而每次对话可以有自己的生命周期。
也提醒我们:如果要加总预算、最多尝试次数或人工升级阈值,需要额外设计,不能把 max_turns 当成现成答案。
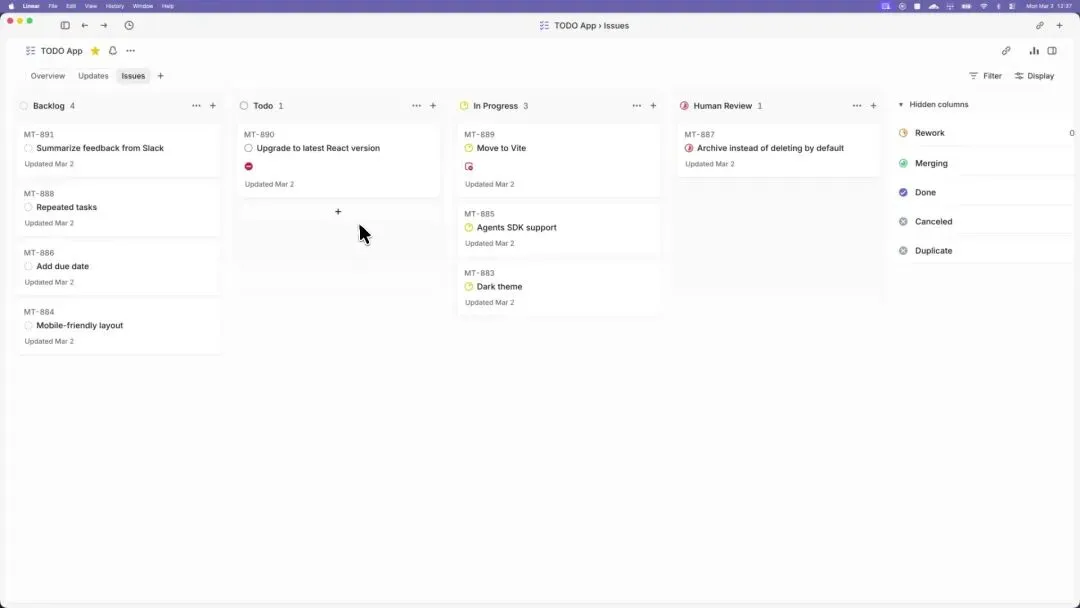
原始材料 B:固定提交中 README 使用的演示视频预览,完整保留。来源:官方仓库,观看原始演示。预览不是本文运行结果;演示中的流程也不能替代对当前配置的核查。
六、Codex 协议:不是抓终端文字,而是处理结构化事件
到这里才真正进入“调用 Codex”的部分。本地路径用 Port 启动 bash -lc,在工单工作目录中执行配置的 Codex 命令。当前实现也支持 SSH worker,但资源供给、机器池管理并不会因此自动齐备。
通信不是从终端输出里猜“它大概做完了”,而是 stdio 上的 JSON-RPC 消息。这让开始、完成、工具调用和请求审批都有可以处理的事件。
AppServer 的握手顺序很清楚:
发送 initialize,等待响应。发送 initialized通知。thread/start创建 thread,附带工作目录、审批和动态工具信息。 turn/start提交提示词,等待 turn ID。 接收事件,直到完成、失败、取消或要求外部输入。
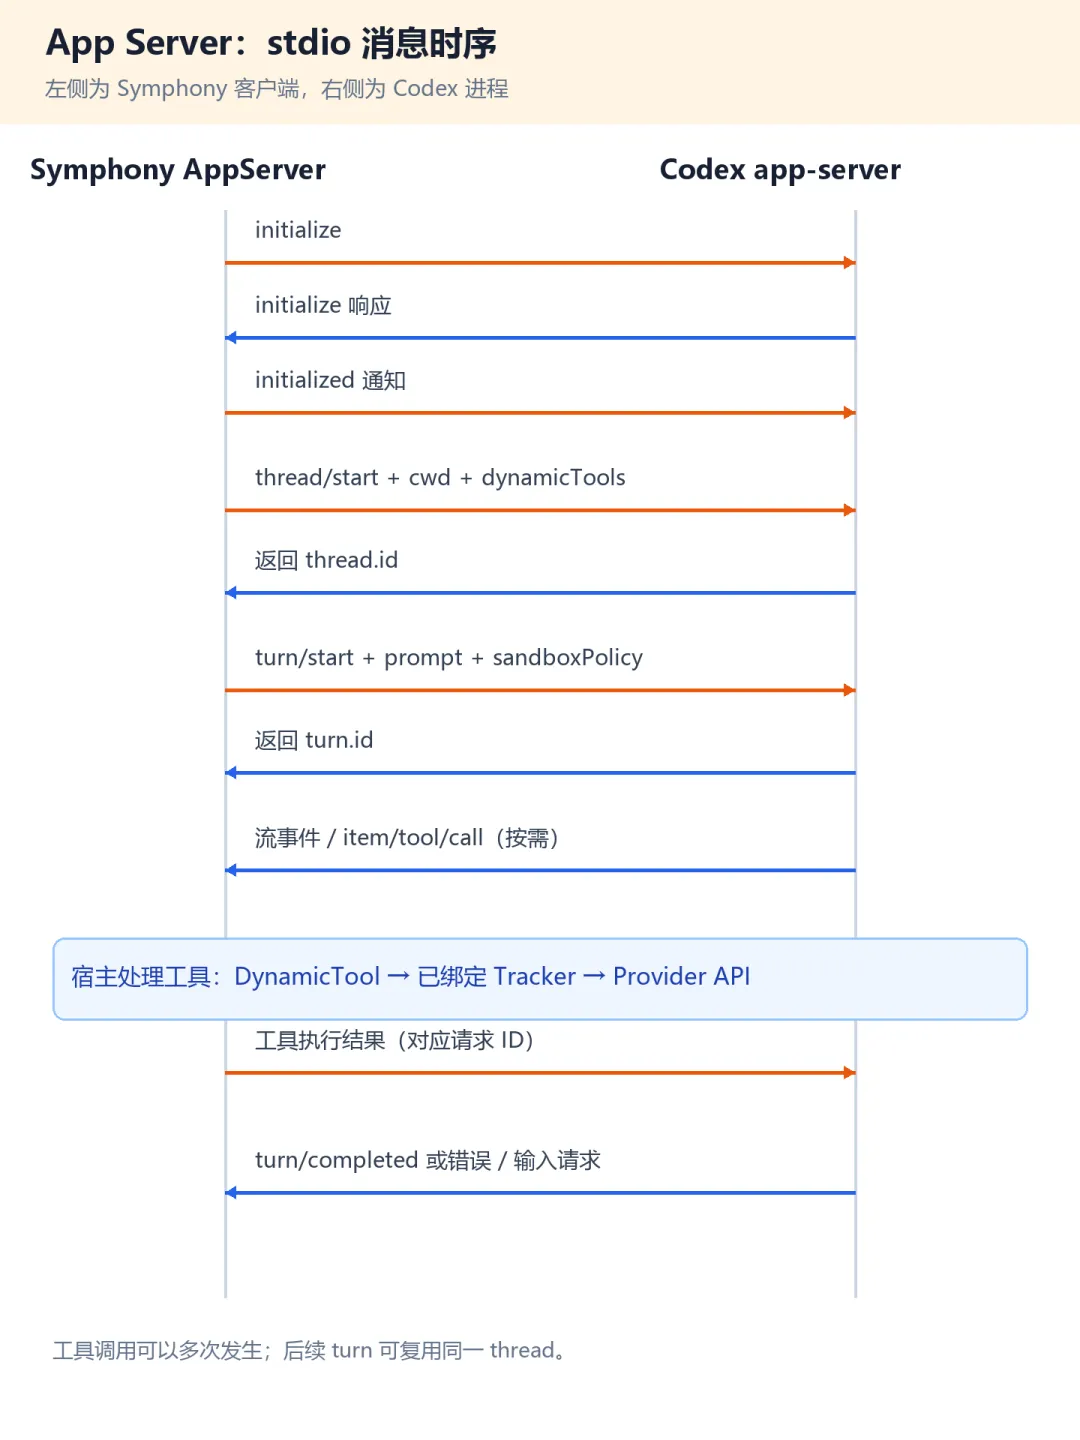
图 7:一次 session 的协议主路径;响应与事件有所简化。动态工具调用可以出现在 turn 执行期间,不是只会发生一次或固定出现在 turn 结束前。
6.1 动态工具:工具留给模型,凭据留在宿主侧
例如,模型请求调用 tracker 原生工具时,AppServer 将请求交给 DynamicTool,再转给绑定的 Tracker adapter,最后把结构化结果送回 Codex。
启动 session 时,Tracker.bind_agent_tools/0 会捕获适配器、有效 tracker 设置、工具规格和秘密环境变量名称。
AppServer 会从 Codex 子进程环境移除适配器声明的 tracker token 变量,并在启动 shell 中进行相应 unset。这个设计让 Agent 能请求工单操作,而不必直接拿到原始 tracker token。
但工具本身代表授权能力。隐藏 token 并不等于工具天然没有风险,更不代表其他所有秘密都已经隔离。
6.2 turn_timeout_ms 不是总时长闹钟
receive_loop 每处理一段流更新,继续进入下一次等待;因此 turn_timeout_ms 衡量的是接收流静默等待,不是整个 turn 从开始到结束的总时长。
仓库有一个专门的 超时测试:fake Codex 持续发更新时允许继续,静默足够久后才超时。
表 2:两种“没有动静”的检测分属不同层;具体判断依据也不同。配置默认值应读 Schema,不能直接拿示例工作流覆盖后的值当默认值。
七、退出、重试、阻塞:真正的调度状态机
我会把这一节和正常路径一起读。无人值守系统最怕的,不是偶尔出错,而是不知道自己为什么停了,只会再来一遍。
Orchestrator 通过 Process.monitor 接收 worker 的 :DOWN,移出 running、汇总用量,再按结果分流。
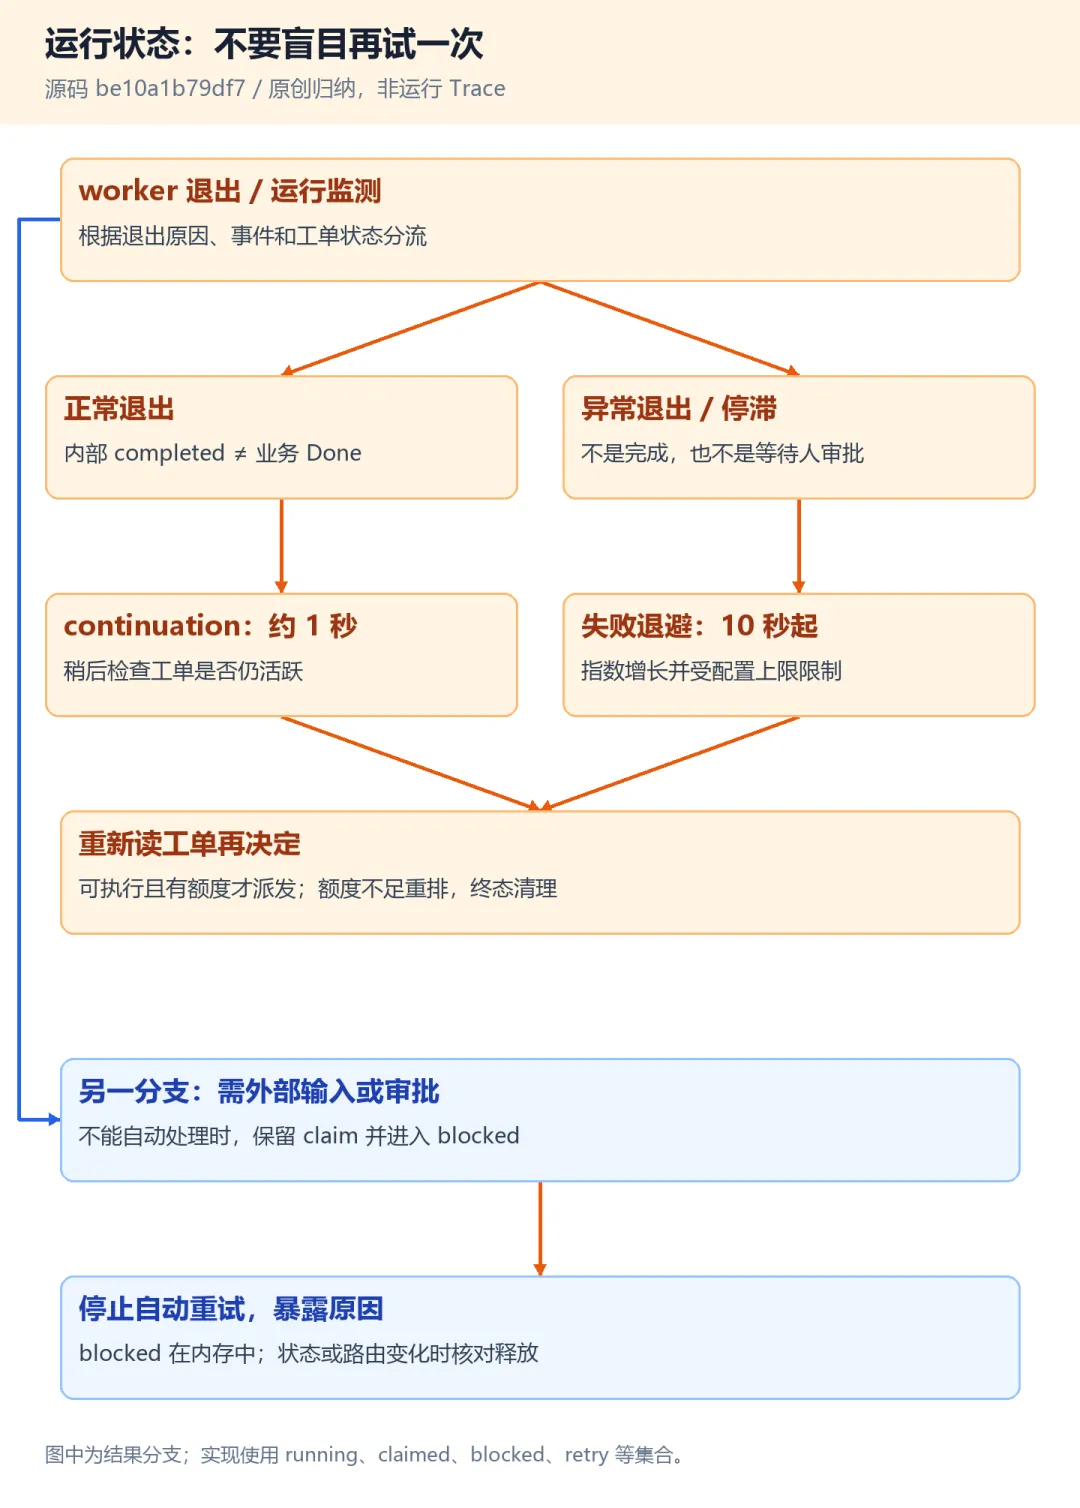
图 8:结果分支是概念归纳,retry、blocked、claimed 在实现里并非互斥枚举值,而是多个集合/映射。正常 continuation 与失败 backoff 不能混为一谈。
7.1 正常退出:先安排 continuation,不直接宣布 Done
代码会更新内部 completed 集合,但同时安排 continuation check。这个集合不能当作业务已验收清单。
续跑定时消息触发时,仍会重新获取工单:进入终态就清理并释放;离开活跃状态就释放;仍可运行且有额度才派发,额度不足则重新排队。
7.2 异常退出或停滞:退避,而不是立即疯狂重启
失败重试的基本间隔为 10 秒,再指数增长,受配置的 max_retry_backoff_ms 限制;默认上限为五分钟。代码还对指数位移的幂做了额外封顶。
调度器会给重试消息附上 retry_token。收到消息时,必须与当前记录一致才能消耗该重试条目。
取消旧计时器并不足以排除旧消息已经进邮箱的情况;token 用来防止旧消息误消费新重试。 仓库有对应的 stale retry 测试。
这类细节不适合放在发布标题里,却是源码最值得看的地方。少处理一条旧消息,可能就多跑一轮昂贵的任务。
7.3 需要输入或审批:blocked,不把它当瞬时故障
当某项请求不能自动处理,AppServer 发出 input/approval 相关事件并返回错误;Orchestrator 可把工单移入 blocked,保留 claim,避免下一轮又当新任务派发。
这不意味着 Dashboard 自动提供完整交互审批工作台。需要区分“暴露阻塞原因”和“替用户完成审批”。
blocked 也在内存中。工单仍活跃且可路由时,会继续保持阻塞;仅仅改一改描述,不能假设就能自动恢复。离开相应状态、失去路由资格或终止时,才有对应释放路径。服务重启后,blocked 内存不保留。
7.4 看板变了:停止继续做错事
周期性 reconcile 会区分:
- 进入终态:
停止当前 worker,并清理工作区。 - 离开活跃状态或不再归本实例路由:
停止执行,但不按同样路径删除工作区。 - 读取失败:
本次保留已有 worker,后续再检查。
“系统会恢复”不是“原会话永生”。 它主要靠工单状态和留下的文件重建有用执行;外部评论、PR 和其他副作用仍需要幂等处理。
八、业务工作流:Human Review 为什么能让 Agent 停下来
工单业务上是 In Progress,运行时却可能 running、等待 retry,或者 blocked。把这两个维度混在一起,界面上很容易只剩一个永远转圈的“处理中”。
示例 WORKFLOW.md 将 Todo、In Progress、Merging、Rework 配为 active,而没有把 Human Review 放进去。
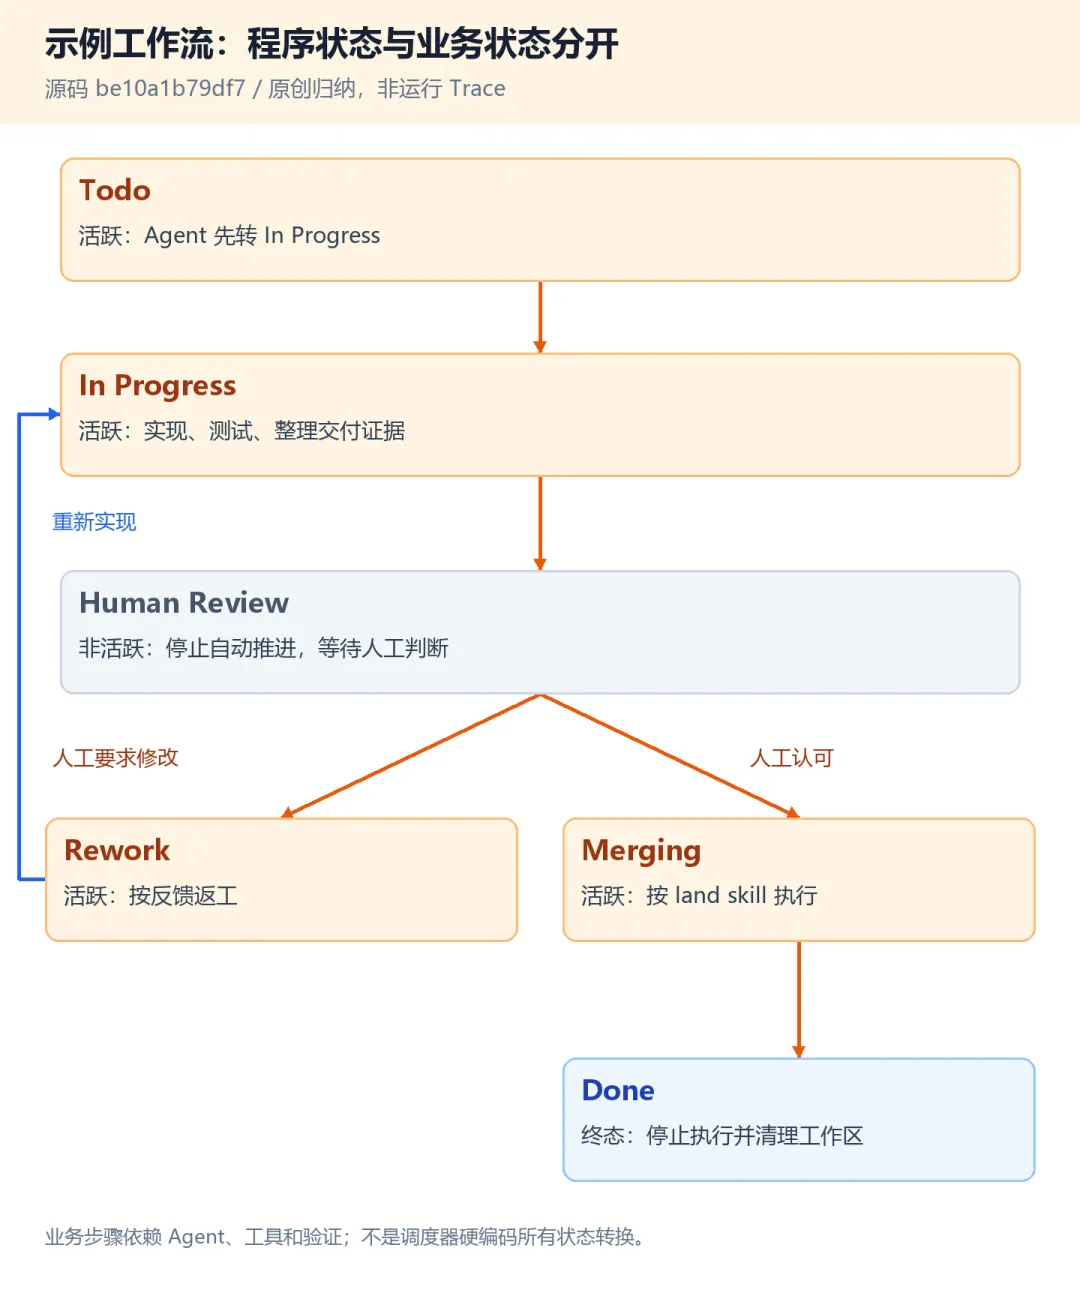
图 9:固定版本示例工作流,不是全部 tracker 的强制状态标准。实现/验证/更新状态主要由 Agent 按提示与工具执行;人工决定审查后返工还是合并。
于是,Agent 把工单推进到 Human Review 后,内层 turn 检查或外层 reconcile 会发现它已经不活跃,停止继续推进。
人认可后改为 Merging,工单重新具备活跃资格;Agent 再按工作流执行仓库里的 land skill。审查要求修改则进入 Rework。
这是一种很有价值的分工:程序约束“哪些状态可以启动”,工作流规定“做什么才配进入下一个状态”。
前者是确定性检查;后者若只写在提示中,仍需要测试、工具和证据支持,不会因为写进 Markdown 就变成不可绕过的强制规则。
Ryan Lopopolo 在 Harness Engineering 原文 中把工程师的职责落在工作环境、意图与反馈机制上,而不是反复替模型补一句提示。这里正好能看到这项分工:Symphony 可以识别 Human Review,却不能只凭这个状态知道测试是不是真的充分。
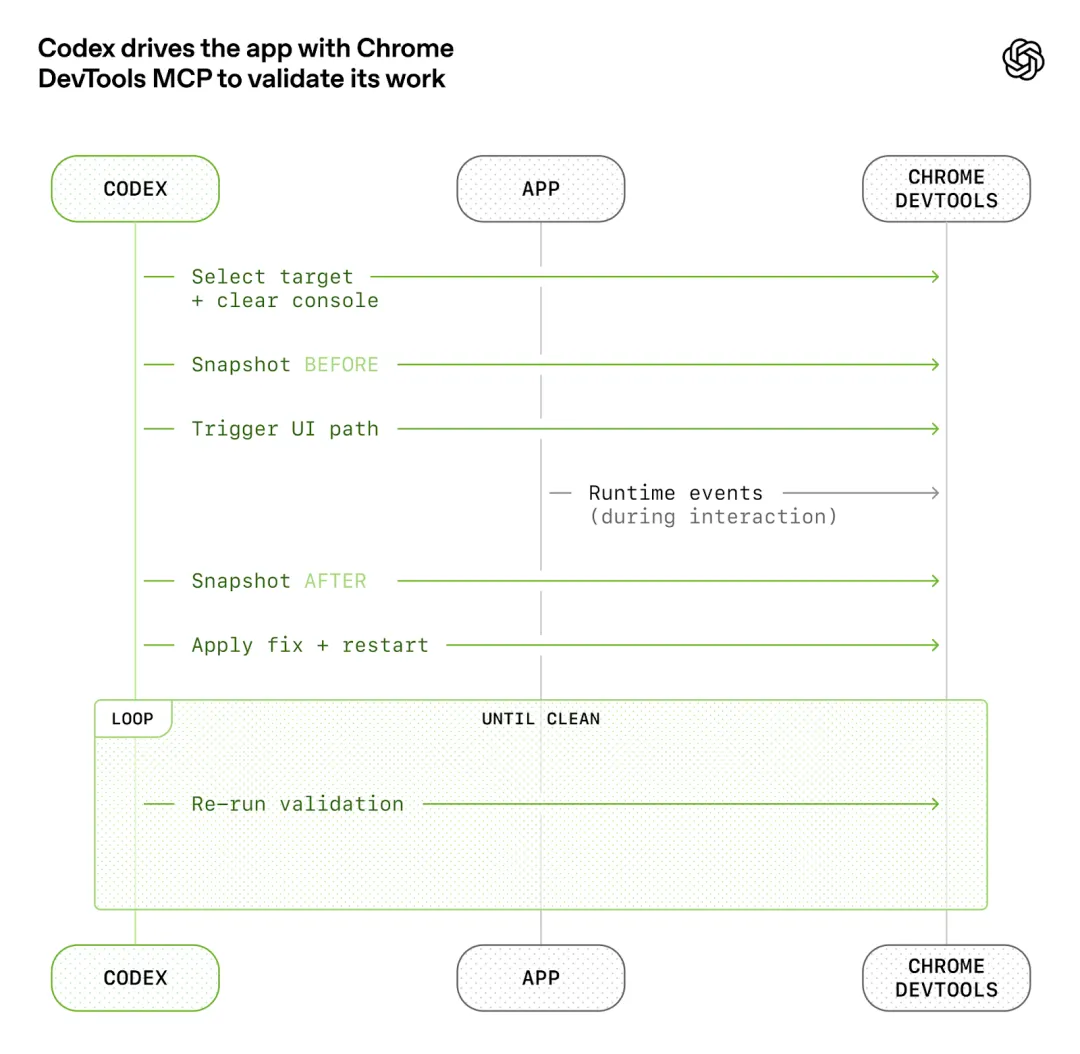
原始材料 C:Ryan Lopopolo 的原文配图,展示 Codex 通过 Chrome DevTools 操作应用、观察结果并反复验证。来源:Harness Engineering,2026-02-11。图片版权归 OpenAI 所有;这是团队工作方式的说明,不是 Symphony 默认附带了整套 QA 系统。
九、配置热更新与可观测性:如何让常驻服务可运营
服务长时间运行之后,另一个现实问题会冒出来:工作流总会改,能不能不重启就改?改坏了怎么办?
WorkflowStore 定时检查文件,stamp 包含修改时间、长度和内容哈希。新文件加载、Schema 解析与配置校验成功后才替换缓存。
如果更新失败,会记录错误并保留最后有效版本。与此同时,调度前 Config.validate! 会通过 force_reload 暴露错误,阻止该轮新派发;并不是“静默忽略坏配置,照常启动所有新任务”。
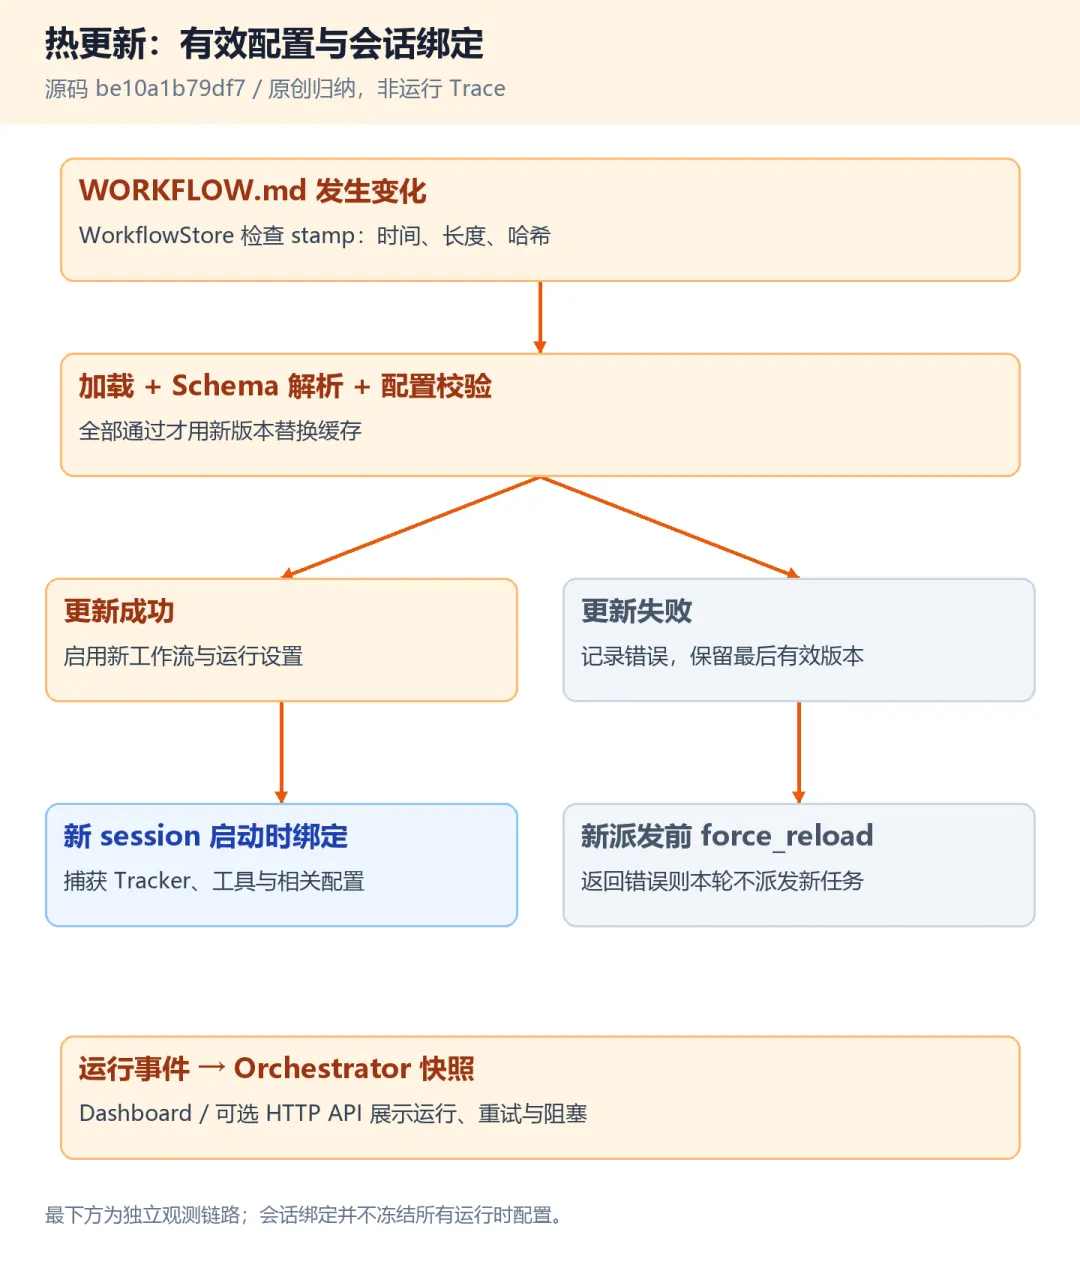
图 10:配置生效边界。会话启动时绑定的是 tracker 工具、相关设置和策略,不代表所有配置都被冻结;运行期间仍有部分逻辑读取当前配置。
这也解释了为什么 Tracker 要为 session 建立工具绑定:如果运行到一半切换 provider,已暴露给 Codex 的工具名与实际执行后端不应该突然对不上。
在可观测性侧,worker 将事件发给 Orchestrator,后者更新 session、活动时间、Token 与速率限制等快照。展示层通过这些状态帮助人判断“在运行、在等待、还是被阻塞”。
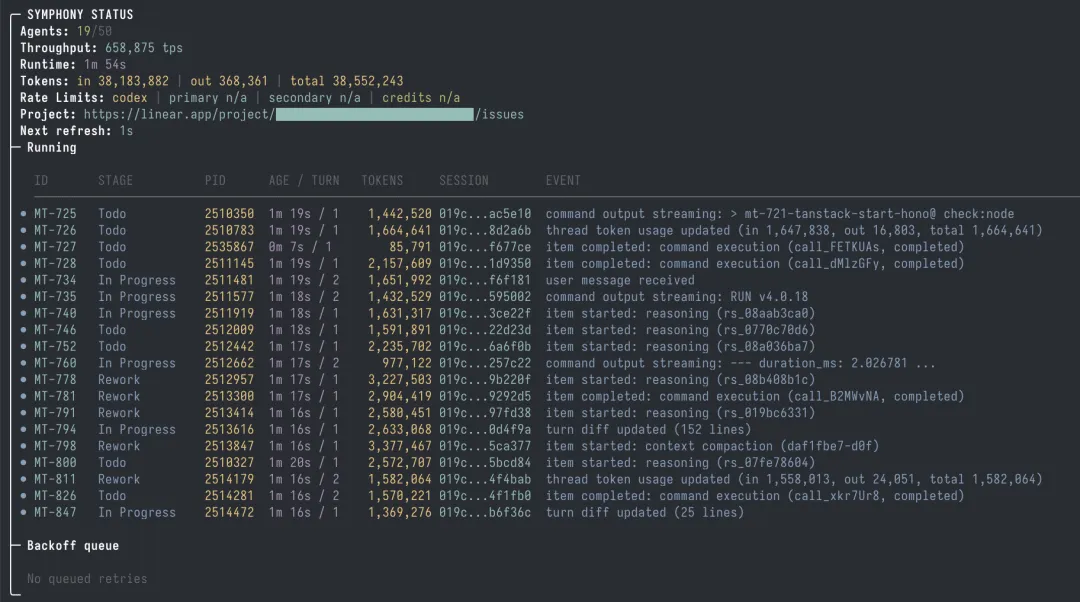
原始材料 D:固定提交中 Elixir README 引用的项目状态截图,原图保留了 Running、Session、Event、Token 和 Backoff queue 等信息。来源:仓库原图。这是上游示例,不是本文实测;图中吞吐、用量和运行时间不能作为性能结论。项目地址的遮挡来自原图,本文未另行改写。
这张项目截图,比单独一张抽象架构图更能说明运营时要看什么。左边的 Todo、In Progress、Rework 是业务状态,右边的事件是在告诉你进程最近干了什么。看到两列放在一起,就不容易把“还在发事件”误当成“工作正在有效推进”。
可选 Phoenix 服务有状态快照、按工单查询和主动 refresh 等接口。HTTP 并不是核心调度的必要前提,也不是一个完整项目管理后台。
监控“有活动”只解决可见性,不等于已经证明产出质量。 要判断功能是否正确,仍要看仓库实际测试与验收证据。
十、把作者的判断放回源码,哪些成立,哪些还要自己补
源码说明“做到了哪一步”,原始博客解释“为什么这样做”。放在一起看,有三组观点值得留下。下面是有出处的转述,不是采访引语;其中也没有外部专家对这个提交做过审计的意思。
Symphony 三位作者:要减少的是人的切换,不只是提高代码产量
Alex Kotliarskyi、Victor Zhu 和 Zach Brock 在 原文 中说,把管理对象从会话转到任务后,团队不必再反复切换窗口来启动、催促和跟踪工作。他们也明确保留了交互式工作的空间:模糊问题、依赖经验判断的问题,仍适合工程师直接与 Codex 协作。
我的理解是,评估 Symphony 应该先问“每项交付需要人打断自己几次”,而不只是看 PR 数。原文报告的部分团队合入 PR 增长 500%,是特定团队的自报结果,不能直接换算成业务价值或质量提升。
从源码看,轮询、续跑检查、工作区复用和状态交接,都在接替这部分人工搬运。它们没有试图替人决定一个需求究竟值不值得做。
Ryan Lopopolo:环境欠的账,编排器不会替你还
Ryan 是 Harness Engineering 的署名作者,页面标注职务为 OpenAI Member of the Technical Staff。他回顾的早期阻碍,不只是模型能不能写,而是环境缺少工具、抽象和足够清楚的结构;失败后要追问缺了什么能力,怎样让它既可理解又可执行。
这恰好解释了 Symphony 为什么把那么多事情留在 hooks、skills 和 WORKFLOW.md。调度框架保持通用,仓库负责提供能启动的应用、可信的测试和可检查的结果。 如果测试本来就不稳定,接上常驻调度只会更快地重复不稳定的流程。
因此我不建议从“先把并发开到十”开始。先拿一张有复现步骤的工单,验证它能否独立完成并交出证据,再逐步放量。这个建议来自对调用边界的判断,不是原文给出的统一部署参数。
Prithvi Rajasekaran:别把今天需要的脚手架,当成永久架构
Anthropic Labs 成员 Prithvi Rajasekaran 在 长时应用 Harness 文章 中提出,每个 Harness 组件都隐含着对模型能力不足的假设;模型变强以后,这些假设值得重新检验。他自己的实验就逐项移除了不再必要的结构,而不是一直往上加角色和步骤。
原始材料 E:Anthropic 文章实拍,保留标题、作者说明与发布日期。来源:Prithvi Rajasekaran 的原文,发布于 2026-03-24,截图于 2026-11-15。这是另一套 Harness 实验的观点,用作比较,不是他对 Symphony 的直接评价。
这个提醒对读 Symphony 很有用,但不能机械照搬。模型将来可能不再需要某种拆任务提示,却不会因此让旧计时消息消失,也不会让两个调度实例自动互斥。补偿模型不足的提示结构,可以随模型重测;控制副作用、并发与权限的工程约束,要按故障模型来判断。
这也是我读完后的主要取舍:不要因为模型变强就拆掉所有控制,也不要因为某个机制今天管用,就把它永久固定在模型周围。
真要落地,我会先追问这三件事
一张工单最多能花多少钱,谁来终止不断续跑的任务?两套服务同时运行,怎样保证不会领到同一份工作?已经发出的评论、PR 或外部变更,重试时怎样识别?
这几件事都不能只靠进程内 claimed、单次 max_turns 和“请勿重复操作”的提示解决。预算、跨实例协调与业务幂等,才是把参考实现接进真实团队时要补的账。工单进入 Done 也仍要有可信的验收依据。
推荐的源码阅读路线
先读入口与监督树,再读 maybe_dispatch 和 spawn_issue_on_worker_host;接着沿 AgentRunner 进入 Workspace 与 AppServer;最后回到 handle_agent_down、retry 和 blocked 分支。
测试也按问题读,而不是只看“有测试”:
表 3:这些是交叉阅读过的测试入口,不表示本文已运行测试或验证真实服务。
写在最后
如果只记一个源码细节,我会选开头提到的那次正常退出:worker 说这一轮结束了,调度器还要再去看工单。
这比“永远运行的 Agent”更接近真实工程。执行有边界,状态会变化,某些时候该重试,某些时候必须停下来等人。持续运行不是让模型永不停止,而是让工作在停顿之后还有明确的去向。
Symphony 给出了一个值得借鉴的调度骨架。至于能不能用它交付可靠的软件,答案还在你的仓库、测试和工作流里。
我更愿意先验证它能不能替工程师少打断几次,而不是先统计它一晚上生成了多少代码。