ARTICLE · 1365454
禾攸科技_自研AI视觉模型_宣传文档
禾攸科技_自研AI视觉模型_宣传文档禾攸科技 · 技术宣传文档 凌晨两点的深圳,一家电子厂的车间仍亮着灯。 流水线每分钟吐出上百块产品。过去,这条线后面站着十几名质检员;现在,只剩两个人在做抽检。订单没有变少,变的是那道工序——看产品的不再只是人眼。 这份文档要讲的不是算法,而是一个更具体的问题:一台机器要在工厂里长出可靠的眼睛,究竟需要什么。禾攸给出的答案,是一套自研模型族——禾攸模型 hy-m,以及把它从一张标注图带到产线上的完整链路。 这是公开报道里的一个场景。深圳一家电子制造工厂引进基于视觉模型的 AI 质检系统,几个月后,人工质检岗位减少约八成,检测速度提升三倍以上,漏检率明显下降。 数字之外,更值得注意的是它的工作方式:工业相机在工位上方按节拍拍照,模型在几百毫秒内判断出缺陷位置与类别,判定不合格的产品被下游机构自动剔除。整套系统的核心不是相机,而是那个被自己的数据训练出来的视觉模型。 很多人以为机器视觉离制造业还很远。事实恰好相反——它先在制造业最枯燥、最耗人的那道工序上落了地。 一个中等规模的电子制造厂,通常要养 10 到 30 名质检员。工作内容高度重复:看外观、找划痕、查缺口、判合格。看起来简单,代价却不低。 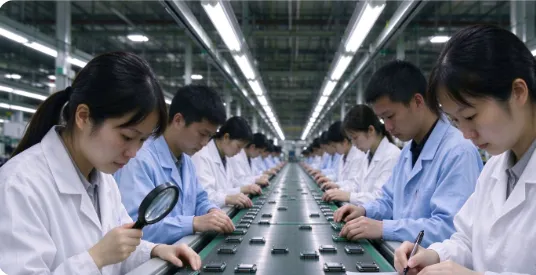
五件事往往同时发生:眼睛会疲劳,注意力会走神,漏检和错检无法避免;熟练工流失后新人要重新带;而客户的质量要求一年比一年高。人越难招、越难留,标准反而越紧。 真正要算的还有漏检的账。一件不良品流到客户端,牵动的是整批货的返工、赔款和交付延期——这笔钱,通常远高于一个质检岗一年的工资。 所以工厂买的从来不是“AI”这个名词,而是一种稳定的判断力:不疲劳、不走神、全天候保持同一套标准。 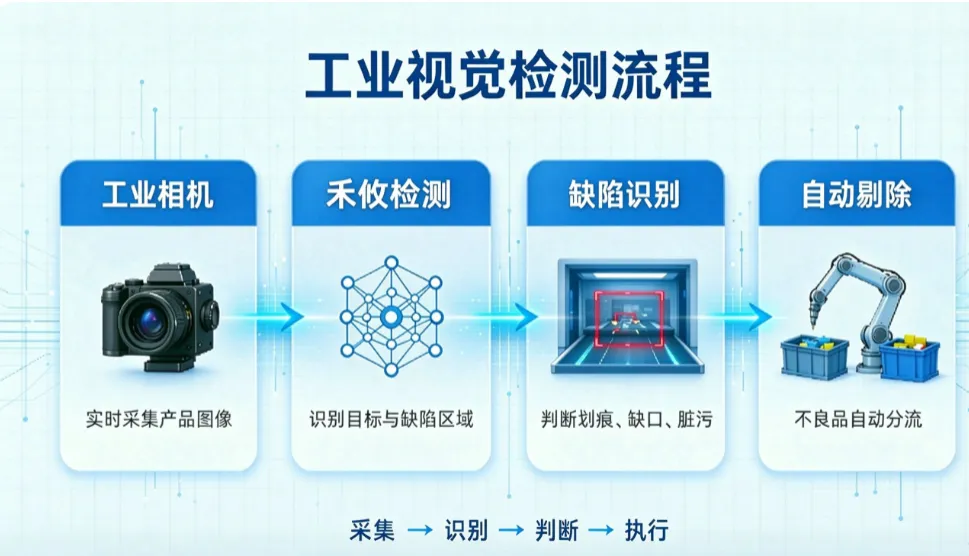
开源检测模型早已普及,搭一套跑得起来的检测系统并不难。难的是把它变成产线上靠得住的东西,中间有三道坎。 第一道,场景是碎的。换一个料号、换一条产线、换一种光照,数据分布就变,模型要重新标注、重新训练。没有自己的训练平台,这件事只能一次次外包,周期和成本都不受自己控制。 第二道,算力在产线侧。工位旁边放的是几百到几千元的边缘盒子,不是机房里的 GPU 集群。模型必须在很小的算力上跑出够用的速度和精度。 第三道,数据不能出厂。产品外观图像往往牵涉工艺和型号信息,多数工厂不允许把原始图片上传到公网训练。 三道坎指向同一个结论:模型、训练、部署必须握在自己手里。这也是禾攸做自研模型族的起点——不是为了在榜单上多刷零点几个点,而是为了让模型能进车间。 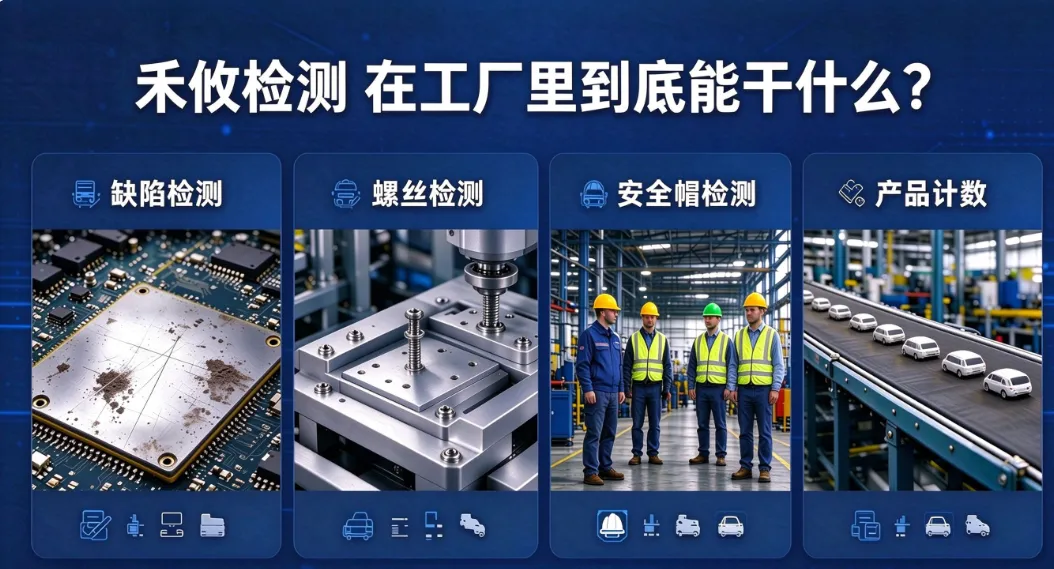
禾攸平台 v1.0.0 把这件事拆成六个模块:概览、数据中心、训练标注、模型训练、一键部署、系统管理。数据进来,标注、训练、验证、下发到产线,走的是同一条链路,不需要在几套工具之间来回搬数据。 平台既支持禾攸自研模型,也兼容 ResNet、BERT 等主流架构。自研是为了把常见工业场景做快做准,兼容是为了在客户已有的技术栈里不制造新的孤岛。 目前自研分支对外可见的有两条: 禾攸模型-Medium,面向目标检测,m 档规模,负责线序、装配缺件、表面缺陷的定位与分类,优先保证产线节拍下的响应; 禾攸模型-Seg-Nano,面向实例分割,n 档轻量规模,负责轮廓、边缘、异形污损这类需要像素级边界的任务,在小算力盒子上也能跑。 两者的架构代号同为 hy-m:一套代码骨架,靠规模档位和任务头适配不同工位。这是模型族的本意——不是一个大模型包打天下,而是一组能按工位选型的模型。 表1 禾攸模型 hy-m 的两个自研分支
训练侧的能力同样是为工厂准备的:完整轮次的训练、AMP 混合精度加速、实时的 Loss 与指标曲线、训练完成后的验证与一键重训,以及把模型直接下发到边缘设备的一键部署。换料号不再意味着重新招标,而是一次复训。 实例场景1:线序检测 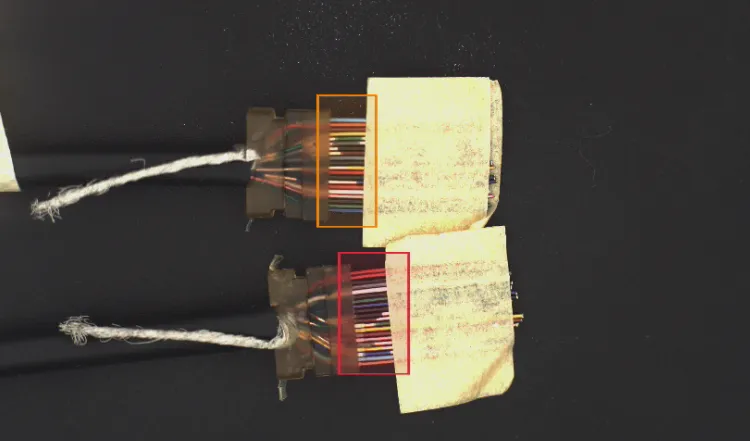
实例场景2:划伤检测 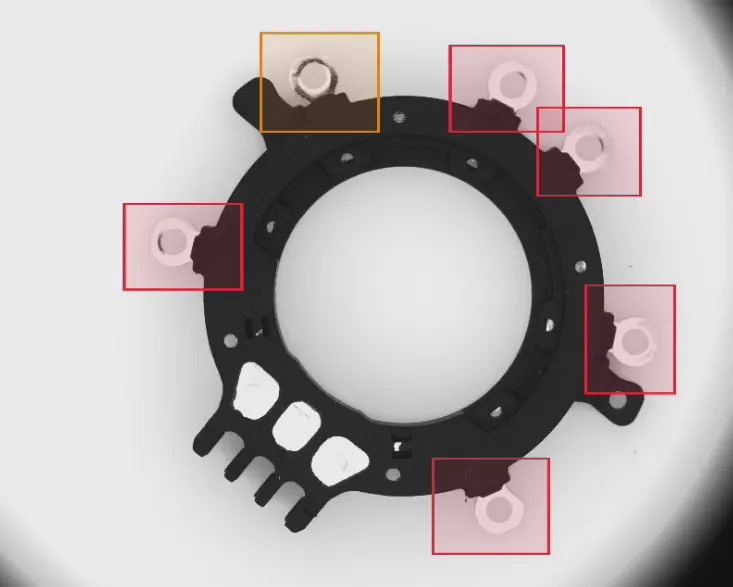
比起宣传口径,一组可查的训练记录更有说服力。下面是禾攸平台内的一个真实训练任务,取自 2026 年 11 月 7 日。 任务名“线束线序检测_禾攸科技_A1_20261107”,架构 hy-m,训练跑满 100/100 轮,开启 AMP 混合精度,后台累计 656 条训练日志。Loss 从约 18 一路下降到 8.5 附近的平台区,随后在小幅波动中收敛——这是模型把这个场景“学会”的过程。 表2 线束线序检测 A1 训练结果
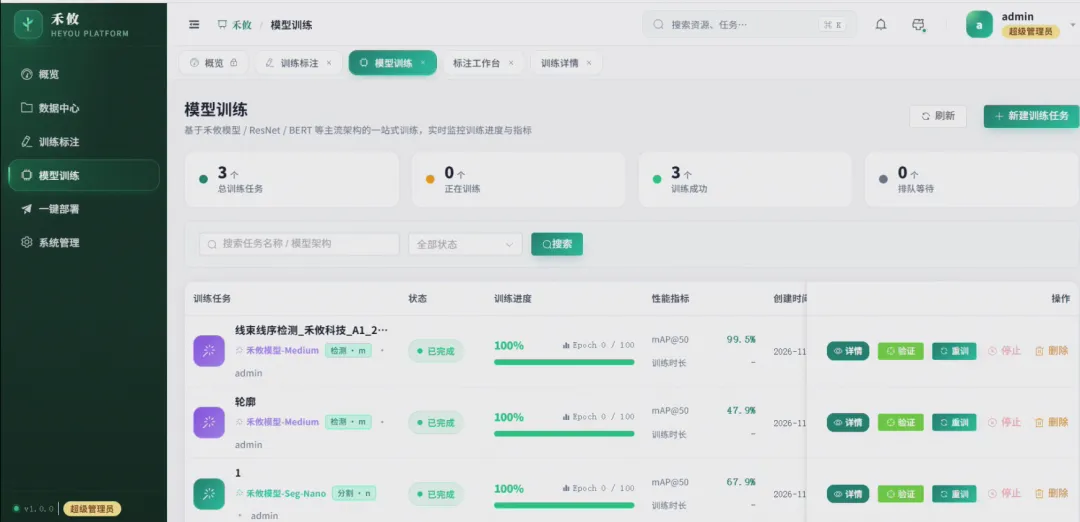
图1 禾攸平台模型训练任务列表(2026 年 11 月 7 日) 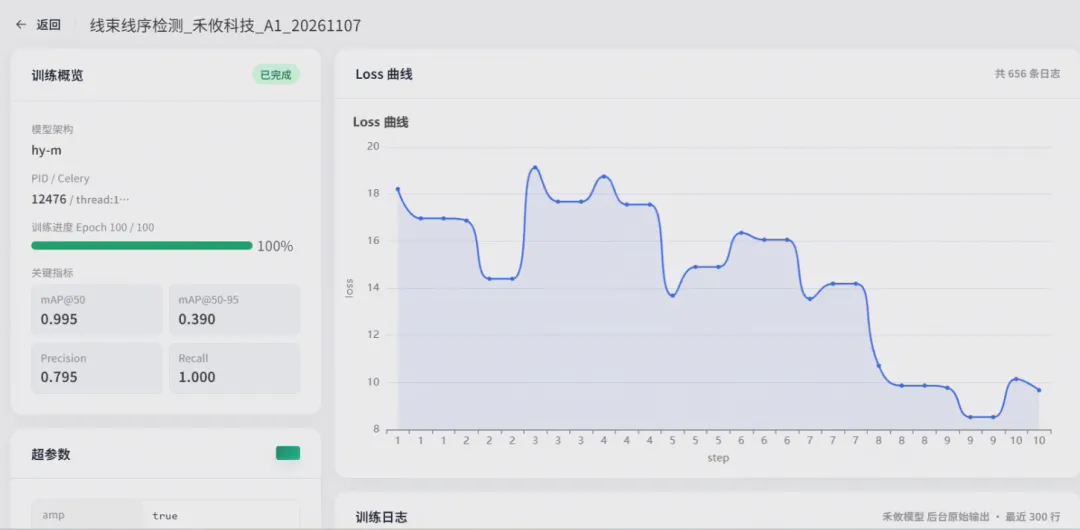
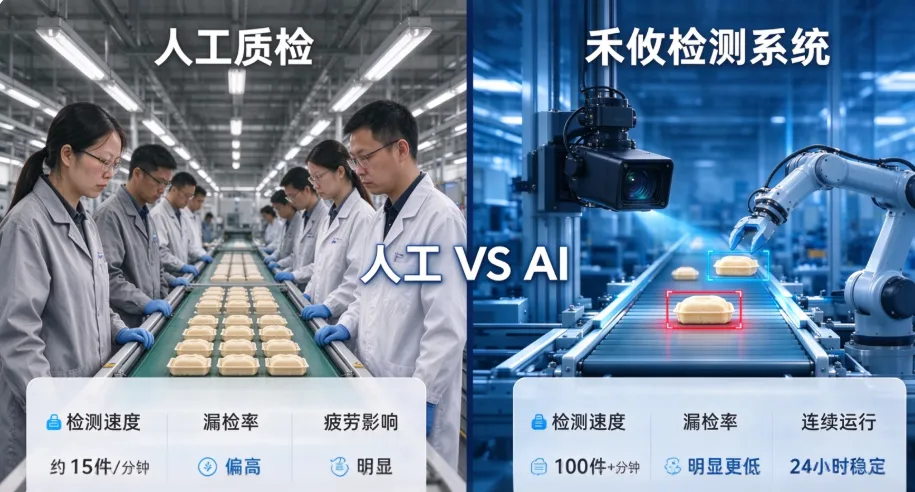
图2 训练详情:hy-m 架构、100 轮训练与 Loss 曲线 上面四个数字里,工厂老板只需要先盯住最后一个:Recall。 Recall 1.000 的意思是,这一版模型把标注过的缺陷一个都没放过。在质检场景里,这条线比什么都重要——漏检是不可逆的,货一旦发出去,追溯成本是几何级上升的。 代价写在 Precision 上:0.795 意味着每 100 个被判为不良的样本里,约有 20 个其实是好的。这是刻意的取舍。A1 是这一场景的首版基线,策略是先把漏检压到零,再用复训、补充负样本和判定阈值把误报压回去——误报的代价是多看两眼,漏检的代价是整批退货。 mAP@50 达到 0.995,说明在 IoU 0.5 这一工业常用口径下,定位与分类几乎全中;mAP@50-95 的 0.390 则诚实地指出:更严格的定位精度还有余量,这是下一版要解决的事。我们不打算用一个漂亮的单指标把这件事盖过去。 把这类模型放到产线上,收益是可以量出来的。下面是同一类改造在公开案例中的前后对比。 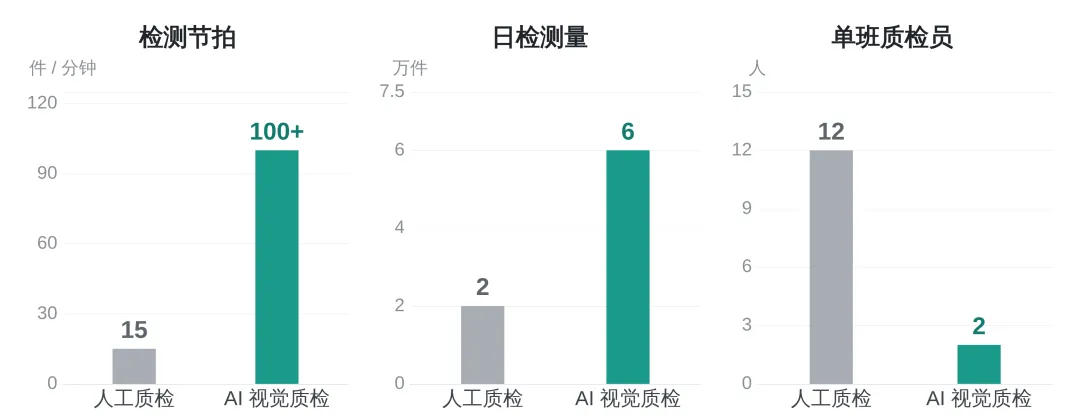
图3 人工质检与 AI 视觉质检的效率对比(数据来源:AIoT 物联技术,2026 年 10 月 24 日) 这里必须说清口径:图 3 的三个数字来自公开报道的深圳某电子制造工厂案例,用来说明这类改造的行业量级,不是禾攸某个项目的结算数据。每个厂的节拍、料号复杂度和缺陷定义都不同,真实收益要拿自己的样件跑一遍才算数。 按工位划分,hy-m 目前最能发挥作用的是四类任务。 表3 四类典型工位与检测内容
部署形态很朴素:一台工业相机、一台边缘计算盒子、一个 hy-m 模型。盒子可以是 Jetson Orin、RK3588 或昇腾 Atlas 这类工业 AI 设备,模型通过平台一键部署下发,图像与训练数据留在厂内网络,不出公网。 一个场景从零到并线,走五步:取一批包含缺陷的样件图像、在平台上完成标注、选分支训练、用留出集验证、通过后下发到产线并与现有的剔除机构联动。 质检岗位会消失吗?不会,但会转型。 纯靠肉眼的目视检查会逐步交给模型,工厂需要的人变成三类:会管 AI 设备的人、会调视觉系统的人、能把工艺要求翻译成检测规则的人。判断“这个划痕算不算不良”、决定“阈值该松还是紧”,仍然是人的活。这也是历次工业变革的共同规律:机器接走重复,人往上走一层。 真正改变工厂的,不是让机器干活,而是让机器学会看见。当一盏灯亮到凌晨两点,产线上还剩下两个人,他们该做的事不是盯着产品看——而是决定什么才算合格。 如果你手上正有一条靠人眼撑着的质检线,不妨先拿一小批样件跑一次。模型好不好,用你自己的产品说话。
让机器学会看见
禾攸自研 AI 视觉模型 hy-m 与工业质检落地实录
一、凌晨两点的车间,只剩两个人
二、质检是制造业最贵的一道工序
三、通用模型能用,但工厂要的不止是精度
四、禾攸模型 hy-m:一个模型族,一条闭环
分支 | 任务类型 | 规模档位 | 典型工位 |
禾攸模型-Medium | 目标检测 | m | 线束线序、装配缺件、表面缺陷定位 |
禾攸模型-Seg-Nano | 实例分割 | n | 轮廓提取、边缘缺口、异形污损区域 |
五、一条线束的实测记录
指标 | 数值 | 含义 |
mAP@50 | 0.995 | IoU 0.5 下的平均精度,工业验收的常用口径 |
mAP@50-95 | 0.390 | 更严格定位要求下的平均精度,反映定位余量 |
Precision | 0.795 | 判为不良的样本中,确为不良的比例 |
Recall | 1.000 | 真实不良中被检出的比例 |
六、指标怎么读:工厂只认一个数
七、能干什么,怎么部署
场景类别 | 检测内容 | 典型工位 |
产品缺陷 | 划痕、裂纹、缺口、脏污、压伤 | 外观全检、出货抽检 |
装配校验 | 螺丝缺件、标签错贴、线序错位、端子未插到位 | 组装段、包装段 |
安全防护 | 安全帽、反光衣、危险区域闯入 | 车间通道、设备周边 |
计数与盘点 | 产品、物料、包装数量统计 | 入库、装柜 |