ARTICLE · 1365851
palf 日志复制源码,多数派到底是怎么确认的
落笔相逢,我是军哥!
上个月面试一个候选人,简历写着"精通 OceanBase 高可用"。我问了个常规题,三副本集群,一条 redo 日志从 leader 产生到事务应答客户端,中间经过哪几步。候选人答得很顺,写日志、发 follower、多数派确认、应答。我追问了一句,多数派确认在代码里是哪个动作触发的,确认位点是谁算出来的。卡住了。
这个追问不过分。第 3 篇从容灾架构角度讲了多数派账本,那是"道"。这篇进"术",钻进 src/logservice/palf 的代码,把"多数派确认"这四个字拆到函数级别。读完你会发现,所谓多数派确认,代码里就是一次排序加一次取中位,朴素得让人意外。

先认位点,palf 的世界坐标
读 palf 代码之前得先认位点,不然所有函数都不知道在跟谁比大小。一条日志流上有几个关键位点。
写到哪,max_lsn,本副本日志写到的位置。确认到哪,committed_end_lsn,多数派都落盘了的位置,事务应答就看它。回放到哪,apply 位点,日志内容真正进 memtable 的位置。
三者永远满足"写到哪 >= 确认到哪 >= 回放到哪"。确认位点和回放位点的区分特别重要,确认管的是丢不了,多数派落盘意味着机器炸了也能从其他副本找回来。回放管的是看得见,进 memtable 了查询才读得到。这个区分到第 32 篇讲故障恢复时还要反复用。
一条 redo 的四步旅程
拿一笔事务提交产生的 redo 来跟,画成时序图:
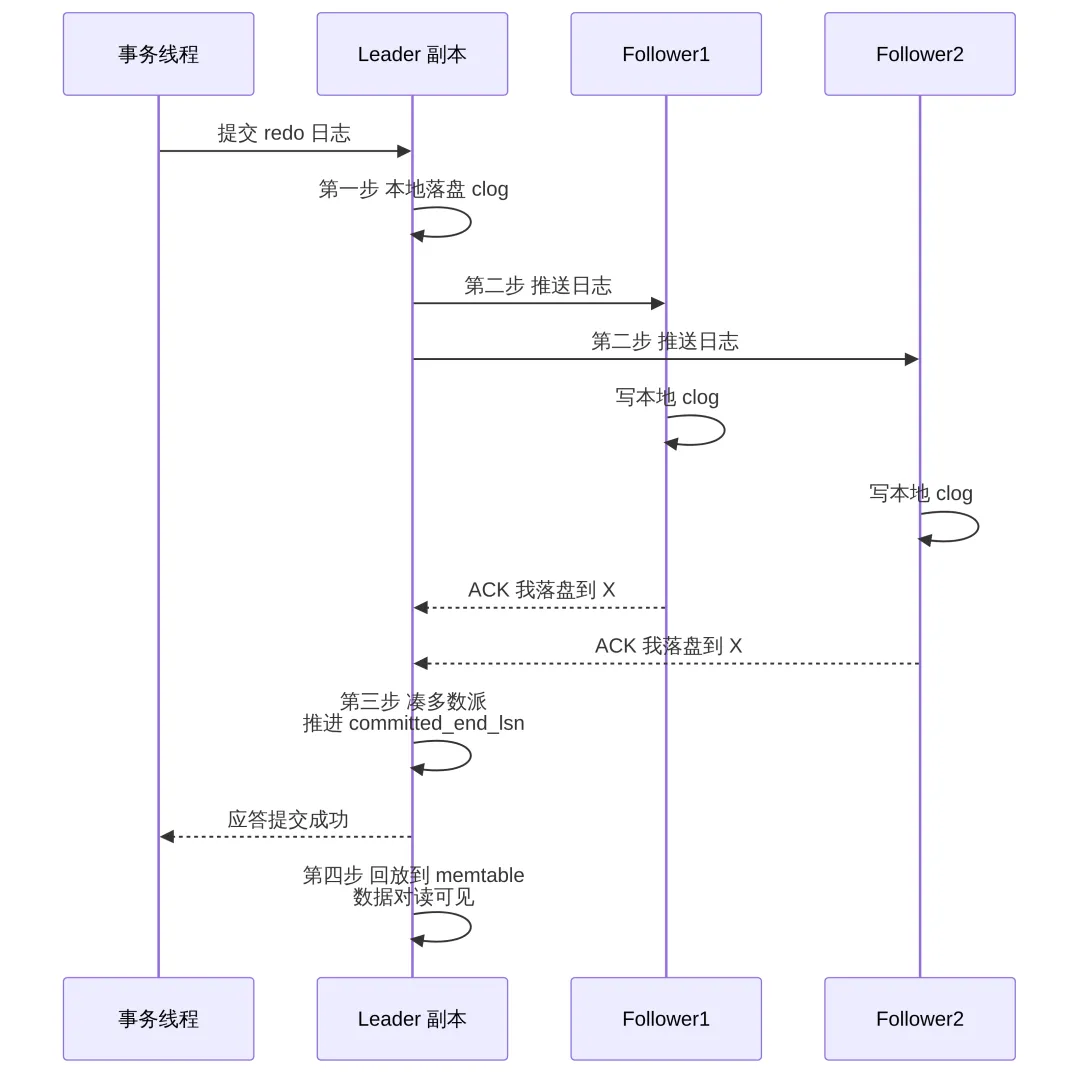
第一步,leader 本地落盘。顺序有讲究,先落自己的盘,不然后面出事连恢复的材料都没有。这个顺序跟 Oracle 的 LGWR 先写 redo log 再应答是同一个思想,持久性永远优先于可见性。
第二步,发往 follower。leader 把日志推给这条日志流的所有 follower,follower 写自己的 clog 后回 ACK。发送有窗口管理,src/logservice/palf/fixed_sliding_window.h 里那个 FixedSlidingWindow 干的就是这件事。窗口里每个槽位一条日志,槽位带引用计数和字节锁,滑出条件是 can_be_slid()。思想跟 TCP 滑动窗口相通,允许多条日志在途,不用每条都串行等确认,吞吐就是这么来的。
第三步,凑多数派。这是本篇的主角,下面单独拆。
第四步,回放。确认之后的日志 apply 到 memtable,数据对读可见。
多数派确认,源码里长什么样
follower 的 ACK 回到 leader,入口是 LogSlidingWindow::ack_log(log_sliding_window.cpp:4215):
int LogSlidingWindow::ack_log(const common::ObAddr &src_server, const LSN &end_lsn){ ... } else if (!in_member_list && !in_degraded_list) { // src_server is not paxos member or degraded learners, skip PALF_LOG(WARN, "src_server is not in curr_member_list/degraded_learner_list", ...); } else if (OB_FAIL(try_update_match_lsn_map_(src_server, end_lsn))) { ... } else { LSN new_committed_end_lsn; if (state_mgr_->is_leader_active()) { // Only leader with ACTIVE state can generate new committed_end_lsn. (void) gen_committed_end_lsn_(new_committed_end_lsn); if (new_committed_end_lsn > old_committed_end_lsn) { (void) leader_broadcast_committed_info_(new_committed_end_lsn); } } (void) handle_committed_log_();
逐层看。先验明正身,发 ACK 的家伙必须在 paxos 成员列表或降级 learner 列表里,陌生人的 ACK 直接扔掉。然后把对方的落盘位点记进 match_lsn_map_,这是一张"每个成员确认到哪个 LSN"的账本。只有 ACTIVE 状态的 leader 才有资格推进 committed_end_lsn,推进了还要广播给各副本,最后 handle_committed_log_ 处理这批刚确认的日志,等待中的事务在这里被唤醒。
真正算多数派的地方在 get_majority_lsn_(log_sliding_window.cpp:2856):
if (valid_member_cnt < replica_num / 2 + 1) { PALF_LOG(WARN, "match_lsn_map do not reach majority", ...); } else if (OB_SUCC(ret)) { lib::ob_sort(lsn_array, lsn_array + valid_member_cnt, LSNCompare()); result_lsn = lsn_array[replica_num / 2];
三行核心。把账本里所有成员的确认位点收进数组,检查人头够不够多数(replica_num/2+1),然后排序,取第 replica_num/2 个元素。三副本取第 1 个(下标从 0 数),也就是第二小的那个位点。为什么取它,排序后前两个成员都确认了小于等于这个位点的所有日志,加上"至少两个副本持有"就是多数派持有的定义。所谓多数派确认,落实到代码就是这么一次排序取中位。大道至简,简单的东西才可靠。
ACK 信息本身的结构也值得看一眼,log_ack_info.h:53 的 LogMemberAckInfo 就三个成员,成员地址、last_ack_time_us_(降级时 double check 用)、last_flushed_end_lsn_(升级时 double check 用)。降级升级时拿这两个时间戳和位点做二次确认,防止慢节点刚恢复就被算作有效票数。这个字段设计直接连着第 23 篇的仲裁话题,降级升级是仲裁场景的常规动作。
强弱同步,性能和安全的老矛盾
多数派机制之上还有个选择,等不等全部 follower。强同步等多数派落盘才应答,RPO=0,代价是提交延迟被最慢的那个多数派成员拖住。弱同步不等齐就放行,性能好,故障时可能丢最后一小段。
三副本强同步下,提交延迟约等于 leader 落盘时间加网络往返再加 follower 落盘时间。哪个环节慢了,整条链都在等。这就是为什么下面实验要拿 tc 给 follower 加延迟。
实验,给 follower 加 50ms 延迟看 TPS
可复现步骤,三副本测试集群。
第一步,跑基线。sysbench oltp_write_only 压业务租户,记录 TPS 和平均提交延迟。
第二步,找到目标日志流的 follower 所在机器,用 tc 给它的网卡加延迟,tc qdisc add dev eth0 root netem delay 50ms。
第三步,再看 TPS。预期观察到 TPS 明显下降,提交延迟抬高约 50ms 起步,因为每笔提交都要等这个慢 follower 的 ACK 凑多数派。GV$OB_SQL_AUDIT 里能看到请求耗时变长。
第四步,去掉延迟 tc qdisc del dev eth0 root,TPS 恢复。
这个实验把"强同步的代价由最慢的多数派成员决定"这句话变成了看得见的数字。再进一步,把延迟加到 500ms 以上,观察是否有副本被判超时降级,这就摸到下一篇选举的门槛了。
面试怎么答,生产怎么查
面试被问多数派怎么确认,按四步旅程答,本地落盘、推送 follower、收 ACK 推进 committed_end_lsn、回放可见。追问确认算法,答"每个成员的确认位点记账,排序取多数派位次的那个值",能说到 match_lsn_map 这个层次基本封顶了。再追问确认和回放的区别,答"确认管丢不了,回放管看得见"。
生产上怀疑日志同步慢,先看位点差距。查 GV$OB_LOG_STAT 或者相关视图,对比 leader 的写到哪和 follower 的确认到哪,差距拉大就是同步跟不上。再看慢在哪段,网络延迟(tc 实验那个思路)、follower 落盘慢(clog 盘 IO)、还是日志流上热点太重。observer 日志里 grep "ack log" 和 "majority" 关键字,确认位点推不推得动一目了然。
留给你的三个思考题
1. 三副本集群里 follower1 的 ACK 正常,follower2 机器宕机。committed_end_lsn 还能推进吗?用本篇的排序取位算法推一遍。
2. 面试官问"为什么取排序后的第 replica_num/2 个元素,取最小值行不行",你怎么回答?取最小值会丢什么保证?
3. 强同步集群里一个 follower 网络抖动 30 秒后恢复。这期间它错过的日志怎么补?结合 match_lsn_map 和滑动窗口想想补日志的触发点在哪。
干货已送达,点赞是签收,转发是好评,留言是售后!
关于我:郭一军 | 云贝教育创始人 | 25 年数据库老兵,长期为银行、证券等金融机构授课,专注信创数据库人才培养。
推荐阅读.从OBCE到源码
一、基础篇
二、架构篇
三台机器的 CPU 是 85%、30%、25%,负载均衡坏了吗
我把租户 A 的 CPU 打满了,租户 B 为什么还是抖了一下
IO调度源码合并和业务抢IO怎么办?翻出IO调度器的源码
三、内核篇
MemTable 明明最新,OceanBase 为什么不先读它
一次空查询要读几张 SSTable?BloomFilter的拦截战
更多精彩,关注我公众号,一起学习、成长