ARTICLE · 1365929
DeepSeek突发!算力不足,App网页版限额使用
算力饥荒撞上免费惯性:DeepSeek限额,只是大模型账单清算的第一声哨
11月16日,一批DeepSeek用户打开App,迎面撞上一行弹窗:受算力约束,存续超过7天且无活跃交互的长对话不再保留,单次输入上限压到4万字左右,每日对话额度另设天花板。
触碰上限的人看到的是同一句话,“因服务器繁忙,使用额度已达上限”。
官方口径克制到近乎冷淡。
行业分析给出的解释是回收闲置会话占用的KV缓存,把HBM显存腾给活跃请求。翻译成日常语言:显存不够用了,先把那些占着上下文却没人碰的会话请出去。
这不是一次产品迭代。这是一家以“极致性价比”立身的公司,在推理侧第一次向C端用户亮出了供给约束的底牌。
限额之前,故障记录已经把底牌掀开过一角。
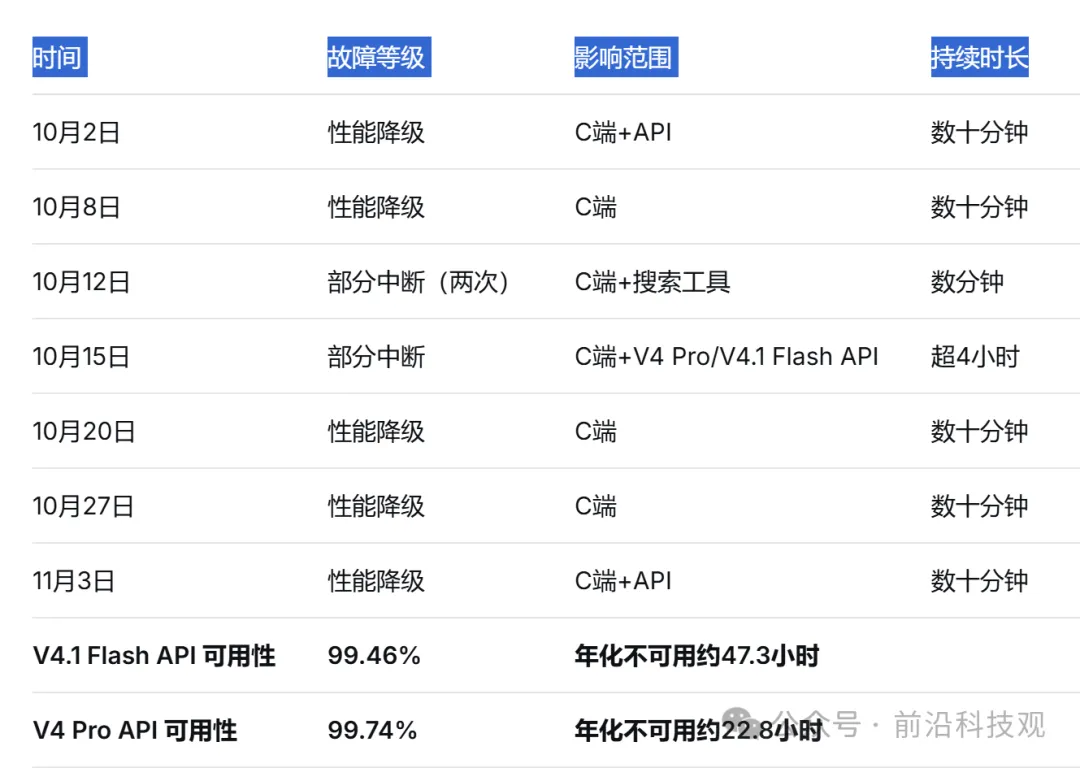
10月以来,DeepSeek状态页记录了8起异常,10月15日那次持续超过4小时,C端与V4 Pro、V4.1 Flash两条API线同步受限,事后靠赠金补偿开发者。按官方状态页口径,8月至10月V4.1 Flash API可用性99.46%,V4 Pro为99.74%。媒体做过一个折算:99.46%放到一年8760小时里,意味着Flash用户平均有47.3小时打不开服务,V4 Pro对应约22.8小时。
表1:DeepSeek近期故障记录与API可用性
数据来源:DeepSeek官方状态页,转引自36氪
需求侧的曲线比故障记录陡峭得多。
DeepSeek Harness披露的数据:截至11月4日,官方API口径日活154万,日消耗Token约92万亿。9月29日桌面端发布时的基数还停在日均活跃用户数的一个低位,一个月出头,日活翻了五倍以上。
表2:DeepSeek Harness用户与Token消耗
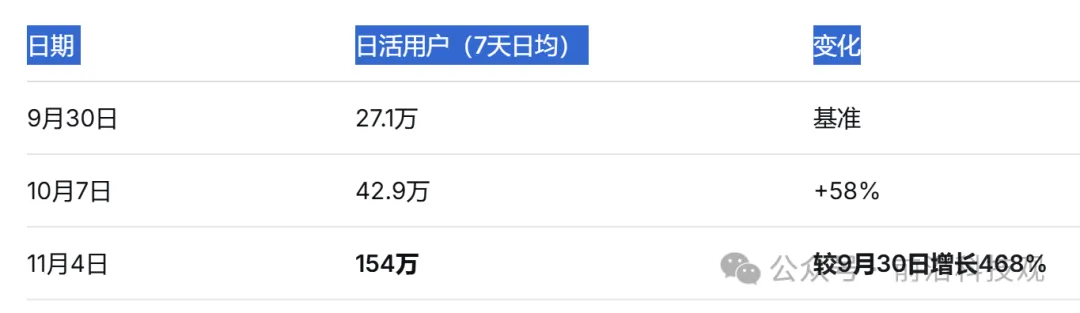
数据来源:DeepSeek Harness披露,36氪/北京商报
放到更大的盘子里看,这只是一条支流。国家数据局的口径:2026年3月,国内日均Token调用量突破140万亿,2024年初是1000亿。中国信通院的口径再往前推了一步:2026年6月日均消耗约500万亿,接近2025年12月的4倍,词元价格同期翻倍,量的增长达到3倍。
需求以指数斜率往上顶,供给的斜率被物理规律锁死。
IDC与浪潮信息联合发布的《2026年中国人工智能计算力发展评估报告》画出了一条剪刀差的完整轨迹:全球AI算力需求满足率从2024年的79%滑向2027年的71%谷底,2030年才勉强回到77%;缺口从389亿美元扩大到3809亿美元。
IDC副总裁周震刚把根子指向高端芯片、HBM和服务器CPU的产能扩张周期,以及能源约束的叠加。
表3:全球AI算力需求满足率与缺口
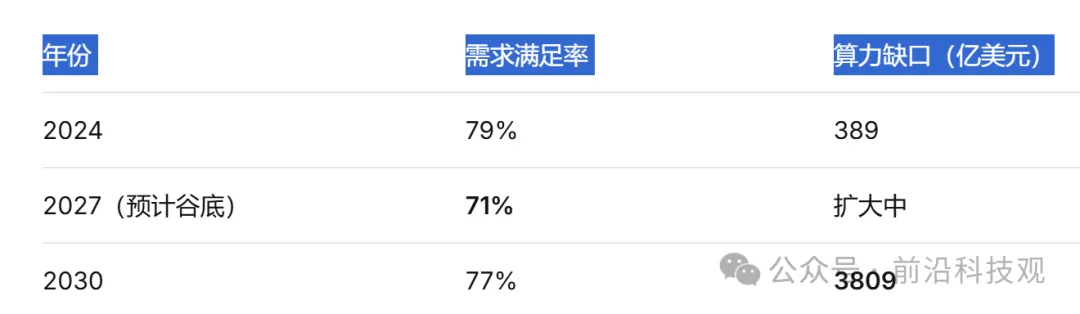
数据来源:IDC & 浪潮信息《2026年中国人工智能计算力发展评估报告》
DeepSeek V4 Pro的参数量是1.6万亿,预训练计算量粗略估算在1e25 FLOPs量级。技术社区做过一个粗糙但指向清晰的对照:用OpenAI同等规模的集群跑等量计算,时间以小时计;DeepSeek在没有同等卡数的前提下,训练和推理的排队逻辑注定是另一套算法。
工程效率可以压缩单Token成本,V4 Pro在百万上下文下把单token推理FLOPs压到V3.2的27%,KV缓存压到10%,但压缩改变不了排队本身的物理存在。
云厂商的调价动作比模型公司的弹窗诚实得多。
2026年3月,十天内三家头部云厂商集体转向。阿里云算力卡产品上调5%至34%,百度智能云AI算力上调5%至30%,腾讯云混元系列模型价格上调超过4倍。
云计算行业二十年“只降不升”的定价惯性,在这一轮里被撕开一道口子。这不是孤立现象:AWS年初对训练用EC2容量块提价15%,谷歌云北美AI基础设施涨幅冲到100%,欧洲厂商跟进,涨价是一条全球同步的线。
表4:2026年3月主要云厂商AI算力调价
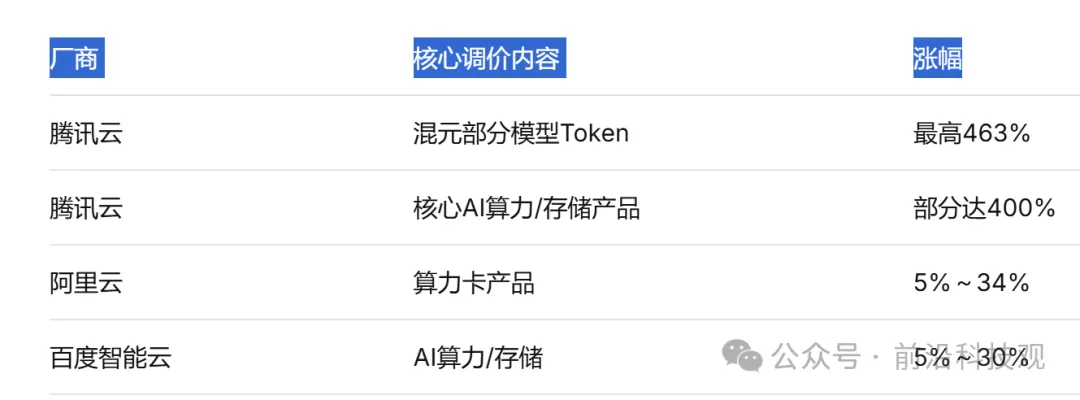
数据来源:新华财经、经济日报
国产算力的替代在真实发生,但兑现节奏和需求爆发之间存在一个时间差。IDC出货口径:2026年上半年国内AI加速器总出货约200.8万颗,英伟达份额降至34%,华为昇腾以28%、57.2万颗排在国产首位,国产五家厂商合计超过47%。
非GPU加速器出货101.6万颗,首次超过GPU的99.1万颗。这是一个结构性的信号,但它解决的是“有没有”,不是“够不够”。
表5:2026上半年中国AI加速器市场份额(IDC出货口径)
数据来源:IDC,转引自投资界/格隆汇
供给侧的长期布局都在推进。DeepSeek在乌兰察布规划GW级数据中心,至少16万颗国产AI芯片,投产窗口落在2027年底到2028年初。
互联网大厂和运营商的资本开支在加速:腾讯上半年847亿元,阿里945亿元,中国移动2027年算力专项投资超过1000亿元,中国电信算力基础设施投资同比增长26%。方向没有问题,节奏也都在走。
但所有这些动作从资本开支变成可调度的推理Token,最短的时滞以季度计,长的以年计。IDC报告里那句判断值得原样保留:物理世界的供给增速难以匹配数字世界的需求增速。
回到限额本身。KV缓存的技术逻辑不复杂:长对话持续驻留上下文,闲置会话不释放,HBM显存就被锁在低效状态。
回收7天不活跃的长对话,在工程上是成本最低的调节阀。真正值得琢磨的是选择背后的信号。
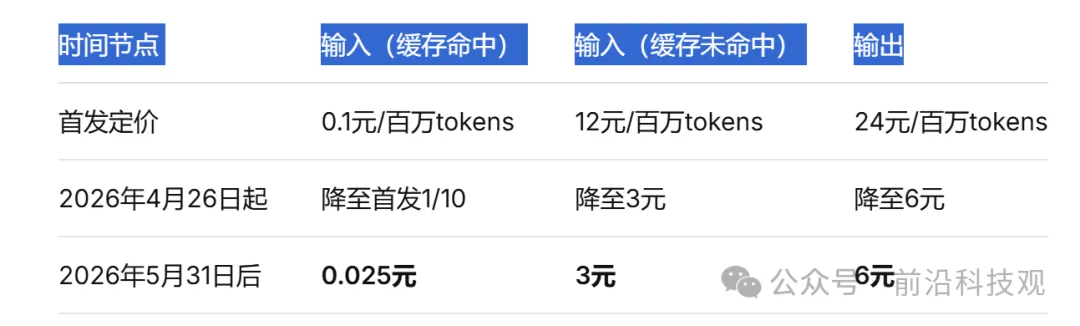
DeepSeek过去最锋利的武器是价格。V4 Pro的API定价一路压到每百万tokens输入缓存命中0.025元、输出6元,5月底官宣永久降为原价的四分之一,“创全球大模型价格新低”。
C端长期免费。这套打法的隐含前提是:算力成本可以被规模摊薄,或者被资本耐心覆盖。
两个前提都在松动。云厂商的涨价函已经送到了每一家AI应用公司的桌上,Token从“越用越便宜”的叙事滑向“越用越紧”的现实。
DeepSeek自己在API侧启用了峰谷定价,闲时价格为高峰的一半,用价格信号引导错峰调用,C端与API的资源池做隔离,deepseek-flash和v4-pro分别设2500、500的账号并发上限。
这是Token从统一定价走向动态定价的一小步,也是大模型服务从“公共品”向“经营性商品”回摆的切面。
免费大模型的好日子建立在三重幻觉上:算力无限、资本无限、用户增长不产生边际成本。三个条件里任何一个松动,商业模型就得重写。
DeepSeek选择用限额代替收费,用“限制”替代“账单”,手法温和,方向清晰。今天收回的是闲置长对话和输入字数,明天收回的可能是调用频次,后天摆在台面上的就是一张分级价目表。
DeepSeek依然是国产模型里工程效率最锋利的那一个。它在昇腾平台上的推理加速、在KV缓存上的压缩、在峰谷调度上的尝试,都是真实的技术动作。但效率优化能推迟账单,消不掉账单。
算力是重资产,Token是消耗品,推理的每一次前向计算都在产生电费、折旧和显存占用。
当需求曲线以千倍为单位抬升,供给曲线以产能周期为单位爬坡,免费就不再是一个可以无限续杯的选项。
限额弹窗是一声哨响。
哨声之后,大模型行业要面对的那个问题越来越难绕开:你愿意为一次推理付多少钱,用户又愿意为一次回答付多少钱。
这两个数字之间的差额,资本可以补一年、补两年,补不了永远。
对这个话题,您怎么看?
期待您在留言区文明理性发布高见,留言点赞最高的朋友,扫文末微信,可获得投行圈子精美商务背包一个。
声明:本文仅为财经热点分析,数据及资料援引公开查询、公司公告及同花顺IFinD,观点仅供参考,不构成任何投资或消费建议。
#科技热点#深度解读#商业财经 #科技大厂 #上市公司#AI#一级市场#上市#前沿科技
感谢耐心阅读,欢迎顺手点个“在看”。