ARTICLE · 1373297
谷歌开源了"大象与金鱼"插件,专挑AI看不见的坑!
19,955颗星,本周新增5k!
google/elephant-goldfish-model在GitHub Trending周榜排第五。
仓库版本号还停在0.1.1。
让Claude Code写完一份设计文档,紧接着在同一个会话里追一句"请审查这份设计",回来的多半是"结构清晰、考虑周全、可以实施",它记得自己刚才为什么这么写,也就看不见自己漏了什么。
谷歌这个插件把"写"和"审"拆给了两个角色:大象负责写,金鱼负责挑刺。
名字直接来自仓库名elephant-goldfish-model,仓库用Apache-2.0开源,里面是7个技能、10个人格文件、5份写死的评审标准。
为什么偏偏是大象和金鱼?
这两个名字来自Dave Rensin的文章《Elephants, Goldfish, and the New Golden Age of Software Engineering》,EGM架构文档的三位作者里就有他。
取名逻辑很直白:
大象在俗语里是从不忘记的代表,一个项目的历史、需求、先前决策都该有人记得住;
金鱼的梗是"记忆只有七秒",眼前的东西看完就忘!
两个角色各拿一种上下文:
| 不能,严格只读 |
大象是主会话里一直陪着你干活的那个Agent,金鱼是评审时临时拉起来的subagent,用完即弃,它们背后可能是同一个模型,差别全在喂了什么上下文。
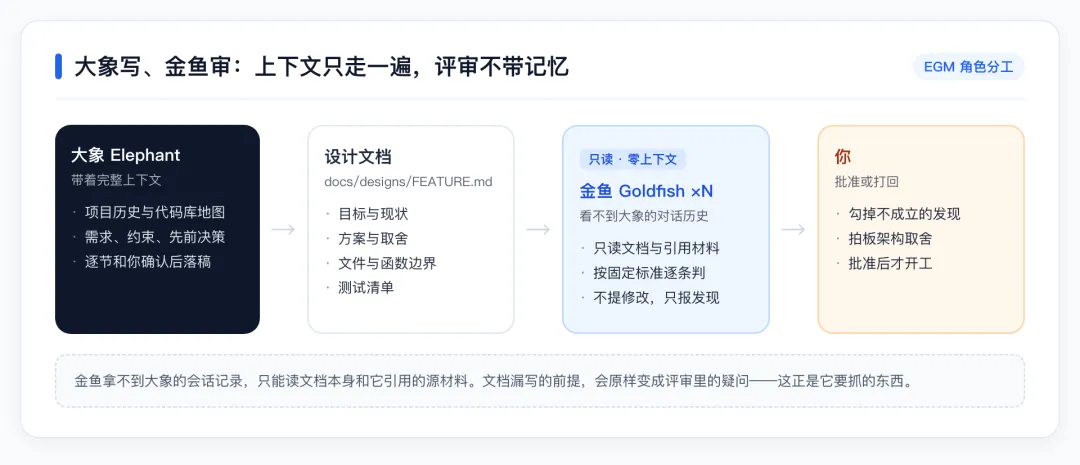
这个设计把"模型审自己"换成了"不带记忆的模型审文档",大象写下的每一个假设,金鱼都会当成陌生的文档重新读一遍,读不通的地方原样报出来。
技能文档提到:宿主没有subagent工具,评审就必须停下来,同一个上下文里跑出来的复述不算金鱼评审,独立版Antigravity IDE就卡在这一条上。
同一个会话里,模型审不出自己的问题
架构文档四种系统性失败
第一种就是开头那幕的学名:幻觉级联与上下文污染——同一线程里先访谈、再设计、再写码,前面那些"可能吧""先这样"的猜测会留在上下文里被当成事实,模型再拿它们论证自己没错。
另外三条分别是过早实现、聊天窗塞满和文档漂移。过早实现指Agent默认就近改文件,跳过架构位置、YAGNI检查和已有服务复用。文档漂移指设计文档随代码腐烂,后来接手的Agent读到的是一份过期地图。
四条失败对应四个每天都在发生的动作:同一会话自我审查、直接开写、把长文档贴进聊天窗、设计文档不跟代码一起提交。这些事很少被当成"流程问题"记在账上,直到某天发现AI写的模块谁也不认识。
五道关,每关换一批金鱼
review技能分五个阶段跑,每关换不同的评审人格,跑完才汇总:
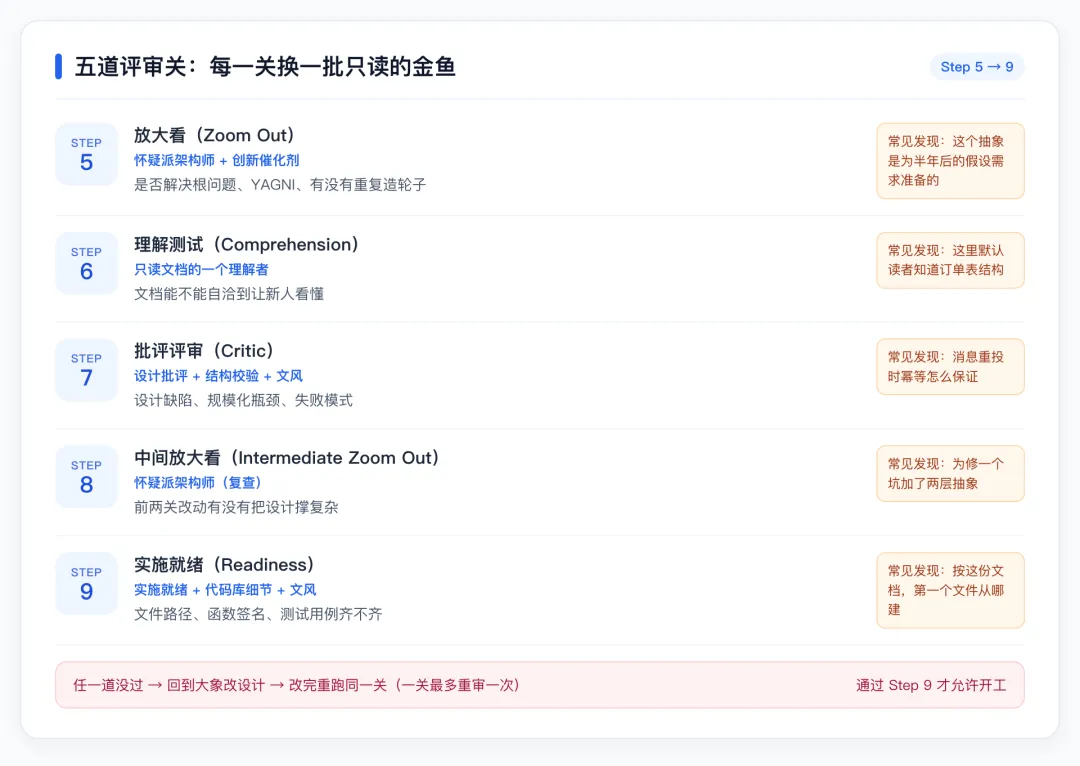
原文把流程标成1到N,前四步是人与模型的对话式推演,插件接的是第五步之后的评审段,通过Step 9,文档才算能拿去开工;没过,回大象那边改,改完再跑。
Comprehension只给它这份文档,不给代码库,也不给之前的对话。文档少写一句前提,它就照着缺的那块去理解,然后把偏差原样写进报告。这一步测的是文档能不能脱离作者独立成立。
Step 9只认三件事:第一个文件建在哪、函数签名是什么、测试用例怎么写。三样写不出来,评审直接判未就绪。
先看全局,再测文档自洽,然后抠设计细节,细节关放到前面,容易在错误的方向上打磨得很精细。
发现按🔴Blocker、🟡Major、🟢Nit三档汇总,每条通过追溯矩阵挂回原文,可以直接在PR里对照着改。
写死的标准
仓库提供了5份标准:
zoom-out
feature-spec
implementation-readiness
re-implementation
heilmeier
评审人格读哪份标准、按哪几条判,都在技能里绑定好了。
heilmeier则直接照搬了DARPA的Heilmeier提问法:
zoom-out那份把"简单"拆成了可判定的条目:是否只治标不治本、是否与项目根文档的架构哲学一致、是否引入投机性抽象、是否在瓶颈未被证明前就上缓存和异步队列。
让模型"审一下这份设计",它给的是观感;让它对照八问逐条打勾,缺哪条当场露出来,评审质量的上限,被标准文档抬高了。
七个技能串成的一条流水线
仓库里的7个技能各管一段,不要求按顺序全用:
/egm-brainstorm | concepts_brief.md | |
/egm-draft | docs/designs/<feature>.md | |
/egm-review | ||
/egm-resolve | ||
/egm-bootstrap | ||
/egm-drift-report | ||
/egm-review-loop |
"7个视角同时开枪"的实现细节:技能文档要求并行起多个lens,禁止串行评审,因为串行会带来顺序偏置,前一个评审的结论会影响后一个的注意力。
drift-report适合当每周例行动作,文档与代码分叉在多人项目里几乎必然发生,与其等新人读文档被误导,不如每周跑一次,人工决定改文档还是改代码。
这套流程同样能审提案和项目计划,换一组评审人格和标准即可,立项书、方案、跨团队技术提案,都能按Heilmeier八问过一遍。
bootstrap帮助则解决存量项目接入:老代码库没有设计文档,先让它自底向上生成各级README,把上下文层级搭起来,大象才有东西可读。
项目目录官方给了个推荐形态,docs/designs放批准后的设计,_agents/skills放给大象用的项目上下文索引:
path/to/project
├── _agents/skills/<project>_elephant/SKILL.md
└── docs/designs/
    ├── SITEMAP.md
    └── FEATURE.md
_agents/skills/<project>_elephant是可选项,作用给大象装一份项目上下文索引,不用每次从零翻代码。
/egm-resolve的边界划得清楚:金鱼只提发现,大象把每条标成"提议修改"或"反驳",你批准之后才动文档,改完重跑同一关,一关最多重审一次,防止在一条意见上来回打磨。
前提与安装方法
官方列了三个主宿主的装法:
# Claude Code
claude plugin marketplace add google/elephant-goldfish-model
claude plugin install egm@egm

# Codex CLI
codex plugin marketplace add google/elephant-goldfish-model
codex plugin add egm@egm

# Antigravity CLI
agy plugin install https://github.com/google/elephant-goldfish-model
安装前提,装之前先看看:
- 必须整包安装
只拷skills目录会坏掉,因为技能运行时要去读agents/和resources/document_standards/。 - 宿主得有subagent工具
没有就停,独立版Antigravity IDE就卡在这一条。 - 产物目录可以另指
在CLAUDE.md或AGENTS.md里加一行 EGM artifact directory: .dev/docs,草稿和报告就写到指定目录,不污染仓库根目录。
默认产物落在工作目录:concepts_brief.md、design_draft.md、几份评审报告,批准后的设计再进docs/designs/。
Claude Cowork可以从claude.ai/plugins里装,ChatGPT侧要在工作区后台导入市场。
哪些宿主真能跑
harnesses.md把每个宿主的支持状态列得很细,摘几条差异明显的:
| 不支持 | ||
Codex和Antigravity的泄漏都写在harnesses.md里,官方叫它"宿主指令泄漏":全新subagent能隔离父对话的历史轮次,但项目或用户的指令文件仍可能被带进评审上下文。
Claude的适配器设了omitClaudeMd来规避这个问题,Codex和Antigravity在文档里明确写着"没有验证到指令文件被排除"。
是否有坑?先泼盆冷水...
版本号0.1.1。74个open issue、40个open PR、204次提交。技能、人格、标准三层结构已经跑通,但这是早期版本,接口会变。
官方自己划了界线。plugin.json里写着"Not an officially supported Google product",仓库和issue区都按社区项目对待,不承诺企业级支持。
一次评审的开销不小。五道关要起3到15个subagent,每个都独立读文档、按标准出报告。官方对输出的定位也很克制:反馈会很多,按相关性取用,其余忽略。
评审意见默认是英文。技能里把"Plain-English Standard"写成了硬约束,草稿摘要和评审通信都要用不带行话的英文。中文团队得多花一道翻译和转述的工序。
没有docs/designs/的项目跑这套流程,产出只是一份草稿,第二天照样得重来。
这个项目适合谁?
有设计文档、多人协作、需要把架构决策留在仓库里的团队,适合从/egm-review单关切入:拿一份现有设计跑一遍,看金鱼能不能挑出你自己没想到的那条。报告是.md文件,能进PR、能被同事看见、能留到半年后翻旧账,会话里的自查过一晚上就找不回来了。
一个人维护的小脚本、一次性能改完的bug,官方文档明说别硬套:能一把改完的事,走流程是浪费时间。
如果觉得有用,再去补/egm-draft和/egm-brainstorm把上游接上。
如果直接从上游开始,容易先被流程本身劝退。
历史文章: