 夜雨聆风
上一章拆解了 langchain-tests,看见 LangChain 如何用同一套可执行契约验收不同模型集成。
但在真正进入检索链路之前,还有一道更早、也更容易被低估的工程边界:一篇几十页的文档,究竟应该以什么粒度进入向量库?
切得太大,召回结果会夹带大量无关上下文;切得太小,标题、定义和论证关系会被撕开;重叠太多,索引体积、召回重复和模型输入成本一起上涨;没有来源元数据,最终答案即使正确,也很难给出可靠引用。
所以 text splitting 不是“把字符串每 N 个字符截一刀”。它实际决定了检索系统最小的知识单元。
LangChain 把这套能力独立成 langchain-text-splitters,再用 TextSplitter、RecursiveCharacterTextSplitter、token splitter、标题感知 splitter 和结构化 splitter 处理不同边界。
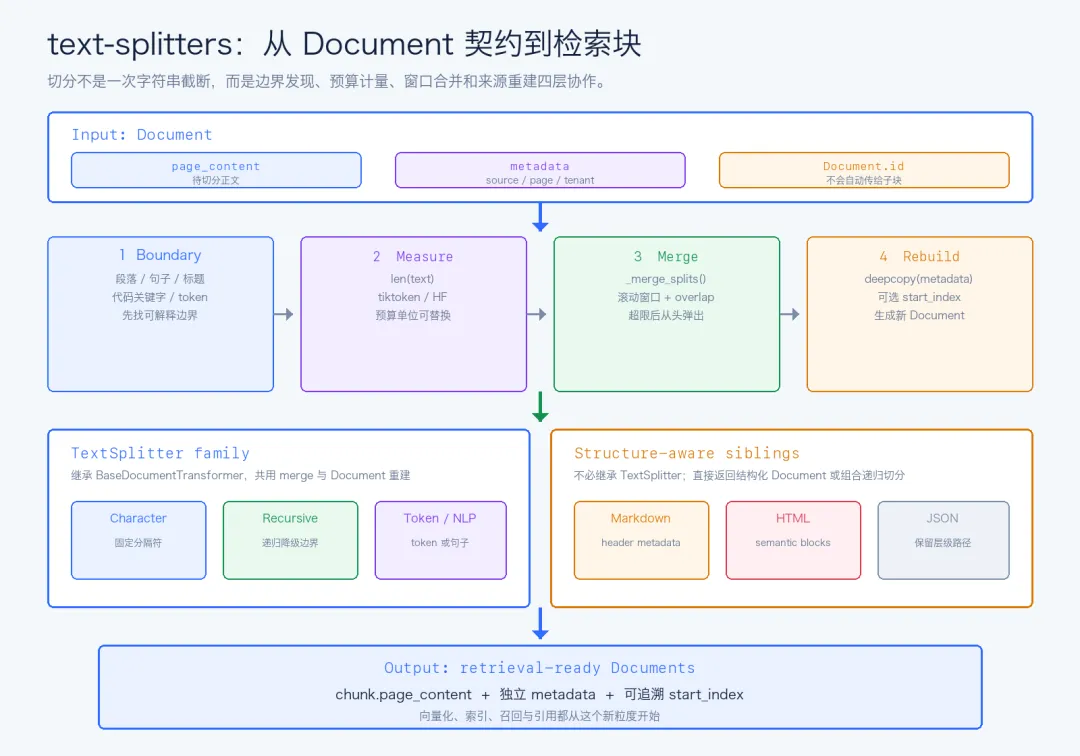
TextSplitter的核心不是某一种分隔符,而是一条四层管线:发现候选边界,用可替换的长度函数计量预算,用滚动窗口合并并保留上下文,最后重建带来源信息的Document。
一、切分质量决定的不是排版,而是召回单元
假设原文包含三段内容:
标题:退款规则
第一段:适用范围
第二段:退款比例
第三段:例外情况
如果固定每 100 个字符切一次,第二段的条件可能留在前一个 chunk,比例数字落到后一个 chunk。向量检索召回“退款比例”时,只拿到数字却拿不到条件,模型就会在缺失约束的上下文里生成答案。
反过来,如果把整页都作为一个 chunk,标题、范围、比例和例外虽然都在,但检索向量会同时表达多个主题。查询只与其中一小段相关,剩余内容会稀释匹配信号。
切分因此同时影响四件事:
这也是为什么 LangChain 没把 splitter 藏在某个向量库实现里。它是摄取管线中的独立决策层,应该在 embedding 和索引之前显式存在。
二、langchain-text-splitters 是独立发布的边界层
langchain-text-splitters 是独立版本的包,核心依赖只有 langchain-core。
这个依赖方向很有意思:
langchain-core
  └── Document + BaseDocumentTransformer
          ▲
          │
langchain-text-splitters
  └── 各类切分策略
它不需要知道向量库、Agent 或具体模型,只依赖两项稳定契约:
输入输出都可以表示为 Document;一个 document transformer 接收一组文档并返回变换后的文档。
因此 splitter 既可以独立使用,也能插入更大的文档加载、清洗、切分、嵌入和索引流程。
包的公开入口还特意写了一条提示:MarkdownHeaderTextSplitter 与 HTMLHeaderTextSplitter 并不继承 TextSplitter。
这说明“text splitter”是一个能力集合,不是所有实现都必须塞进同一个继承树。字符串预算型切分和结构解析型切分,输出形状相似,但内部契约并不完全相同。
三、TextSplitter 首先是一个 DocumentTransformer
TextSplitter 的类定义不是孤立的字符串工具:
class TextSplitter(BaseDocumentTransformer, ABC):
    @abstractmethod
    def split_text(self, text: str) -> list[str]:
        ...
它同时提供三层入口:
split_text(text)
  -> list[str]

create_documents(texts, metadatas)
  -> list[Document]

transform_documents(documents)
  -> Sequence[Document]
最底层 split_text() 只关心字符串。create_documents() 把字符串结果包装成文档,transform_documents() 则把 splitter 接回统一的 document transformer 协议。
BaseDocumentTransformer 还提供默认异步入口。它不是重新实现一套异步切分算法,而是通过 executor 执行同步的 transform_documents()。
所以这里的 async 表示“可以在异步管线中调用”,不代表每个 splitter 内部都有原生异步计算。
四、六个参数其实定义了三类不同契约
TextSplitter 的构造参数看起来不多:
TextSplitter(
    chunk_size=4000,
    chunk_overlap=200,
    length_function=len,
    keep_separator=False,
    add_start_index=False,
    strip_whitespace=True,
)
但它们并不是同一层的配置。
chunk_size | ||
chunk_overlap | ||
length_function | ||
keep_separator | ||
add_start_index | ||
strip_whitespace |
构造函数会拒绝 chunk_size <= 0、负 overlap,以及 chunk_overlap > chunk_size。
注意这里允许二者相等。对字符型 splitter,这在某些输入下仍能结束;但真正按 token 滑动窗口时,步长是 tokens_per_chunk - chunk_overlap,二者相等会让窗口无法前进,因此 token 路径会进一步要求 tokens_per_chunk > chunk_overlap。
同名参数到了不同策略里,仍然要服从该策略能否前进的算法约束。
五、CharacterTextSplitter 是“先拆再合”,不是直接定长切片
最简单的 CharacterTextSplitter 也没有直接写 text[i:i + chunk_size]。
它先按指定 separator 拆出原子片段,再调用 _merge_splits() 把相邻片段合并到预算附近:
splitter = CharacterTextSplitter(
    separator=" ",
    chunk_size=7,
    chunk_overlap=3,
)

splitter.split_text("foo bar baz 123")
结果是:
foo bar
bar baz
baz 123
空格是候选边界,7 是合并预算,3 决定上一窗口尾部能保留多少。算法先形成 foo bar,发现再加入 baz 会超限,于是输出当前块,并从窗口头部弹出 foo,留下 bar 参与下一块。
这类设计的价值是:chunk 尽量接近预算,但边界仍然落在完整单词之间。
separator 还可以是正则表达式。实现会区分普通分隔符与零宽 lookaround:普通分隔符在 keep_separator=False 时可以在合并阶段重新插回;零宽断言本身不消费字符,不能被当成普通文本再次插入。
六、分隔符放在开头还是结尾,会改变语义归属
keep_separator 不只是“保不保留标点”。它还决定边界属于哪一侧。
对输入:
foo.bar.baz.123
使用 . 切分时,三种结果分别是:
False   -> foo | bar | baz | 123
start   -> foo | .bar | .baz | .123
end     -> foo. | bar. | baz. | 123
对自然语言,句号通常更适合留在前一句结尾;对 Markdown 标题,\n## 更适合留在下一段开头;对代码中的 \nclass 或 \ndef,把关键字留在新块开头,更有利于块自身表达结构。
RecursiveCharacterTextSplitter 默认 keep_separator=True,等价于放在下一块开头。这与普通 CharacterTextSplitter 默认丢弃 separator 不同。
默认值的差异反映了两种意图:固定 separator 更像显式切割;递归 separator 更强调在降级切分时保存结构提示。
七、递归切分的关键,是“高层边界优先,超长才降级”
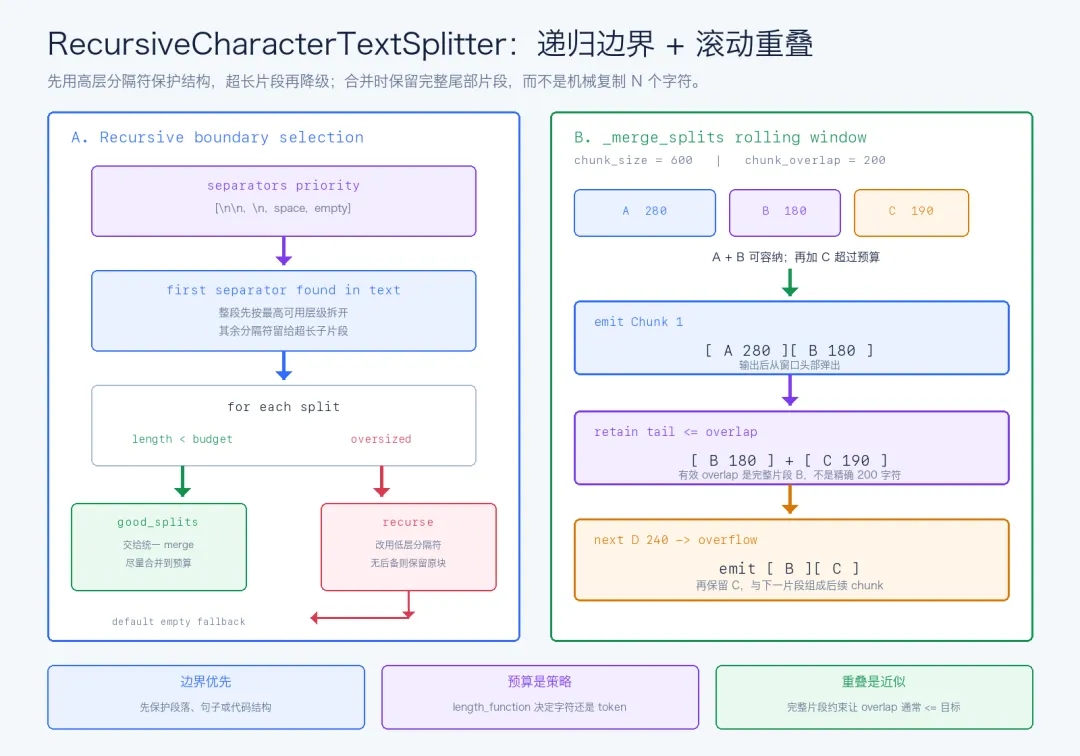
RecursiveCharacterTextSplitter 默认分隔符顺序是:
["\n\n", "\n", " ", ""]
它的流程不是同时尝试四种切法再评分,而是按优先级寻找当前文本中第一个存在的 separator:
能按段落拆,就先保护段落边界; 某个段落仍然太长,再对这个段落按换行拆; 某一行仍然太长,再按空格拆; 单词仍然太长,最后退到空字符串,按字符拆。
伪代码可以概括为:
choose first separator found in text
split text by it

for each piece:
    if piece fits budget:
        collect as good split
    else:
        merge collected good splits
        recurse piece with lower-priority separators

merge remaining good splits
这里的递归只发生在超长片段上。已经满足预算的片段不会继续被低层 separator 打碎,而是交给统一合并器尽量拼成更饱满的 chunk。
八、_merge_splits() 才是所有字符与句子策略共享的核心
无论候选片段来自空格、段落、NLTK 句子还是 spaCy sentence,很多 splitter 最终都会进入 _merge_splits()。
它维护两个状态:
current_doc: 当前窗口中的完整片段列表
total:       片段长度 + 片段间 separator 长度
当加入新片段会超过 chunk_size 时:
先把当前窗口 join 成一个 chunk; 如果窗口总长大于 overlap,从头部不断弹出片段; 即使已经不大于 overlap,但“保留尾部 + 新片段”仍然超预算,也会继续弹出; 最后把新片段加入剩余窗口。
这不是一个只判断一次的 if,而是一个持续收缩窗口的 while。
第二个收缩条件很重要。否则为了保住 overlap,下一块可能在加入第一个新片段时就再次超限,算法会制造连续的大块。
最后 _join_docs() 负责拼接 separator、按配置 strip 首尾空白,并把空字符串转换成 None,因此空输入和纯空白输入不会生成空 Document。
九、chunk_overlap=200 不代表精确复制 200 个字符
这是使用 splitter 时最容易产生的误解之一。
_merge_splits() 的窗口元素不是单个字符,而是前一步产生的完整片段。算法只能从头部整片弹出,不能为了凑满 200 再把某个句子切成两半。
假设尾部片段长度分别是 280 和 180,目标 overlap 是 200。输出 chunk 后,算法弹出 280,留下完整的 180。下一块的有效 overlap 是 180,而不是精确的 200。
如果最后一个原子片段本身是 260,它又会被整片弹出,实际 overlap 可能变成 0。
所以 separator-based splitter 的 overlap 更准确的定义是:
在不破坏原子边界和下一块预算的前提下,尽量保留不超过目标 overlap 的尾部片段。
这个取舍是合理的。重叠的目的本来就是保留语义连接;为了精确达到字符数而切开句子,反而会破坏它试图保护的内容。
十、chunk_size 也常常是软预算,而不是绝对上限
CharacterTextSplitter(separator=" ") 遇到一个长度 20 的单词,而 chunk_size=10 时,没有更细的 separator 可以继续切。这个单词会作为一个超过预算的原子块返回。
RecursiveCharacterTextSplitter 默认把空字符串放在最后,因此通常可以一路退到字符级,把普通文本压进预算。但以下情况仍然可能产生超长块:
调用方自定义 separators,却没有提供最终字符级后备; 一个最小原子单位在自定义 length_function下就已经超过预算;结构型 splitter 为了保存标签、代码块或媒体元素,主动选择不继续拆解。
因此工程上不应该只写:
assert all(len(chunk) <= chunk_size for chunk in chunks)
更合理的是同时记录超长原因:它是配置遗漏、不可分结构,还是业务主动允许的原子单元。
chunk_size 是合并器努力满足的预算;是否成为硬上限,取决于策略有没有可靠的最小后备边界。
十一、按 token 计量和按 token 切片,是两件不同的事
length_function 让字符型 splitter 可以改用 tokenizer 计量:
splitter = RecursiveCharacterTextSplitter.from_tiktoken_encoder(
    encoding_name="cl100k_base",
    chunk_size=800,
    chunk_overlap=100,
)
这时边界仍然来自段落、换行、空格和字符,只是 _merge_splits() 判断预算时调用 tokenizer 计算 token 数。
而 TokenTextSplitter 走的是另一条路径:
text
  -> encode token ids
  -> ids[start:start + tokens_per_chunk]
  -> decode chunk
  -> start += tokens_per_chunk - chunk_overlap
二者差异可以直接列成表:
TokenTextSplitter | |||
Sentence Transformers 路径还会先去掉 tokenizer 自动加入的开始与结束 token,再做窗口切片,避免把特殊 token 当成正文预算反复计算。
所以“用了 tiktoken”不能直接推导出“按 token 边界切”。要看它只是 length_function,还是直接驱动窗口下标。
十二、Document 重建负责把切分结果重新接回来源
create_documents() 会遍历原始文本,为每个 chunk 创建新的 Document。
它对 metadata 使用深拷贝:
parent metadata
  -> deepcopy -> chunk 1 metadata
  -> deepcopy -> chunk 2 metadata
因此给 chunk 1 增加 rerank 分数或清洗标记,不会污染 chunk 2,也不会修改原始文档的嵌套 metadata。
开启 add_start_index=True 后,它还会在 metadata 中写入字符偏移:
Document(
    page_content="bar baz",
    metadata={"source": "policy.md", "start_index": 4},
)
这个位置不是 parser 在切分时一路携带的 source map,而是在 chunk 生成后,通过 text.find() 回原文搜索得到。搜索起点会参考前一块位置、前一块字符长度和 overlap,避免重复文本总是命中第一次出现的位置。
这里有两个边界值得记住:
start_index是原始字符串的字符偏移,不是 token 下标; split_documents()传递的是 page_content与 metadata,不会自动继承父Document.id。
如果检索链路依赖稳定父文档 ID,应该把它显式放进 metadata,例如 parent_id,而不是假设子块保留对象级 ID。
十三、标题感知 splitter 为什么不必继承 TextSplitter
MarkdownHeaderTextSplitter 的目标不是先满足字符预算,而是把标题层级转成 metadata:
# 产品手册
## 退款规则
正文

-> Document(
     page_content="正文",
     metadata={"h1": "产品手册", "h2": "退款规则"}
   )
它直接返回 Document,因为输出不只是字符串碎片,还包含解析过程中得到的结构信息。
HTML 也有类似分层:
HTMLHeaderTextSplitter按标题组织内容; HTMLSectionSplitter先提取 section,再用递归字符切分处理超长 section; HTMLSemanticPreservingSplitter直接实现 BaseDocumentTransformer,保存链接、列表、表格或媒体等元素,并组合RecursiveCharacterTextSplitter做二次预算切分。
RecursiveJsonSplitter 则保留 JSON 层级路径,必要时把 list 转成按索引命名的 dict,再按序列化大小组织 chunk。它没有 overlap 语义,也不需要继承字符串窗口算法。
从这些实现可以看出一个清晰原则:
当策略的首要任务是解析结构和生成 metadata 时,直接返回 Document 更自然;当首要任务是围绕统一预算合并文本片段时,继承 TextSplitter 更合适。
十四、代码与 Markdown 的“语言感知”仍然是优先级规则,不是 AST
RecursiveCharacterTextSplitter.from_language(Language.PYTHON) 会为 Python 配置类似这样的 separator:
\nclass
\ndef
\n\tdef
\n\n
\n
space
empty
Markdown 则优先标题、代码围栏和水平线,HTML 优先常见标签,其他语言也会列出 class、function、control flow 等候选边界。
from_language() 会把这些规则当成正则 separator 使用,但它并没有构建语法树。
因此它能做到的是“优先在看起来像结构边界的位置切”,不能保证:
字符串字面量里的 class一定被识别为普通文本;嵌套函数、装饰器与注释始终归属正确; 一个 chunk 必然对应完整 AST 节点; 非法或不完整代码仍能被正确解析。
这种方案的优势是轻量、无编译器依赖、对残缺文本也能工作;代价是语义保证弱于真正的 parser。
把它称为“语言优先级切分”比“语法解析切分”更准确。
十五、最稳妥的实践是先保结构,再控制预算
对于 Markdown,一条常见的两阶段管线是:
from langchain_text_splitters import (
    MarkdownHeaderTextSplitter,
    RecursiveCharacterTextSplitter,
)

sections = MarkdownHeaderTextSplitter(
    headers_to_split_on=[("#", "h1"), ("##", "h2")]
).split_text(markdown_text)

chunks = RecursiveCharacterTextSplitter(
    chunk_size=800,
    chunk_overlap=120,
    keep_separator="start",
    add_start_index=True,
).transform_documents(sections)
第一阶段把标题变成 metadata,第二阶段只处理仍然过长的正文。这样比直接对整篇 Markdown 做字符递归多保留了一层可用于过滤、引用和展示的结构。
不同输入可以采用不同组合:
from_language() | ||
不存在一个对所有文档都最优的 chunk_size。边界类型、embedding 模型、查询长度、召回数量和下游 prompt 都会改变最佳粒度。
十六、切分器应该用检索不变量验收,而不是只看块数量
一套可执行的验收至少应该覆盖:
空输入和纯空白不产生空块; 普通块符合预算,超长原子块有明确原因; separator 的 start/end 归属与业务语义一致; metadata 在不同 chunk 之间互不共享可变对象; 开启 start_index时,原文切片能还原 chunk;相同输入重复切分得到稳定顺序; token 预算使用与下游模型或 embedding 相同的 tokenizer; 用真实查询评估召回,而不是只优化平均 chunk 长度。
最后一条最重要。
切分算法只能提供候选边界与预算保证,无法单独证明检索效果。真正的闭环应该是:
切分配置
  -> 建索引
  -> 真实查询集
  -> recall / precision / citation coverage
  -> 调整边界、预算与 overlap
回头看,langchain-text-splitters 的设计重点不是发明一种万能分块算法,而是把边界、长度、重叠和来源拆成可以独立替换的策略。
这使同一份 Document 契约既能承接轻量字符递归,也能承接 token 窗口、标题 metadata、HTML 语义块和 JSON 层级,而下游向量库只需要面对统一的检索单元。
系列链接
第 1 篇:LangChain源码解析01:先看懂Agent工程骨架
第 2 篇:LangChain源码解析02:Runnable把一切串起来
第 3 篇:LangChain源码解析03:RunnableConfig如何追踪到底
第 4 篇:LangChain源码解析04:Message不只是字符串
第 5 篇:LangChain源码解析05:Tool如何从函数变成契约
第 6 篇:LangChain源码解析06:Prompt和Parser守住两端
第 7 篇:LangChain源码解析07:BaseChatModel如何统一模型调用
第 8 篇:LangChain源码解析08:init_chat_model如何动态切换模型
第 9 篇:LangChain源码解析09:create_agent如何编译Agent运行图
第 10 篇:LangChain源码解析10:Agent条件边如何决定下一步
第 11 篇:LangChain源码解析11:middleware如何接管Agent执行链
第 12 篇:LangChain源码解析12:结构化输出如何在两种策略间切换
第 13 篇:LangChain源码解析13:ToolRuntime如何把上下文注入工具
第 14 篇:LangChain源码解析14:stream_events如何汇合Agent多路事件
第 15 篇:LangChain源码解析15:Agent为什么最终变成StateGraph
第 16 篇:LangChain源码解析16:AgentExecutor如何驱动经典Agent循环
第 17 篇:LangChain源码解析17:ChatOpenAI如何统一两套API
第 18 篇:LangChain源码解析18:ChatAnthropic如何编排思考与工具
第 19 篇:LangChain源码解析19:一套测试如何验收所有模型
源码参考: GitHub: https://github.com/langchain-ai/langchain
当文档已经被切成稳定的检索单元后,运行时又怎样知道不同模型的上下文窗口、工具调用、结构化输出和多模态能力,而不把这些事实写死在每个集成里?