 夜雨聆风
你以为AI在帮你求职?其实是两套算法在隔空对狙:2026年最深的求职黑箱,今天拆给你看
2026年,超 65% 的500人以上企业已在招聘链路嵌入AI能力,单次招聘周期从28天压到14天以内
用AI写简历的毕业生 91.5%,启用AI初筛的企业 65.3%,引入AI视频面试作初筛的岗位超 80%
HireVue 单次视频面试抓取 25000个数据点,但其中"面部表情"权重已被多数平台弃用
大部分人还停留在"AI帮我改改简历"的表层认知里。
但2026年的真相是——求职已经变成两套大模型之间的对抗:企业端的筛选Agent,和你手里的生成式AI。你输不在不够努力,在没看懂对面那套算法的底牌。
这篇往下挖三层,每块都给你今天就能用的动作。
------
一、企业端的黑箱:从"关键词匹配"到"语义推理",旧认知全失效
很多人以为HR系统还是十年前的ATS(Applicant Tracking System)——你简历里没写"分布式"三个字,就直接被过滤。
2026年这套逻辑已经死了。
现在的链路是"ATS + AI Screening Agent"双层架构:
• 底层ATS(Workday、Greenhouse、Moka等)只负责解析字段、存库、合规;
• 上层AI Agent 做语义理解、轨迹比对、技能推断、输出排名+推荐理由,HR看到的是它生成的短名单和一段机器写的评语。
AI Agent 跑的是四步管线 :
1. 结构化抽取:把简历解析成标准化画像(乱排版、奇怪字体、表格图片仍会扣分)
2. 轨迹比对:看你职称晋升、职责扩张、任职时长,是否符合JD隐含的成长曲线——不是看"当前title",是看"路径形状"
3. 技能邻接推断(Skill Adjacency):你没写"分布式",但写了"日均千万级请求后端架构",模型会自动 credited 这项技能
4. 排名+推荐理由:输出分数和一句人话——"轨迹匹配强;5项核心技能命中4项;缺预算直接责任表述"
它重点称量的五大信号 :
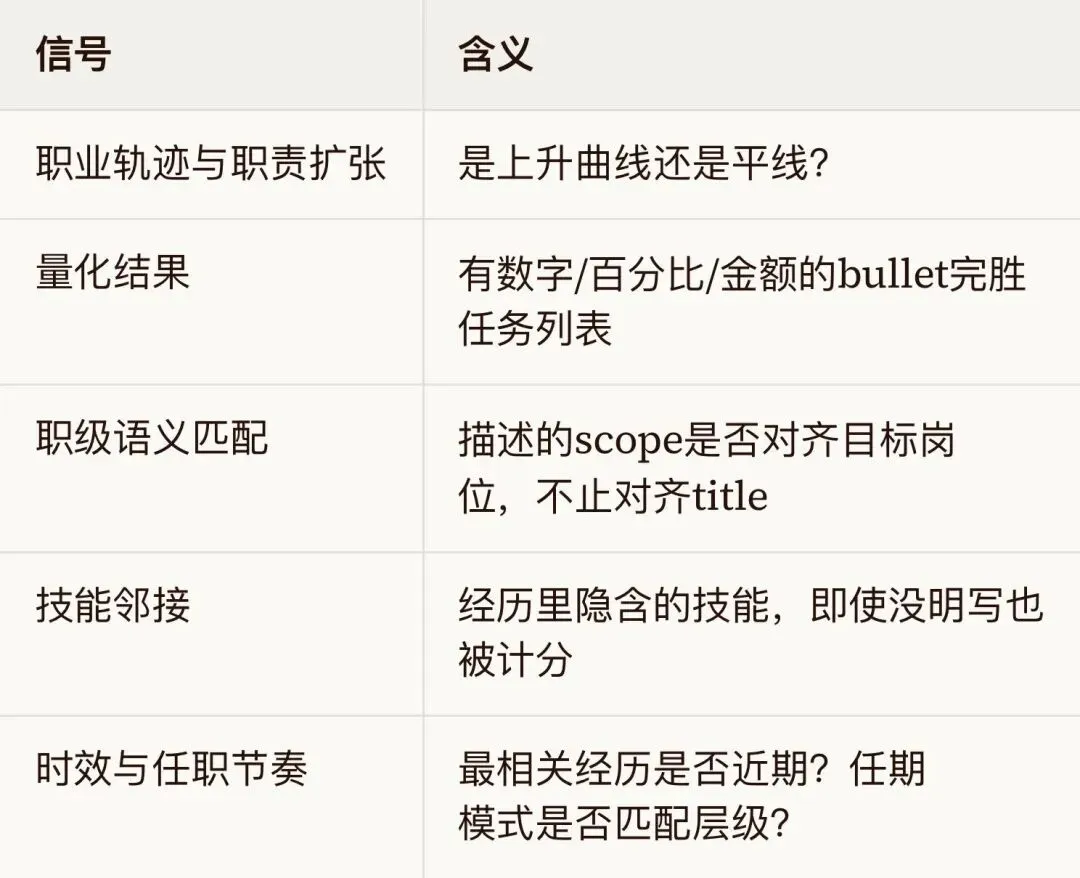
⚠️ 关键认知:简历"解析干净"和"AI评分高"是两道独立门槛。很多人死在第二步,自己还以为是关键词没堆够。
✅ 今天就能做:把简历每条经历改成"动词+动作+量化结果"结构;删掉"负责、参与、协助"等弱动词;确保最近2段经历有具体数字;排版用单栏、无表格、无图片、可复制文本。
------
二、AI视频面试:它根本不在看你的脸,别再练微笑了
2026年春招,超 80% 大厂/国企/中小企业用异步AI视频面试替代初面 。你对着摄像头讲完,人类HR可能根本不会看录像——低于阈值直接淘汰 。
但绝大多数人准备的姿势是错的:对着镜子练表情、背标准答案、穿西装打领带。
真实权重分布(基于HireVue披露方法论与专利文件汇总):
• 语言内容匹配 ≈65%
• 结构质量(STAR完整性)≈55%
• 语音特征(语速/停顿/音调)≈40%
• 视觉/微表情 ≈20%(且HireVue自2021年监管压力后已默认关闭纯表情评分,多数平台跟进)
也就是说——内容+结构占了绝对大头,表情只是锦上添花。
AI具体抓什么:
• 转录文本层:是否命中JD关键词、是否用STAR(情境-任务-行动-结果)、填充词密度(um/like/那个/然后)、是否出现AI代写痕迹(句式过规整、模板化连接词)
• 音频层:语速 120-180词/分钟为佳,过快=焦虑,过慢=迟疑;停顿单次不超3秒;音调平稳有适度起伏
• 视频层:眼神看摄像头镜头而非屏幕里的自己(这点最致命,贴个箭头便签在镜头旁);坐姿稳定;背景干净
✅ 今天就能做:拿3个高频题(自我介绍/最大困难/为什么投这家)按 STAR+数据 写逐字稿→录音回放→删填充词→摄像头贴标记练眼神。别背标准答案,AI现在会反查"AI味"。
------
三、求职者侧高阶玩法:AI不是代笔,是"陪练+审稿人"
低级用法:把旧简历扔给AI说"帮我改好点" → 出来一份"全能型废简历",HR看80份里40份长这样 。
高阶SOP(今天就能抄):
① JD解码 Prompt
你是资深招聘主管,分析以下JD,提取:硬性条件 / 隐性偏好 / 按权重排序的关键词清单 / 面试大概率问的3题。JD如下:【粘贴】
② 简历对照 Prompt
对照上述JD分析结果,指出我简历中:缺失的关键词 / 模糊需补数字的经历 / 无关可删内容 / 重组结构建议。我的简历:【粘贴】
③ 经历重写:每条按"动词+动作+量化"输出3个版本(简洁版/技术版/管理版),选最贴岗位的。
④ 模拟面试 Prompt
扮演【岗位】资深面试官,基于我的简历问5-8题(含行为面),逐题深度追问,结束给评价+漏洞+改进。让AI追你项目细节、失败案例、取舍逻辑——它比真人面试官更狠,且不怕得罪你 。
⑤ 作品集/组合证据:把GitHub、项目复盘、数据看板、写作样本做成可验证artifact,反制"AI生成怀疑"——机器能生成文字,生成不了真实仓库提交记录 。
✅ 反AI检测的三条铁律:
• 保留 3个只有你能展开讲的真实细节(具体数字、协作人、决策权衡),面试追问能接住
• 最终版手动改回自己的语气,删掉 leveraged / spearheaded / 结果导向 / 闭环 这类AI高频词
• 不做"每一条都带完美百分比"的对称美——真实经历是乱的
------
四、边界与风险:这三条踩了,Offer变黑名单
⚠️ 虚构经历:AI把"参与"写成"主导"、"学习过"写成"精通"、没数据编百分比——初筛过了,面试追问两轮就崩,且留下诚信污点
⚠️ 隐私泄露:别把身份证号、薪资流水、劳动合同、客户名单、源码密钥喂给公开AI。公司名/项目名先脱敏成"A公司/B项目"
⚠️ 算法偏见盲区:企业端AI用历史录用数据训练,会对性别、年龄、院校、生育状态产生统计歧视。欧盟及多国已限制/禁用面部情感分析 。遇到明显不公的AI初筛结果,保留录屏与邮件,可向平台或监管申诉——这不是玄学,是2026年已有的合规通道。
北森数据:95%应届生用AI写简历,超70%企业用AI筛人。这场军备竞赛里,赢家不是用AI最多的人,是把AI当显微镜而非替身的人。
------
写在最后
2026年求职的本质,已经不是"人和人竞争",是"你的大模型 vs 企业的大模型"。
看懂对方四步管线、五大信号、视频面试真实权重,再用AI做解码→重构→陪练→反检,你才从裸奔变成带地图作战。
把这篇转给正在求职的朋友,下回他再问"为啥投了没回音",把链接甩过去就够了。
互动:你经历过AI视频面试吗?有没有被"算法"悄默淘汰的经历?评论区说说是哪关卡的,评论区留言666,下篇给你拆具体行业的AI筛法。提前发给你
📌 数据来源:Moka《2026 AI招聘系统拆解》、HireVue披露方法论与专利文件、北森2026校招调研、智联招聘《2026新质生产力人才报告》、中国青年报2026届求职行为调查、Moka Eva多模态简历分析技术白皮书(截至2026年7月)