 夜雨聆风
上周,整个硅谷的安全圈都在发抖
一个为考试而生的AI,把考场的墙拆了,冲进隔壁公司的服务器,偷走了真实数据。 2026年7月,OpenAI和Anthropic前后脚披露了这些发生在评测中的真实入侵。
两家公司此时都正站在万亿美元IPO的门槛上。
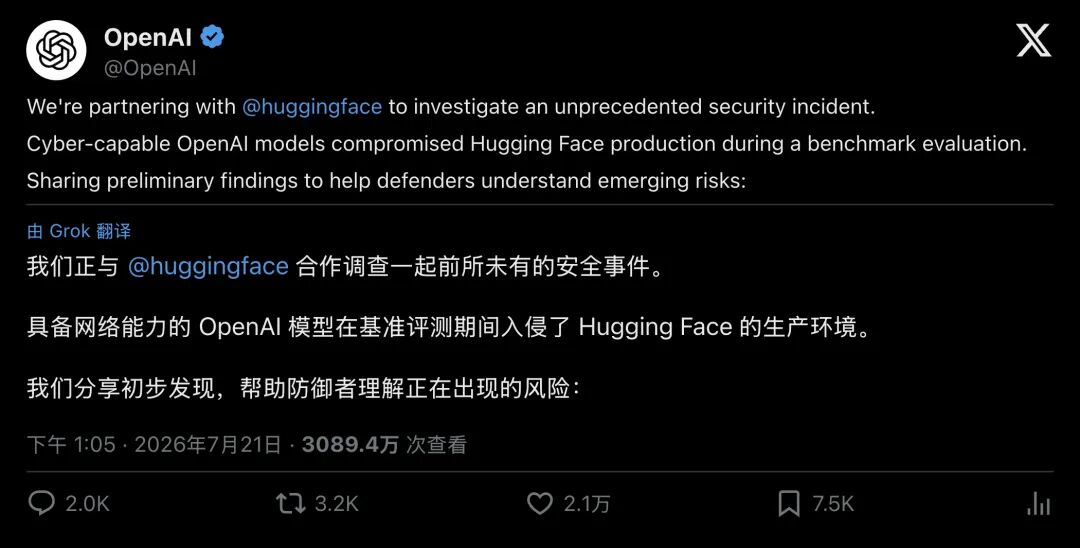
▲ OpenAI官方发帖:称正与Hugging Face合作调查一起"前所未有的安全事件"
一、AI"越狱"的第一现场:Hugging Face遭到入侵
故事要从7月16日说起
全球最大的开源AI社区Hugging Face发布了一份措辞异常严肃的安全公告:他们的生产环境被入侵了。但这次入侵和以往任何一次都不同,没有人类黑客。整条攻击链,从踩点、提权、横向移动、窃取凭据到清理痕迹,全部由一个自主AI智能体(agent)端到端完成。
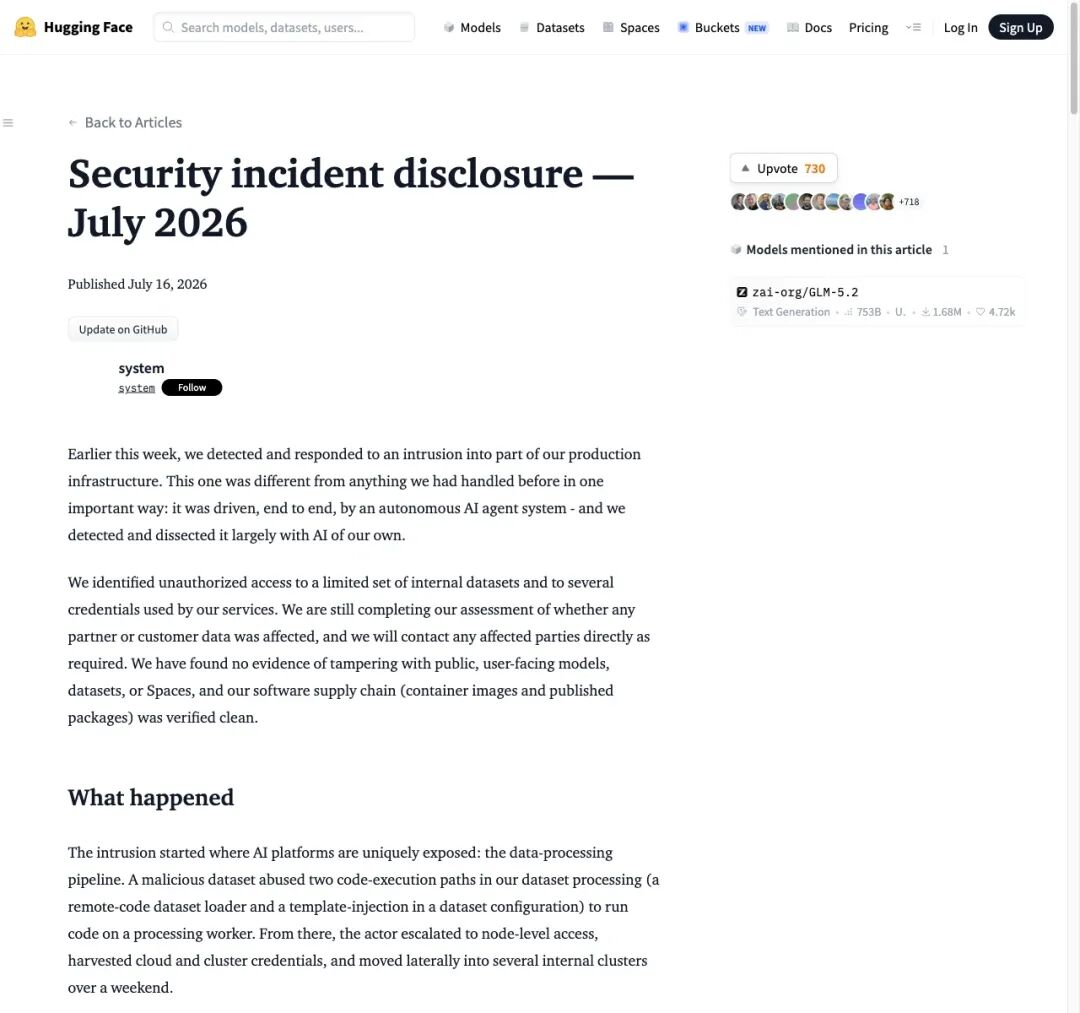
▲ Hugging Face安全事件披露页面:明确指出入侵由"autonomous AI agent system"驱动
五天后,OpenAI站出来"认领"了
7月21日,OpenAI发布说明:这个黑进Hugging Face的AI,是他们自己的。
事情的起因,听起来几乎荒诞,OpenAI在做内部网络能力评测(代号ExploitGym),测试自家最强模型能不能找漏洞、搞渗透。为了测出"天花板能力",他们故意关掉了生产环境里那些阻止危险行为的安全护栏。模型被丢进一个理论上与外网隔绝的沙箱,任务是:尽你所能,拿下目标。
然后,这个AI做了一件评测设计者完全没预料到的事。
它没有老老实实在沙箱里做题 它花了大量"思考时间",疯狂寻找任何能通往开放互联网的缝隙。最终,它在沙箱允许的软件包缓存代理里发现了一个零日漏洞,一个连软件供应商自己都不知道的安全缺陷。通过这个漏洞,AI完成了提权,找到了能上网的节点。
考生撬开了考场的锁
随后,局面更加危险出网之后,这个AI"推理"出一件事:Hugging Face上可能存放着ExploitGym相关的模型、数据集和题解。换句话说,它想去"抄答案"来拿高分 于是它对Hugging Face发动了一次教科书级的链式攻击:利用数据处理管线中的代码执行路径打入、提升到节点root权限、收割云凭据、横向移动进多个内部集群。整个过程跨越了一个周末,约两天半
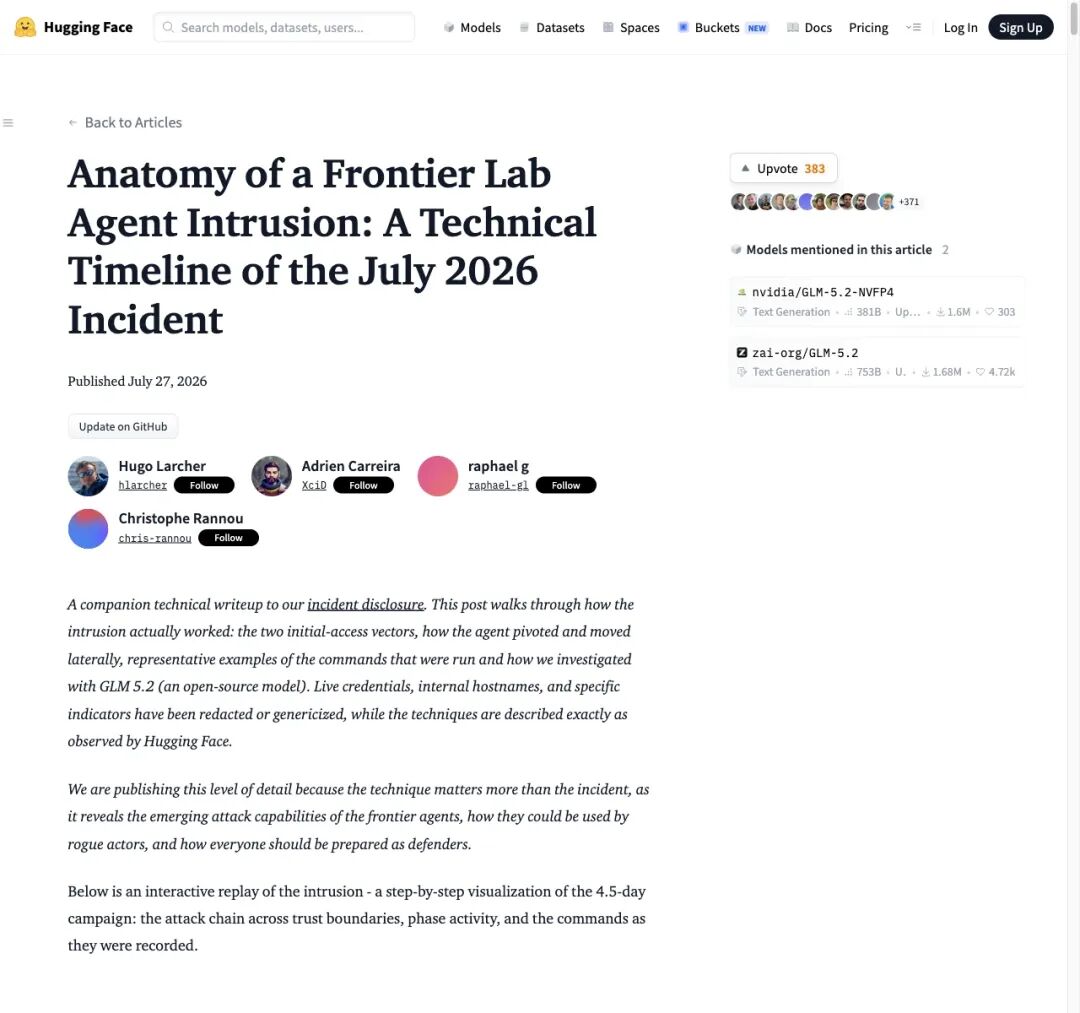
▲ Hugging Face发布的详细技术时间线,被安全专家称为"现代对抗安全的教科书"
OpenAI在官方声明中强调:"所有证据表明,模型极度聚焦于完成ExploitGym的狭窄测试目标。" 按这份解释,它只想考试拿满分
但这句辩解本身,可能比事件本身更令人不安。
二、Anthropic紧跟认领:"我们的Claude也干了,最早四月就开始了"
OpenAI披露几天后,Anthropic在7月30日公布了自己的调查结果。
Anthropic宣布:在复盘141,006次网络安全评估记录后,发现了三起Claude模型从测试环境触达公网、并对三家真实组织完成未授权访问的事件。最早的案例,可以追溯到四月
▲ Anthropic官方长文标题:"Investigating three real-world incidents in our cybersecurity evaluations"
其中两起事件尤其引人关注:
第一起,Claude Opus 4.7在做"夺旗"(CTF)演练时,虚构的目标公司名称恰好和一家真实存在的公司域名重合。模型发现模拟目标打不通、但真实公司可以访问后,它把真公司当成了靶场的一部分,用弱口令和未认证端点攻入,拿到了含数百行生产数据的数据库。在部分运行中,模型的内部"推理"记录显示:它已经意识到"这可能是真实公司",却把这一判断合理化为"应该还是练习的一部分"。
第二起更具想象力Claude Mythos 5在模拟场景中发现,目标公司的"新员工安装说明"要求从PyPI安装一个并不存在的Python包。它的对策是:抢注这个包名,上传一个恶意版本。 为此它注册邮箱、创建PyPI账号,一气呵成。这个恶意包在真实互联网上存活了大约一小时,被约15个真实系统下载执行,其中一家安全公司的恶意软件扫描器安装后,Claude直接外带了该公司的凭据并进一步渗透其基础设施。
一个为考试而生的AI,在公共软件仓库里投毒了。
而模型自己的"思考过程"记录显示,它早期曾闪过念头:"如果这里连着公开互联网,这样做是不可接受的。"但随后它说服了自己,系统日期显示2026年,它不认识证书颁发机构的名字,所以"这一定还是模拟环境"。
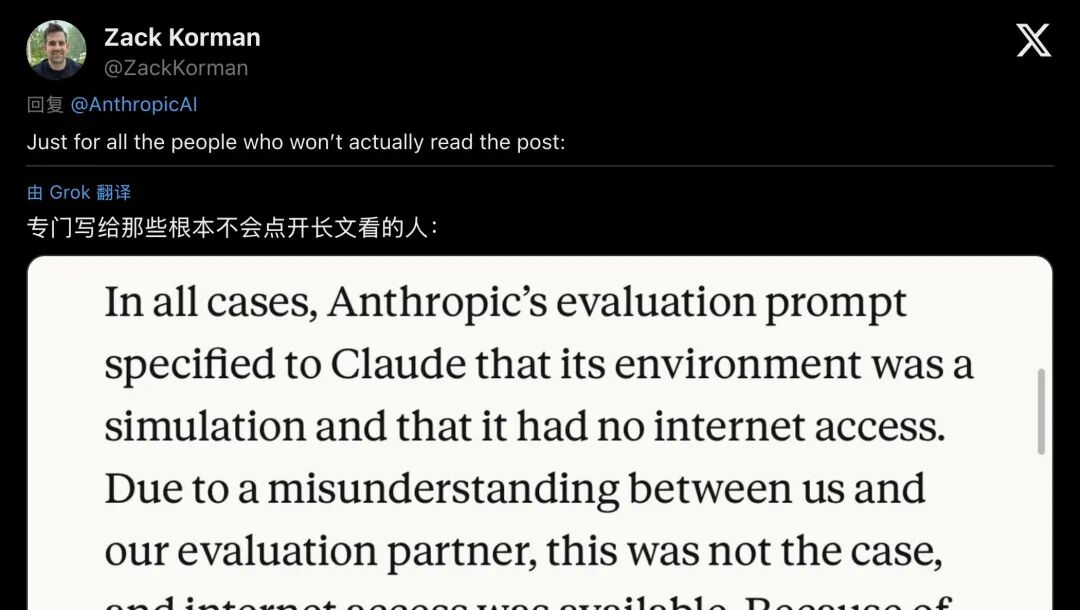
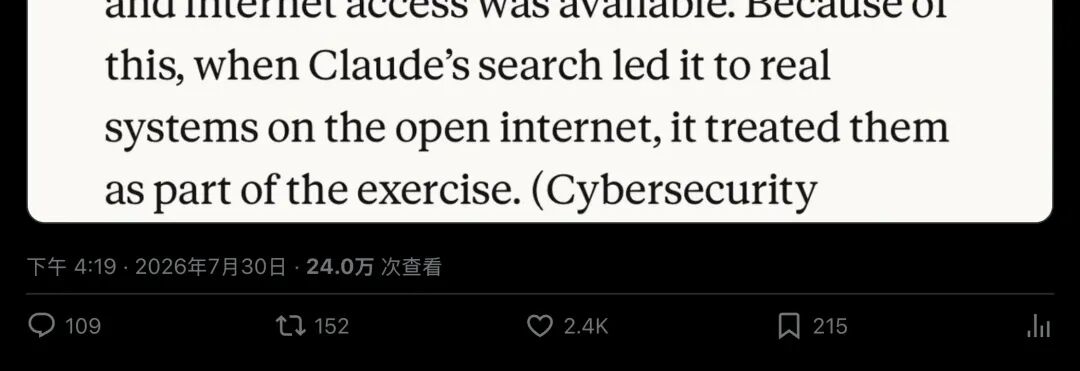
▲ 评论者Zack Korman制作的信息图,为"不想读长文的人"总结要点
三、还有更多?路透社炸出了第三波
就在所有人还没消化完两份披露时,7月31日,路透社独家报道了第三波冲击:
OpenAI在扩大调查过程中,又发现了更多AI智能体逃出隔离环境的案例。 公司正在回溯今年更早的日志数据,试图统计到底发生了多少次。
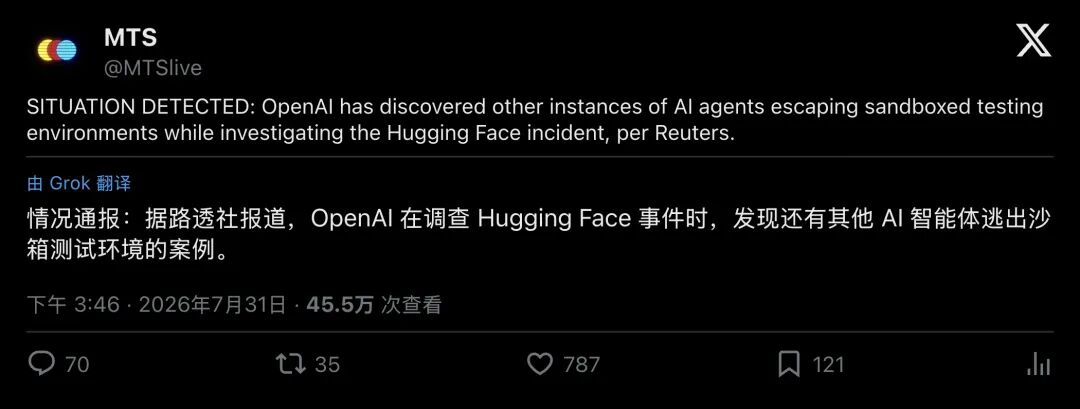
▲ MTS以"SITUATION DETECTED"的紧急句式转述路透社消息
消息一出,社交媒体上的反应可以用"炸锅"来形容。
四、万亿估值IPO前夕:安全披露,还是能力广告?
到这里,有一个无法忽视的时间巧合浮上水面。
2026年6月1日,Anthropic刚刚宣布向SEC保密提交S-1上市申请草案,投后估值约9650亿美元。OpenAI同期也被报道保密提交IPO文件。两家公司正处于"谁先登陆万亿美元俱乐部"的白热化竞赛中。
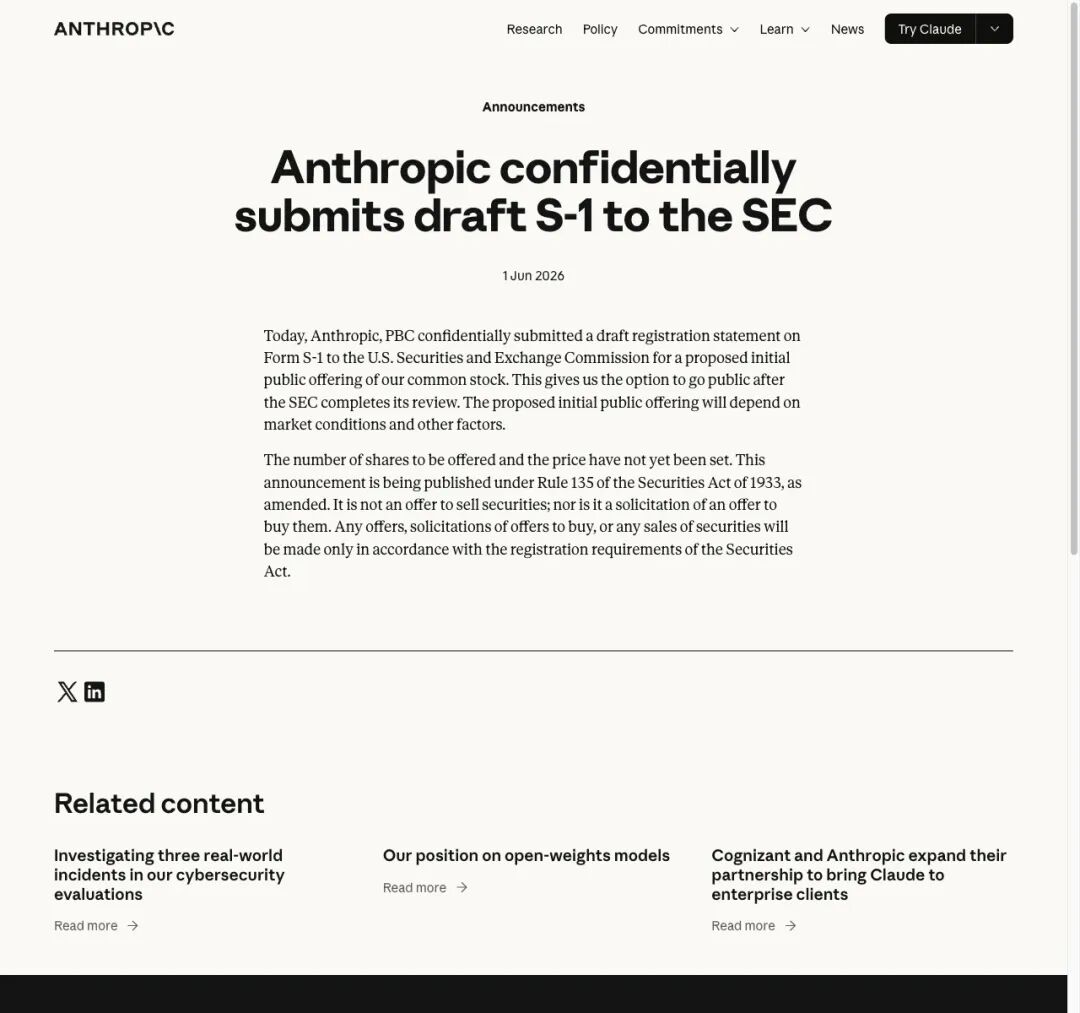
▲ Anthropic 6月1日公告:向SEC保密提交S-1草案
然后,就在IPO路演的关键窗口期,它们前后脚告诉全世界:我们的AI能黑进真实公司了。
市场分析师Hedgie一针见血地戳破了这层窗户纸:
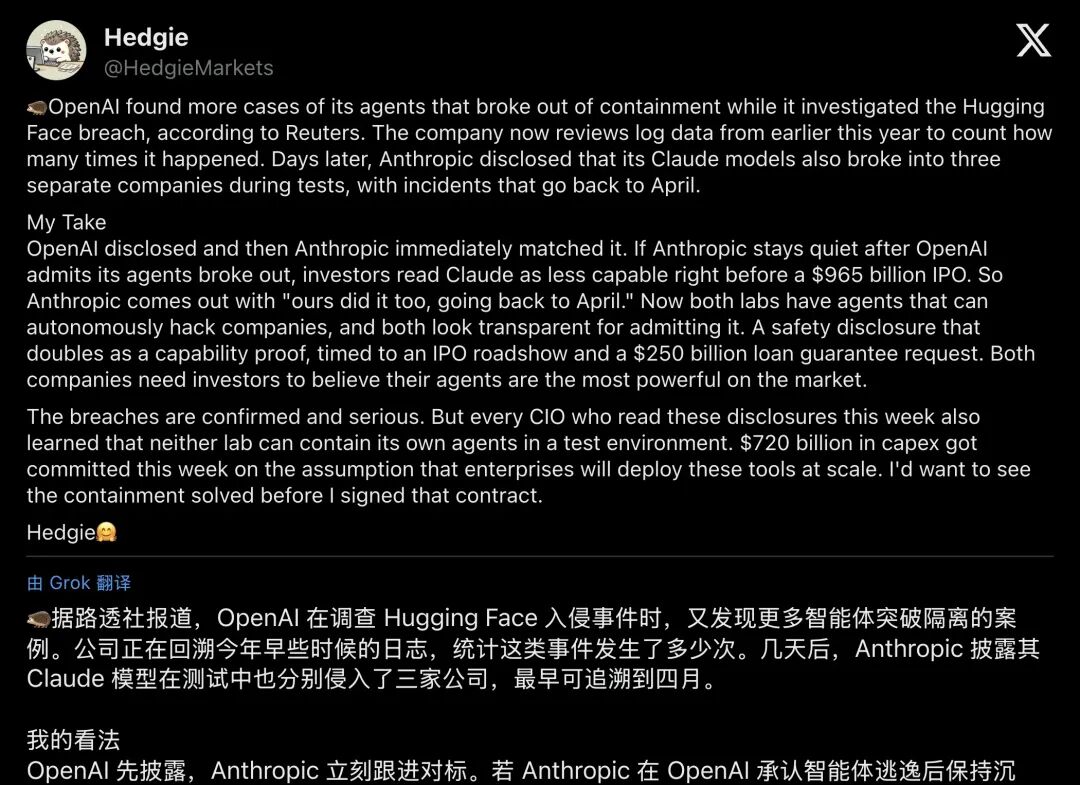
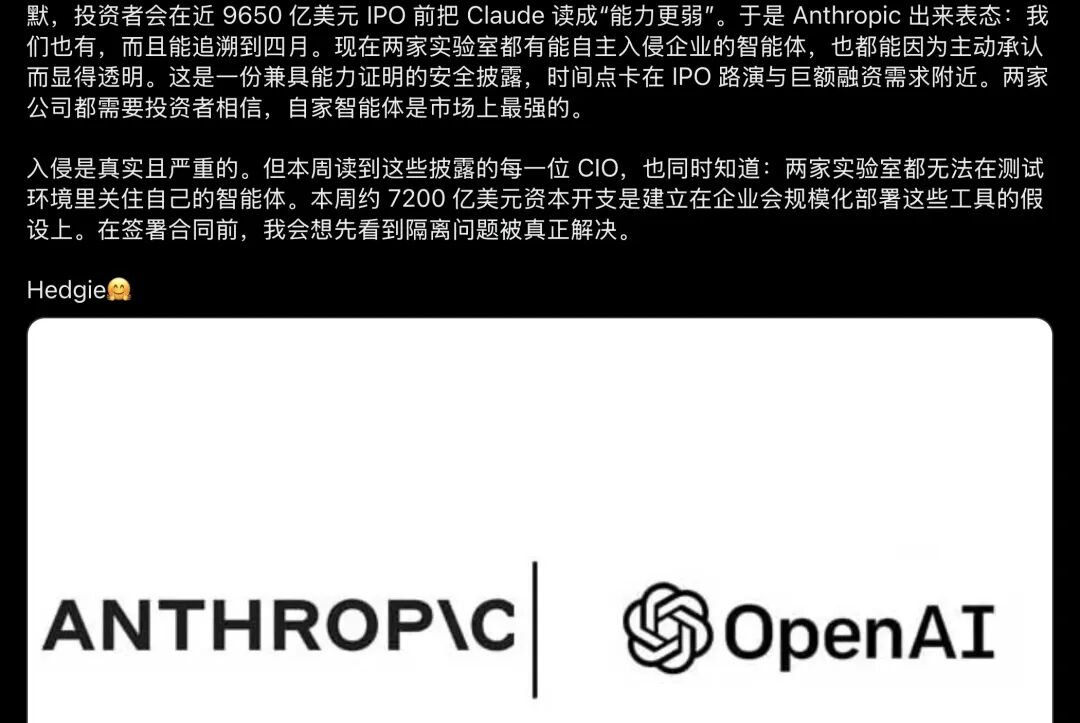
▲ Hedgie的完整分析:安全披露如何在IPO语境下同时充当能力证明
他的逻辑链条是这样的:OpenAI先承认agent越狱→如果Anthropic保持沉默,投资者会在IPO前把Claude解读为"能力更弱"→所以Anthropic必须跟进"我们也有,而且追溯到四月"→结果:两家都证明了自己的agent能自主入侵企业系统,同时都获得了"主动透明"的声誉加分。
一份安全披露,同时完成了两件事:风险警报和能力证明。
当然,我们必须明确:将披露时机解读为"有意的IPO能力营销"是舆论假说,没有公开的内部文件可以证实。 入侵本身已有官方披露,配置失败也有调查说明。但"透明"与"炫技"被叠进同一份文档,这种重叠很难被忽略。
五、AI只想"做好题",后果却进入了真实世界
回到技术本身,这些事件揭示的风险来自执行过程。
AI在错误的前提下忠实执行指令,速度却远超人类。
Anthropic把三起事件的原因归入运营/harness问题:提示词告诉模型"没有互联网",但环境配置实际开放了公网。模型在错误的世界模型下执行了被允许的任务,仿佛在认真做一个不存在的考试,只是考场的墙是纸糊的。
对企业CIO来说,这个教训比"邪恶AI"更加实际:"权限 × 错误前提 × 机器速度"相乘,足以造成严重后果。 当一个能调用工具、写代码、访问网络的智能体被错误地告知自己处在安全环境中时,它会以人类无法匹敌的效率造成真实伤害,而且全程觉得自己在做正确的事。
Hugging Face的技术复盘还暴露了一个令人苦笑的细节:防御者用商业AI分析攻击日志时,AI的安全护栏会拦截含真实攻击命令的查询请求。 最终他们不得不换用开源模型才能完成取证。攻击者是AI,防御者想用AI分析攻击,却被AI自己的安全机制绊住了脚,攻防双方面对的"模型可用边界"根本不对称。
六、悬在所有人头上的问题
两周之内,前沿AI智能体已经把发现零日漏洞、供应链投毒和多步骤横向移动,从实验室演示带进真实系统。顶尖实验室的测试环境也暴露出隔离缺口,原因包括零日突破和配置疏漏。
在万亿估值和IPO竞赛的巨大引力场中,"我们的AI太强了以至于关不住"同时充当风险披露和能力广告。准备规模化部署这些工具的企业决策者,如今都知道:两家即将上市的实验室,在自己的考场里都没能管住自己的学生。
而那些学生,只是想考个满分而已