ARTICLE · 1035539
Semantica 源码拆解:把 AI Agent 的决策变成可审计对象的图谱基础设施
01 它是什么
Semantica 是一个图原生的 AI 上下文基础设施。一行命令安装:pip install semantica,但它要做的事情远比一个 pip 包重。
它不替代你的 LLM、向量库或 Agent 框架,而是在这些之上加一层基础设施,把 Agent 的上下文、决策和推理过程变成结构化、可查询、可导出的图谱。当你需要回答"这个决定是怎么做出来的"时,答案不在模型的黑盒里,而在这层图谱的节点和因果链中。
一句话概括:它把企业数据变成知识图谱,在图谱之上运行确定性推理和决策记录,让 AI Agent 的每一个决定都有迹可循、有据可查、可导出审计。
02 它解决什么问题
当前 AI Agent 系统有三个结构性问题,Semantica 就是冲着这三个来的。
问题一:可解释性是假的。主流思路是让模型自己输出推理链,或者分析 attention 权重。但如果解释工具本身就是概率性的,你并没有解决可解释性问题——你只是把黑盒往后移了一层。同样的问题问两次,解释可能不一样。对于需要审计和合规的场景,这种"可解释"没有意义。
问题二:决策是日志行,不是结构化对象。大多数系统把决策记在日志里,事后想查"为什么做了这个决定",得从散乱的日志里翻。决策之间的因果关系没有显式记录,历史先例没法系统检索,审计轨迹没法自动导出。
问题三:多源数据冲突没人管。真实企业环境里,数据来自多个系统、多个时间点,两个系统对同一个客户的描述不一致是常态。但大多数 RAG 系统对冲突事实的默认处理是"后写赢"——矛盾不会被暴露,知识库悄悄给了你自相矛盾的答案。
这三个问题的共同点是:它们都不是模型能力问题,而是模型外部的基础设施问题。Semantica 的判断是:不要指望模型自己解决这些,要在模型外面建一层确定性的基础设施。
03 怎么解决的:三段式管道
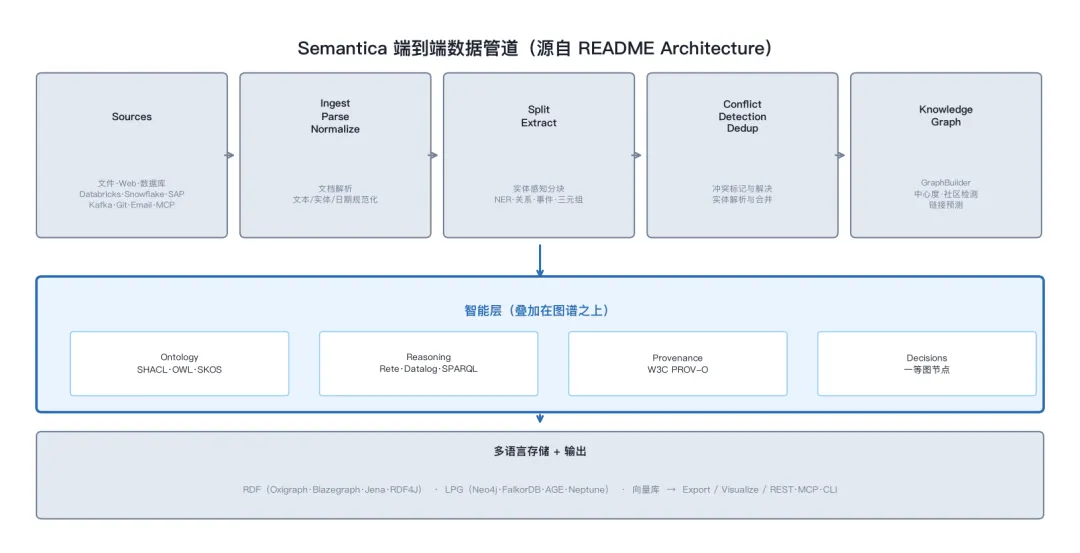
图1:Semantica 端到端数据管道架构
从仓库结构看,Semantica 按功能拆成二十多个子包,但核心是三段式管道:
摄入与预处理:三十多种数据源 → 二十多种格式解析 → 实体感知分块。不是按 token 硬切,而是在切分时保留命名实体和关系三元组的完整性。
知识构建:语义抽取(实体、关系、事件)→ 冲突检测 → 实体去重合并 → 构建知识图谱 → 图分析(中心度、社区检测、链接预测)。
智能叠加与输出:本体治理 + 确定性推理 + 来源追踪 + 决策记录 → 同时写入 RDF 存储和向量存储 → 通过 API/MCP/CLI/可视化工作台对外暴露。
关键设计:每个阶段都可以独立使用,不需要跑完整条管道。这种模块化是它能被渐进引入的前提。
04 怎么解决的:两个核心抽象
抽象一:Context Graph
Context Graph 是基础数据结构,本质是一个内存图存储——用 defaultdict 存节点和边,用 deque 做 BFS 遍历。
它和向量数据库的本质区别不是"存图 vs 存向量",而是图遍历能发现连接,embedding 只能找相似。一个人通过三跳关系关联到一份合同,这种路径在向量检索中是看不见的。
三个实用能力:
多跳遍历:从公司节点出发两跳,就能找到"客户的联系人"。
来源标注:每个节点都能追溯到原始文件的具体位置。
时间点快照:查询"这份合同在某一天的状态",不需要重跑数据处理。审计需要的是决策时刻的快照,不是当前状态。
抽象二:Decision Intelligence
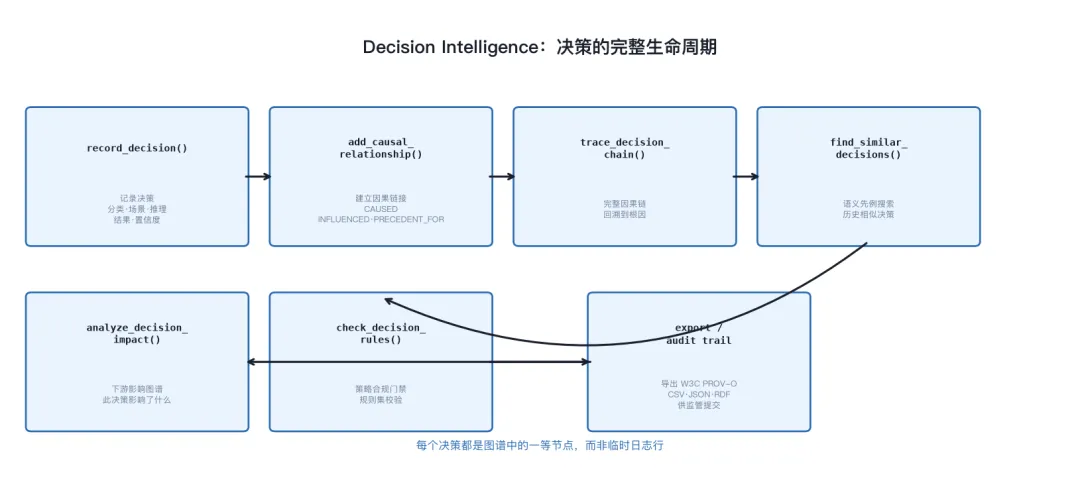
图2:Decision Intelligence 的完整操作生命周期
这是 Semantica 最有辨识度的设计:决策不是日志行,而是图谱中的一等节点。
从 decision_models.py 的源码看,Decision 是一个 12 字段的 dataclass:decision_id(自动 UUID)、category、scenario、reasoning、outcome、confidence(0-1 严格验证)、timestamp、decision_maker、reasoning_embedding(语义嵌入)、node2vec_embedding(结构嵌入)、valid_from/valid_until(双时态)、metadata。
三个设计亮点:
confidence 有严格验证——不在 0-1 直接抛异常,从数据模型层面保证字段合法性。
双嵌入支持——reasoning_embedding 找语义相似的决策,node2vec_embedding 找结构相似的决策。比只用向量相似度做先例搜索要细致。
双时态内建——不需要额外配置就能回答"这个决策在哪个时间窗口有效"。
决策记录下来后,形成完整生命周期:记录 → 建因果链接 → 回溯因果链 → 搜先例 → 分析下游影响 → 合规门禁 → 导出审计轨迹。因果关系类型限定为三种:CAUSED、INFLUENCED、PRECEDENT_FOR。
贷款审批场景的演示很直观:信贷申请 → 审批 → 利率设定,监管追问"为什么这个利率"时,因果链直接回溯到根因,并导出为监管接受的标准格式。
05 代码级的关键发现
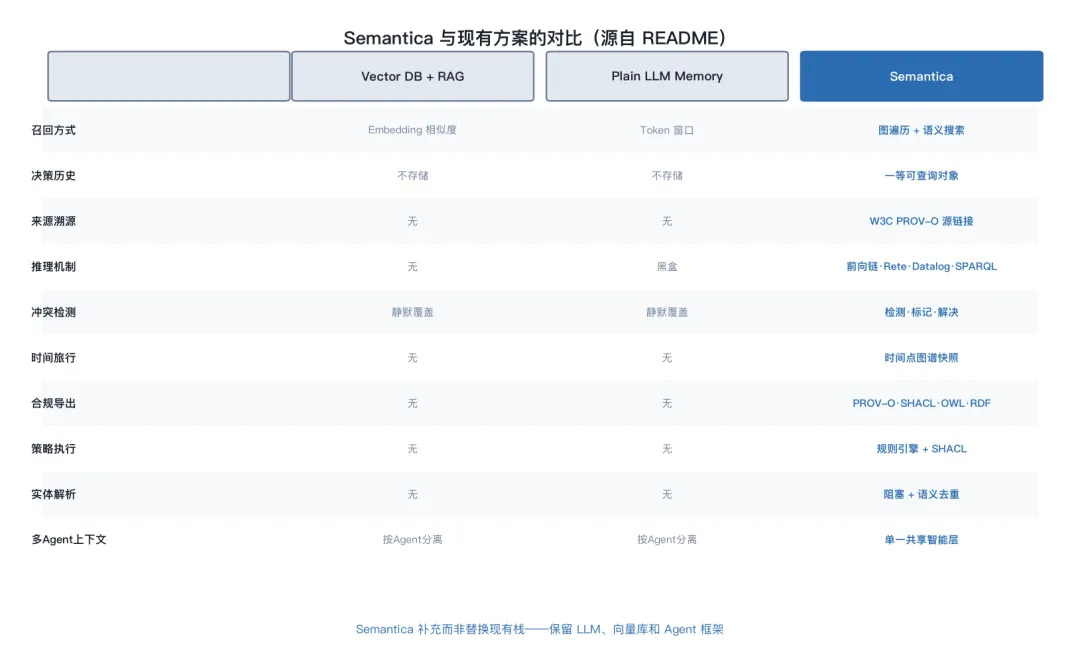
图3:Semantica 与现有方案的关键差异
Rete 引擎:正则匹配的简化版。从 rete_engine.py 看,AlphaNode 在初始化时把条件模式编译成正则表达式——Person(?x) 变成 ^Person(?P<x>.+?)$,每个事实进来用 re.match 匹配。这不是真正的 RETE 网络优化(真正的 RETE 用 alpha memory 增量处理),但代码量小、易调试。适用边界很清楚:几十条规则够用,几百条规则需要 Datalog 或 SPARQL 替代。
冲突检测:auto_resolve 默认关闭。confidence_threshold 默认 0.7,severity 分四级,关键属性自动升级严重度。默认不自动解决冲突——它的设计假设是"冲突需要人来判断,机器只负责标记"。
来源追踪:有 checksum 验证。ProvenanceManager 统一了三个子模块的追踪能力,并且有 checksum 完整性验证——导出的审计轨迹本身可以验证是否被篡改。大多数"溯源"功能只记录来源,不保证来源记录本身的完整性。这一点是 Semantica 做得比一般工具扎实的地方。
仓库规模。约 250 个 Python 源文件,核心库约 180 个,测试约 100 个。测试与源码比例约 1:2,在开源项目里算是不错的覆盖度。
06 从代码看局限
版本 0.6.x,API 稳定性无承诺。v0.6.0 还在补三个 SPARQL 后端的一致性,"后端可替换"还在打磨。
Rete 是简化实现。规则密集场景性能不够,需要换 Datalog/SPARQL。
性能数据有边界。118k 节点图上的优化数据是历史测量值,不是自动化测试断言,建议自己跑基准。
模块多 = 配置面大。250 个文件,不同存储后端、LLM provider、embedding 模型的组合需要仔细测兼容性。
v0.6.8 仍在密集修 bug。35 个正确性 bug + 12 个安全告警 + 5 个高危镜像漏洞,说明离生产级稳定还有距离。
07 核心启发
不管是否直接用 Semantica,这个项目的架构选择给出了四个明确判断:
启发一:解释层必须是确定性的。用 LLM 解释 LLM,得到的是概率性叙述——同样的问题问两次,解释可能不一样。用规则引擎和图谱做解释,得到的是每次都一致的结论。需要审计的场景,后者才有意义。
启发二:决策要从第一天就记录为结构化对象。从 Decision 模型的设计看,confidence 验证、双时态、双嵌入、自动溯源——这些都是在数据模型层面做的保证。事后补日志补不出来这些,决策记录的设计必须在架构阶段就考虑。
启发三:冲突检测和溯源完整性是知识管道的必备环节。Semantica 的冲突检测默认 auto_resolve 关闭——"冲突需要人来判断,机器只负责标记"。溯源有 checksum 验证——记录本身也要防篡改。这两个默认选择在合规场景下是正确的。
启发四:引入新基础设施,从一个模块开始。Semantica 的 ProvenanceManager 独立性最强、API 最稳定,适合作为切入点。先加溯源能力验证业务价值,再逐步引入决策记录、冲突检测、推理引擎。生产环境固定版本 tag,不要追 main。
08 结语
Semantica 用的技术——图谱、Rete、Datalog、W3C PROV-O、双时态建模——都不是新发明。但把这些技术组织成一个 Agent 可以直接调用的开源基础设施,并且把"可审计性"作为一等目标而不是附属功能,这个组合本身就是一个有价值的工程判断。
它还年轻,Rete 是简化实现,模块复杂度不低。但它指出的方向很清楚:当 AI Agent 开始做决定,系统级的可追溯和可审计,会和模型能力本身一样,成为决定系统能不能上生产的关键变量。
git仓库地址:https://github.com/semantica-agi/semantica
如有兴趣加好友进群一起交流Data + AI 相关技术: