ARTICLE · 1035529
FBI刚指控中国AI,美国官网先"叛变" !
这世上最讽刺的剧本,都不敢这么写。
上周,FBI、NSA、CISA 三巨头联合发声明,义正辞严指控六家中国 AI 公司——包括阿里巴巴——用"工业规模的蒸馏手法"抄袭美国模型,偷美国核心技术。
那措辞、那架势,仿佛明天就要把阿里的工程师按在地上审。
结果呢?才过了一周。
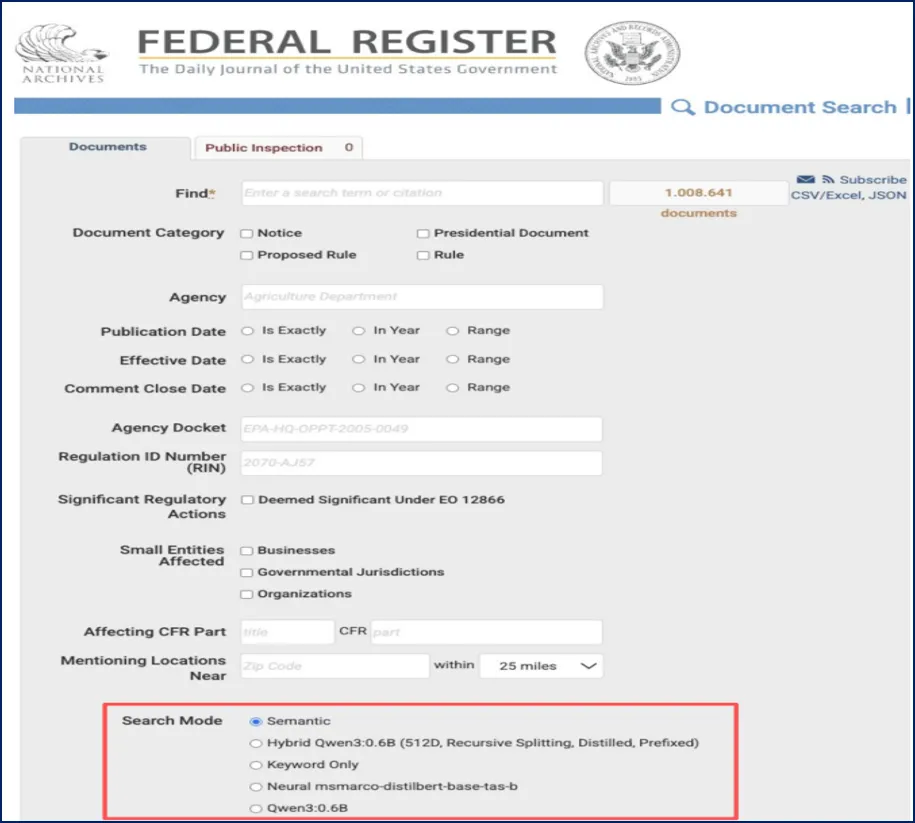
美国国家档案馆运营的《联邦公报》网站——注意,这可是美国联邦政府的"官方公告栏",总统令、部门规章全往这上面登的那种正经政府网站——被网友扒了出来:
你们这高级搜索功能,怎么接的是阿里的通义千问?
还是 Qwen3,0.6B 版本。
被网友在社交媒体上一挂,好家伙,当天就给撤了。撤得那叫一个干净利落,连句"我们正在调查"都没有——跟做错事的小学生把手机往书包里一塞,假装自己一直在写作业似的。
一、9 月 8 日到 9 月 16 日:一周,演完了一整出反转剧
咱们先捋一下时间线,看看这出戏有多魔幻:
9 月 8 日,美国三大安全机构联合公告,点名六家中国 AI 公司"工业规模蒸馏"美国模型——DeepSeek、月之暗面、阿里、MiniMax、阶跃星辰、Z.AI,一个都没落下。措辞之严厉,仿佛中美 AI 冷战已经正式开打。
9 月 15 日,有外国网友偶然发现,联邦公报网站的高级搜索选项里,明明白白写着"Qwen3, 0.6B"——阿里开源的一个小参数模型,专门干语义检索这种粗活的。
9 月 16 日,社交媒体开始热议,当天该功能就下架了。
美国国家档案馆和白宫,至今一个字没解释。
什么时候上的?为什么选 Qwen?用了多久?有没有人审核?统统不知道。
合着这就是"贼喊捉贼"最完美的诠释。
二、离谱的是——用的还是开源版
很多人可能没发现这件事最离谱的地方。
FBI 指控阿里"偷"美国 AI 技术,逻辑是什么?是说你阿里拿了美国 API,用海量账号刷数据,蒸馏人家的模型,等于"偷师"。
那美国政府这边呢?
人家根本没找阿里买 API,也没跟阿里云有任何数据往来——人家是直接把 Qwen 的开源权重下载下来,部署在自己服务器上跑的。
用的还是 0.6B 这种"小不拉几"的版本。什么概念?就是你家里电脑都能跑起来的那种小模型,专门用来干文档检索、语义匹配这种体力活的。
这意味着什么?
意味着这事儿根本不是什么"中国渗透美国政府网站",而是联邦公报的某个工程团队,在选型的时候认认真真做了技术评估,最后一拍大腿:
"就它了,开源、免费、能本地部署、检索效果还不错。"
翻译成人话就是两个字:
真香!
三、为什么非得是 Qwen?
有人可能会问:美国自己那么多大模型,GPT、Claude、Gemini,用哪个不行,怎么偏偏选了中国的?
问得好。这就是问题的核心。
联邦公报的搜索需求是什么?是几百万页政府法规文件——用户输入一个关键词,系统得从海量文档里把相关内容捞出来。
这种活,用 GPT-4o 当然也行。但你算算账:
每搜一次就调一次 API,每次都是钱。政府网站流量又不小,一年下来调用费得多少?更麻烦的是,所有法规数据都要发到第三方的服务器上——这合规吗?这安全吗?
反过来,Qwen3 0.6B 呢?
开源免费,下载下来跑在自己服务器上,数据不出门,边际成本几乎为零。效果呢?干个语义检索这种活,0.6B 的小模型已经够用了。
工程团队不傻。
在"够用"和"最好"之间,当任务简单到一定程度,性价比就是硬道理。
所以你看——
嘴上喊着"国家安全",身体很诚实。预算一紧张,意识形态就得让路。
这跟美国人一边禁华为设备、一边运营商偷偷买华为基站回本,本质上是一个剧本:不是不知道你"不安全",是用你真省钱。
四、开源时代,拧巴的美国
这件事真正值得琢磨的,不是"美国政府用了中国 AI"这个瓜,而是它暴露出来的一个死结:
开源模型,你怎么脱钩?
美国现在搞小院高墙,禁这个禁那个,逻辑是什么?是"我不让你用我的东西,你就发展不起来"。
芯片可以禁出口,技术可以禁转让,服务可以禁接入——这些都好办。
但开源模型不一样。
模型权重一放出来,就跟写在网上的代码一样。你可以说它是"中国公司做的",但你没法阻止一个美国工程师把它下载下来,跑在自己的服务器上,改都不用改直接用。
你总不能立法规定"美国政府网站不准用参数量低于 1B 的开源模型"吧?
那以后谁家工程师写代码用了一个开源库,作者是中国人,是不是也要上法庭?
这就像你骂邻居家儿子是小偷,转头发现自家装修师傅用了他家出的乳胶漆——你总不能把墙皮铲了吧?铲了住哪?
有分析说得很到位:特朗普政府今年 6 月的 AI 政策,一边要求政府加速用 AI,一边要求利用开源技术降本增效。
这两个目标放在一起,结果就是:嘴上要脱钩,身体在联网。
五、你说我偷技术?制裁反而让我涨了 72%
更绝的是什么?
就在联邦公报这个瓜爆出来的前后脚,9 月 18 日,《科学》期刊上发了一篇论文——清华和港大的研究人员分析了 2010 到 2022 年中国的专利申请,发现:
受美国制裁的中国企业,专利里引用的科学文献数量,暴涨了 72%。
什么意思?
就是你制裁我,不让我买你技术,我就去自己搞研究、自己做开源、自己从基础科学开始啃。
结果呢?越制裁,自主创新能力越强。
有外媒报道这事的时候,标题都透着一股"美国没想到"的味道。
现在把这两件事放在一起看,你就知道这出戏有多荒诞了:
你指控我"偷"你技术 → 结果制裁反而逼出我 72% 的创新增长 → 创新出来的开源模型做得太好 → 你自己政府网站悄悄下载下来用 → 被网友扒出来赶紧下架。
这一整套连招下来,到底谁是赢家?
你说我偷技术,结果你自己悄悄用我做出来的东西——这算什么?算你承认我做得好?还是算你偷我的?
FBI 那边在紧急开会,讨论怎么封锁中国 AI;另一边,研究数据已经摆在这里了:
你的制裁,正在亲手把中国企业逼成你自己都离不开的技术供应商。
说到这儿,忽然想起七十多年前,毛主席讲过一句振聋发聩的话,简直像是专门留给今天的:
"封锁吧,封锁吧!再封锁个十年八年,中国的一切问题都解决了。"
那年头,他们封锁的是货物、是援助、是技术图纸。
如今,他们封锁的是芯片、是算力、是模型权重。
封锁的东西换了一茬又一茬,这句话却被验证了一次又一次。
六、后续会怎样?
最后给大家脑补一个画面:
FBI 的技术专家们正在会议室里苦思冥想——怎么检测政府网站有没有接入中国 AI 模型,怎么封锁 Qwen 的权重分发,怎么在网络层识别出哪些请求是在跟中国模型交互。
而隔壁办公室,国家档案馆的程序员小哥刚把 Qwen3 0.6B 部署上去,看着检索速度从 2 秒变成 200 毫秒,满意地点了根烟。
他可能到下架那天都没想明白:自己不就是用了个开源模型,怎么就成"国家安全事件"了?
这大概就是当下中美 AI 博弈最真实的注脚——
你在围堵你的,我在用我的;你说我偷技术,我说你自己用得挺顺手啊。
至于联邦公报那个搜索功能什么时候重新上线?
我赌五毛,不出三个月,换个名字就回来了。
毕竟总不能为了政治正确,让政府网站的搜索功能烂在那吧——
钱又不是大风刮来的。