ARTICLE · 1038531
计算机十讲⑤|软件线:数据库的诞生(1960s—1990s)
信号与激励 · 计算机系列第 5 篇
前四讲,我们看了硬件三次跃迁,也看了语言和操作系统如何长成软件的两条腿。但计算机还有一个更基础的问题没解决:数据怎么存、怎么找?
这一讲,我们讲数据库(database)。你会看到:人类如何从"每个程序自备一份文件"的混乱,走向"一套模型管所有数据"的秩序;又如何从"必须知道数据放在哪"的导航式系统,走向"只说我想要什么"的关系型革命。最后你会明白:关系模型,是今天信息社会的骨架,也是中国信创产业绕不开的主战场。
一、引言:数据开始"爆炸"
1950 年代的计算机,主要是拿来"算"的——算弹道、算工资、算库存。但到了 1960 年代,情况变了:企业发现,计算机最大的价值不在"算得快",而在"记得住"。
一个工厂要管多少数据?零件清单、供应商、订单、库存、客户、价格……每一项都不是孤立存在的:一张订单关联着客户,客户关联着地址,订单又关联着零件,零件关联着供应商。数据之间是网状纠缠的。
更让人头疼的是数据量本身。1950 年代一个企业数据库的规模,用今天的眼光看小得可怜——几千条记录而已。但"小"不代表"好管":记录之间复杂的关联,让"找到一条数据"变成了一场冒险。1960 年代,IBM 的一份内部报告估计,大型企业花在"数据维护和检索"上的成本,已经占到整个 IT 预算的大头。算得快的问题被硬件解决了,"记得住、找得着"的问题才刚刚开始。
保险业是第一批被数据逼疯的行业:一张保单要关联投保人、受益人、缴费记录、理赔记录,关系层层嵌套。银行业更不用说——每一笔交易都要实时更新账户余额,错了就是真金白银。1960 年代中期,美国保险业协会甚至专门开会讨论"数据处理危机"。这些行业的需求,直接催生了数据库这个新产业——直到今天,保险、银行依然是关系数据库最忠实的用户。
可当时没有"数据库"这个概念。每个程序都自带一份文件——工资程序带工资文件,库存程序带库存文件,各自存在磁带或磁盘上。后果是什么?同一份客户数据,可能在五个文件里存了五遍,改了一处忘改另一处,账就对不上了;程序和数据绑死,文件格式一改,所有相关程序全部要重写。
程序员界甚至流传着一句自嘲:那个年代写程序,一半时间在"对付文件",另一半时间在"等文件转磁带"。更扎心的是,很多"程序"本质上就是给下一批程序做"文件搬运工"——把一份文件的内容重排一下格式,好让另一个程序能读。整个企业计算的日常,就是一场无休止的文件格式对接。
用这个系列的话说:数据是最需要"秩序"的信号,而当时的存储方式,是一团乱麻。这一讲,我们看人类怎么把这团乱麻,整理成一张"秩序之网"。
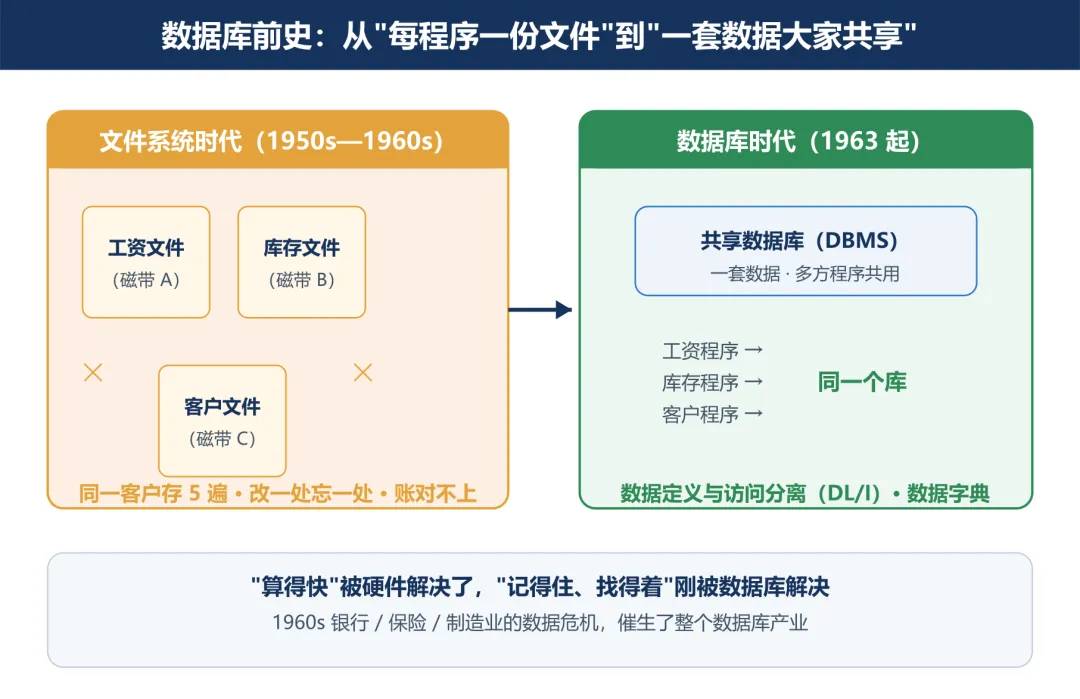
图1 · 数据库前史:从"每程序一份文件"的混乱,到"一套数据大家共享"的秩序
二、两种旧模型:层次与网状(1960s—1970s)
1. IMS:为阿波罗而生的层次数据库(1966)
数据库的第一次正经亮相,和国家大事绑在一起。
1966 年,NASA 的阿波罗计划正忙得焦头烂额:一枚土星五号(Saturn V)火箭,有两百万个零件。每个零件都在被不断修改,工程师改完一个件号,必须确保所有关联文件用的是最新版本——一个零件错了,火箭就完了。注意,这正好是我们《太空十讲》里讲的阿波罗工程的软件侧面:航天工程的复杂度,逼出了软件行业一个又一个"第一次"。
IBM 和北美罗克韦尔(North American Rockwell)合作,为阿波罗建了一套系统:1963 年先在 IBM 7010 上做原型(叫 DATE),1967 年扩展成 ICS/DL/I,1968 年 8 月 14 日在罗克韦尔工厂正式上线——那天,第一行 "READY" 出现在 IBM 2740 终端的屏幕上。1969 年 IBM 把它商品化,改名 IMS(Information Management System)。
IMS 用的是层次模型(hierarchical model):数据像一棵树,根是客户,下面是订单,订单下面是明细……想查"某客户的所有订单",就从树根一路往下走。它的核心设计——把"数据怎么存"和"程序怎么用"分离(DL/I 语言)——让多个程序可以共享同一份数据,这在当时是革命性的。它甚至把"数据定义"和"数据访问"分开,应用程序只关心业务逻辑,不碰底层存储。直到今天,超过 95% 的《财富》1000 强企业还在用 IMS 处理核心交易——因为它太快、太稳了。2003 年,距离出生已经 35 年,IMS 迎来了它卖得最好的一年。
2. Bachman 与 IDS:网状数据库(1963)
比 IMS 更早的,是巴赫曼的 IDS。
1960 年代,巴赫曼在通用电气(GE)费城的工厂里,给一个叫 MIACS 的制造信息系统做数据层。1963 年,他发明了 IDS(Integrated Data Store,集成数据存储)——公认的第一个数据库管理系统。在那个内存只有 40 KB 的年代,他硬是把 IDS 和整个应用系统塞进了 IBM 的一台小型计算机里,靠的是对磁盘存储极致的压榨。
IDS 用的是网状模型(network model):数据记录之间用指针直接相连,客户记录指到订单记录,订单指到明细,可以多对多。巴赫曼还给数据建立了一本"数据字典"(data dictionary),专门记录记录类型之间的关系。这里要提一句:第四讲讲 COBOL 时出现过一次 CODASYL(它发明了 COBOL),这次它又出现了——1971 年,CODASYL 的数据库任务组(DBTG)把网状模型标准化,出了一份著名的《DBTG 报告》。同一批人,先定了商业语言的规范,又定了数据模型的规范,堪称 1960 年代软件标准化的"总指挥部"。
网状模型一度成了行业正统,但它有个致命问题:程序员必须像"导航员"一样,沿着指针一条条路走——查一个数据要写一长串"游标移动"的代码,业务逻辑全淹没在导航细节里。1973 年,巴赫曼拿了图灵奖,演讲题目就叫《程序员作为导航员》(The Programmer as Navigator)——他自豪地把程序员比作在数据海洋里掌舵的人。但历史证明,"导航"恰恰是这条路最深的坑:数据一多、关系一复杂,导航就成了一门只有极少数高手能掌握的绝活。
层次和网状,共同的问题是:程序员必须知道数据"怎么存的",才能查。 IMS 你得知道树的形状,IDS 你得顺着指针走。数据一变,导航路线就断。这个"导航式"的痛点,正等着一个天才来解决。
三、关系模型:科德的范式革命(1970)
1970 年 6 月,IBM 圣何塞实验室的数学家埃德加·科德(Edgar F. Codd)在《ACM 通讯》(Communications of the ACM)上发表了一篇论文:《大型共享数据银行的关系模型》(A Relational Model of Data for Large Shared Data Banks)。
科德是个牛津大学数学系出身的老派学者,二战时在英国皇家空军开过飞机,后来在 IBM 参与了 701 和 7030(STRETCH)等机器的设计。他的想法,用一句话说:别管数据怎么存,把所有东西都看成"表"(table)——行是记录,列是字段,表之间用公共的列建立关系(relation)。 用户只需要说"我要什么",不必关心"数据在哪、怎么连"。这背后是扎实的数学:集合论和关系代数。数据独立性——逻辑视图和物理存储分离——第一次被写进了理论。
这里给非技术读者打个比方:层次模型像"公司组织架构图"——每个部门只有一个上级,想找跨部门的信息得绕很多弯;网状模型像"城市地铁图"——线路多、直达多,但你要会看图、会找换乘站;关系模型则像"电话号码簿 + 地图"——每一页都是表,姓名、地址、电话排成行,你要找谁,按名字一翻就出来,至于这页纸存在哪、怎么排的,你根本不用管。科德的洞见,就是"让用户看到表,让系统处理迷宫"。
当时业界的反应很冷淡。IMS 和 CODASYL 的支持者觉得这玩意儿"太理想化、跑不起来";连 IBM 内部都有不少人认为论文"太数学、不实用"。有个项目组成员后来回忆:"至少在当时,那看起来是一篇写得很难读的论文——开头讲点工业动机,然后直接跳进数学。" 1974 年,ACM 专门组织了一场辩论,科德对阵巴赫曼——关系模型 vs 网状模型,谁才是未来?辩论很激烈,但谁也没说服谁。历史后来判了案。
科德后来还提出了一套"关系完整性"规则,江湖人称"科德 12 条"(其实编号从 0 到 12,一共 13 条,程序员式的幽默):比如"所有信息必须用表里的值显式表示""系统必须支持空值(NULL)""数据操作必须不依赖物理存储位置"……这些规则成了后来所有关系数据库的"十诫"。1981 年,科德凭关系模型拿了图灵奖——距离他那篇论文发表,才过了 11 年。
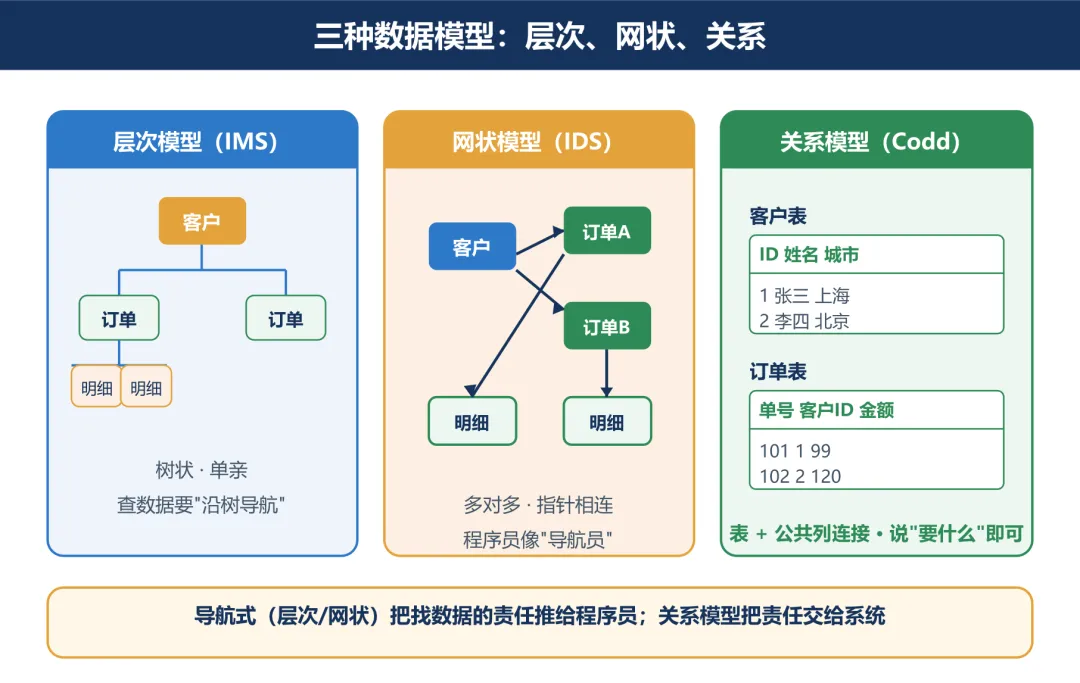
图2 · 三种数据模型:层次(树状)、网状(指针)、关系(表 + 连接)
四、System R 与 SQL:把理论变成语言(1973—1979)
光有理论不够,得能跑。1973 年,IBM 圣何塞实验室启动了 System R 项目,目标是造一台全功能的关系数据库。项目组里有唐纳德·钱柏林(Donald Chamberlin)、雷蒙德·博伊斯(Raymond Boyce)、帕特丽夏·塞林格(Patricia Selinger)等人。
1974 年,钱柏林和博伊斯发表了 SEQUEL(Structured English Query Language,结构化英语查询语言)——用接近英语的句子写查询:
"从客户表里选出城市是上海的姓名"——非程序员读一遍就能懂。这就是今天所有程序员都在用的 SQL。因为 "SEQUEL" 是英国飞机公司霍克·西德利(Hawker Siddeley)的注册商标,后来改名 SQL(Structured Query Language)。
System R 还首次实现了数据库的 ACID 事务(原子性、一致性、隔离性、持久性)——让"多个人同时改数据也不出错"成为可能。这里给非技术读者翻译一下 ACID:原子性就是"要么全做,要么全不做"(转账转一半崩溃了,钱不能丢一半);一致性就是"数据永远符合规则"(余额不能为负);隔离性就是"两个人同时改一条数据不会互相踩脚";持久性就是"一旦提交,断电重启也不丢"。这四个字母,是今天一切银行系统、电商系统敢让你放心用的基石。
塞林格开发了基于成本的查询优化器,让 SQL 能自动找到最快的执行路径;雷蒙德·洛里(Raymond Lorie)发明了"预编译查询计划",让重复查询不再每次都从头解析。可以说,今天关系数据库的每一项核心技术,都起源于 System R 这个"母机"。
但 IBM 犯了一个后来被反复研究的错误:它不敢把 System R 快速推向市场——因为担心它会蚕食自家 IMS 的利润。结果,IBM 直到 1981 年才推出简化版 SQL/DS,1983 年才发布 DB2。而正是在这段犹豫期里,别人抢跑了。科德本人则在 1981 年拿到图灵奖——关系模型从"异端"变成"正统",只用了十年。
IBM 发明了关系模型和 SQL,却在商业化上输给了 Oracle——因为怕冲击自家 IMS 的利润。这几乎就是第三讲里 DEC 错失 PC 的翻版:大公司面对"会革自己命"的新技术,为什么总是一步慢、步步慢? 既是路径依赖,又是组织惯性,同时也是财务上的"护城河心理"。三者当中,财务护城河心理是根本,组织惯性是关键,路径依赖是次要加持因素。
大公司核心营收来自成熟现金牛业务,IBM 的 IMS 数据库、DEC 的小型机都是高利润支柱。颠覆性新技术会蚕食存量利润,短期冲击财报与高管绩效。职业经理人出于避险心态,不愿主动颠覆自身盈利体系,形成拖延观望的决策惯性。
同时,企业组织架构、考核机制、资源渠道均围绕旧业务搭建,团队利益固化,天然排斥低毛利、抢存量的新业务。而长期深耕旧赛道形成的路径依赖,进一步抬高了转型成本。
最终企业因畏惧自我革新错失窗口期,外部无存量束缚的对手顺势崛起,造就大公司一步慢、步步慢的宿命。
五、商业王者:Oracle 与 SQL 的胜利(1979—1990s)
1. Oracle:第一个吃到螃蟹的人(1977—1979)
1977 年,加州一个叫拉里·埃里森(Larry Ellison)的软件工程师,读到 IBM 发表的 System R 和 Codd 论文后,做了个判断:这是下一个时代。他和鲍勃·迈纳(Bob Miner)、埃德·奥茨(Ed Oates)凑了 2000 美元,成立了一家小公司,最初叫软件发展实验室(Software Development Laboratories)。有个花絮:埃里森此前在 Ampex 公司参与过美国中情局(CIA)的一个项目,项目代号恰好叫"Oracle"——后来这家公司干脆用了这个名字。
1979 年,公司发布 Oracle V2——历史上第一个商用的 SQL 关系数据库。注意,没有 V1:埃里森坚持"客户不会买第一版",直接跳号。当时的 Oracle V2 跑在 DEC VAX 小型机上,内存只有 128 KB,简陋得像个玩具,但它是真的能跑的 SQL 数据库。1983 年公司改名 Oracle,同年发布用 C 重写的 V3,能跑在大型机、小型机、PC 上——跨平台成了它的大杀器。
埃里森的商业嗅觉,和第四讲错过 IBM-PC 的基尔代尔形成鲜明对照:技术可以不是最完美的,但时机必须是第一个。 Oracle 抢在 IBM 前面卖 SQL,从此奠定了"数据库霸主"的地位,一路统治到互联网时代。1990 年 Oracle 一度因销售策略激进几乎翻车(提前确认收入导致财报丑闻),但很快爬了起来,1995 年成为第一批全面拥抱互联网的大软件公司。
2. 群雄并起:DB2、SQL Server 与数据库战国(1980s—1990s)
关系数据库的市场一旦被点燃,群雄并起:
- IBM DB2
(1983):IBM 终于把 System R 产品化,主攻大型机市场,至今仍是银行核心系统的定海神针; - Microsoft SQL Server
(1989):微软和 Sybase 合作推出,后微软买断 Windows 版版权,1990 年代随 Windows 占领中小企业市场; - Ingres
(伯克利,1973):加州大学伯克利分校的迈克尔·斯通布雷克(Michael Stonebraker)领导的学术项目,是最早的关系数据库之一,后来开源; - Sybase / Informix / 其他
:各据一方。
值得一提的是,1980 年代还上演过一场"SQL 版权战":IBM 曾想把 SQL 据为己有,但业界抵制,最终 SQL 走成了开放标准——这个决定,让 SQL 成了全人类的共同语言,而不是某一家公司的私产。
此外,1980 年代的数据库圈还有一家公司值得记一笔:Cullinet。它把巴赫曼的 IDS 思想做成了商品化的 IDMS,一度是全球最大的独立数据库软件公司,1980 年代在纽约证券交易所风光上市。但关系模型崛起后,Cullinet 没能及时转型,1980 年代末迅速衰落——一个时代的明星,成了下一个时代的注脚。它的故事和后来 DEC 的陨落如出一辙:在范式转换面前,过去的成功反而成了最重的包袱。
1986 年,ANSI 发布第一个 SQL 标准(SQL-86),1992 年的 SQL-92 做了大扩展(外连接、子查询、完整性约束)。SQL 从"IBM 的方言"变成了"全世界的通用语"——程序员学会一套,走遍天下数据库都不怕。这就像度量衡的统一:一旦标准立住,网络效应就开始滚雪球,后来者再想另起炉灶,难如登天。
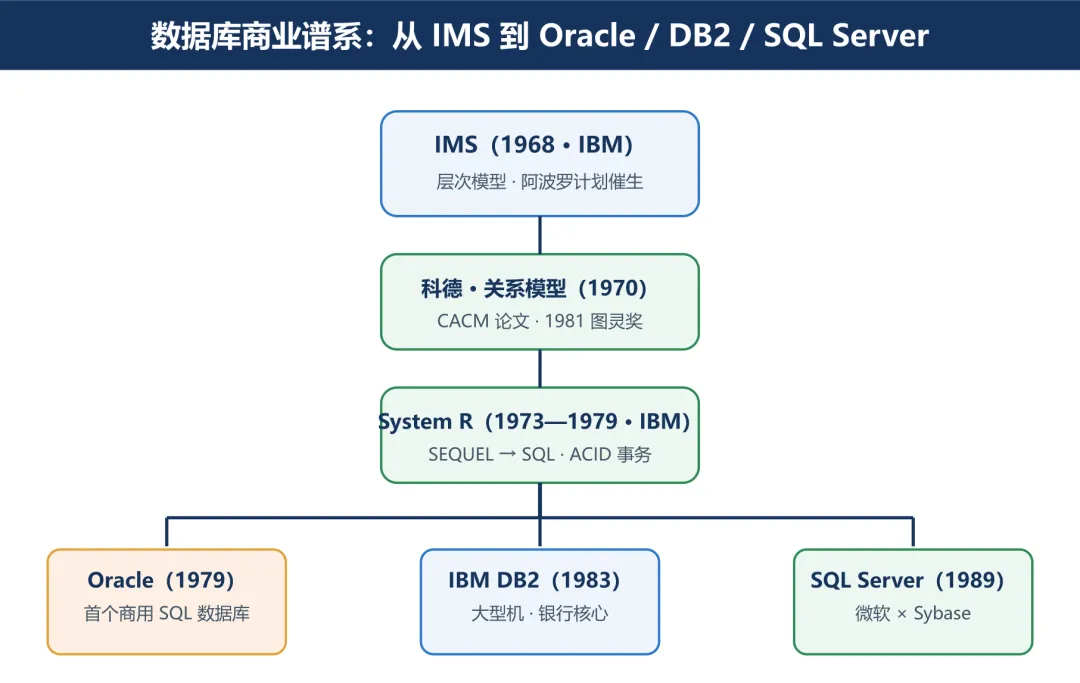
图3 · 数据库商业谱系:IMS → System R → Oracle / DB2 / SQL Server
六、开源革命:数据民主化(1995—2000s)
1990 年代中后期,关系数据库的贵族时代(Oracle、DB2 动辄数十万美元)迎来了一批"平民挑战者":开源数据库。它们的故事,和第四讲 UNIX 的"被迫免费"一脉相承,但这次是主动拥抱开源。
1. MySQL 与 LAMP(1995)
1995 年,瑞典程序员迈克尔·维德纽斯(Michael "Monty" Widenius)和戴维·阿克马克(David Axmark)发布了 MySQL——名字来自维德纽斯的女儿 My。它简洁、快速、免费,正好赶上互联网爆发,和 Linux、Apache、PHP 组成了著名的 LAMP 技术栈——今天互联网上不计其数的网站,靠这套"免费四件套"跑起来。可以说,没有 MySQL,就没有 2000 年代那波低成本创业潮:一个大学生用几百美元租台服务器,就能搭起一个能扛住百万访问的网站。
2008 年 Sun 收购 MySQL AB,2010 年 Oracle 收购 Sun——MySQL 落到竞争对手 Oracle 手里,维德纽斯愤而分叉出 MariaDB(以他另一个女儿 Maria 命名),发誓永远开源。这个"女儿的名字"梗,成了开源世界里最温情也最执拗的一段佳话——技术之争,说到底还是价值观之争。
2. PostgreSQL:学术血脉的集大成者(1986—1996)
另一条更"学院派"的线是 PostgreSQL。它的祖先是斯通布雷克 1973 年在伯克利做的 Ingres;1986 年他启动后继项目 POSTGRES,加入对象-关系特性(复杂数据类型、规则系统);1996 年改名 PostgreSQL 正式开源。它以"标准最严、功能最全、扩展性最强"著称,今天被公认为全世界最先进的开源关系数据库——从金融系统到地理信息(PostGIS),到处是它的身影。斯通布雷克本人 2014 年拿了图灵奖——他是数据库领域唯二的图灵奖得主之一(另一位是科德)。
3. SQLite:无处不在的隐形冠军(2000)
还有一位低调到极致的:SQLite。2000 年,理查德·希普(Richard Hipp)为美国海军的导弹驱逐舰项目设计了它——不需要独立服务器,直接内嵌进应用程序。如今,你手机里的每个 App、每台电脑的操作系统、每个浏览器,几乎都内置了 SQLite;有人统计全球有超过一万亿个 SQLite 数据库在默默运行。它是"最不起眼,却最无处不在"的数据库——就像混凝土里的钢筋,没人注意,但整个大楼靠它撑着。
顺便说一个反常识的事实:这四家开源数据库(MySQL、PostgreSQL、SQLite,加上后来的 MariaDB),没有一家是"美国大厂"主导的——MySQL 来自瑞典、MariaDB 是分叉、PostgreSQL 来自大学实验室、SQLite 是个人项目。数据库这个领域,恰恰是"个人和小团队也能撼动巨头"的最典型样本。 这提醒我们:核心软件不一定只能靠巨无霸公司造出来,开放生态和聪明头脑,同样是国之重器。
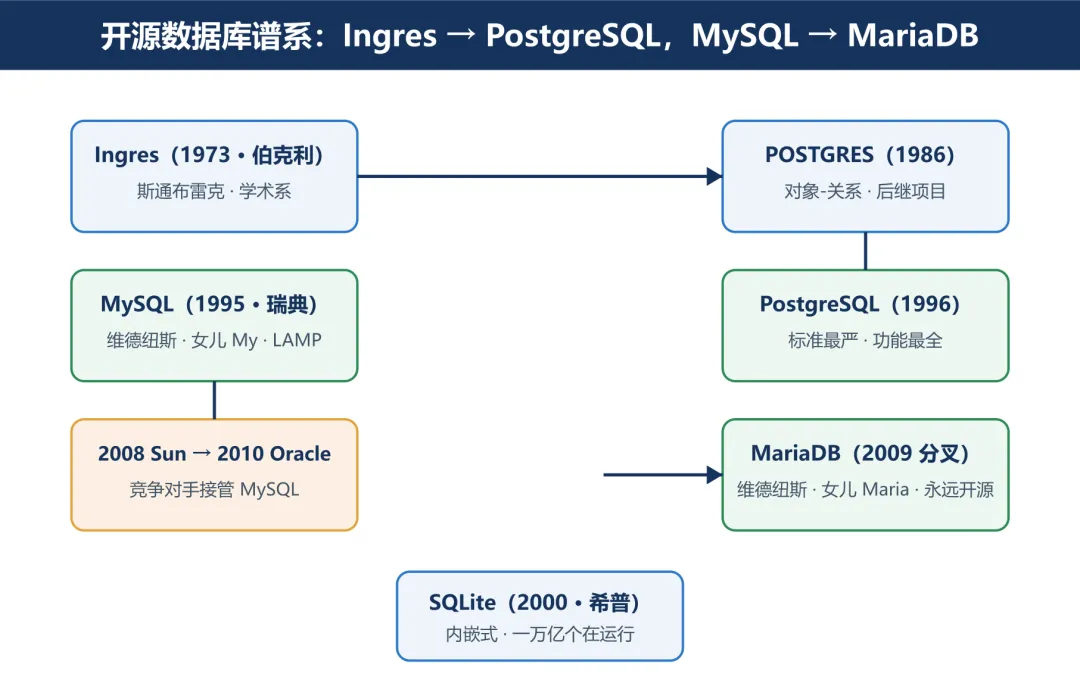
图4 · 开源数据库谱系:Ingres → PostgreSQL,MySQL → MariaDB/SQLite
开源数据库的崛起,本质是一场"数据库民主化":将高端关系数据库从大企业昂贵商业产品变为行业公共基础设施。公地逻辑下,核心底座开放共享,全社会开发者共同迭代,降低使用门槛,放大上层应用创新效率,但开源不等于自主可控,开源 + 自主是可行但有边界的重要路线,而非万能解。
开源底座提供成熟代码、社区生态与人才池,可以大幅缩短研发周期,避免从零造轮子。国内数据库厂商基于开源内核做深度定制、增强安全能力、适配国内软硬件生态,构建自主服务与商业能力,能够快速落地信创场景。
但风险同样突出:开源代码受海外许可证约束,社区主导权不在我方,存在版本断供、协议变更、供应链漏洞风险。因此 “开源 + 自主” 不能简单拿来即用。必须做到内核可控,掌握代码修改、漏洞修复的主导权,建立国内独立社区,同时布局部分完全自研的技术储备作为兜底。
综上,开源 + 自主是信创数据库高效的现实路径,但自主可控的核心不在于是否开源,而在于对代码、社区、供应链的实际掌控力,开源是工具,不能替代底层自主能力建设。
七、收束:数据组织 = 信息社会的骨架
把这一讲收个口。
从 1963 年巴赫曼的 IDS,到 2000 年的 SQLite,数据库走完了四步:
- 文件系统
(1950s):数据归程序私有,一团乱麻; - 层次/网状
(1960s):数据共享了,但要"导航"才能找到; - 关系模型
(1970):一次声明式革命——"我只说我想要什么"; - 开源民主化
(1995—2000s):关系模型变成人人可用的公共品。
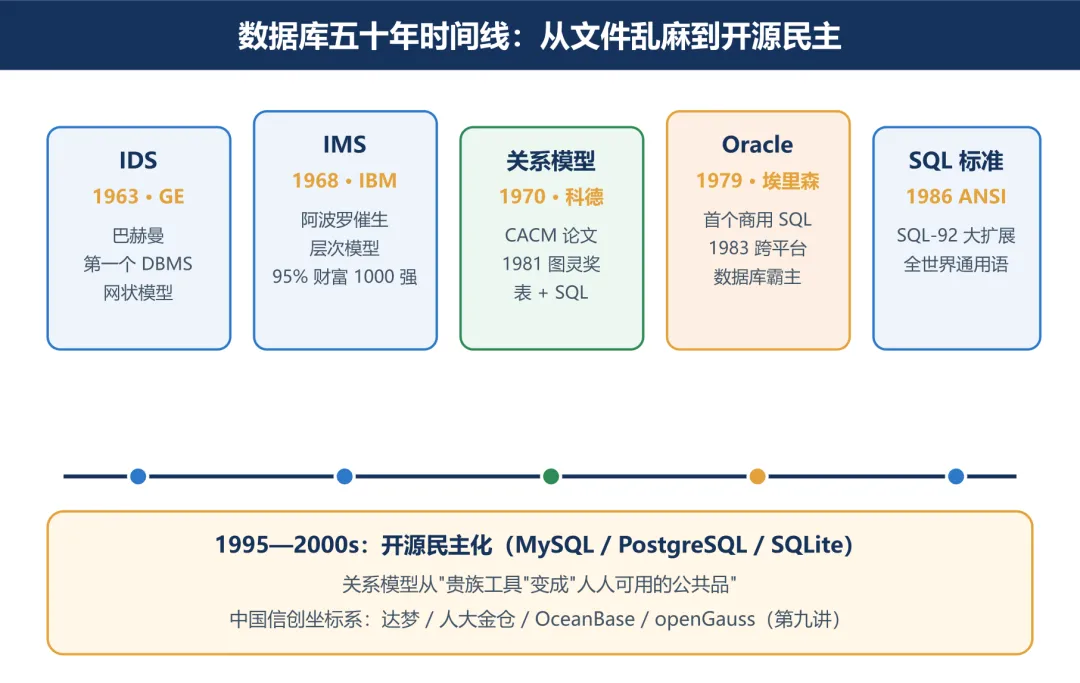
图5 · 数据库五十年时间线:IDS(1963)→ 关系模型(1970)→ Oracle(1979)→ SQL 标准(1986)→ 开源(1995)
关系模型为什么能赢五十年?因为它做到了三件事:抽象(把物理存储藏起来)、简单(一张表,人人都懂)、数学(有严谨的集合论打底)。层次模型和网状模型被淘汰,不是因为它们"错",而是因为它们把"怎么找数据"的责任推给了程序员——而关系模型把这份责任交给了系统。这就像第四讲操作系统里"分时系统"的哲学:把复杂度留给机器,把简单留给用户。
用这个系列的话说:数据是信息社会最基础的"信号",数据库就是把信号整理成"秩序"的基础设施。 没有数据库,今天的一切——银行转账、网购、订票、健康码、推荐算法——全部停摆。你每一次点"查询",背后都是一次 SQL 在几毫秒内完成的数据检索。据估计,今天全球每天产生的数据以 EB(10 亿 GB)计,而其中绝大多数,最终都沉淀在关系数据库——或者受关系模型启发的数据系统里。
有一个经典框架叫"DIKW 金字塔":数据(Data)→ 信息(Information)→ 知识(Knowledge)→ 智慧(Wisdom)。数据库站在最底层——它把原始数据变成"信息",而信息和知识、智慧,全都建立在这一层之上。可以说,数据库是文明的"记账本":农业文明记账靠竹简,工业文明记账靠账本,信息文明记账靠数据库。谁的记账本最可靠、最强大、最自主,谁就掌握了这个时代的话语权。
这个框架还能往后延伸:2000 年代以后,互联网规模爆炸,催生了 NoSQL(非关系数据库)和分布式数据库——Google 的 Bigtable、亚马逊的 Dynamo 都是为"海量 + 高并发"而生的;今天 AI 时代的大模型训练,本质也是在"更高效地组织和使用数据"。但万变不离其宗——关系模型的思想(表、键、连接、事务)仍然是现代数据世界的地基,就像冯·诺依曼架构是所有计算机的地基一样。甚至今天的向量数据库、图数据库,也大多提供 SQL 接口——因为几代程序员都只会这一种"数据库普通话"了。
对中国来说,数据库还有一层特殊的意义:它和操作系统一样,属于"卡脖子"的核心软件。第八、九讲我们会讲到,中国的达梦、人大金仓、OceanBase、openGauss 正在这条赛道上追赶——而这一讲讲的所有故事,就是他们追赶的坐标系。数据库的价值,不只是"存数据",更是"定义数据主权":谁掌握数据库标准,谁就掌握了一个国家最核心的数据资产。想象一下:如果有一天,一个国家的金融、政务、能源系统底层都跑在别国的数据库引擎上,那么断供、后门、制裁——每一个词都足以让人睡不着觉。这正是中国为什么要坚持搞自主数据库的原因,也是"信创"这个词背后真正的分量。
关系模型统治了半个世纪,靠的是"抽象 + 简单 + 数学"。但今天的数据世界正在剧变:海量非结构化数据、实时流、大模型向量检索。
然而,我认为关系模型并不会被颠覆,会如同 “存储程序” 范式一样继续作为底层地基,但不再是唯一的数据范式,将与向量、流、非结构化等新模型共生共存,也是未来我们信创数据库演进的核心逻辑起点。
关系模型的根基是严谨集合论数学抽象、SQL 简洁表达能力、事务 ACID 强一致性,这是金融、政务、企业业务系统不可替代的刚需。海量业务交易、账务、管控类信创场景,依然强依赖它的确定性、可解释性与工程成熟度,这部分需求不会消失。
大模型带来向量检索、实时流处理、非结构化数据爆发,并不是推翻关系逻辑,而是新增能力维度。新一代数据库普遍走向多模融合:在传统关系底座之上叠加向量引擎、流计算、JSON 处理能力,而不是彻底抛弃 SQL 与表结构。
真正被替代的只是单一封闭的传统商业数据库产品,而非关系范式本身。信创数据库的未来,也不是从零完全另起一套全新范式,而是守住关系模型这个成熟地基,再补齐向量、流、AI 增强等新能力,构建多模一体化的数据底座。
这一讲同样有一个反复出现的主题:"第一个发明的人"往往不是"第一个赚钱的人"。IBM 发明了关系模型和 SQL,Oracle 赚走了钱;科德拿了图灵奖,埃里森成了首富。发明权、商业权、话语权三者常常分离。
今天我们中国要实现卡脖子技术突围,不能只满足于完成原型发明,必须同步争夺生态、标准与商业模式,实现发明权、商业权、话语权的统一。
IBM 率先发明关系模型,科德完成理论突破,但没有完成商业化落地、构建产业生态,商业果实被 Oracle 摘取,充分说明:技术发明不等于产业胜利。拥有技术原型,只拿到了发明权;能否把技术转化为产品、打磨商业模式、牵引上下游、主导行业标准,才决定商业权与话语权。
对今天的我们,“做得出” 解决有无问题,是基础底线;但仅仅突破技术,很容易陷入 “有技术无市场、有产品无生态” 的困境。一方面要坚持底层技术攻关,掌握核心发明能力;另一方面要补齐短板:打磨适配市场的产品方案,培育上下游产业生态,参与甚至主导技术标准,跑通可持续的商业闭环。
技术突破解决 “能不能做”,生态标准商业模式解决 “能不能用起来、能不能持续迭代”。三者缺一不可,只有技术、商业、话语权协同,才能真正完成技术突围,避免 “发明了技术,却输掉产业”。
下一讲,我们终于要讲计算机如何从"机构"走向"个人"了——个人电脑的诞生,微软与苹果的世纪对决。那是整个计算机史里,最热闹、也最精彩的一章。
写到这里,我们终于知道一直在触碰数据库,自己却浑然不觉:网上注册第一个账号填写用户名密码,信息便存入关系数据库的一张张表里;打开银行 APP 查询余额,背后是 SQL 完成的查询与账务事务;拿 Excel 整理课程表格、记账清单,本质也是在用类关系模型组织行列数据。
我们很少看见数据库本身,却时刻行走在它的地基之上。每一次登录、每一笔交易、每一次表单填写,都是关系模型在默默完成存储、查询与校验。这套半个世纪前诞生的思想,早已埋藏在信息社会的每一秒日常里,成为看不见却无法离开的基础设施。
7. 下一讲预告
第六讲《个人电脑·微软与苹果》(1975—1995)——从 Altair 到 IBM PC,从 Apple II 到 Macintosh,看计算机如何从机构走向个人。
资料出处(建议发布前复核链接有效性)
IBM, "Edgar F. Codd" 与 "The relational database" 官方历史页,ibm.com/history/edgar-codd ACM, "Charles William Bachman — A.M. Turing Award Winner (1973)",amturing.acm.org Wikipedia, "IBM Information Management System"(1966 立项 / 1968 上线 / 95% Fortune 1000),en.wikipedia.org Oracle 官方文档, "1 Introduction to Oracle Database"(1977 SDL / 1979 Oracle V2 / 1983 改名),oracle.com Chamberlin, D. "50 Years of Queries"(CACM,含 SQL 历史与开源三杰 MySQL/PostgreSQL/SQLite),cacm.acm.org SQL 历史综合(SEQUEL → SQL 商标改名、System R ACID、SQL-86 标准),engineering.zooz.com
相关阅读|信号与激励系列
· 《计算机十讲》① 战火中的计算 · 《计算机十讲》② ENIAC 与冯·诺依曼体系 · 《计算机十讲》③ 硬件线:从晶体管到微处理器 · 《计算机十讲》④ 软件线:操作系统与编程语言 · 《芯片十讲》③ 硬件线:从晶体管到微处理器 · 《芯片十讲》⑨ 先进制程与制造 · 《AI 十讲》① AI 简史 · 《AI 十讲》② (AI 主线续) · 《电磁波十讲》⑦ 雷达 · 《太空十讲》①
注:本文由作者和AI合作完成。