ARTICLE · 1042739
安卓版 Ollama 杀疯了:6GB 旧手机跑大模型,OpenAI 接口随便调
最近我在 GitHub 上找到一个开源 App,叫 OlliteRT,作者是按"安卓上的 Ollama"这个思路做的。装在手机上,手机就能跑大模型,同时在局域网里开一个和 OpenAI 兼容的接口,别的设备上的软件填个地址就能调。
比如每天汇总一下 RSS,给相册照片打打标签,偶尔还有智能家居那边过来的指令要处理。像这种活儿都不大,一次几秒就完事,但总得有个东西一直在那儿跑的场景。专门扔台电脑跑着不划算,这个项目就能派上用场。
简介
OlliteRT 底层用的是谷歌的 LiteRT-LM 运行时,跑模型用的是手机自己的 GPU 或者 CPU,然后在局域网里开一个 HTTP 服务,开源,Apache-2.0 协议。
模型下载好以后,断网也能用,手机上处理的东西不会传到任何地方去。官方在隐私这块写得也很清楚,没有数据收集,也没有统计代码。
模型这块能干什么
模型从哪来,它给了几条路。最省事的是应用里内置的模型列表,看中哪个点一下就下载,文件托管在 HuggingFace 的 LiteRT 社区。也可以把手机里已有的 .litertlm 文件直接导入。另外还能自己加模型源,填一个 JSON 文件或者一个 URL 就行,加了以后应用大概每 24 小时自己刷新一次,看看有没有新模型。
内置列表里目前这些模型值得说说:
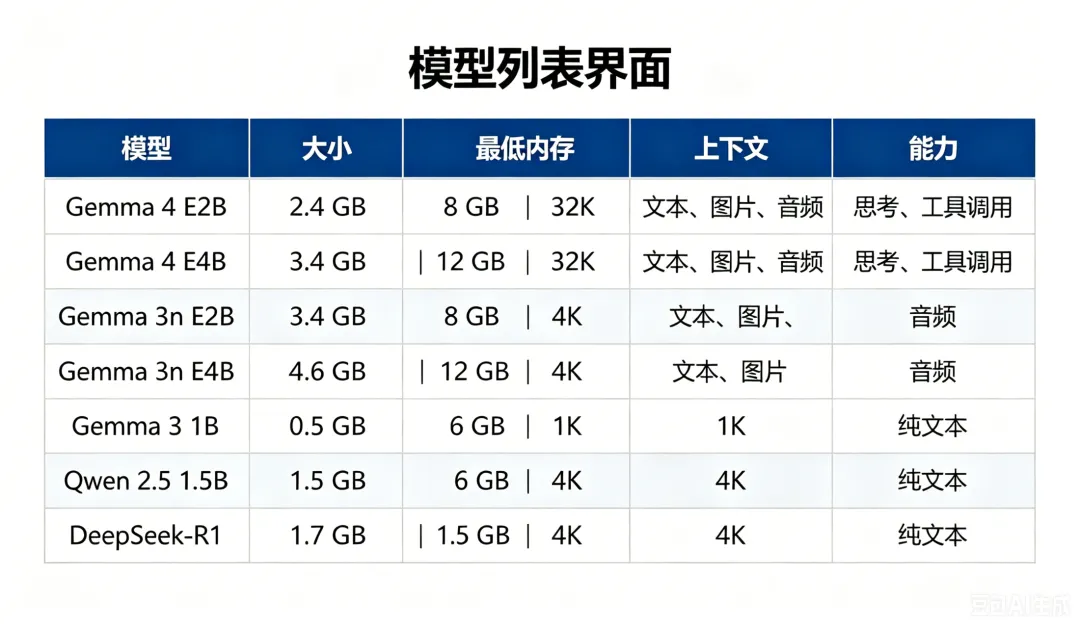
官方推荐大多数人用 Gemma 4 E2B,手机配置高的可以上 E4B。这两个是多模态的,能看图、能听音频,也支持思考模式,回答之前会先给出一段推理过程。Gemma 4 还带一个叫 MTP 的功能,大概意思是一次预测好几个词,出字速度会快不少,需要在模型的设置里手动打开。
我自己的手机内存不算大,平时挂的是 E2B,够用了。
接口兼容到什么程度
这块我觉得是它做得比较突出的地方。OpenAI 的 chat/completions 和 completions 都有,Responses 接口和音频转写接口也支持,甚至连 Anthropic 的 Messages 接口都兼容了,流式和非流式都能用。
所以手头现成的工具基本不用改,像 Open WebUI,填个地址就能连上。Python 里用 OpenAI 官方 SDK,把 base_url 指到手机就行,curl 直接调也没问题,Home Assistant 那边有专门的接入文档。我自己是把 NAS 上那几个定时任务的接口地址改了一下,任务就跑起来了,别的什么都没动。
有一点要注意,工具调用目前还是实验性质,在 Gemma 4 上效果最好,小模型不一定能稳定按格式返回。官方给了两种模式,默认是 schema 注入,不行的话可以在设置里关掉,退回到用提示词解析的老办法。
监控和日志做得挺细
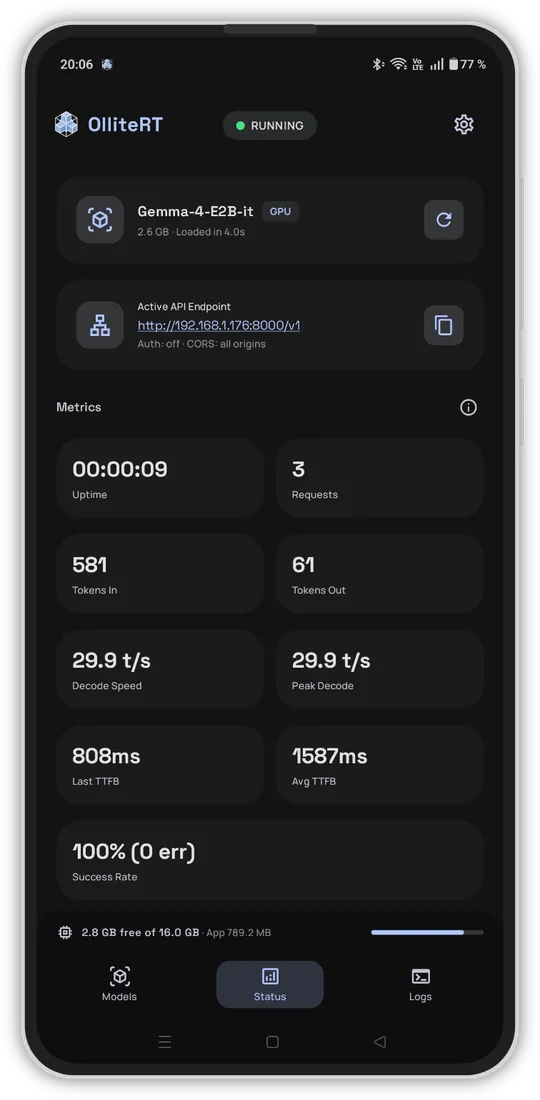
服务器跑起来以后,状态页上有实时数据可以看,跑了多久、处理了几个请求、输入输出多少 token、出字速度、首字延迟、成功率,都摆在那儿。还有一个悬浮窗,可以拖来拖去,手机扔在一边当服务器用的时候,瞟一眼就知道它还在不在跑。
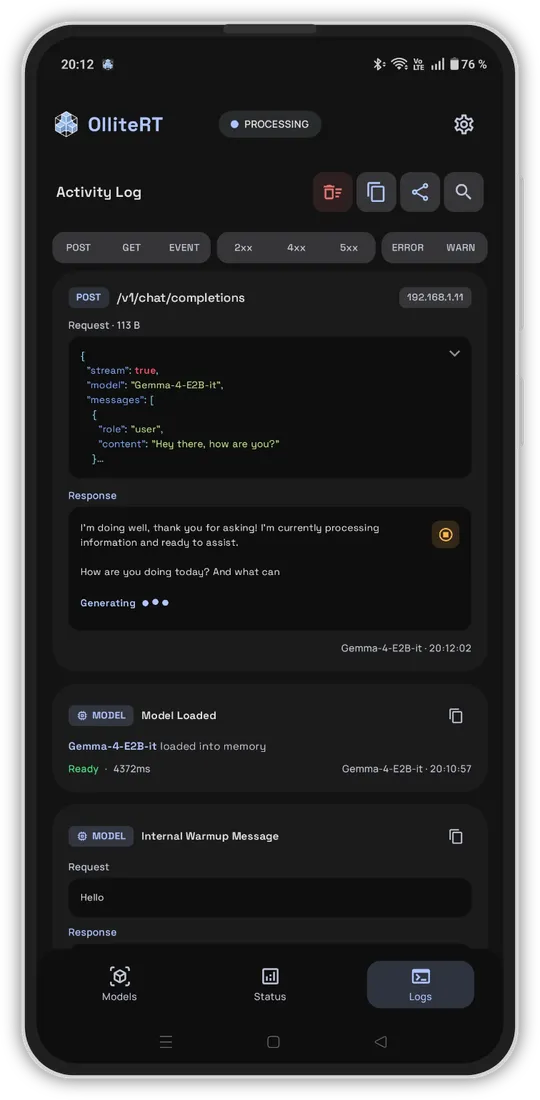
日志页也做得细。每次请求和响应都会记下来,想找某一条可以按请求方法或者状态码过滤,也可以搜关键词,JSON 带语法高亮。每条日志底下有一排小标记,能看出来这次请求花了多少毫秒、是不是流式、有没有开思考、估算的输入 token 占了上下文多少。上下文快占满的时候那个数字会变黄变红,挺直观。
除了应用里能看到的这些,它还有一个 /metrics 端点,能吐出 29 个 Prometheus 格式的指标,家里跑着 Grafana 的话可以直接接进去画图。Home Assistant 除了接模型,还能通过它内置的 REST 接口远程看状态、切模型、改设置。
另外它内置了 Benchmark 功能,同一台手机上把几个模型挨个测一遍,谁处理长输入快、谁出字快、谁加载快,一比就知道。新手机上手的话,我建议先跑一遍这个,比看参数表直观。
配置项给得挺足
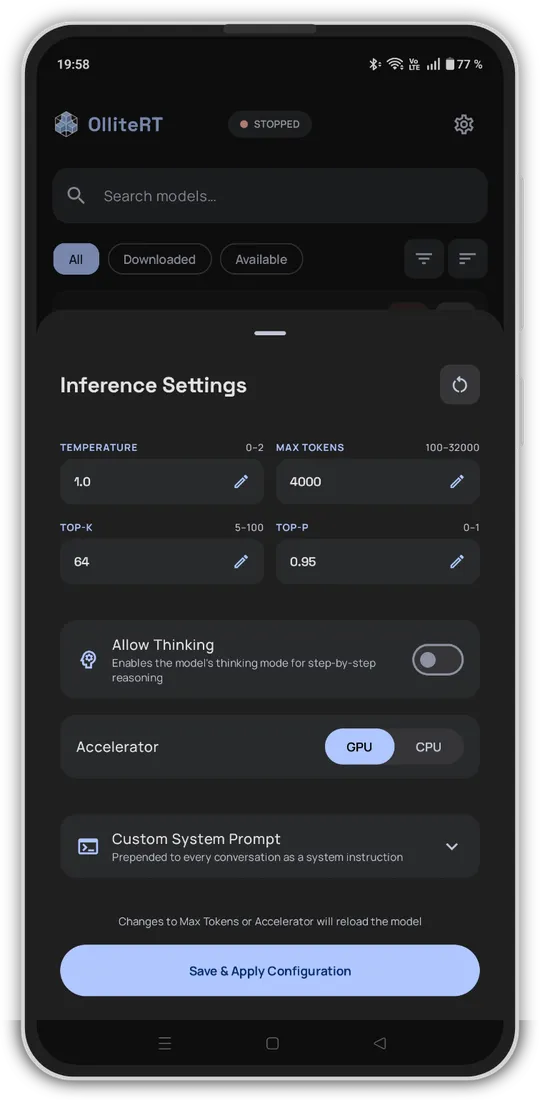
每个模型可以单独存一套推理参数,温度、top-k、top-p、最大输出长度都按模型保存,重启不丢。加速器可以在 GPU 和 CPU 之间切,默认 GPU,出问题再换 CPU 试试。
有几个开关我自己是真用上了。
一个是闲置自动卸载。 设一个时间,比如 5 分钟没收到请求,模型就从内存里卸掉,内存还给系统。下一个请求进来的时候会自动重新加载,代价是这一次会慢几秒。手机平时还要干别的的话,这个开关就很有用。
开机自启我也开了。 选一个默认模型,打开 Start on Boot,手机重启以后服务自己就起来了。记得把它的电池优化关掉,不然安卓后台可能把它杀掉。这样弄完,这台手机基本就是个不用管的设备。
还有个常驻通知。 它靠一个前台通知保住后台服务,通知上直接有停止服务和复制地址两个按钮,这个细节挺贴心。
接口安全这块
接口可以开 bearer token 验证,开了以后没带 token 的请求直接 401。还能设客户端 IP 的访问规则,只放行家里那几个设备,监听范围也能调。
官方文档里有句话我觉得得单独拿出来说:
不要通过端口映射把它暴露到公网,它没有 HTTPS,token 验证也只是基础手段。它合适的使用场景就是局域网,别往公网放。
上手很简单
整个过程没什么门槛。从 GitHub 的 Releases 页下载 APK 装上,打开以后在模型列表里挑一个下载,下好了点模型卡片上的 Start Server,状态页上就能看到地址,一般是 http://手机IP:8000/v1 这个样子,把这个地址填进客户端,完事。
硬件要求:安卓 12 以上,arm64 架构,内存最低 6 GB,想跑多模态模型最好 8 GB 往上。2017 年以后的安卓机基本都是 arm64,这一点问题不大。
有些限制得提前说下
一次只能加载一个模型,请求也是一个接一个排队处理,想拿它当多人共用的服务不现实。
只支持 .litertlm 格式,不认 GGUF。网上那些给 llama.cpp 和 Ollama 准备的模型文件在这儿用不了,别下错了。
接口返回的 token 计数是估算的,按字符数除以四算出来的,英文还行,代码和多语言内容会偏。想拿这个数去算费用是不行的,看个大概还凑合。
从本地导入模型的时候,文件会被复制一份到应用自己的目录,相当于占了双倍空间,导入完记得把原文件删了。
因为跑在移动端运行时上,logprobs、LoRA 这类进阶玩法都没有。
长时间挂机要注意的事
如果打算让它 7×24 小时跑着,官方的建议是插着电用,把手机壳摘了帮助散热,放在阴凉硬实的平面上,隔段时间看看有没有发烫、电池有没有鼓包。
功耗方面,模型生成的时候大概 5 到 10 瓦,闲着的时候接近零。跟显卡服务器动辄三百瓦往上比,省电是真省电。
用下来的整体感受
指望它替代一台正经的推理机器是不行的,一次只能跑一个模型、请求排队处理,这个限制绕不开。但放在某些场景下刚好,活儿碎,量小,不想专门开电脑,也不想数据往外走。监控、日志、权限、自启这些东西它都有,当一个常驻服务用没什么问题。
用到现在,NAS 上那几个任务没再让我操过心,家里有闲置安卓机的话,可以装一个试试。
开源地址:
https://github.com/NightMean/OlliteRT