ARTICLE · 1048240
系统智能:AI代理正在进入“记忆时代”,降低90%Token开销
系统智能:AI代理正在进入“记忆时代”,降低90%Token开销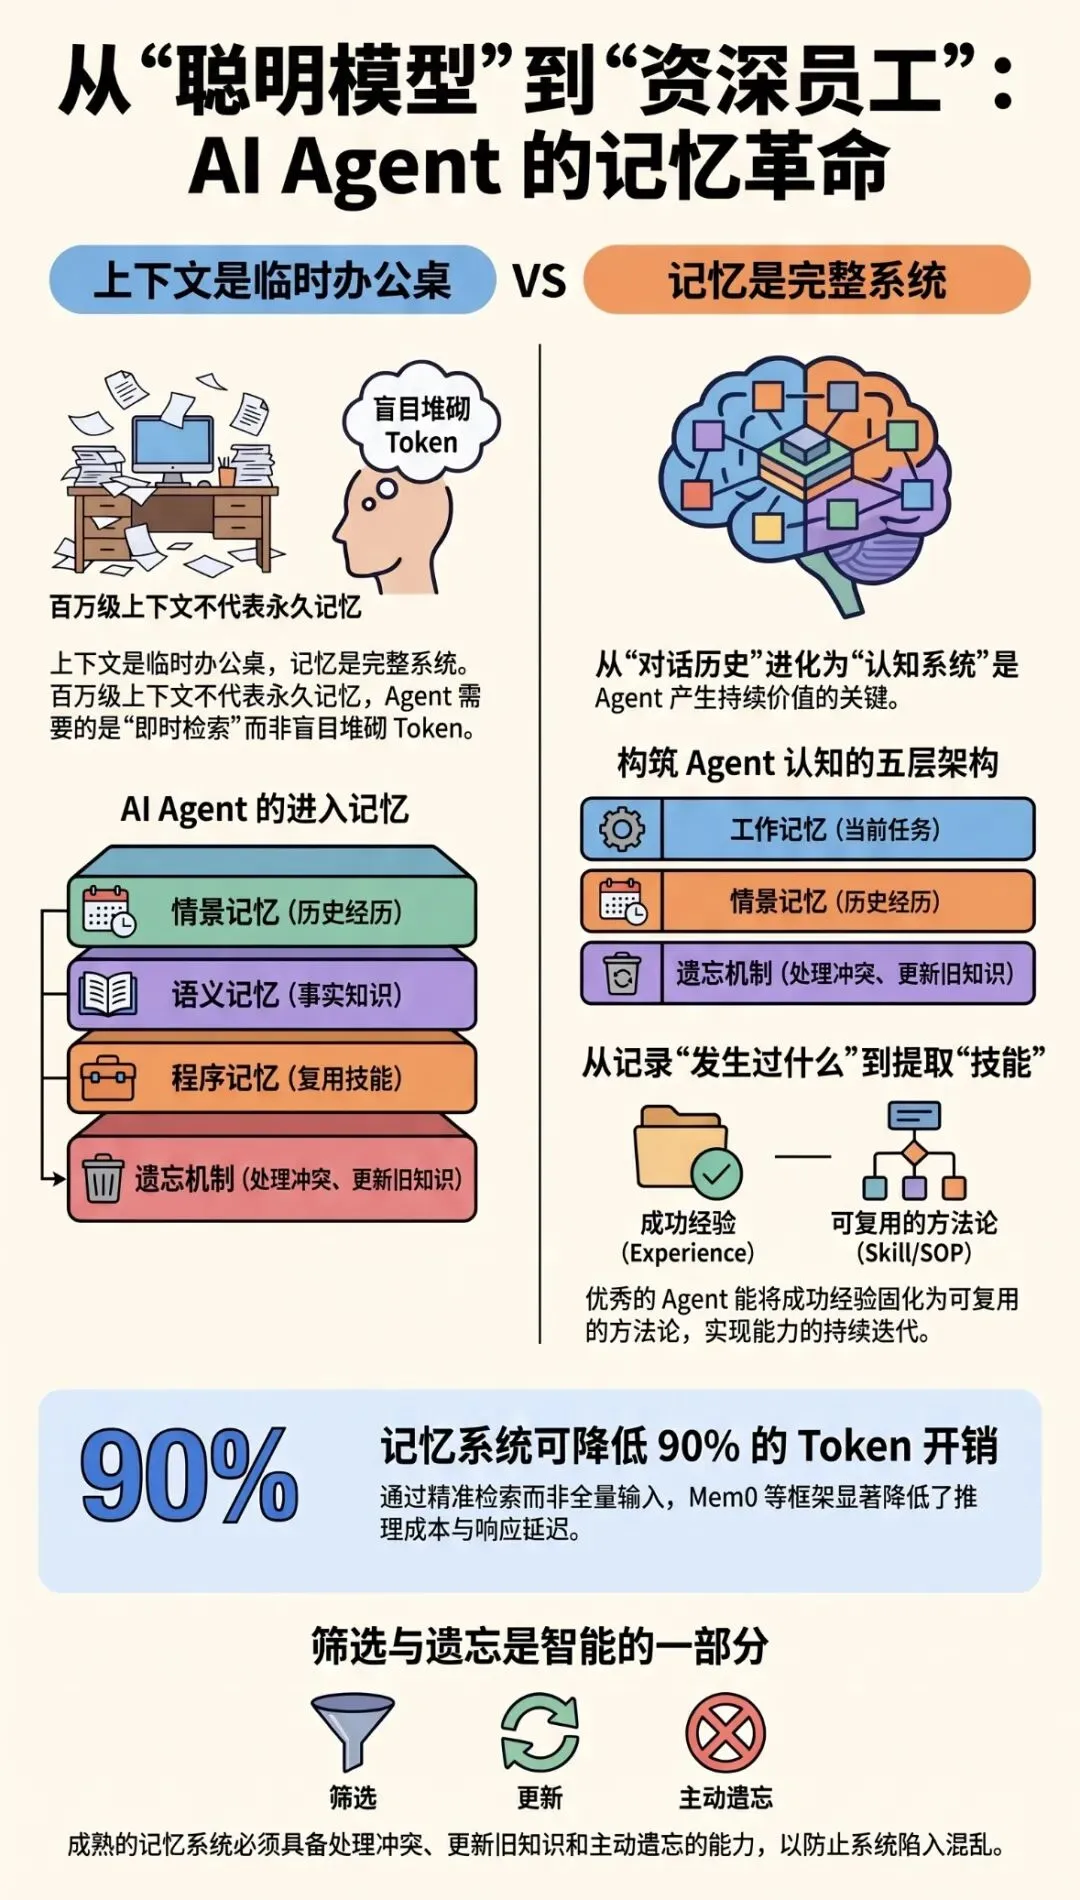
文章导读: 这篇文章探讨了人工智能智能体(Agent)的发展重心正从单纯追求模型规模和上下文长度,转向构建完善的记忆系统。作者指出,传统的上下文窗口仅相当于“临时办公桌”,而真正的智能需要涵盖工作记忆、情景记忆、语义记忆与程序记忆的综合体系。通过将历史经历转化为结构化知识与复用技能,Agent 能够显著提升运行效率并大幅降低 Token 成本。此外,有效的遗忘机制也是维持系统智能、避免信息冲突的关键。最终,AI 的进化将体现为从“聊天模型”向具备时间连续性的系统智能跨越,使其能够通过积累经验实现真正的成长。 
过去两年,大模型竞争最受关注的指标一直是参数规模、推理能力和上下文窗口。从 128K、200K 到百万级 Context,模型似乎拥有了越来越大的“脑容量”。但当 AI 从聊天机器人走向能够连续工作数小时、数天甚至更久的 Agent 后,一个更基础的问题开始暴露出来:上下文再长,也不等于真正拥有记忆。 一个 Agent 今天花了半小时排查程序故障,最终发现问题出在数据库迁移脚本;第二天再次遇到类似问题,如果它仍然需要重新阅读几十个文件、重新分析日志、重新尝试昨天已经失败的方法,那么模型即使再聪明,本质上仍然是在重复“上班第一天”。 因此,2025—2026 年,Agent 工程正在出现一个明显转向:竞争正在从“模型能想多聪明”,逐渐转向“系统能积累多少经验”。Anthropic、Mem0、Snowflake 以及学术界近期的一系列研究,都在指向同一个方向——下一代 Agent 不只需要上下文,还需要一套完整的记忆系统。 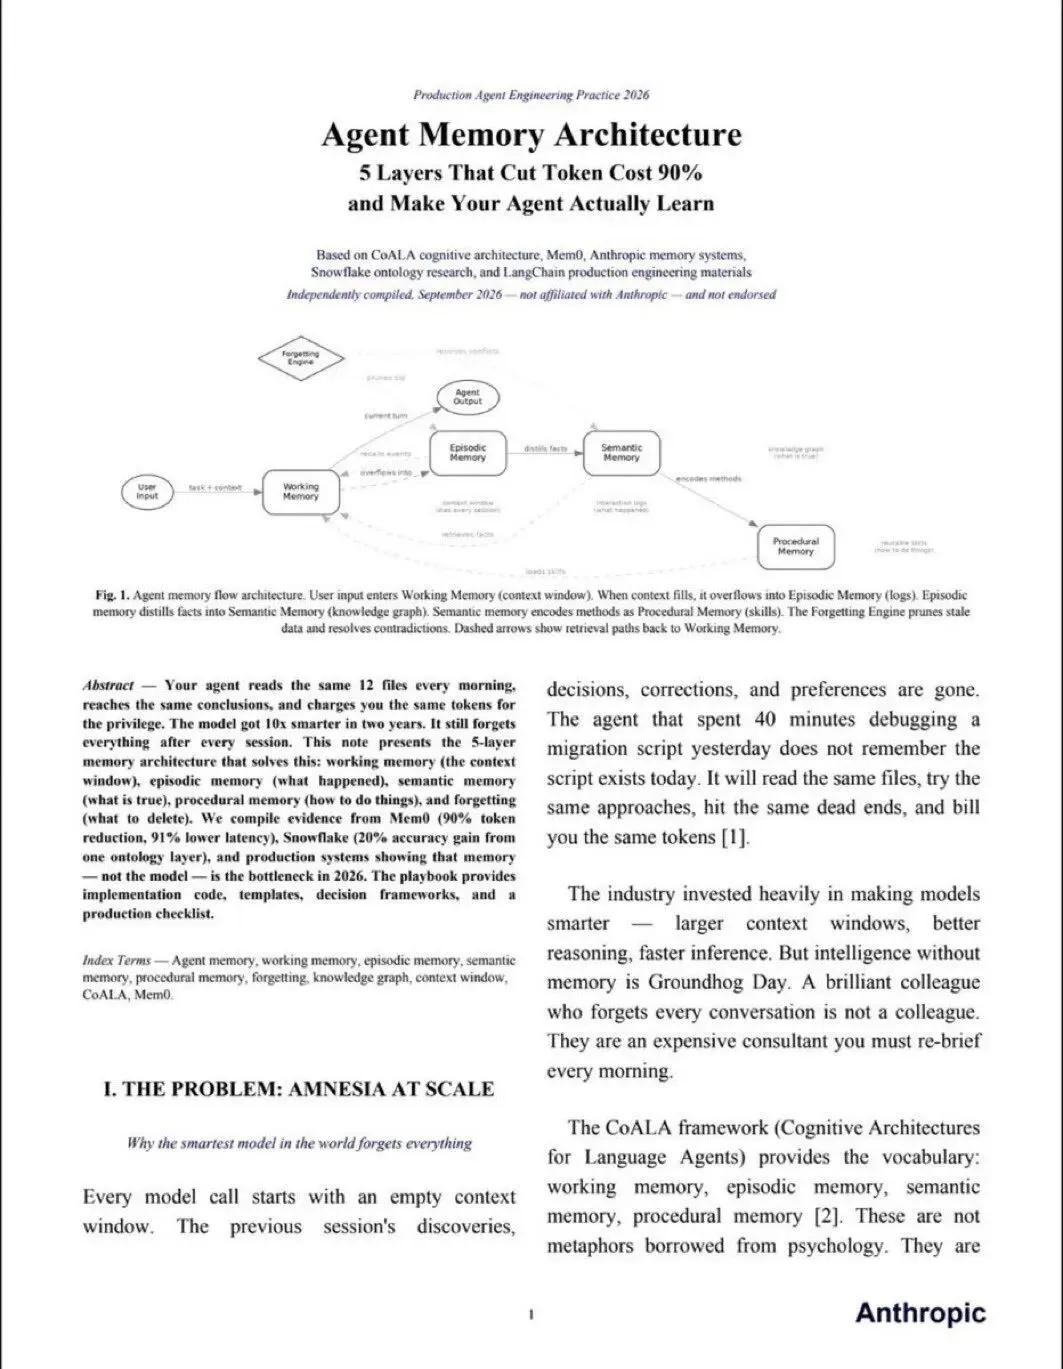
这套系统大致可以理解为五个层次:工作记忆、情景记忆、语义记忆、程序记忆,以及遗忘机制。 今天绝大多数大模型应用的基本结构都差不多:用户提出问题,系统把相关信息放进 Context Window,模型进行推理并输出结果。这实际上就是 Agent 最基础的工作记忆。 Anthropic 在有关 Context Engineering 的工程实践中强调过一个重要观点:Context 是有限资源。随着 Agent 持续运行,工具调用结果、文件、网页、历史消息和中间状态会不断增加,不可能无限制地全部塞进模型。上下文越长,也不意味着模型对所有信息的利用就越稳定,过多无关信息反而可能稀释真正重要的信号。 所以百万 Token 上下文并不能简单理解成“AI 拥有百万 Token 的永久记忆”。它更像一张巨大的办公桌:桌子再大,如果把过去几个月的会议纪要、邮件、代码、日志和聊天记录全部堆在上面,人仍然会找不到真正需要的东西。 因此,Agent 的关键问题正在从: “上下文能装多少?” 转向:“此刻究竟应该让模型看到什么?” 这也正是 Context Engineering 和 Memory Engineering 开始变得重要的原因。 工作记忆解决的是“现在正在处理什么”。例如一个工程 Agent 正在排查设备故障,它真正需要看到的可能只有当前报警、最近几分钟的传感器数据、相关操作规程、刚刚执行的几个工具结果以及当前任务目标,而不是工厂过去三年的全部数据。 换句话说,未来的 Agent 不应该像考试前把整座图书馆搬进考场,而应该做到:需要什么,再去取什么。 这就是所谓的 Just-in-time Retrieval。很多现代 Agent 已经开始这样工作:文件、代码、数据库和知识不必永久塞在 Context Window 中,模型只需要知道它们在哪里,需要时再搜索、读取和加载。某种意义上,这反而更接近人的工作方式——我们并不会记住所有资料,我们更多时候记住的是:东西在哪里。 仅仅解决工作记忆还不够。真正长期运行的 Agent 必须能够回答另一个问题: 以前发生过什么? 这就是情景记忆,Episodic Memory。 比如:9 月 12 日第一次部署失败,原因是数据库 Schema 没有同步;方案 A 无效,后来使用方案 B 成功,整个处理过程耗时 37 分钟。 这不是一个抽象知识,而是一段具体经历。 现实世界中大量真正有价值的经验都属于这种类型:“这个供应商的数据接口周一早晨经常延迟”“这种设备报警大多数时候不是传感器坏了,而是清洗周期到了”“这个代码库升级某个依赖以后容易破坏旧 API”。 这些经验往往不会提前写在操作手册里,而是在一次次真实工作中积累出来。 早在 2023 年,CoALA(Cognitive Architectures for Language Agents)就系统讨论了语言 Agent 的记忆结构,将长期记忆区分为 episodic、semantic 和 procedural 等不同类型。这背后的关键思想是:聊天记录并不等于记忆。 聊天记录只是历史。只有当系统能够从历史中筛选、提炼并重新调用相关经历时,历史才真正变成记忆。 如果一个 Agent 工作半年,可能已经积累了几十万条事件记录。显然,它不能每次都重新阅读这些历史,于是就需要进一步抽象,把大量“发生过什么”提炼成“我们由此知道什么”。 这就是语义记忆,Semantic Memory。 例如: 用户更偏好 TypeScript。 生产数据库采用 PostgreSQL。 这里记录的已经不再是某一次对话,而是相对稳定的事实。 因此,情景记忆与语义记忆之间存在一个非常重要的转换: Event → Fact 前者记录“发生过什么”,后者保存“由此确认了什么”。 这也是为什么 Knowledge Graph 在 Agent 领域重新受到重视。与单纯把整段文字存在向量数据库不同,知识图谱可以明确表达实体之间的关系,例如: 项目 A → 使用 → 设备 B → 位于 → 工厂 C 当 Agent 需要处理复杂实体关系、多跳查询和事实更新时,这种结构往往比一堆散乱文本更加有效。 比“记住事实”更重要的一步,是把成功经验固化成方法。 假设一个 Agent 第一次完成某项任务时尝试了三个方案:A 失败,B 失败,C 成功。传统聊天系统通常只是把整个过程留在聊天历史里;而更成熟的 Agent 应该进一步问: 这个成功过程能不能变成一个以后直接复用的方法? 于是:Experience → Skill 这就是程序记忆,Procedural Memory。 例如一个 Agent 第一次处理复杂 Excel 文件时,花了很长时间摸索出一套有效流程:读取所有 Sheet、识别日期列、统一金额格式、拆除合并单元格、生成 Pivot、检查异常值。第一次需要反复尝试,但如果这套流程被保存成 Skill、Workflow、Script、Function 或 SOP,下一次再遇到类似任务,它就没有必要从头思考。 这也是 Agent Skills 这类设计真正重要的地方。 事实的积累增加知识,方法的积累增加能力。 如果一个 Agent 每完成一次任务,都能把有效经验逐渐沉淀为可复用技能,那么第 1000 次执行任务时,它与第一次执行任务时就真正产生了区别。 这也意味着,未来 Agent 的“成长”不一定全部来自更大的基础模型。大量能力可以沉淀在模型之外:规则、脚本、技能库、工作流、知识图谱和长期记忆,都可以成为 Agent 的外部经验系统。 Memory 最容易被忽略的一面其实不是“记住”,而是“遗忘”。 直觉上,人们很容易认为 Agent 保存的信息越多越好。但一个永远不会忘记任何事情的系统,最终反而可能变得越来越混乱。 比如一年前系统记住:用户喜欢 Python。 半年后更新为:用户最近主要使用 TypeScript。 现在用户又明确要求:新项目统一使用 Rust。 如果三条信息永久拥有同样的优先级,Agent 到底应该相信哪一条? 因此,一个成熟的 Memory System 不只是“保存”,还必须处理更新、冲突、合并、衰减和删除。 一条真正可管理的 Memory,未来很可能不仅包含内容本身,还会附带来源、时间、可信度、权重和有效期。于是它的生命周期变成: Create → Retrieve → Reinforce → Update → Merge → Decay → Forget 这与传统数据库已经有明显区别。 数据库主要关注“把正确的数据存下来”;Agent Memory 还必须判断: 什么时候一条曾经正确的信息,已经不再代表现在。 因此,遗忘不是 Memory 的失败,而是 Memory 的一部分。 智能不仅意味着记住,也意味着筛选。 Memory Architecture 的价值并不只是概念上的,它还直接关系到 Agent 的成本和速度。 Mem0 在长期对话基准 LoCoMo 上进行过一组很有代表性的实验。传统 Full Context 方法是每次推理都重新输入大量历史对话,而 Memory 方法则先从历史中提取重要信息,在新问题到来时只检索相关部分。 在其实验设置中,相对于 Full Context,Mem0 报告了超过 90% 的 Token 开销下降,以及约 91% 的 p95 延迟下降。 背后的逻辑其实非常简单。 假设一个 Agent 工作一年以后产生了 100 万 Token 的历史,现在用户只是问: “上一次为什么没有采用方案 B?” 最笨的方法是重新读取 100 万 Token。 而一个成熟的 Memory System 可能只需要从历史中取回几百个真正相关的 Token。 所以 Memory 带来的效率提升,并不是让模型“读得更快”,而是让模型: 少读大量无关的信息。 随着 Agent 运行时间从几分钟延长到几个月甚至几年,这种差距会越来越大。 Memory 带来的收益还不只是 Token。 Snowflake 曾在 Agent 场景中加入结构化的数据本体信息,例如表之间的关系、Join Key、数据粒度、基数关系和 fanout 等。也就是说,它不是单纯把更多数据库内容交给模型,而是先告诉 Agent: 这个世界是怎么组织的。 其内部实验显示,相对于基线系统,加入这类结构化信息后,最终答案准确率有所提高,平均工具调用次数和整体延迟也明显下降。 这个结果非常值得注意。 Agent 效率低,有时候并不是模型不会推理,而是它不知道: 东西在哪里、彼此是什么关系、应该先查什么。 就像一个经验丰富的工程师第一次进入陌生工厂,如果没有任何资料,他只能不断开门、检查和试错;但如果先给他一张厂区图、管线图、设备清单和控制逻辑图,效率会完全不同。 未来企业级 Agent 的竞争,很可能越来越依赖这种机器可理解的组织知识。 这几年,一个非常明显的架构变化正在发生。 传统聊天系统基本是: History → Prompt → LLM 未来的长期 Agent 更可能变成: History → Memory System → Retrieval → Context → LLM 模型负责思考,Memory System 负责保存和寻找经验,Tools 负责与现实世界交互,Skills 保存做事的方法,Session 保存长期运行状态。 于是一个成熟 Agent 很可能不再只是: LLM + Prompt 而会逐渐形成一整套技术栈: LLM → Working Context → Memory Manager → Episodic Store / Semantic Store / Skill Library / Knowledge Graph → Retrieval & Ranking → Forgetting & Conflict Resolution 外部再连接 Files、Database、API、MCP、Tools 以及其他 Agent。 这会重新定义所谓的“AI 应用”。 未来两家公司完全可能使用同一个基础模型,但一年之后,它们的 Agent 表现出完全不同的能力。一家公司可能已经积累了十万条企业知识、几千次项目经验、数百套工作流和大量专业 Skills;另一家公司仍然每次只给模型发送一个 Prompt。 即使底层模型相同,两套系统表现出来的“智能”也会越来越不同。 当然,这里需要区分一个概念:Agent 拥有 Memory,并不意味着基础模型本身每天都在重新训练。 昨天 Agent 解决了一个 Bug,并不意味着 Claude、GPT 或其他模型的神经网络权重今天自动发生了变化。真正持续变化的是模型外围的 Memory、Files、Knowledge Graph、Skills、Rules 和 Workflows。 因此,更准确的说法不是“模型一直在学习”,而是:模型没有持续重训,但 Agent 系统开始持续积累经验。 这可能会成为未来 AI 极其重要的一次转向。 过去几年,大模型的发展大致经历了这样一条路径: 让模型拥有知识 → 让模型拥有推理能力 → 让模型能够使用工具 → 让 Agent 拥有历史。 而真正长期工作的智能体,最终必须知道五件事: 我现在在做什么;以前发生过什么;哪些事实已经确认;过去什么方法有效;哪些旧信息已经应该忘掉。 当这五件事能够连接起来时,AI 才第一次真正获得一种类似于“时间连续性”的东西。 聊天机器人解决的是: “这一次怎么回答?” 而 Agent Memory 解决的是: “下一次能不能从这里继续?” 未来衡量一个 Agent,也许不应该只看一次回答有多聪明,而要看它工作半年之后有没有真正变得更好:是否记得过去犯过的错误,是否能够把成功经验升级成技能,是否能够识别已经过时的知识,是否知道什么应该遗忘,又是否能够用越来越少的 Token 完成越来越复杂的任务。 因为一个真正有价值的 Agent,不应该每天醒来都像第一次来到公司。 它应该能够在昨天工作的基础上,继续今天的工作。 这意味着下一代 AI 的核心竞争,可能正在从单纯的模型智能,进入一个更大的阶段: 系统智能。