ARTICLE · 1051368
腾讯开源了个看文档的高手:2B/4B小模型,OCR基准拿了第一
腾讯开源了个看文档的高手:2B/4B小模型,OCR基准拿了第一
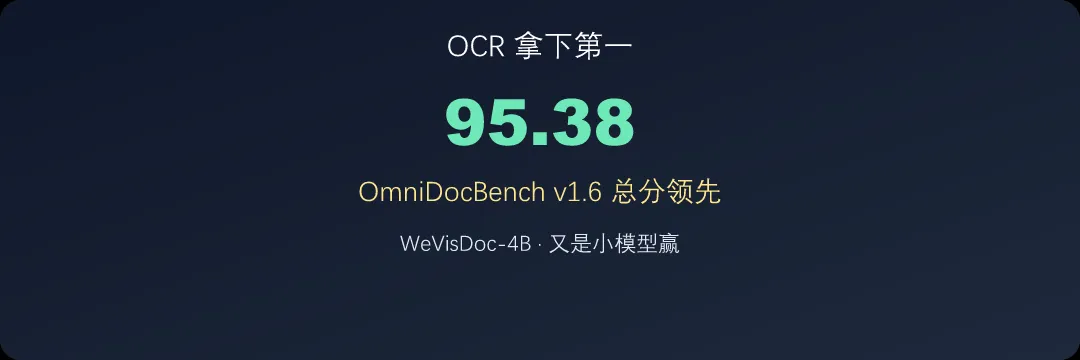
OCR拿下第一
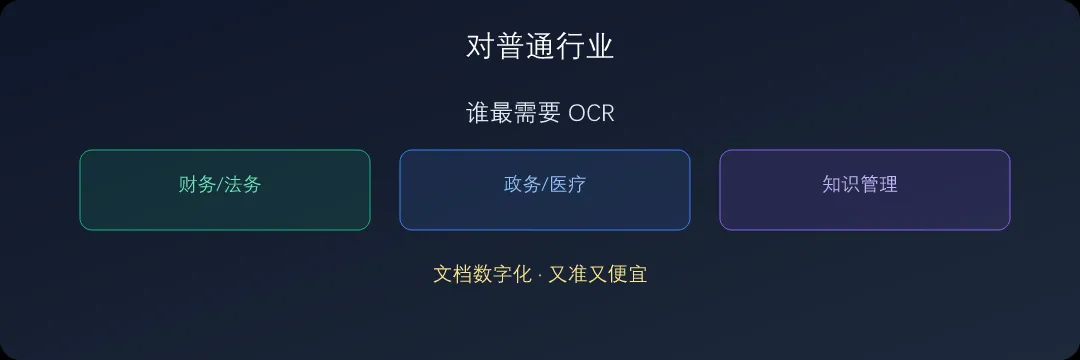
对普通行业
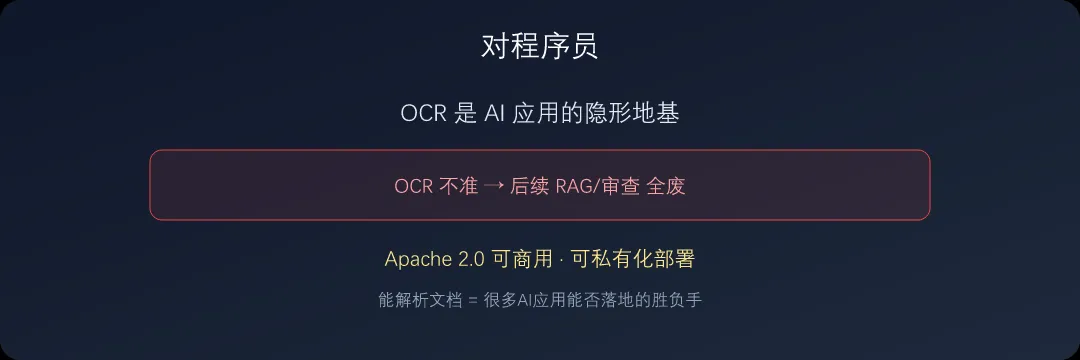
对程序员
前面几期聊的都是"生成"——生成图、生成视频、生成代码。今天这条是"读懂"——让 AI 真的看懂文档。而赢家,又是一个小模型。
01 发生了什么:小模型拿下 OCR 第一
Hugging Face 上架两款新 OCR 模型:腾讯的 tencent/WeVisDoc 与 Jina AI 的 jina-ocr-v1。
几个关键信息:
- • WeVisDoc:提供 2B 和 4B 两个版本,采用 Apache 2.0 许可(可商用)
- • 据 OmniDocBench v1.6 基准测试,WeVisDoc-4B 以 95.38 总分领先
"OCR"是什么? 就是让 AI 把图片/扫描件里的文字和版式"读出来"——这是文档数字化的地基。
值得注意的两点:
- • 又是小模型赢(4B 规模拿下第一)——延续了"小模型在垂直任务上打穿"的主线
- • Apache 2.0 许可——意味着企业可以自由商用,门槛低
02 对普通行业的影响:文档处理这件"苦活",要变轻松了
这条新闻,对"天天和文档打交道"的行业,是实打实的效率提升。
谁最需要 OCR:
- • 财务/法务:把扫描的发票、合同、报表变成可检索的数据
- • 政务/医疗:把纸质档案数字化
- • 企业知识管理:把一堆 PDF/图片资料变成能搜、能问的知识库
过去 OCR 的痛点: 复杂版式(表格、多栏、手写)识别不准,需要人工校对。
而"小模型 + 高分"意味着:
- • 准确率上来了(95.38 分,接近可用)
- • 成本下来了(4B 小模型,企业能自己部署)
- • 可商用(Apache 2.0,没有法律顾虑)
一句话:把纸质、图片文档变成"可用的数据",这件事正在变得又快又便宜。
03 对程序员的影响:OCR 是"AI 应用"的隐形地基,值得重视
对技术人,这条新闻提醒了一件事:OCR 不性感,但它是很多 AI 应用的地基。
为什么重要?
- • 你要做"企业知识库问答"(RAG),第一步就是把文档正确解析出来——OCR 不准,后面全废
- • 你要做"发票自动录入""合同智能审查",也都要先过 OCR 这一关
而"4B 小模型 + Apache 2.0 + 高分"意味着:
- • 你可以在自己的服务器上部署,数据不出域
- • 免费商用,成本可控
- • 可以针对自己的文档类型(比如特定票据)做微调
对程序员的启示: 做 AI 应用,别忽略"数据入口"这个环节。"能把文档准确、低成本地解析出来",是很多 AI 应用能不能落地的胜负手。
一句话总结
腾讯开源 WeVisDoc(2B/4B,Apache 2.0),在 OCR 基准拿下第一。对普通行业,是文档处理这件"苦活"变轻松、变便宜;对程序员,是 OCR 作为 AI 应用的隐形地基,值得重视。小模型又一次在垂直任务上打穿了。
👇 觉得有收获,点个「在看」。
关注「科技洞察助手」,效率这条线我持续追,下一篇拆"文档 AI 处理链,到底怎么搭才不出错"。
信源:无矩AI 9/21 速览、Hugging Face、OmniDocBench。数据基于公开基准;影响分析为综合判断。