ARTICLE · 1057451
华为全联接大会2026 | 为AI构筑算力底座,让昇腾释放生态动能
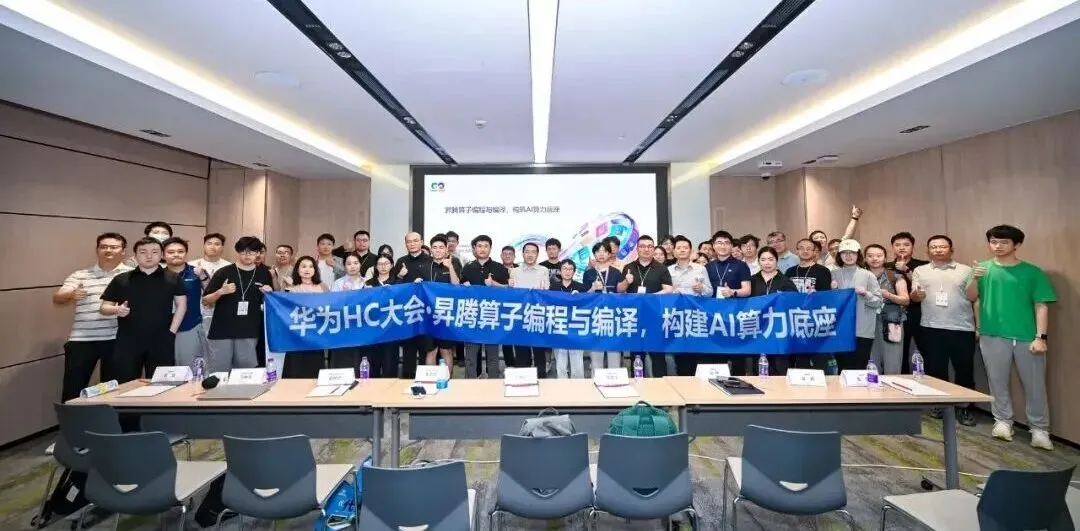
2026 年 9 月 19 日下午,「昇腾算子编程与编译,构筑 AI 算力底座」分论坛在世博展览馆举行。本场论坛汇聚来自华为、Triton-distributed 社区、上海人工智能实验室、北京智源人工智能研究院、中科加禾的技术专家,围绕 AscendNPU IR 编译体系、分布式通算融合、跨芯片统一 IR、智能编译与领域编程语言等核心议题展开深度分享,共同探讨如何通过算子与编译技术充分释放昇腾硬件算力,共建开放繁荣的昇腾开源生态。
昇腾开源软件生态专家吕坤在开场致辞中回顾,昇腾的性能优化已经从早期的「能不能跑」走到「跑得好不好」,如今进入编译优化的深水区。他提到昇腾在 Triton、AscendNPU IR 等方向的持续投入,并表示相关能力在某种程度上已达到一个拐点,希望与社区协同,在编译生态与性能优化上继续推进。
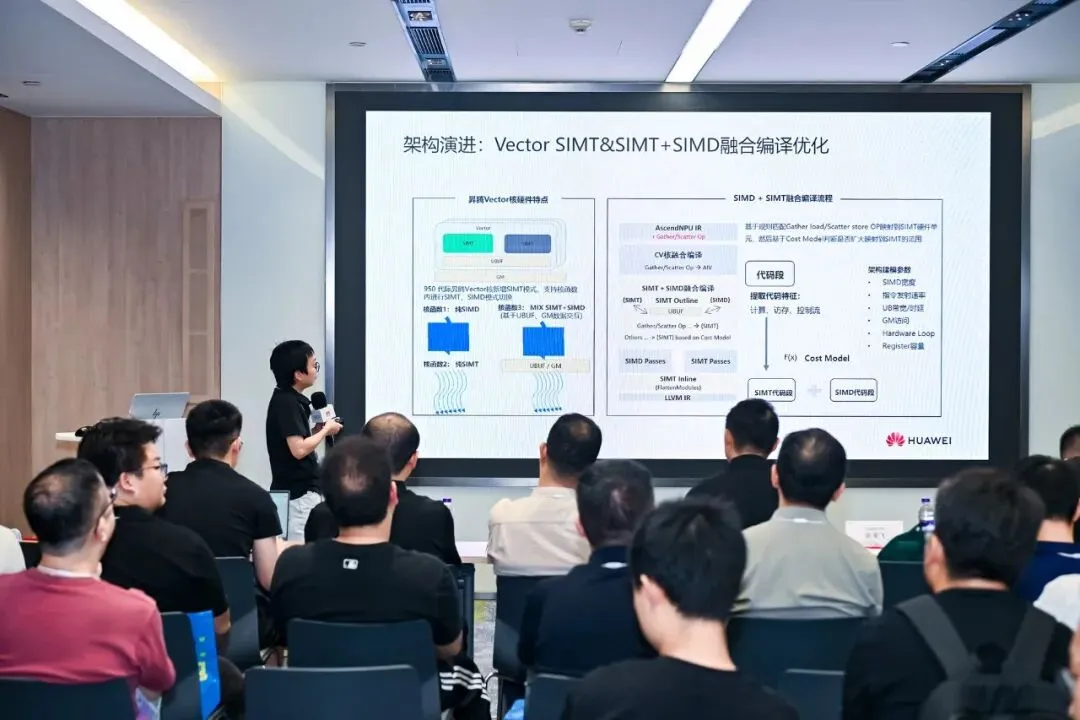
华为编译器与编程语言实验室 AscendNPU IR 架构师吴凌飞介绍了 AscendNPU IR 在架构演进与编译优化上的最新进展。在架构层面,AscendNPU IR 通过 HFusion、HIVM 两层 Dialect 支持多层抽象:HFusion 承接 Triton、FlagTree 等各类 DSL,做与架构无关的预处理;HIVM 面向昇腾硬件抽象,处理核间通信与同步、核内内存分配等。相比 A2、A3 架构,新一代 950 架构引入 Regbase 与 SMIT/SMID 能力,计算由寄存器承载、编译器实现了自动融合和向量化能力,带来「寄存器级融合」这一新的优化技术。吴凌飞介绍,寄存器融合的搜索空间很大,团队先后引入应融尽融、基于cost model的Max Parallel 与 UB-aware 等融合策略。
在性能优化上,吴凌飞分享了多项已落地的能力:AutoBlockify 通过将多次 launch 的开销压到 Kernel 内部,使部分关键算子性能提升约 6%;CV Pipeline 在 Cube 与 Vector 核之间做软流水;CV 1:2 切分支持 reduce 轴与动态 shape,使常用 CV 类算法性能提升约 30%。此外,还包括离散访存场景的 SIMT 能力、CV 间数据交互、transpose 冒泡下沉为单条 load+NDDMA 指令,以及 double buffer 等已在新版本上默认开启。他同时指出,VF 融合等优化存在「性能跷跷板」等难题,目前正在规划通过引入agent、cost model或PGO等反馈式优化来解决部分难题。
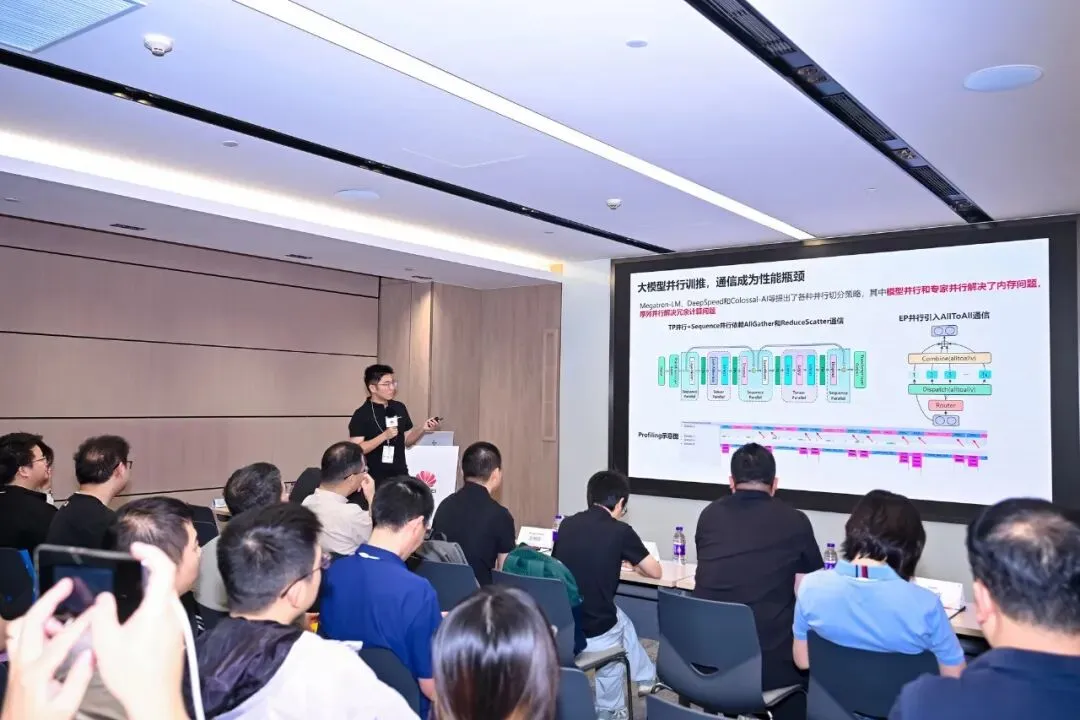
Triton-distributed-ascend 采用后一种思路,将 Tile 编程范式应用到分布式通算融合,并通过分布式 Swizzle 优化,让节点内各卡的通信链路都得到充分利用。在同步机制上,它同时支持全局同步与基于 wait-notify 的细粒度同步,后者能更精细地编排 Cube 与 Vector 的软件流水。据其分享,在 Ascend 950 上,针对 QKV、AllToAll、MoE 等通信与 Vector 融合场景,可带来约 1.5 倍、最高 1.9 倍的性能收益。目前,A2、A3、950 的节点内编程已完整支持,A2、A3 的节点间编程也已支持;下一步将推进 950 节点间 RDMA 编程、MegaKernel 支撑,以及 MegaMoE 等融合算子。
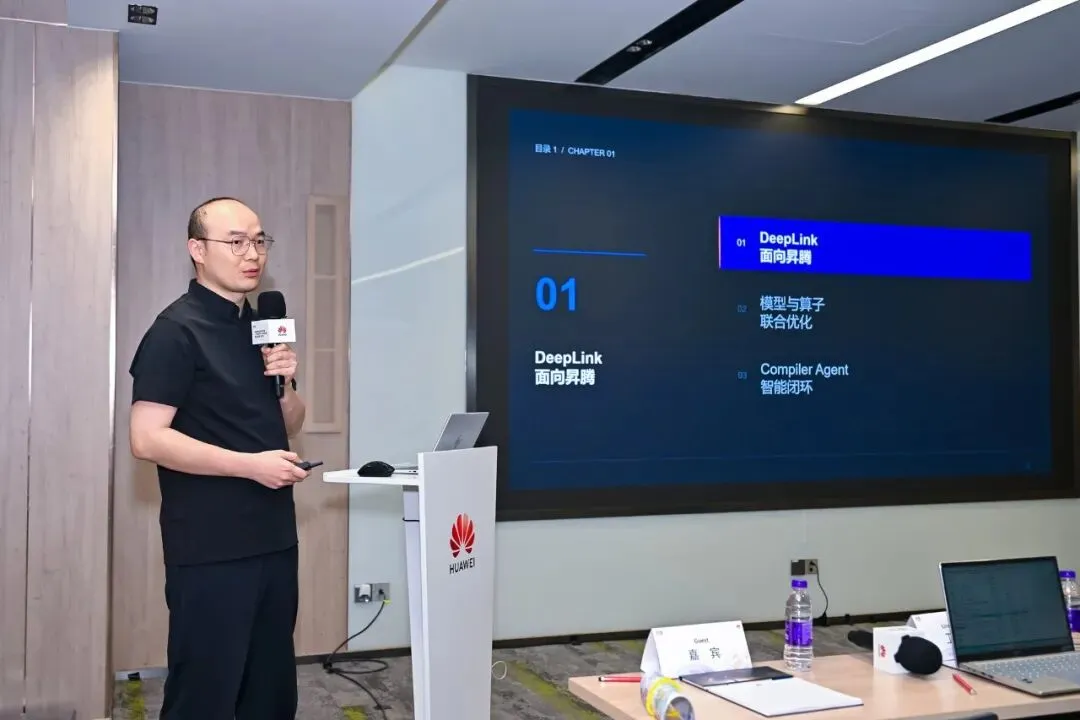
上海人工智能实验室 DeepLink 团队编译器技术专家赵朝兴介绍了 DLCompiler 面向昇腾的高性能编译与大模型智能优化工作。DLCompiler 基于 AscendNPU IR,在其上方提供 Triton DSL 优化、调度与后端硬件适配。赵朝兴提到,团队在 AscendNPU IR 开源之前就已尝试 Triton on Ascend,AscendNPU IR 开源后,相关工作才得以顺利开展。DLCompiler 提供从高层到 Low-level 的多级编程入口,并在核内调度、缓存、搬运访问与自动调优等方面做编译优化。
在模型与算子联合优化上,他以 Qwen3Next、DeepSeekV3 的 Attention Prologue 为例:这两款模型在 Attention 前有 matmul 与 RMSNorm/RoPE 交替执行,单 stream 下 Cube 与 Vector 计算资源难以同时利用。团队基于 Producer-Consumer 编程模型,把 Cube 与 Vector 放进同一个 Kernel 里最大化利用计算资源,其中 DeepSeekV3 三段融合取得约 1.7 倍的加速比。他同时分享了模型—编译器—硬件联合优化的闭环思路,并展望了 Agent 智能编译:让 Agent 直接生成底层代码,把开发者从手写算子中解放出来。
北京智源人工智能研究院编译器技术专家王明贵分享了面向多厂商芯片的统一 IR(FLIR)探索。他指出,当前 Triton 生态在多硬件适配中普遍存在重复建设问题:各硬件后端均独立维护 Lowering 路径,Tile 级分析、访存优化等公共优化逻辑需在每套路径重复实现,工程成本随后端数量持续攀升;不同架构的执行模型、数据搬运逻辑差异显著,新硬件后端切入成本高,缺乏标准化接入规范,接入时往往需要从零设计整套 Lowering 路径。
针对上述问题,FLIR 以 Tile 级抽象构建统一编译中间层,在 Triton 前端与厂商后端 IR 之间提供统一的优化接口:将访存合并、Tile 融合、布局传播、内存规划、软件流水线等公共优化 Pass 上移至 FLIR 层复用,而与硬件深度绑定的特性优化,则交由各厂商自有 IR 落地实现。
在具体落地上,FLIR 对下可适配不同架构的后端 IR:通用计算架构侧可复用成熟的编译基础设施,而以昇腾为代表的 DSA 架构侧,则直接对接 AscendNPU IR —— 由 FLIR 层完成跨架构通用的 Tile 级优化,再下沉到 AscendNPU IR 完成布局转换、VC 流水编排等硬件专属优化,既保证了公共优化能力的统一复用,又能充分释放硬件架构特性。他同时介绍了 Helion 对接与 Agent for Compiler 的后续规划。
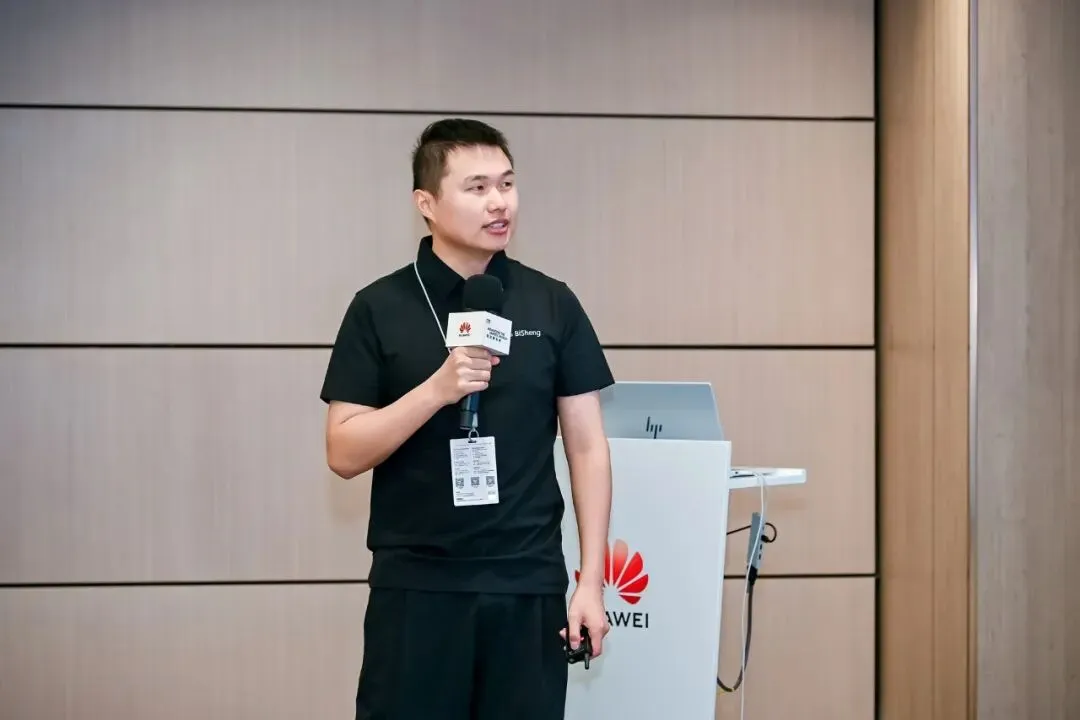
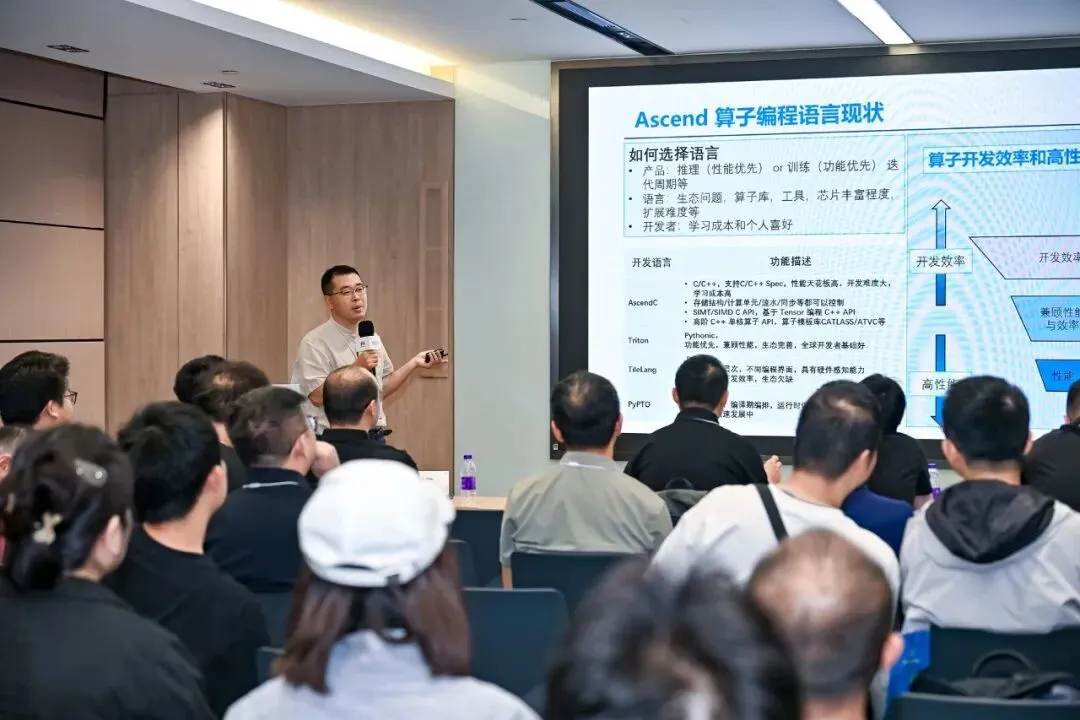
中科加禾研发总监朱天阳介绍了面向 Ascend 的领域编程语言 Triton-TLE 的设计与实践。他分析了昇腾上算子开发语言的现状与取舍:Ascend C 性能天花板高但开发与学习成本高,Triton 功能优先、生态完善,他提到智源主导的 FlagGems 算子库已达 800—900 个算子,是全球规模最大的算子库之一,TileLang、PyPTO 则兼顾性能与效率。在他看来,Triton 当前的挑战主要有三点:一是对 DSA 架构支持不足;二是本质上仍是算子编译器、不支持跨算子的系统层面编程;三是通信与流水编排等新特性演进较慢。但从工程落地角度看,Triton 具备开发效率高、优化见效快的特点。他以 GLM-5.3-Flash 模型推理优化为例说明:仅在 Triton 算子层面优化,用 2 人天就把吞吐提升了一倍以上,TPOT 也明显改善。他指出当前算子编程语言的2种趋势“向下走”和“向上走”,Triton/Tilelang/PyPTO等高层语言通过暴露硬件能力“向下走”提高语言性能,Ascend C等语言通过 Pythonic “向上走”增强语言易用性,同时编程语言开始突破算子边界,向系统层面的编程语言演进。
在实践上,他介绍了与智源联合设计的 Triton-TLE 三层扩展(TLE.LITE/ TLE.DSA / TLE.GPU),以及 TLE.PIPE(流水编排)、TLE.DIST(分布式原语)、TLE.RAW(OP 扩展框架)三类原语扩展,目标是在减少算子分叉的同时兼顾性能与开发效率。他总结了Triton-TLE 目前进入的一系列编译优化方法,包括FIXP 到 L0C 通路、GM 到UB和L1的高效Gather、L2 Bypass、别名分析、计算强度优化等,使TopK/LightningIndex/chunked_gated_delta_rule_fwd/Grouped_matmul 等关键算子性能都接近或超过Ascend C 版本。
本次分论坛从多元算子体系、分布式通算融合、跨芯片统一 IR,到智能编译与领域编程语言,完整地呈现了昇腾在算子编程与编译现阶段的生态建设成果。算力价值的释放,离不开硬件与编译软件栈的双向协同。硬件提供算力基础,而算子、编译软件栈很大程度上影响着硬件能力的实际落地效果。未来,期待更多开发者参与到昇腾开源社区当中,共建技术、共享实践,共同推进 AI 编译技术的产业落地。
点击底部「阅读原文」,访问大会官网,查看更多大会信息。
扫码添加编译小助手微信,邀请您加入微信交流群