ARTICLE · 1058396
中科逸视智能文档抽取系统:融合OCR与大模型,为企业合同全生命周期管理装上智能引擎
中科逸视智能文档抽取系统:融合OCR与大模型,为企业合同全生命周期管理装上智能引擎一份企业合同,看着是几页纸,背后藏着合作主体、金额、履约周期、违约责任等几十项关键信息。在很多企业里,法务、采购人员依旧要逐字翻阅、复制粘贴、手动录入台账。遇上扫描件、老合同、盖章压字、格式五花八门的协议,人工处理不仅耗时耗力,还很容易漏掉关键细节,埋下合规风险。 中科逸视(北京)科技有限公司的智能文档抽取系统,正是瞄准这一企业痛点,把AI 的 “火眼金睛” 和 “理解大脑” 结合,让机器不再仅仅识别文字,而是真正读懂合同内容,为企业合同全生命周期管理装上智能引擎。 
黑科技拆解:OCR 做眼睛,大模型当大脑,看懂合同分两步走 很多人以为AI 读合同,就是简单的文字识别。事实上,单纯 OCR 只能 “看见字”,却看不懂文字背后的含义。就好比机器可以认出纸上写着 “合同总价款五百万元”,但未必知道这串数字就是这份协议的核心金额字段。中科逸视智能文档抽取系统采用**OCR 视觉识别 + 领域大模型深度融合**的双引擎架构,完成从图像文件到可分析结构化数据的完整蜕变。 第一步:OCR 视觉引擎,搞定各种“不完美”合同 这相当于整套系统的一双眼睛。 企业真实场景里的合同文件五花八门:有扫描复印的纸质旧合同、拍照的传真件、盖章盖住部分文字、文档倾斜、光线昏暗、附带手写签名批注。传统识别工具碰到这类文件很容易“翻车”。 系统采用CNN‑Transformer 混合架构的深度学习 OCR 模型,先做图像预处理:自动把歪斜文档摆正、去除噪点、修复印章遮挡造成的文字缺损,把模糊的文件做增强优化。随后检测定位每一行文字、表格区块,完成字符识别。 它不只是输出一堆零散文字,还同步记录每个文字的坐标位置、段落、表格布局等空间信息。通俗来讲,它不光知道写了什么字,还记住标题在哪、表格在哪、哪一段是付款条款,把整篇合同的“版面骨架” 完整保留下来,为后续理解语义打下基础。印刷体文档识别准确率可达 99.5% 以上,面对印章压字、手写批注等复杂场景也具备很强适配能力。 第二步:大模型语义理解,实现从“认字” 到 “读懂” 拿到OCR 输出的文字与版面信息之后,就轮到大模型这个 “大脑” 上场。 过去传统方案,大多依靠人工编写规则模板,合同格式一变,规则就失效,每一类新合同都要大量标注训练,维护成本很高,泛化能力弱。 中科逸视的方案采用参数高效微调技术,基于少量企业真实合同样本,就能让模型学习合同语言逻辑。结合版面空间信息,模型会理解上下文语境:自动分辨哪一家是甲方、哪一家是乙方;区分“甲方付款” 还是 “乙方付款”;在杂乱表格、分散附件里,定位出合同金额、履约期限、违约责任、交付条件等关键信息。 打个比方:OCR 相当于把一本纸质书扫描转录成电子文字;大模型则像一位熟读各类合同的法务助理,读完之后自动摘出签约双方、金额、时间、风险要点,整理成一条条清晰条目,直接输出结构化数据,不用人再一页页翻找。 整套流程打通:文档上传→图像修复识别→版面解析→语义抽取→结构化结果输出,实现端到端自动化处理。 它能解决哪些实际问题 不挑模板,少量样本就能上手 新合同旧合同通吃 表格和手写内容也能稳住 做逻辑校验,少出错 把人从重复劳动里解放出来: 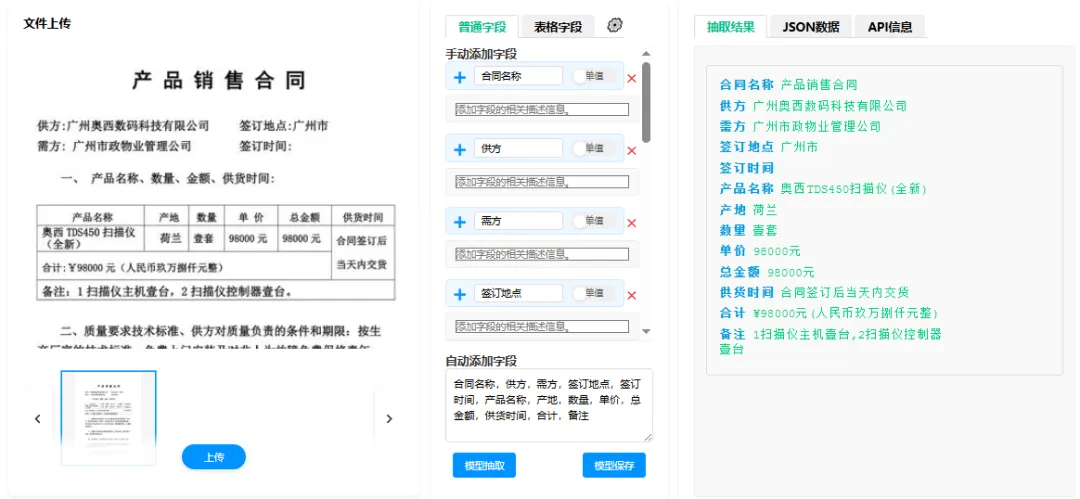
在合同管理里能怎么用 快速建合同台账 盘活存量历史合同 辅助审核和版本比对 风险筛查,给合规兜底 数字化时代,企业的合同不应该只是一份归档文件,更是宝贵业务数据。中科逸视智能文档抽取系统,依靠OCR 视觉能力与大模型语义理解的融合,解决了 “机器看得见文字,却读不懂合同” 这一行业难题。它不是要替代法务人员,而是把人从海量重复摘抄、录入工作中解放出来,让 AI 做信息搬运,让人专注判断与决策,帮助企业把合同管理做得更高效、更严谨。
不用堆海量标注数据,拿少量合同样本就能自定义要提取的字段。不管标准采购合同、服务协议,还是格式很自由的合作框架,都能适配,企业不必为每一类合同单独开发一套,落地成本低。
支持PDF、扫描件、图片、电子文档等各种输入。仓库里堆了几年的纸质旧合同扫描件,也能批量完成数字化提取,把压在柜子里的老合同变成数据库里能检索的数据。
合同里的价格明细、清单表格常有合并单元格、跨行跨列,系统能还原出表格逻辑;手写的签名和补充批注也做增强识别,手写改过的关键内容不会被漏掉。
模型会结合上下文做简单核对,比如比对合同总金额和分期付款明细对不对得上,发现矛盾就提醒。结果能输出成JSON 等格式,对接企业的 ERP、OA 或合同管理平台,数据直接流转过去。
信息自动抽出来后,法务不用再反复复制录入,可以把时间花在风险研判、条款谈判这类更要紧的事上,而不是耗在摘抄信息这种机械活里。
采购、业务线合同源源不断,过去靠人工整理Excel 台账,又慢又容易错。系统批量处理合同,自动抓出合同编号、签约主体、签署日期、金额、有效期、付款节点等字段,直接生成标准化台账。几百份合同很快就能归集完,后面统计、检索、到期提醒都方便,再不用翻文件夹找合同。
很多公司档案室堆着大量纸质旧合同,查都没法查、更别说统计。扫描上传后,系统批量抽信息,把非结构化的纸质档案变成能查能统计的数据,回过头做历史履约复盘、供应商风险分析,沉睡的文档才算真正用起来。
合同来回改过好几轮后,系统抽两份文档的关键信息,快速定位条款差异,重点标出金额、权责、期限这些改过的地方,帮法务揪出隐蔽的修改,不用再一行行人工比对。
系统能定向抽取违约责任、保密义务、争议解决这类重点条款。企业可以批量扫一批合同,迅速锁定有特定风险表述的文件,把人工核查的范围缩到最小,提前发现隐患。