ARTICLE · 1064220
OpenAI,被起诉!
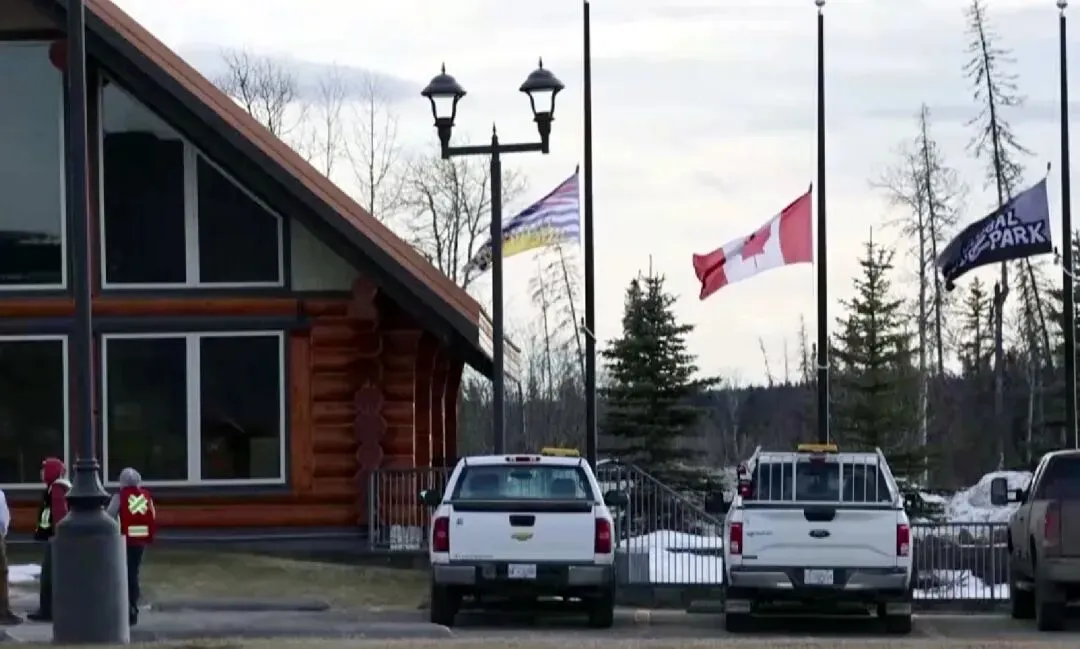
2026年9月21日,加拿大不列颠哥伦比亚省政府在美国加州联邦法院起诉OpenAI及其首席执行官萨姆·奥尔特曼,将今年2月发生的塔布勒岭校园枪击案再次推到全球舆论面前。当地政府指控,枪手在袭击前曾使用ChatGPT策划暴力行动,其账号早在2025年6月就被OpenAI内部系统标记,安全人员据称曾建议联系警方,但公司最终只采取了封禁账号的措施。2026年2月10日,18岁的杰西·范鲁特塞拉尔在家中杀害母亲和继弟,随后前往学校行凶,造成包括枪手在内9人死亡。
真正值得追问的,并不是一句“ChatGPT导致了枪击案”能否成立,而是一个更加复杂的问题:当一家AI公司已经掌握了用户可能实施现实暴力的危险信号,却没有采取进一步行动,那么这家公司究竟只是一个被犯罪者利用的技术平台,还是已经成为必须承担相应注意义务的产品提供者?
这也是此次诉讼最重要的地方。按照不列颠哥伦比亚省提交的诉状,问题并不止于枪手使用过ChatGPT,而在于OpenAI是否“看见了危险,却没有及时处理”。如果相关指控最终得到法院证实,那么争议的核心就从模型回答是否安全,进一步进入企业内部决策机制:谁发现了风险,谁拥有升级处置的权限,什么情况下必须通知执法部门,又是谁最终决定不通知?
这类问题之所以棘手,是因为生成式AI与传统互联网产品存在明显差异。搜索引擎主要提供信息索引,社交平台主要连接人与人,而大型语言模型能够持续参与用户的思考过程。它能够记住上下文、理解语义、回应情绪,也能够在连续对话中逐渐获得一个人的信任。于是,一次看似普通的问题,与前后几十轮对话结合起来,可能呈现完全不同的风险含义。
OpenAI自己也已经承认,危险信号有时并不出现在单独一句话中,而是随着长期对话逐渐显现。公司2026年5月公布的安全更新就明确提出,要增强模型识别跨消息、跨对话风险的能力,并针对伤害他人的高风险情形加强安全干预。
恰恰因此,塔布勒岭案件暴露出的并不是一个简单的“AI会不会说危险内容”的问题,而是安全机制能否真正形成闭环。拒绝回答暴力问题,只是第一道防线;识别危险用户,是第二道防线;发现真实世界威胁之后怎么办,则是完全不同的第三道防线。封禁账号、阻止重新注册、保存相关记录、人工复核、联系平台之外的公共安全机构,每一步都涉及技术、隐私、法律责任和人身安全之间的艰难平衡。
更值得注意的是,枪手在账号被封之后,据诉讼文件所称,又注册了新的账号继续使用ChatGPT。 这意味着单纯的“封号”并不等于风险已经消失。对于普通违规行为,平台封禁或许足够;但对于可能涉及现实暴力的严重风险,如果系统能够识别同一用户反复规避限制,那么安全机制是否应该进一步升级,就成为无法回避的问题。
当然,法律责任不能仅凭悲剧发生后的结果倒推。枪击案的直接实施者仍然是犯罪行为人,AI究竟在多大程度上影响了其行为,也必须通过证据和司法程序确认。OpenAI则表示,公司禁止利用其服务实施暴力,并称只有当对话显示存在“迫在眉睫且可信的伤害他人风险”时才会通知执法部门。公司此前还向加拿大政府表示,如果当时被封禁的账号按照今天强化后的标准重新评估,将会被转交执法部门。
问题因此变得更加深刻:安全标准究竟应该以什么为尺度?如果标准过低,普通用户的隐私和正常表达可能被过度监控;如果标准过高,等到风险已经足够明确时,可能又错过了最重要的干预窗口。AI公司不可能成为警察,也不可能仅凭算法预测一个人一定会犯罪,但这并不意味着企业可以把所有现实风险都归还给用户和社会承担。
此次案件已经不是孤立事件。在不列颠哥伦比亚省政府起诉之前,已有数十名受害者家属、学生及其他受影响者在美国加州提起相关诉讼。9月2日,又有约30起新的诉讼被提交。 当越来越多案件开始把问题带入法院,AI行业真正面对的已经不只是赔偿金额,而是责任边界本身。
过去,技术公司常常强调“平台中立”:工具被谁使用、如何使用,并不完全由平台决定。但当AI从被动工具变成能够持续对话、分析意图、生成内容甚至参与决策的系统以后,这种传统的责任划分正在受到挑战。能力越强,意味着平台能够识别的风险也可能越多;而识别能力越强,却仍然选择不采取行动,就越难简单地把责任推回用户个人。
这场诉讼最终会如何判决,需要等待证据、专家意见和司法程序给出答案。但无论结果如何,一个新的时代问题已经摆在AI产业面前:未来的安全标准不能只回答“模型有没有拒绝危险请求”,还必须回答“当系统已经发现危险时,企业究竟应该做到哪一步”。
