ARTICLE · 1065173
AI要真正办事,怎么把接口谈下来?
它得接学校业务系统。
学生问:
我的请假批到哪一步了?
AI要查学工系统。
学生说:
帮我把请假信息填好,我确认后提交。
AI还要调用系统写入数据。
于是学工部或辅导员找到信息中心:
我们希望智能体接入学工系统。
最常听到的回答可能是:
涉及学生数据,有信息安全风险。
那应该怎么谈?
不是告诉信息中心“AI很先进”。
而是把问题换成:
在法律法规和学校现有安全体系下,怎样让AI合法、合规地完成学工业务?
法律不是简单地说“数据不能用”
学工部首先自己要有底气。
《个人信息保护法》第一条除了保护个人信息权益、规范个人信息处理活动,还明确提出:
促进个人信息合理利用。
第六条进一步要求:处理个人信息要有明确、合理的目的,与处理目的直接相关,并采取对个人权益影响最小的方式。
《数据安全法》则要求实行数据分类分级保护,并建立全流程数据安全管理制度。
所以法律要求的不是:
学生数据一律不能用。
而是:
为什么用、谁来用、用哪些、用到什么程度,要设计清楚。
教育部《关于加强新时代教育管理信息化工作的通知》还明确提出解决“数据共享不畅”等问题,推动统一身份认证、集中授权,并提出:
“以共享为原则、不共享为例外。”
安全和共享,本来就不是二选一。
和信息中心第一次谈,可以直接这么说
不要问:
能不能把学工数据开放给AI?
可以直接说:
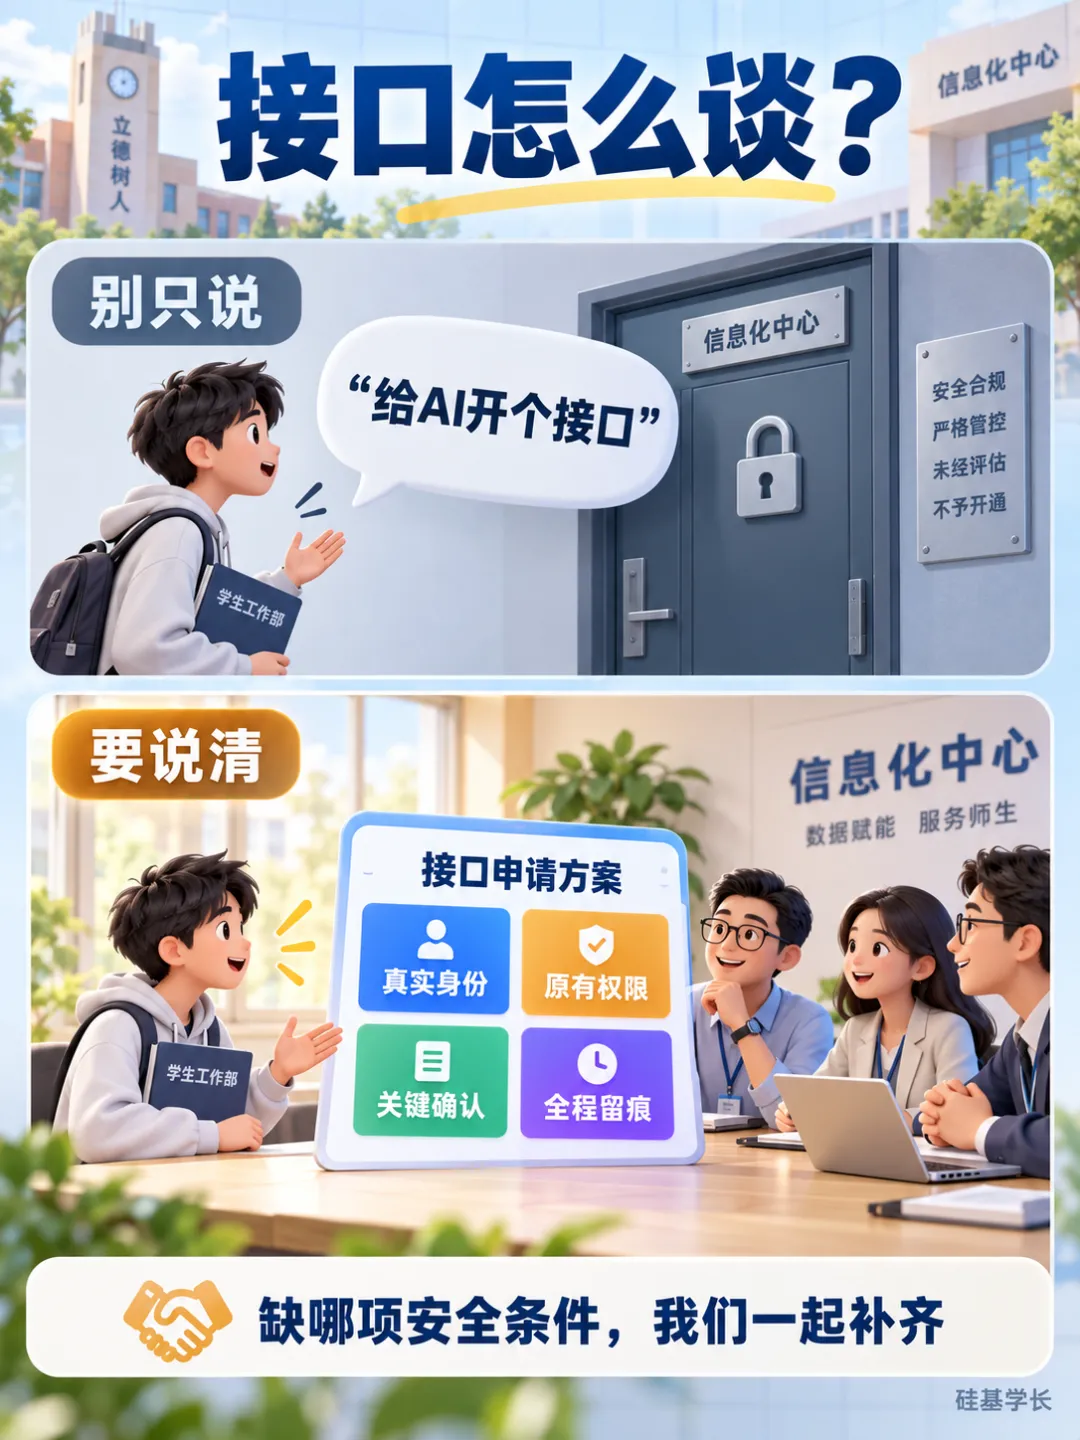
我们不是申请把学工数据库交给大模型,也不是要求AI绕过现有权限。学工部的目标是开展学工服务全流程AI化改造,把现有系统里的查询、填报、提交、流转、提醒等能力,按照学校原有身份认证和权限体系提供给智能体调用。AI每一次操作都对应一个真实登录用户,后台继续按照这个人的身份和业务权限判断能不能做;关键操作由本人或老师确认,所有调用全程留痕。请信息中心按照学校现有数据管理和安全要求,和我们一起确定接口、权限和数据流向。如果目前不能实现,请明确还缺哪一项安全条件,我们共同解决。
这和一句:
给AI开个接口。
完全不是同一个需求。
全流程AI化,不等于给AI一个超级账号
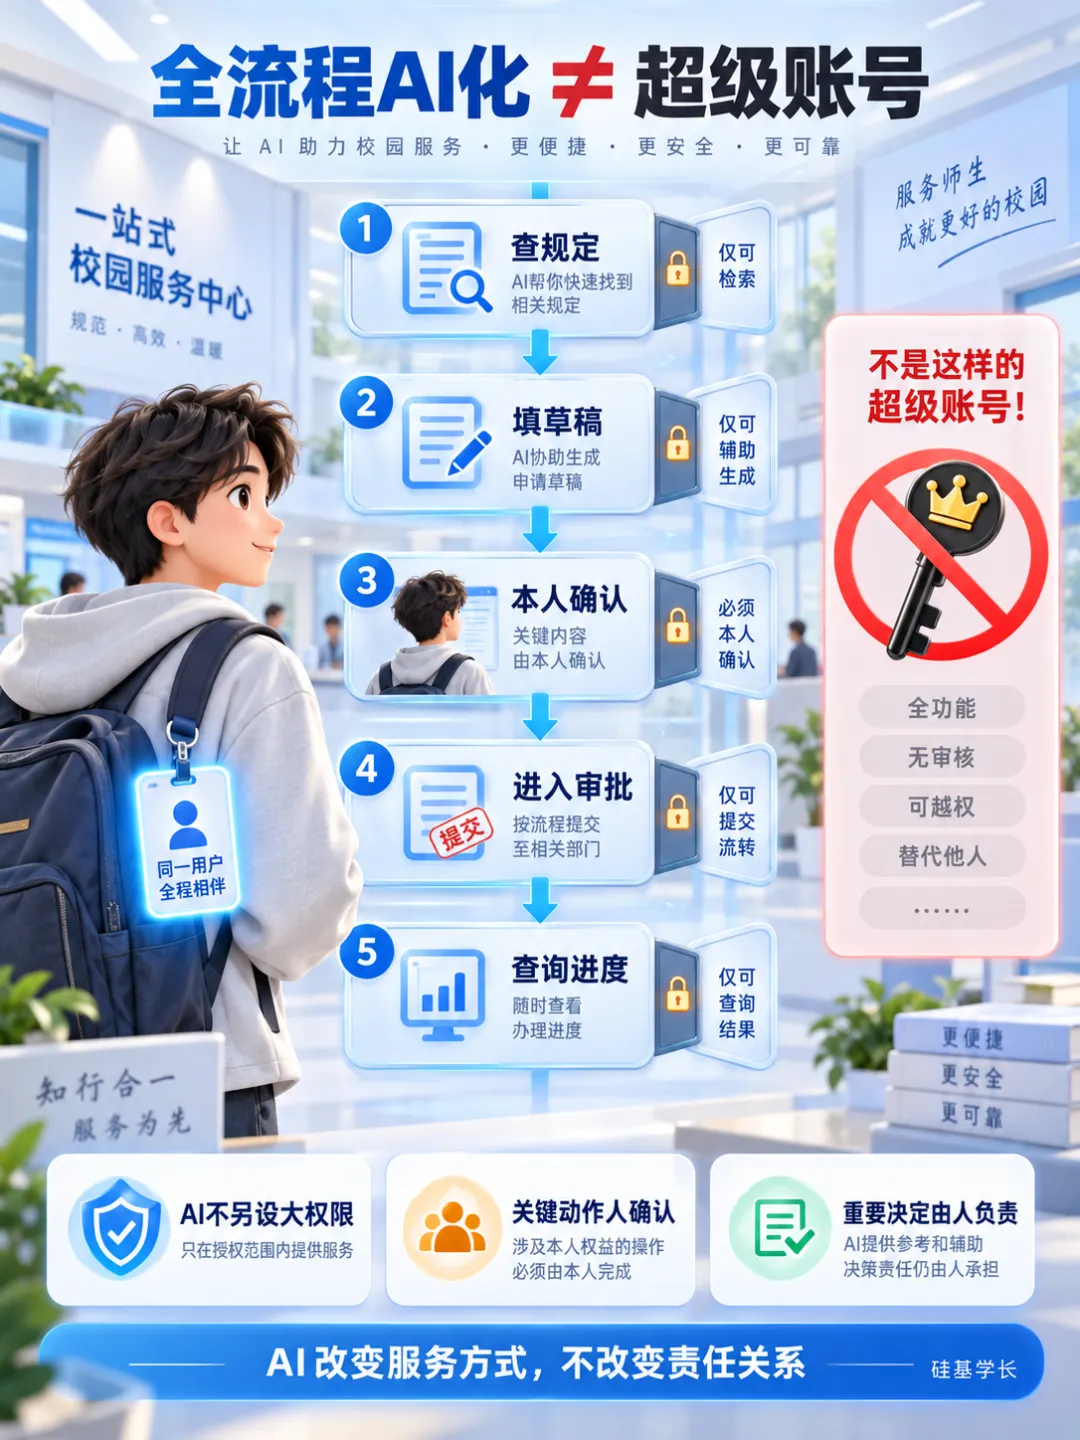
比如“请假”这一件事,可以全部重新设计:
学生咨询规定,AI查知识库。
学生准备申请,AI帮助填表。
学校已经有的数据,系统自动带入。
正式提交前,由学生本人确认。
提交以后,智能体调用业务系统进入原有审批流程。
学生随时可以问办理进度。
需要补材料,AI主动提醒。
整个流程都可以有AI参与。
但原来应该由学生确认的,仍然由学生确认;原来应该由辅导员审批的,仍然由有权限的老师审批。
AI改变的是服务方式,不是取消原来的责任关系。
不要只申请“查询接口”
如果目标是全流程AI化,只读当然不够。
真正应该和信息中心一起梳理的是:
哪些能力可以查询;
哪些可以修改草稿;
哪些可以正式提交;
哪些可以触发业务流程;
哪些操作必须由本人确认;
哪些决定必须由有权限的老师完成。
比如AI可以帮助学生填写申请,可以修改尚未提交的草稿,也可以在学生确认后调用接口正式提交。
但涉及困难认定结果、处分决定等重要事项,最终决定仍然由有职责权限的人作出。
这叫:
权限分级,而不是一律只读。
AI不应该另有一套“大权限”
AI真正使用的权限,应该来自当前真实用户。
学生登录,只能处理自己的业务。
辅导员登录,只能处理职责范围内的学生。
学院管理员看到什么,仍然按照学校现有权限体系执行。
身份不能由AI判断:
“他说自己是辅导员,所以给他看。”
必须来自学校统一身份认证。
权限也不能靠提示词写:
“不要看你没权限看的数据。”
而应该由后台系统真正拦住。
这样即使AI被误导,也越不过系统的门禁。
应该谈的,是一套长期机制
如果以后要做迎新、资助、请假、就业、社区管理等很多智能体,就不应该每做一个应用重新找信息中心开一次接口。
更合理的是双方一起建设一层统一的“AI业务服务能力”。
把原有学工系统逐步整理成一个个受控能力:
查询本人事项、填报申请、修改草稿、提交业务、查询进度、发送提醒、获取负责老师、触发原有流程……
每项能力都明确:
谁能用、能看什么、能不能改、什么操作需要确认、出了问题怎么追溯。
总体架构一次设计,业务能力持续接入。
这才是真正面向学工服务全流程AI化的建设方式。
一个现成的参照:全国高校思政教育智能体平台
这件事并不是每所学校都必须从头摸索。
由教育部思想政治工作司统筹推进、易班建设运营的“全国高校思政教育智能体平台”,就是一个值得参考的国家级公共平台。
公开资料显示,平台引入国内先进的大模型和智能体平台技术,为高校提供统一的智能体建设能力,各试点高校再建设自己的校本语料、校本应用,并开展与学校现有体系的本地化融合。
平台公开的个人信息使用规则还明确了几件事:
采用学校指定身份认证平台的单点登录;
个人信息按照最小必要原则处理;
境内收集的个人信息存储在境内;
采取加密、访问控制、去标识化等安全措施;
并已通过国家网络安全等级保护三级测评和备案。
这意味着,学校和信息中心讨论的重点,不必变成:
“我们敢不敢自己再造一个大模型平台?”
完全可以换成:
“学校现有业务系统,怎样在本校身份和权限体系下,安全地接入国家统一平台提供的AI能力?”
这里尤其要分清两件事。
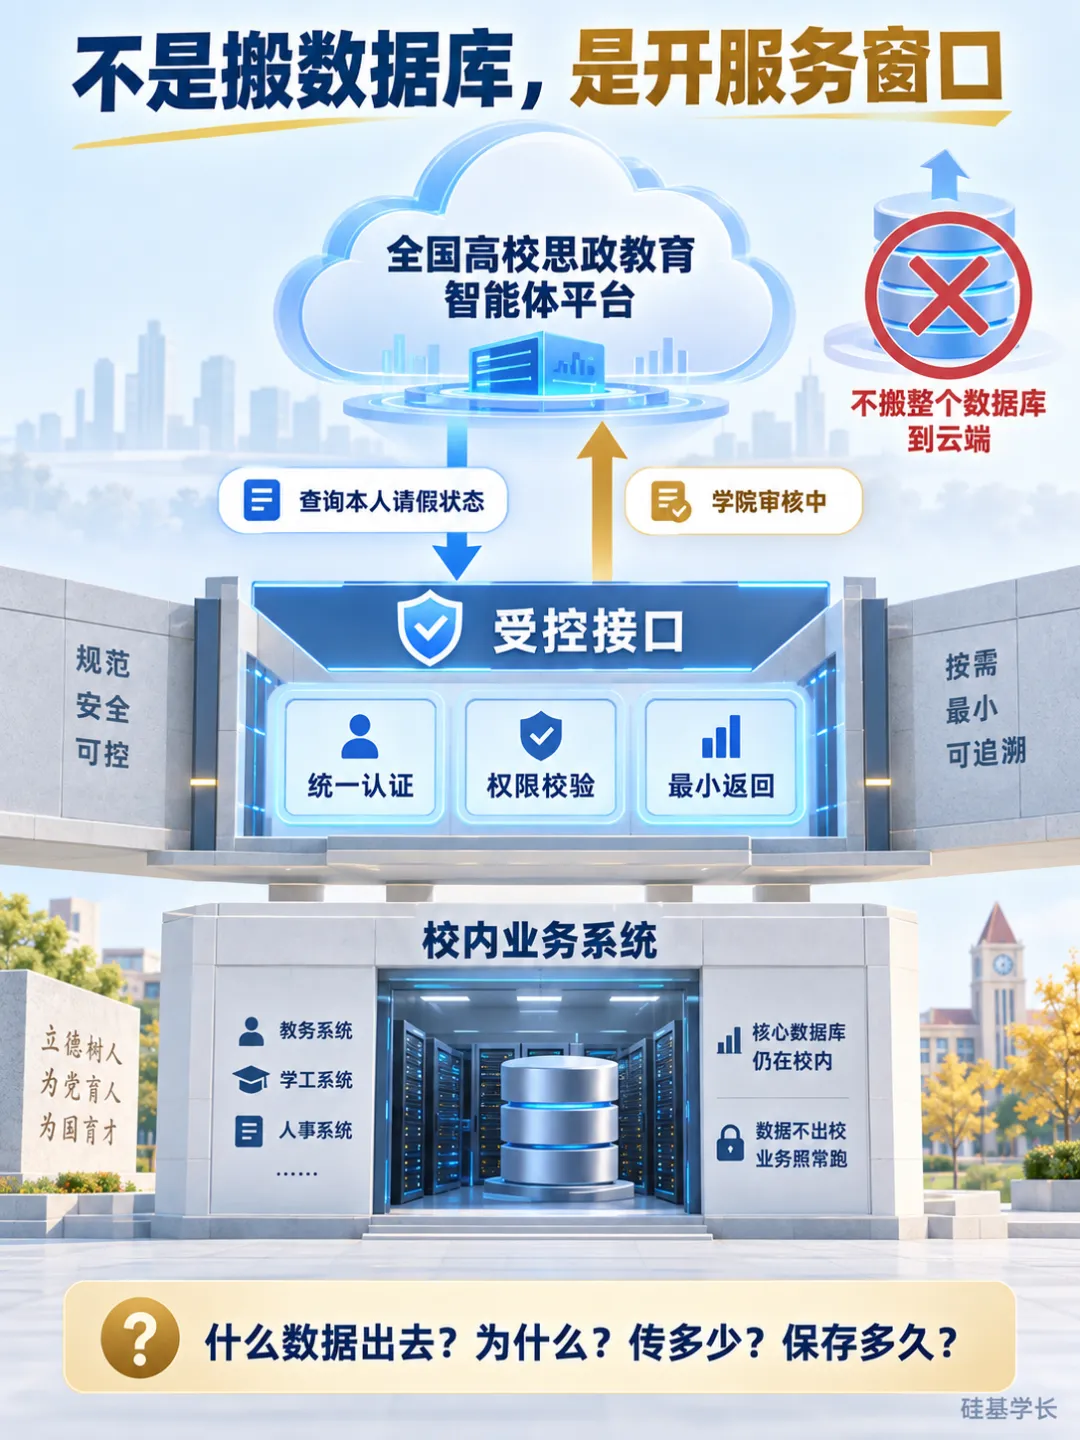
接入国家平台,不等于把学校整个学工数据库搬到云上。
更合理的接口架构应该是:
学校核心业务数据继续由校内业务系统管理和计算。
国家平台上的智能体需要办理某件事时,通过受控接口发起请求。
学校系统根据当前登录人的身份和权限,在本地完成查询或业务处理。
再把完成这一次任务所必需的结果返回给智能体。
比如学生问:
我的请假到哪一步了?
国家平台上的智能体不需要拥有整张学生数据库。
它只需要发出:
当前登录学生,请查询本人这条请假申请的状态。
校内系统完成身份校验和查询后,只返回:
学院审核中。
不是把一座仓库搬上云,而是给国家平台开一个有门禁的服务窗口。
具体每一类数据是否进入模型、以什么形式返回、是否需要脱敏或去标识化,还应根据学校制度和具体技术架构由信息中心、安全部门共同确定。
这样和信息中心谈,“数据上云”也就不再是一个笼统的问题。
真正应该逐项确认的是:
什么数据离开校内系统?为什么需要?传多少?传到哪里?保存多久?能不能进一步减少?
说句大实话:国家级平台的安全性,远胜于学校自建系统。信息中心往往心里惦记的是自己管辖的边界。
如果信息中心还是说“有安全风险”
这时可以很明确地继续问:
我们认同安全要求,请具体指出目前不满足的是哪一项?
如果是身份不可信,就接统一认证。
如果是权限过大,就做角色和业务权限控制。
如果是数据不应进入外部模型,就调整接口返回内容、脱敏方式。
如果担心AI乱操作,就增加本人确认、审批权限、调用频率控制、异常告警和全过程记录。
如果属于较高风险的个人信息处理,就按照学校制度开展相应的安全评估和个人信息保护影响评估。
安全问题应该对应具体的安全措施,而不是自动变成“AI不能做这项业务”。
当然,如果确实存在法律、学校制度或现有技术条件无法满足的要求,就先把这个条件补齐,而不是绕过去。
学工部最后可以带着这段话去谈:
我们不是要求因为做AI就降低信息安全标准。我们希望把AI纳入学校现有的信息化和数据治理体系,在统一认证、分类分级、权限控制和全过程审计的基础上,对学工服务流程进行AI化改造。AI使用的是师生原本就拥有的业务权限,不另设超级权限;学校核心业务数据仍由原业务系统管理,通过接口按场景提供完成任务所必需的能力。全国高校思政教育智能体平台已经提供了国家统一的AI能力和安全治理基础,我们希望在这个基础上重点解决校内业务系统如何合规接入。如果现在还不能实现,请明确缺少的是认证、权限、接口、安全还是制度条件,我们一起把条件补齐。
这时候双方讨论的已经不再是:
“AI能不能碰学校数据?”
而是:
“学校如何在既有安全体系内,把学生工作服务逐步升级成AI时代的新服务方式?”
我是硅基学长,为你使用AI提供技术支持。