ARTICLE · 1066518
AI 时代的软件开发方法论:从“会写代码”走向“可落地交付”
AI 时代的软件开发方法论 · 可落地交付
当 AI 把编码成本大幅压低之后,真正拉开差距的,不再是“能不能快速做出一个 Demo”,而是能否把复杂业务梳理清楚、把规则沉淀清楚、把结果验证清楚,并最终稳定交付到真实项目中。
编码变快之后,瓶颈转移到需求定义、规则沉淀、测试验证与工程治理
ROADMAP
01
PART
为什么传统开发方法在 AI 时代不够用了
WHY
传统软件工程默认一个前提:人是主要生产者,工具负责辅助执行。因此,项目周期里大量时间花在需求梳理、资料搜集、代码实现、反复调试、文档补齐上。
AI 出现以后,这个前提被改写了。现在一个 Agent 在较短时间内就能完成调研、拆解、编码、测试、文档等大量工作,表面上看,交付速度明显提升;但与此同时,另一个问题被迅速放大:
AI 可以非常快地做出一个“像样的东西” 但不代表它真的理解了业务,也不代表这个结果可以稳定落地。
这也是很多项目容易出现的情况:一两天做出一个功能齐全、页面漂亮、流程完整的 Demo,但只要追问业务规则、数据来源、边界条件、异常处理和验证逻辑,系统就会迅速暴露出“花架子”的本质。
02
PART
AI 时代开发的核心变化
SHIFT
过去的重点
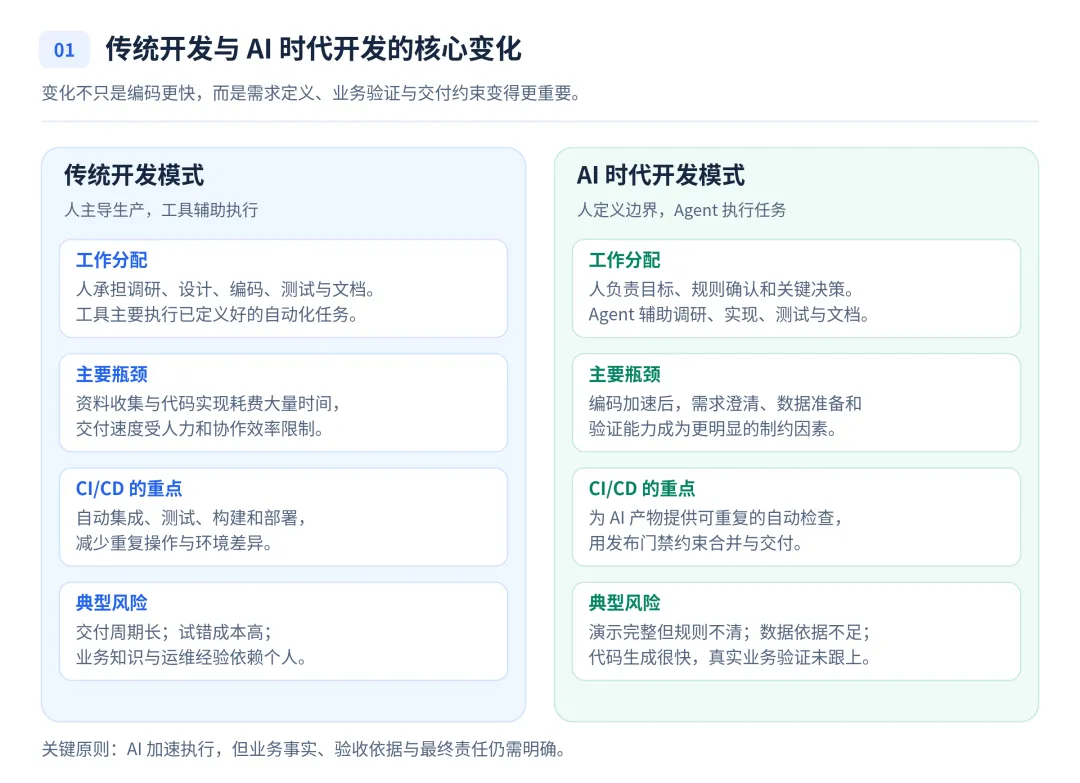
过去最难的是“做出来”。代码量大、调试周期长、资料分散,团队交付速度主要受人力限制。
现在的重点
现在最难的是“做对、做稳、做得能落地”。编码变快之后,真正的瓶颈转移到需求定义、规则沉淀、测试验证和工程治理。
1. AI 不是替代 CI/CD,而是把 CI/CD 的角色抬高了
在传统模式下,CI/CD 更多是自动化工具链;在 AI 时代,CI/CD 的定位更像一条确定性验证底座:
AI 负责产生结果:调研、拆解、编码、补测试、写文档。 CI/CD 负责验证结果:Lint、测试、构建、部署、监控、回滚。
换句话说,AI 负责“生成”,流水线负责“约束”。如果没有这层约束,AI 提高的往往不是生产力,而是不稳定代码进入项目的速度。
2. 新问题不是“不会写”,而是“太会写”
AI 最大的风险,不是写不出来,而是能在没有充分业务上下文的情况下,快速拼装出一个看起来完整的系统。它能生成 UI、能写接口、能搭知识库、能做 Agent,但如果以下问题没有被明确,整个系统就只是一个漂亮的外壳:
规则从哪里来?例如“超标”的判定依据到底是哪一套标准? 数据是否可信?字段含义是否确认过?缺失值如何处理? 逻辑边界是什么?上下游关系如何定义?默认距离为什么是 5km? 异常路径是什么?规则冲突、数据脏污、接口失败时如何兜底? 如何验证?有没有可复现的测试数据、评测样本和回归用例?
03
PART
从“功能开发”转向“可验证的业务能力开发”
CAPABILITY
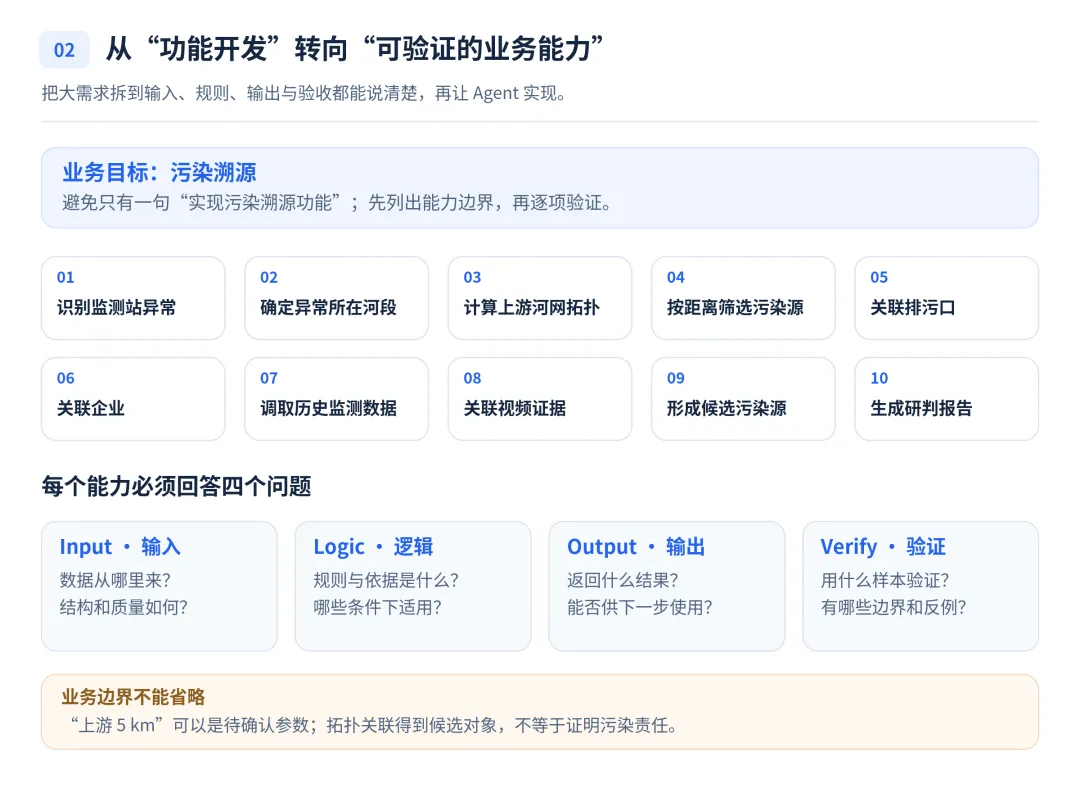
AI 时代不适合继续用“大任务式开发”。如果直接给 Agent 一句“实现污染溯源功能”,它大概率会从页面、接口和流程入手,快速凑出一个完整功能,但关键业务知识往往并没有真正进入系统。
更合理的方式,是把一个复杂目标拆成一组可验证的业务能力,每个能力都可以单独定义、实现和验证。
建议采用的四问法
对于每一个能力,都强制回答四个问题:
Input
输入是什么?数据从哪里来?数据结构和质量如何?
Logic
判断逻辑是什么?规则依据是什么?是否存在前置条件?
Output
输出是什么?输出格式是什么?是否可被后续流程使用?
Verify
如何证明它是对的?是否有测试样本、边界案例和回归标准?
这个“四问法”非常关键,因为它会强制开发过程从“会不会写代码”转向“是否形成工程资产”。
04
PART
治理栈:Governance、Harness、Skills、CI/CD
GOVERNANCE
如果要让 AI 真正参与开发,而不是仅仅当成一个写代码助手,就必须建立分层治理结构。比较实用的方案,是采用四层治理栈。
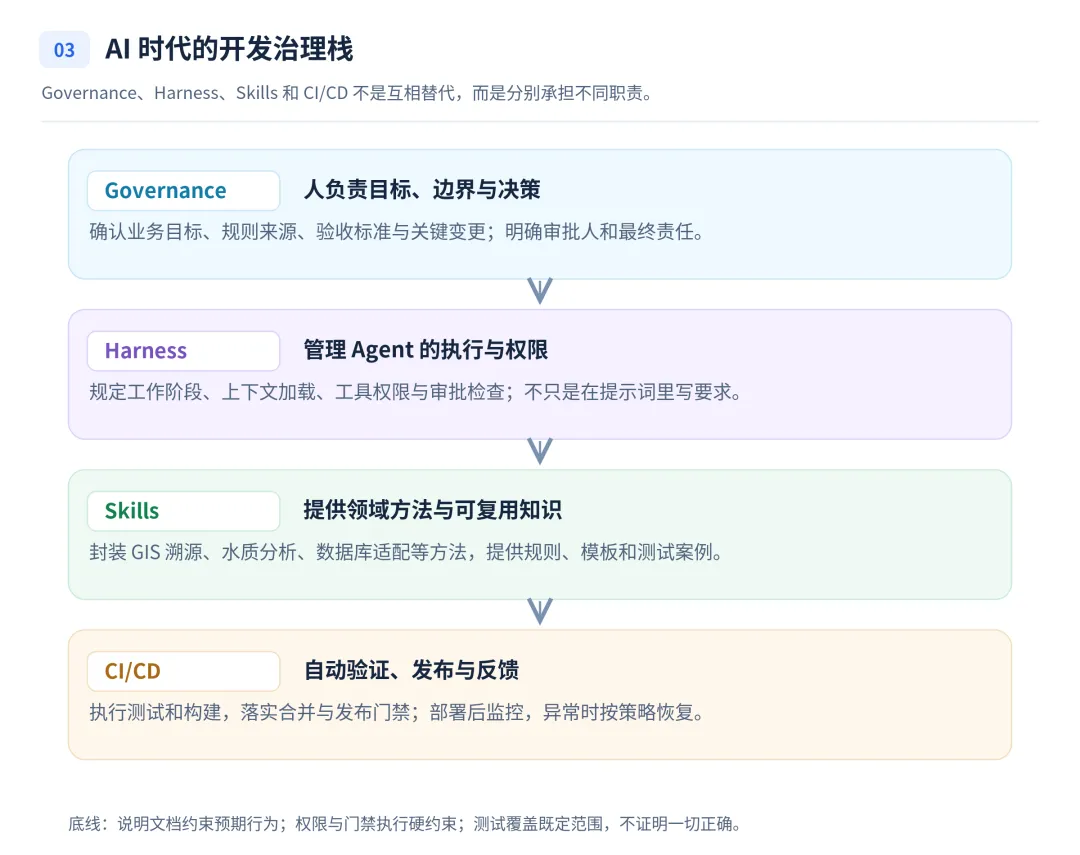
1. Governance:人负责目标、边界与责任
这一层不应该交给 AI。它解决的是“做什么、做到什么程度、谁来拍板”的问题。包括:
确认业务目标与优先级; 确认规则来源与适用范围; 定义验收标准和上线条件; 审批关键架构变更、数据变更、安全策略; 承担最终责任。
2. Harness:约束 Agent 的工作流程
Harness 不是教 AI“怎么做业务”,而是规定它“必须按什么流程做事情”。最关键的原则是:
No Spec, No Code. 没有明确的需求说明与验收标准,Agent 不允许直接开写。
Harness 的作用,是强制 AI 在编码前先完成上下文收集、需求澄清、设计说明、风险识别和测试计划。
3. Skills:沉淀专业知识与方法模板
Skill 对应的是“方法层”。例如 GIS 溯源、水质分析、环境标准查询、数据库适配、前端规范、部署方式等,都可以沉淀为可复用 Skill。它的价值在于把分散在个人经验里的知识,变成团队可调用的组织能力。
4. CI/CD:做确定性验证与交付
CI/CD 不只是自动跑测试,更是工程底线。AI 生成的任何结果,都应该经过这条流水线验证:
05
PART
推荐的 Agent Harness 工作流
WORKFLOW
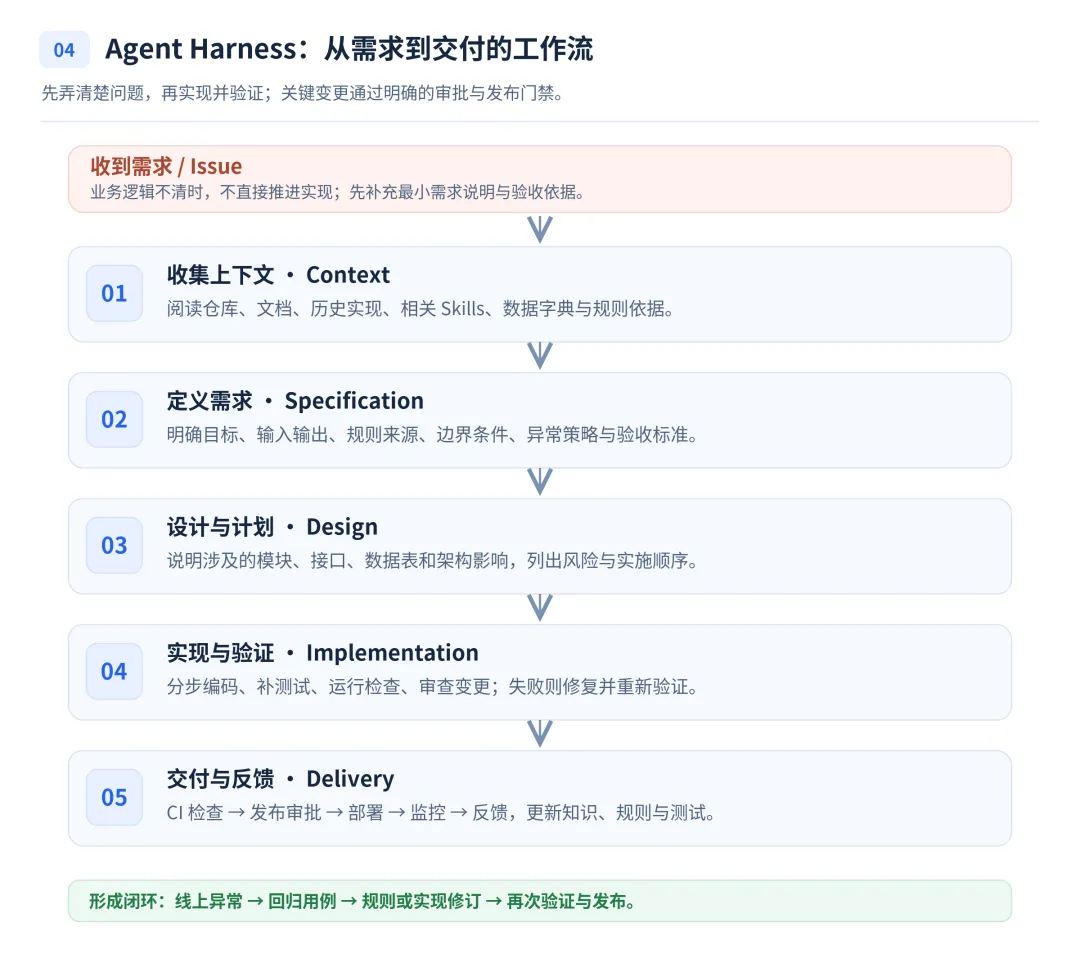
一套真正可落地的 AI 开发方式,不应该是“给任务 → 直接写代码”,而应该是“给任务 → 先整理上下文 → 再明确定义 → 然后编码验证”。推荐的流程如下。
推荐执行步骤
Context Gathering
先阅读仓库、已有文档、历史实现、数据库结构、相关 Skill 与外部规范。
Requirement Spec
产出业务目标、输入输出、规则依据、边界条件、异常情况和验收标准。
Design
确认需要修改的模块、是否涉及数据库或接口变更、是否影响已有架构。
Implementation
在 Spec 和 Design 已明确后,才允许进入编码阶段。
Test & Review
自动补测试、运行检查、审查 Diff、明确风险点。
CI / Deploy / Monitor
通过流水线验证后再部署,并利用监控和日志把线上反馈反哺到文档、Skill 和测试中。
这样做的好处是,Agent 不是“直接替你开发”,而是在一套清晰的工程流程里高效执行。
06
PART
AI 应该参与什么,不应该替代什么
BOUNDARY
适合交给 AI 的工作
资料搜集与初步整理 代码阅读与依赖分析 需求初步拆解 样板代码生成 测试用例补全 文档整理与说明输出 日志分析与问题定位建议
不应直接交给 AI 的工作
业务规则的最终确认 数据真实性与口径确认 关键架构与安全决策 上线门槛与验收标准拍板 最终责任承担
一个简单的判断标准是:AI 可以提出建议,但不能天然拥有解释权。比如 AI 可以建议“默认上游溯源距离设置为 5km”,但如果这条规则最后进入业务系统,就必须进一步补齐:
规则编号与名称; 规则定义; 规则来源(专家确认、规范、项目约定等); 适用条件与不适用条件; 系统实现位置; 对应测试用例。
当一条建议被补全到这种程度,它才从“AI 的一句话”真正变成“系统的工程资产”。
07
PART
一套可执行的落地建议
PLAYBOOK
1. 不要急着堆工具,先搭工程约束
在很多团队里,最容易犯的错误是:刚开始谈 AI 开发,就立刻讨论 Jenkins、Kubernetes、复杂平台、全套自动化。但如果需求定义、Skill 沉淀和测试策略没立住,这些工具很容易变成“更高级的花架子”。
更务实的做法是先把下面这几个点落稳:
BASELINE
2. 给 Agent 建立默认入口规范
建议给项目定义一套统一入口,例如:
先读 PROJECT.md; 按业务域判断任务归属; 自动加载相关 Skill; 输出 Requirement Spec; 生成 Acceptance Criteria; 再制定 Implementation Plan 并开始编码。
3. 把最容易出错的知识优先沉淀成资产
最优先沉淀的通常不是代码,而是那些最容易被误解、最依赖业务经验、最容易导致返工的内容,例如:
业务术语表; 规则清单; 数据字段说明与口径; 典型案例与反例; 评测样本; 边界条件与异常策略; 架构决策记录(ADR)。
4. 以“验证闭环”而不是“代码闭环”为目标
一项能力真正完成,不是因为代码写完了,而是因为它经过了:
规则确认; 实现说明; 测试验证; 部署运行; 监控反馈; 知识反哺。
只有走完这个闭环,AI 交付的结果才真正具备项目价值。
08
PART
结论:真正昂贵的工程资产是什么
CONCLUSION
AI 会让代码越来越便宜,但不会让真正困难的事情自动消失。相反,随着编码变快,以下资产会变得越来越关键:
Domain Knowledge:业务知识与专业经验; Specification:需求说明、规则定义与验收标准; Skills:组织层面的专业方法沉淀; Tests / Evaluation:可验证的测试与评测机制; Real Data:真实、可靠、结构清晰的数据基础; Architecture Decisions:架构决策记录与边界说明; Observability:日志、指标、告警与线上反馈闭环。
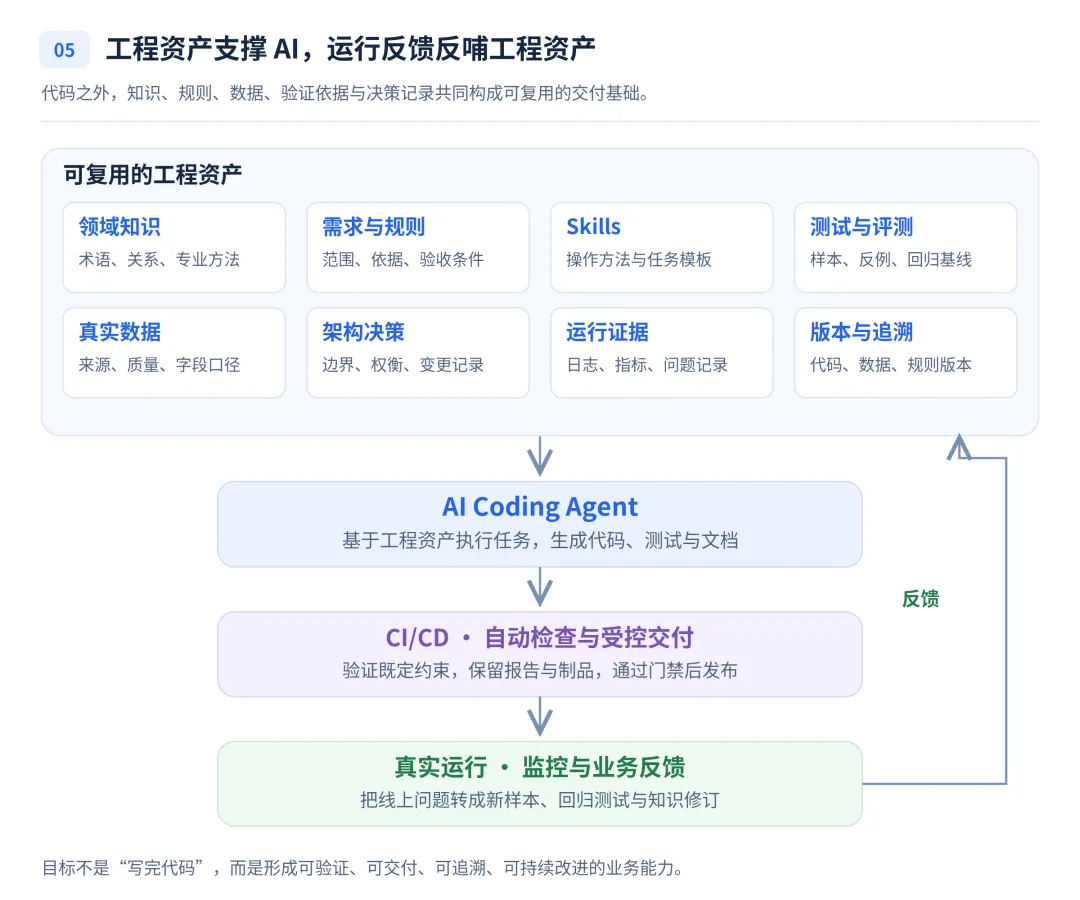
因此,AI 时代的软件开发,不应理解为“让 AI 更快写代码”,而应理解为:
CLOSING
在更短时间内,通过更强的工程约束,把需求、知识、规则、测试与反馈沉淀成可复用资产,并让 AI 在这些资产之上高效执行。
这也是从“能做出一个 Demo”,走向“能稳定交付复杂业务系统”的关键分水岭。
我是陈文茂,持续分享 AI 工具与真实使用体验。
如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见
THANKS FOR READING