ARTICLE · 1067278
爱可可AI前沿推介(9.24)
LG - 机器学习 CV - 计算机视觉 CL - 计算与语言 AI - 人工智能
1、[CL] Beyond Repeated Sampling:Learning Search Policies for LLM Reasoning
2、[CL] Agensh:Scaling Organizational Intelligence to 1,024 Agents
3、[AI] From Decorative to Load-Bearing:Task Difficulty Shapes the Causal Role of Chain-of-Thought
4、[AI] Coding Agents are Strong Prompt Optimizers
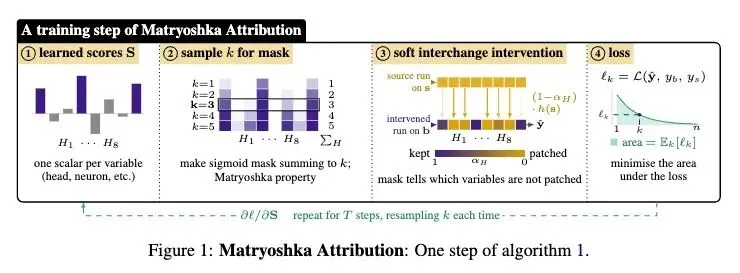
5、[CL] Matryoshka attribution:Learning to attribute language model outputs to representations and weights
摘要:为大语言模型推理学习搜索策略、将组织智能扩展至1024个智能体规模、任务难度塑造了思维链的因果机制、编程智能体是强大的提示词优化器、将语言模型输出关联至表示与权重的学习方法
1、[CL] Beyond Repeated Sampling: Learning Search Policies for LLM Reasoning
I Labiad, M Kowalski, M Schoenauer, R Munos…
[Meta FAIR & Université Paris-Sacla]
超越重复采样:为大语言模型推理学习搜索策略
要点:
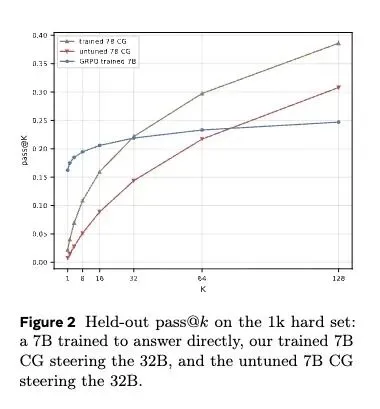
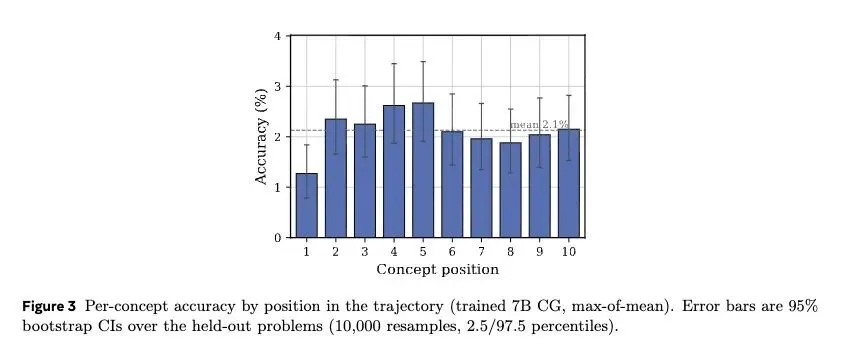
挑战了先前工作(GuidedSampling)的结论,指出当基线方法被允许使用探索性解码参数(如更高的温度)时,原有概念引导采样带来的性能提升基本消失。 将“概念引导探索”转化为一个强化学习(RL)问题:通过训练一个小规模的概念生成器(CG,7B),输出提示/策略,以最大化下游被冻结的大型答案生成器(AG,32B)的成功率。 引入了单轨迹概念生成方法,通过提示模型在一次前向传播中输出多达10个不同的数学概念,这比以前的迭代方法高效且多样化得多。 [反直觉] 经过训练的 7B 概念生成器在引导 32B 答案生成器时的表现,超越了未经训练的 32B 概念生成器,证明专门学习的搜索策略比单纯扩大模型参数规模更有效。 [反直觉] 训练 7B 模型作为 32B 模型的概念生成器(“导航员”),比直接训练该 7B 小模型去解答数学题能获得更好的整体系统推理性能。 [高信息熵] 学到的搜索策略展现出惊人的跨模型家族零样本迁移能力:针对 Qwen2.5-32B 训练出的 7B CG,可以直接用于引导 Llama-3.3-70B 模型,且效果优于 Llama 模型自己生成的概念。 在 DeepMath 的极困难子集(基线 pass@128 仅约 19%)上评估,经过 RL 训练的 CG 在保持相同答案生成算力预算的情况下,将 pass@128 翻倍至 39.2%。 生成概念的计算成本微乎其微(不到生成 128 个答案所需算力的 0.3%),这意味着与朴素的重复采样相比,该方法几乎是以“免费”的代价实现了性能跃升。 发现“均值最大化(Max-of-mean)”奖励聚合方式(奖励稳定有用的概念)始终优于“最大值最大化(Max-of-max)”(只奖励碰巧成功一次的概念),从而促使模型生成语义多样性更高的推理轨迹。
主旨: 解决大型语言模型在处理复杂推理问题时,利用测试时算力(Test-time compute)进行“朴素重复采样”策略探索效率低下、往往只能在局部 token 层面产生解码噪声,导致生成的答案高度同质化(缺乏真正不同解题思路)的问题。
创新:
解耦推理与训练范式:将解题过程分离为“探索方向(生成概念)”和“具体推导(生成答案)”,并创新性地只对负责探索的“小模型”进行 RL 训练,而保持负责推导的“大模型”冻结。 下游奖励驱动的搜索策略学习:将“探索”设定为强化学习的优化目标,使用基于 GRPO 的算法,奖励函数直接绑定在小模型生成的概念能否有效提升黑盒大模型的正确率上。 高吞吐单轨迹多样性生成:摒弃了低效的逐个生成概念的循环,设计了单次轨迹生成所有策略的方法,完美契合 LLM 的自回归特性,且大幅增加了探索空间的广度。
贡献:
重新审视并纠正了学术界关于概念引导推理的现有认知,指出必须在“充分释放基线探索能力”的公平前提下评估新策略。 证实了“小模型可以被训练成通用且高效的搜索策略分配器”这一新范式,打破了必须拥有甚至微调最先进大模型才能优化高阶推理的限制。 在不增加推理算力开销的前提下,显著突破了现有大模型在极困难数学推理任务上的性能天花板,为 Test-time Scaling 提供了高性价比的实现路径。
提升:
复杂任务解决率:在 DeepMath 困难子集(32B 模型基线 128 次采样成功率为 0% 的题目)上,将 pass@128 从 19.0%(探索性重复采样)大幅跃升至 39.2%。 跨分布泛化能力:在完全未见过的 Omni-MATH 2 测试集上,pass@128 从 11.29% 提升至 18.60%。 语义层面的探索多样性:生成的思维链(CoT)有效多样性指标(Vendi Score)从 50.38 显著提升至 73.04,证明系统真正在尝试不同的解题流派,而非单纯替换词汇。
不足:
训练算力成本高昂:强化学习训练过程中,由于奖励的计算需要大量调用冻结的大模型生成答案(例如每个问题评估 1024 个答案),导致训练非常耗时。 信用分配(Credit Assignment)粒度较粗:目前的奖励是分配在整条包含多个概念的轨迹级别上的,而不是精细化到具体哪个概念发挥了关键作用,可能导致无效概念“搭便车”。 训练稳定性的隐患:表现最好的 Max-of-mean 目标在训练几百步后会出现不稳定现象,导致策略熵异常上升和输出截断,需要采取早停策略(Early Stopping)。 领域局限:目前的实验验证几乎全部集中在数学推理任务上,尚未在代码生成、复杂逻辑规划等其他需要 Test-time compute 的场景中进行广泛验证。
心得:
小模型作为大模型的“外挂导航仪”大有可为:这篇论文展示了一种极具实用价值的工程范式。在开源小模型能力越来越强,而闭源前沿大模型微调成本极高的情况下,通过 RL 训练一个小模型去“指挥”大模型探索,不仅成本低,而且具备跨家族(Qwen 指挥 Llama)的通用性。这为我们优化现有的复杂 RAG 系统或 Agent 架构提供了极佳的思路。 打败“皇帝的新衣”,公平的 Baseline 是科学研究的底线:作者在前期分析中发现,之前宣称有效的方法一旦将基线大模型的 Temperature 和 Top-p 调高,优势就荡然无存。这给了我们一个深刻的教训:在做 LLM 推理策略研究时,如果你的 Baseline 故意或无意地被“限制”了,那么由此得出的任何“创新”都是脆弱的。 真正的探索(Exploration)必须发生在“语义层”:我们平时依赖的重复采样(Temperature > 0),本质上是在输出概率分布的边缘注入噪音,这会导致模型写出 100 种句式不同但解题死胡同完全一样的答案。本文深刻指出,要解决极难问题,必须强迫模型先在更高维的“语义/策略”层面发生分化(比如提示它尝试“反证法”、“生成函数”、“几何构造”),才能实质性地提升 Test-time Scaling 的上限。
一句话总结:
本文通过强化学习训练一个轻量级的概念生成器,为冻结的大型语言模型提供多样化的高层解题策略,有效替代了低效的局部重复采样,在几乎不增加推理成本的前提下将复杂数学推理的成功率翻倍,证明了小模型可以作为大模型跨架构通用的高效搜索导航者。
Large language models increasingly tackle hard reasoning problems by spending more test-time compute, yet the dominant strategy remains naive repeated sampling: draw many independent solutions and hope one is correct. Because such sampling explores only through local decoding noise, it tends to produce many near duplicate attempts rather than genuinely different ideas. We ask whether exploration can instead be steered at a semantic level, by first sampling problem specific concepts, hints, or strategies and then conditioning answer generation on them. We refine this into a simple, more exploratory procedure that emits many diverse concepts in a single trajectory, and evaluate it on hard problems where repeated sampling struggles. We then go a step further and make concept generation trainable: a small concept generator is optimized with reinforcement learning so that its concepts maximize the downstream success of a larger, frozen answer generator. On hard mathematical reasoning problems, the trained concept generator substantially improves the answer generator's pass@k over naive repeated sampling at the same answer generation allocation, surpasses concepts drawn from much larger untuned models, and transfers to answer generators it was never trained against, including a model from a different family. A small model can thus be trained into an effective, reusable search policy for a much larger one.
https://arxiv.org/abs/2609.26704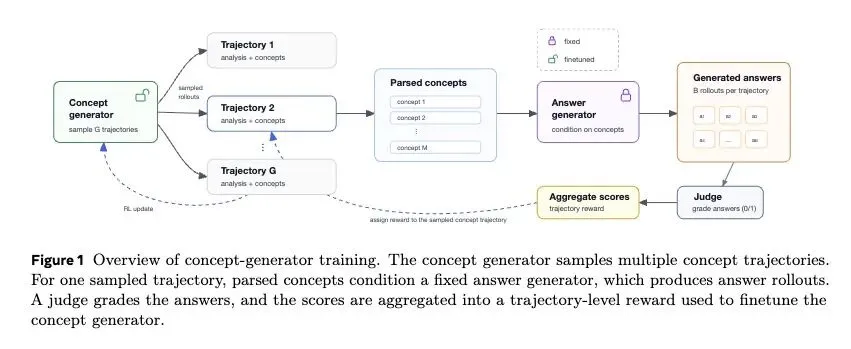
2、[CL] Agensh: Scaling Organizational Intelligence to 1,024 Agents
Z Zhan, T Song, L Dong, S Huang,…
[Microsoft Research]
Agensh:将组织智能扩展至1024个智能体规模
要点:
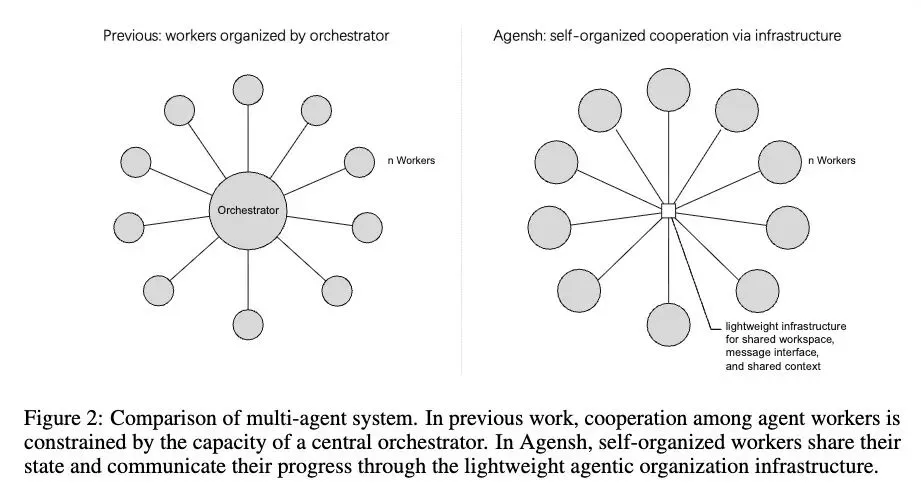
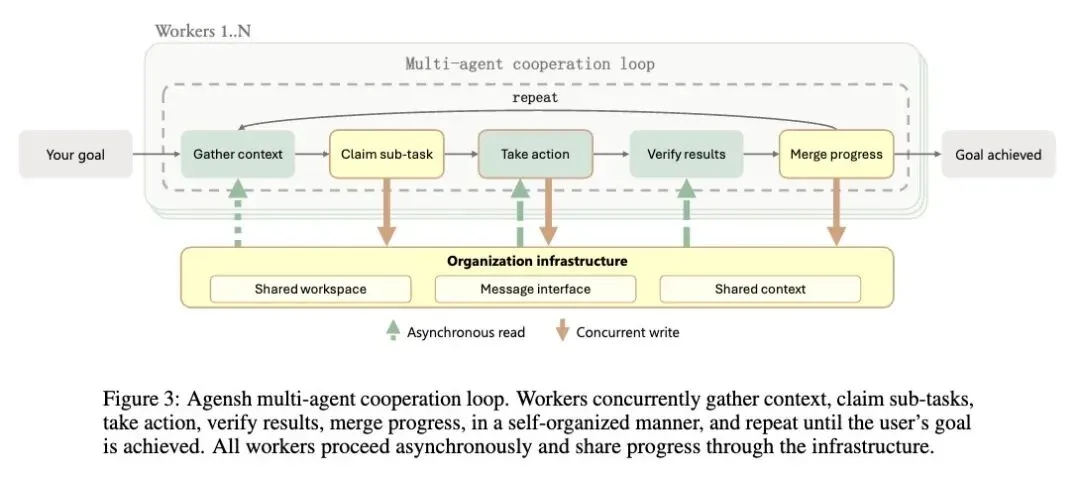
挑战了多智能体系统中依赖“中心编排者(Orchestrator)”的传统范式,指出中心节点是限制系统扩展性的根本瓶颈。 提出了 Agensh,一个无中心编排者、高可扩展的自组织多智能体框架,允许智能体并发且异步地工作。 Agensh 包含一个多智能体协作循环(收集上下文 -> 认领子任务 -> 执行操作 -> 验证结果 -> 合并进度)以及一个轻量级的智能体组织基础设施。 基础设施依赖三大核心组件:共享工作区(基于Git,支持并发写/异步读和冲突解决)、消息接口(用于团队公告和解决任务重叠的紧急私信)、共享上下文(仅追加的日志,记录事实、失败尝试和补丁摘要,以避免重复造轮子)。 实证证明了“智能体数量(Agent Count)”是一个全新的缩放维度(Scaling Dimension)。在 ProgramBench 最难的5个任务上,将智能体从1个扩展到128个,平均最终测试通过率从19.31%提升至28.78%(相对提升49%)。 在复杂的 'pandoc' 代码库重构任务上成功扩展至 1,024 个智能体,在6小时预算内将通过率从33.89%(单智能体)提升至55.06%。 证明了增加智能体数量可以显著降低延迟,更大规模的智能体组织能更快达到相同的性能阈值(例如,128个智能体在30分钟内达到30%的通过率,而8个智能体需要90分钟)。 反直觉与高信息熵发现:尽管所有智能体使用完全相同的提示词(仅ID不同),但随着规模的扩大,系统自然涌现出了复杂的组织行为。 8个智能体时:点对点协调(就技术接口达成一致)。 32个智能体时:多工作者集成(共同处理和审查代码合并请求)。 128个智能体时:工作流标准化(智能体自发建立PR合并的规则和协议)。 1,024个智能体时:组织级别的角色分化(智能体自发充当专职的“集成者”或“审查者”,并建立故障接管的冗余机制)。
主旨: 解决现有基于“中心编排者”的多智能体系统在处理复杂、长周期任务时面临的扩展性瓶颈问题。论文提出了一种去中心化、自组织的并发异步协作框架 Agensh,以探索在极端复杂任务(如从零重构超大型开源代码库)中,大规模扩展智能体数量能否带来组织智能的提升。
创新:
架构创新:摒弃了主流的“主-从(Master-Worker)”任务分配模式,采用完全去中心化的点对点(P2P)异步协作架构。 基础设施引入:巧妙地将人类软件工程中成熟的工具(Git版本控制、Mattermost即时通讯、类似DeLM的全局上下文黑板)深度集成到智能体的协作底层中。 运行时机制创新:引入了“回合中途注入(Mid-turn injection)”机制,在智能体等待工具执行结果时,可以将紧急私信或新的全局上下文动态追加到当前上下文中,极大地提高了异步协作的实时性。
贡献:
理论贡献:提出了“智能体数量(Agent Count)”是多智能体组织中一种新的 Scaling Law(缩放定律),证明了扩大并行智能体规模可以拓展通用人工智能的边界。 工程/实践贡献:成功实现了高达 1,024 个大模型智能体的高效并行协作,并在当前最具挑战性的智能体软件工程基准测试(ProgramBench)上取得了突破性进展。 发现贡献:详细记录并揭示了LLM在没有预先设定角色的情况下,随着规模扩大而自发涌现出的社会学和组织学行为(如角色分工、标准SOP制定等),为研究AI社会学提供了极其宝贵的实证依据。
提升:
任务成功率:在5个高难度代码重构任务中,128个智能体相比单智能体,平均测试通过率实现了约49%的相对提升;在特定任务上,1024个智能体比单智能体通过率提升了超过21个百分点。 效率与延迟控制:显著缩短了完成复杂任务所需的时间,在相同的时间节点(如前2小时内),大规模智能体集群能更早地达到高分,有效解决了严格时间预算下的复杂任务执行问题。
不足:
成本问题:论文未详细探讨运行 1,024 个基于 GPT-5.6-sol 这种顶级模型的智能体并发长达6小时所消耗的巨大算力与API成本,这在实际商业落地中可能极难承受。 冲突开销的非线性增长:虽然框架支持Git冲突解决和消息沟通,但随着规模达到千人级,合并冲突(Merge Conflicts)和信息噪音大概率会指数级增长,论文未深入量化这些“管理损耗”。 任务泛化性:实验仅局限于软件工程(代码重构)领域,该领域具有天然的模块化特性且Git等工具极其适用。这种自组织模式是否能泛化到非结构化任务(如创意写作、商业分析等)尚待验证。 对底层模型能力的极度依赖:该框架之所以能自发解决冲突和分工,很大程度上依赖于 GPT-5.6-sol 极高的推理和纠错能力,如果替换为较弱的开源模型,系统可能会因为死锁或无休止的代码冲突而崩溃。
心得:
AI 组织行为学的觉醒(最震撼的启发): 论文揭示了一个极其反直觉的现象——我们不需要在 Prompt 中刻意为智能体分配“项目经理”、“审查员”或“开发”的角色。只要赋予它们同样的底层目标和良好的沟通/版本控制工具,随着数量的增加,LLM 会自发演化出类似人类现代企业的高度复杂分工组织形态。这说明“管理”和“分工”是复杂系统规模化后的涌现属性,而非人为设计的前置条件。 用“组织缩放”对抗“上下文瓶颈”: 在单体模型面临上下文窗口限制、推理时间过长等物理瓶颈时,Agensh 证明了横向扩展(Scale-out)智能体数量是一条可行的道路。这种“组织智能”的缩放维度,为未来突破现有基础模型的单点能力天花板提供了一种全新的工程学路径。 去中心化是构建超级 AI 集群的必经之路: 传统的中心化 Task Planner 模式在面对稍微复杂的任务时,往往会因为规划粒度不匹配或单点过载而导致整个流程停滞。这启示我们在设计未来 AGI 应用架构时,应当更多地采用类似于分布式系统(微服务、事件驱动、Git版本控制)的设计理念,让局部自治与全局同步相结合。
一句话总结:
本文提出了一种无中心编排者的去中心化多智能体框架 Agensh,首次证明了“智能体数量”是提升多智能体系统能力的新缩放定律,并震撼性地展示了在 1,024 个智能体协作完成复杂代码重构时,即使没有预设指令,系统也会自发涌现出角色分工和标准化工作流等高级人类组织行为。
A multi-agent system can reduce latency on complex tasks by executing work concurrently. Several pioneering harness frameworks support multi-agent systems. However, the scalability of current multi-agent harnesses is often constrained by a central orchestrator's capacity to allocate tasks and coordinate workers. To address this limitation, we introduce Agensh, a scalable self-organized multi-agent harness without a central orchestrator: concurrent workers execute a multi-agent cooperation loop, continuously gathering context, claiming and self-assigning sub-tasks, taking action and sharing findings, verifying results, and merging progress in an asynchronous manner. The loop is supported by the agentic organization infrastructure comprising three components: a shared workspace holds proposed, ongoing, and completed work; a message interface lets workers communicate; and shared context retains reusable findings and work intentions. To test the scalability of Agensh, we evaluate it on the five hardest ProgramBench tasks with GPT-5.6-sol (high). Scaling from 1 to 128 agents raises the mean final test-pass rate from 19.31% to 28.78%, an approximately 49% relative improvement. Larger organizations reach comparable test-pass rates earlier. On pandoc, scaling from 1 to 1,024 agents raises the final test-pass rate from 33.89% to 55.06%. Worker trajectories further show that different forms of self-organized cooperation gradually emerges and standardizes as the organization grows. These results reveal the number of agents as a new scaling dimension for multi-agent organizations to expand the frontier of general intelligence, offering a practical solution for complex tasks under hard latency constraints or time budgets.
https://arxiv.org/abs/2609.26781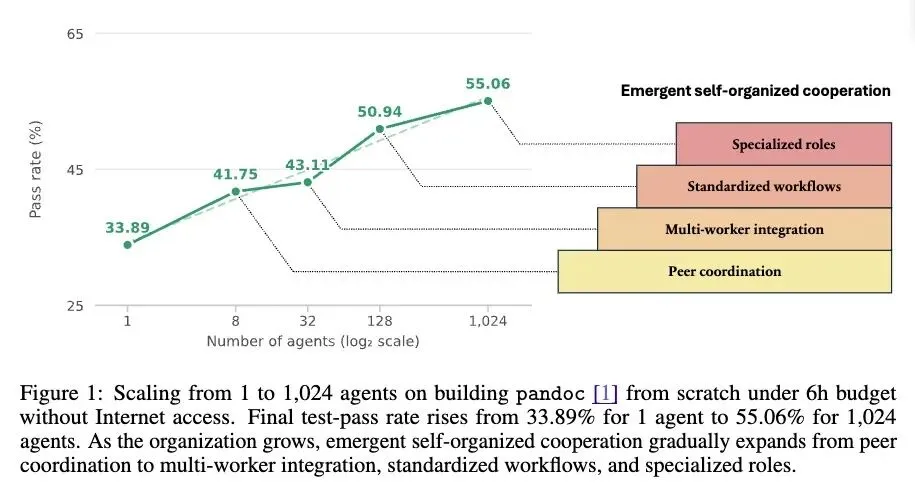
3、[AI] From Decorative to Load-Bearing: Task Difficulty Shapes the Causal Role of Chain-of-Thought
R Jia, D Mu
[Cornell University & CMU]
从装饰到承重:任务难度塑造了思维链的因果机制
要点:
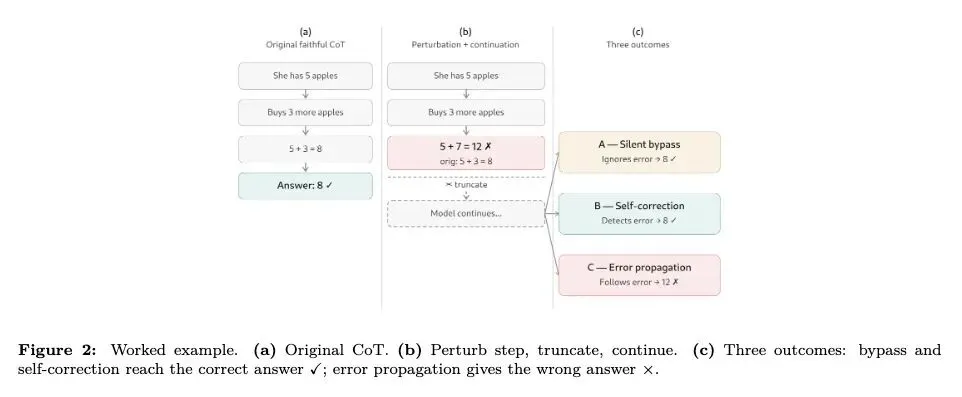
挑战了关于思维链(CoT)忠实度的二元对立观点:CoT并非绝对忠实或不忠实,其因果作用会根据“相对于模型的任务难度”在“装饰性(Decorative)”和“承重性(Load-bearing)”之间动态转换。 引入了“基于延续性的因果测试(Continuation-based causal testing)”:通过扰动CoT中的单个推理步骤、截断文本并强制模型自回归生成,从而干净地分离出CoT与最终答案之间的因果联系。 反直觉的行为转变:在简单任务(如GSM8K)中,模型在很大程度上忽略了自己写下的推理,94.5%的情况下会绕过注入的错误(纯装饰);但在困难任务(如BBH)中,模型会盲目遵循注入的错误(40.9%的误差传播率),这意味着它们在困难任务中极易被污染的上下文带偏(起承重作用)。 高信息熵结论:对28,584次生成的方差分解证明,任务难度解释了高达98.8%的误差传播方差,而具体的扰动类型(文本或数字)仅解释了0.8%。 反直觉的可解释性发现(能探测≠能控制):虽然隐藏状态探针(Probes)能够以高达86.2%的准确率准确预测模型的行为模式(绕过、自我纠正、传播错误),但单方向的附加激活引导(Additive activation steering)完全无法可靠地翻转或控制这些行为。 指出了AI安全与监控的结构性悖论:监控CoT在实际应用中存在致命缺陷。在简单任务中,CoT轨迹没有因果信号(容易产生误报);在困难任务中,错误一旦出现,模型会立刻顺着错误推理,几乎不给监控系统留下干预的窗口。 揭露了可解释性研究中的标签伪影问题:将基于规则的标签修正为LLM裁判标签后,3分类探针的准确率从99.9%暴跌至75.0%。这发出强烈警告:基于行为标签训练的探针其上限受限于标签质量,极易探测到数据伪影而非真正的内部机制。 强化学习训练的推理模型(如DeepSeek-R1-Distill)展现出完全不同的范式:针对推理的RL训练系统性地抑制了误差传播,并显著提高了生成过程中的自我纠正(自我验证)比例。
主旨: 探究大语言模型在生成思维链(CoT)时,写下的推理步骤是否真正在因果上决定了最终答案。论文旨在解决CoT忠实度评估中的空白,研究当上下文中出现错误推理时,模型是会忽略、纠正还是盲从,并揭示任务难度如何重塑CoT在推理过程中的因果角色。
创新:
设计了“基于延续性的因果测试(Continuation-based causal testing)”范式。传统的测试方法通常是重新提示(re-prompt)模型回答,而本文采用“扰动中间步骤->截断->强制续写”的方法,防止了模型从头重新推导,从而精准隔离了CoT到答案的因果链条。 巧妙设计了“扰动类型”与“任务难度”的 2x2 匹配实验(如在简单的GSM8K中加入文本扰动,在困难的BBH中加入纯数字扰动),成功将任务难度与扰动模态解耦。
贡献:
理论贡献:证明了CoT的因果作用是一个动态谱系,提出了“从装饰性到承重性”的难度梯度理论(任务难度解释了98.8%的方差)。 方法贡献:提供了一种可扩展的因果干预评估框架,能在不依赖昂贵的电路追踪(Circuit tracing)的情况下大规模评估大模型的推理忠实度。 可解释性贡献:在Gemma-2等模型上证明,模型是否会陷入“误差传播”在其隐藏状态中是线性可分的,但揭示了“特征可探测”与“特征可控制”之间的巨大鸿沟。 跨模型验证:在指令微调模型(Gemma, Llama)和基于RL的推理模型(DeepSeek-R1-Distill)上验证了结论,发现了RL后训练对模型自我纠正能力的本质改变。
提升:
评估精度与维度:相比于仅依赖表面行为观察的方法,本文的测试方法将CoT忠实度的评估从相关性提升到了严格的因果层面。 机制理解:通过探针技术(Probes),在Gemma-2的第28层实现了86.2%的误差传播检测准确率,大幅提升了对模型内部如何处理错误上下文的机理认识。
不足:
模型规模限制:受限于单卡H100算力,实验主要在7B-9B参数规模的模型上进行,尚未在≥70B的超大模型上验证该难度梯度是否依然成立。 扰动方式的局限:目前每次只扰动单个推理步骤,未来的研究可以探索多步骤、逻辑自洽的复杂扰动是否会引发更高的误差传播。 干预手段单一:得出“无法控制行为”的结论仅限于加性激活引导(Additive steering),更复杂的干预手段(如因果擦除 Causal scrubbing 或注意力电路干预)可能会有效,这部分仍是空白。 标签噪声:依赖LLM作为裁判进行分类,虽然经过了人类验证,但在边界情况(特别是隐性纠正)上仍存在一定的主观性和标签噪声。
心得:
安全监控的困境令人警醒: 当前AI对齐领域寄希望于通过“监控CoT”来防止大模型作恶。但本文揭示了一个残酷的悖论:当任务对模型来说很简单时,它其实根本不看CoT(暗中走捷径);当任务很难时,它又极其容易被CoT中的错误带偏。这意味着基于CoT的监控机制不仅容易被欺骗,而且容错率极低,未来的对齐研究必须将“任务难度”作为核心变量纳入考量。 戳破了“表征工程”的完美幻觉: 很多可解释性研究认为,只要在隐空间找到一个高准确率的线性方向(Probe),顺着这个方向加减向量就能操控模型行为(Detection = Control)。本文用扎实的实验证明,至少在推理链行为上,能探测到完全不等于能直接控制。这提醒我们对待激活修补(Activation Patching)的成果需要更加审慎。 RLHF正在重塑模型的认知模式: DeepSeek-R1-Distill 在遇到错误时展现出远超常规指令微调模型(Gemma/Llama)的自我纠正率和极低的误差盲从率。这深刻表明,为了提升推理能力而引入的强化学习(RL),不仅提高了准确率,更在底层重写了模型对自己上下文的“信任机制”与“验证习惯”,这是极其迷人且值得深挖的演化方向。
一句话总结:
本文提出基于延续性的因果测试,揭示了思维链(CoT)中一个极具反直觉的现象:CoT的因果作用并非一成不变,而是随任务难度从“纯装饰性”向“高承重性”转变——在简单任务中模型会直接忽略CoT中的错误,而在困难任务中则会盲从错误,且这种因果行为在隐状态中可被精准探测却难以通过简单向量叠加来干预,这一发现不仅挑战了传统的表征干预假设,更给当前寄希望于“监控CoT”的AI安全防御机制带来了严峻的结构性挑战。
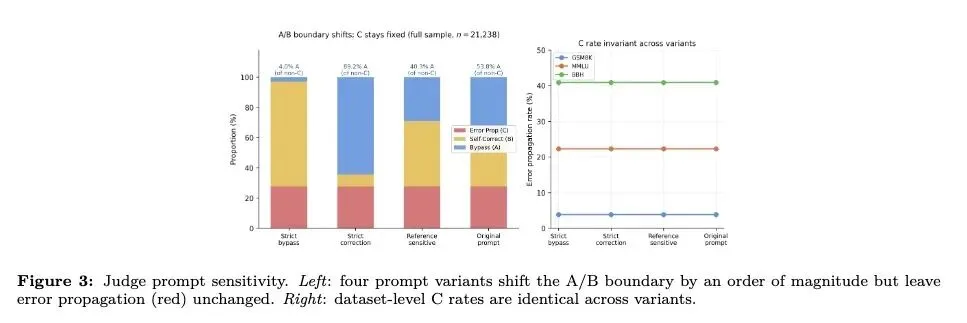
Chain-of-thought (CoT) monitoring is only meaningful if written reasoning causally constrains the answer. We introduce continuation-based causal testing, an ablation-patch intervention that perturbs one reasoning step, truncates the chain, and forces the model to continue from the corrupted prefix. It measures how load-bearing a CoT is for the final answer, a behavioral notion distinct from mechanistic faithfulness. Across Gemma-2-9B-IT, Llama-3.1-8B-Instruct, and DeepSeek-R1-Distill-Qwen-7B on GSM8K, MMLU, and BIG-Bench Hard, CoT load-bearingness tracks model-relative task difficulty: on easy tasks models silently bypass their own reasoning; on hard tasks they follow corrupted steps and propagate errors. A matched 2x2 analysis shows task difficulty dominates perturbation type: error propagation rises 16x from GSM8K to BBH multistep arithmetic, and a variance partition over 28,584 continuations attributes 98.8% of explained deviance to task difficulty versus 0.8% to perturbation type. Reasoning-specific RL suppresses error propagation and compresses the gradient. A four-variant judge-sensitivity analysis and blind two-annotator study (n=500) show the error-propagation vs. non-propagation label is invariant to judge prompt, with perfect inter-annotator agreement (Cohen's kappa = 1.00). This gradient creates a structural problem for CoT-based oversight and AI safety monitoring: where the trace is easy to read it carries little signal, and where it matters errors propagate before a monitor can intervene. Linear probes on hidden states separate silent bypass, self-correction, and error propagation, but additive activation steering provides limited causal control, flipping only about 25% of error-propagation cases at best. Behavioral mode is readable but not reliably controllable.
https://arxiv.org/abs/2609.25366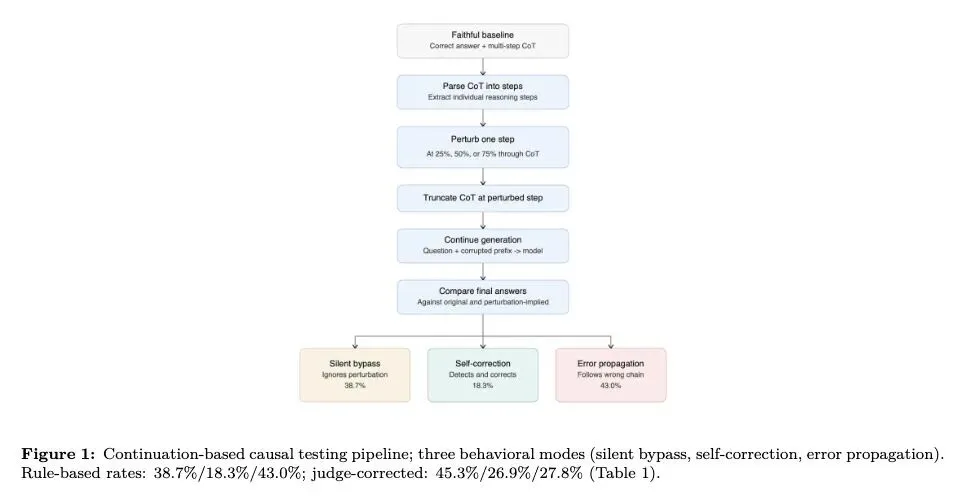
4、[AI] Coding Agents are Strong Prompt Optimizers
A Singh, S Gautam, P Gupta, N Mehrotra…
[Microsoft]
编程智能体是强大的提示词优化器
要点:
挑战了提示词优化(Prompt Optimization)必须依赖迭代搜索、环境交互(Rollout)和验证集筛选的传统假设。 提出了编码智能体技能蒸馏(CASD),该方法使用现成的编码智能体(如Claude Code)分析静态轨迹语料库,并在单次离线传递中直接合成优化后的提示词。 指出“反思范围(Reflection Scope)”是一个关键的设计维度:将基于小批量的自然语言反思,转变为通过执行代码进行的“语料库级统计反思”。 揭示了一个反直觉的现象:小批量轨迹反思对“语料库级别的规律”是盲目的(例如某种必要操作在所有数据中完全缺失,或者数百个回合中的确切重复调用率),而代码驱动的统计分析能让这些规律显形。 实验证明,在相同数据访问权限下,CASD在四个智能体基准测试中平均提升了16.6%的性能,超越了GEPA(+10.9%)和SkillOpt(+5.3%)等最先进的迭代搜索方法。 通过消除环境交互循环和验证集打分,将提示词优化的成本大幅降低至每个约1.60美元(比带验证门控的搜索方法便宜22倍以上)。 提供了将提示词优化视为“偏差-方差权衡(Bias-Variance Trade-off)”的理论框架,表明在数据受限的情况下,单步离线蒸馏避免了蒙特卡洛搜索的“门控过拟合(Gate-overfitting)”和高方差问题。 极具反直觉的发现:蒸馏出的行为规则可以在很大程度上替代昂贵的“测试时推理(System 2思考)”。将CASD提示词应用于“无思考(no-think)”模型,能恢复甚至超越“思考(think)”模型100%的精度差距,同时不生成任何推理Token,大幅降低了推理成本。
主旨: 本文探讨了如何解决现有基于搜索的提示词优化器(如DSPy, GEPA)高度依赖昂贵的“提议-执行-验证”迭代循环,且由于视野局限于小批量样本而无法捕捉宏观系统性错误的问题。论文提出,通过将整个静态历史执行数据交给编码智能体进行一次性“代码驱动的语料库级统计反思”,可以完全替代迭代搜索过程。
创新:
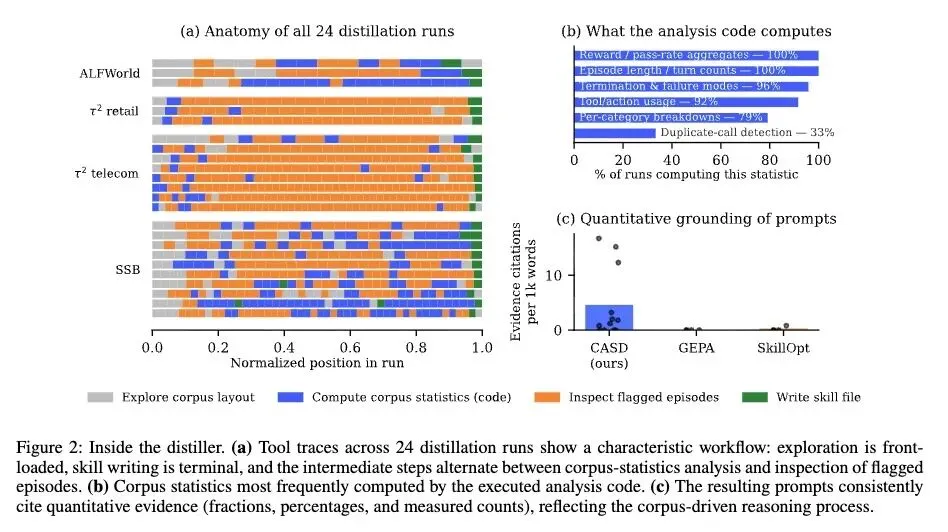
单次离线无循环优化:摒弃了主流的“进化/搜索”范式,将提示词优化转化为类似离线强化学习(Offline RL)的单步蒸馏过程,完全切断了优化过程中的环境交互。 计算辅助的大规模反思(Code-driven Corpus-scale Reflection):不让大模型直接“阅读”少量轨迹,而是让编码智能体自主编写Python脚本(如利用pandas)来统计整个数据集的特征(如工具调用失败率、重复率等),基于硬核统计数据而非零散轶事来生成规则。
贡献:
方法论:提出了CASD框架,证明了现成编码智能体在完全无干预的高层级指令下,能够自主完成从探索数据、编写统计代码到生成包含量化证据的提示词的完整工作流。 理论视角:将提示词优化统一在“偏差-方差”分析框架下,解释了为什么在有限数据下,放弃验证集筛选(消除蒙特卡洛方差和过拟合)反而能带来更鲁棒的优化结果。 工程实践:实现了一种极具性价比的优化器,在提升Agent基准测试性能的同时,将优化成本降低了整整一个数量级(~22倍)。
提升:
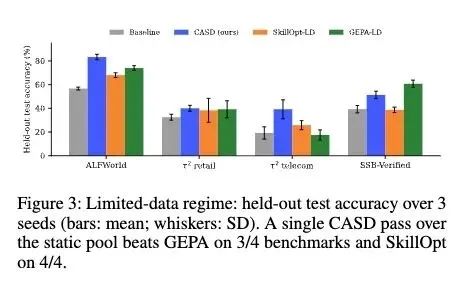
准确率指标:在ALFWorld、τ2-bench (零售和电信)、SpreadsheetBench上,在静态数据集受限的情况下,平均绝对通过率提升16.6%(超过GEPA的10.9%)。 优化成本维度:从SkillOpt的142.5美元/提示词骤降至CASD的1.60美元/提示词。 推理效率维度:通过规则前置(提示词化),使得“无思考(no-think)”小模型的输出Token量大幅降低(例如从3.7k降至0.8k),却达到了开启“思考(think)”模式时的性能。
不足:
受限于静态语料库(Inherits the corpus bias):CASD无法发现日志数据中完全未涉及的潜在行为空间,如果数据集极小或完全没有失败案例,模型将无从蒸馏。 对提炼者能力的依赖:实验仅测试了GPT-4o-mini作为目标模型和Claude 3.5 Sonnet作为编码智能体的组合,该方法对编码智能体自身代码能力和分析能力的敏感度尚未充分验证。 无法替代所有推理:实验表明,在复杂任务(如电信排障和表格处理)中,仍有部分特定于实例的动态演绎推理是静态提示词无法完全恢复的。
心得:
用精确计算代替大模型直觉(计算赋能反思):这篇论文最值得深思的一点是揭示了大模型上下文窗口在处理长轨迹时的“盲区”。依靠大模型肉眼看几条失败轨迹,永远无法发现“某个函数在284次调用中有123次是完全重复的”这种宏观统计特征。将“计数和统计”下放给Python解释器,将“总结规律”留给大模型,是提升Agent反思能力的降维打击。 提示词优化实质上是“系统1”对“系统2”的知识蒸馏:论文中“用CASD提示词替代测试时推理(think tokens)”的结果非常震撼。它暗示了当前大语言模型在测试时进行的大量“反思和推理”,其实是在重复推导“标准作业程序(SOP)”。如果我们在离线阶段通过数据分析把这些SOP找出来并写进提示词,就可以省去在线推理时高昂的Token成本。这为后o1时代的推理成本优化指明了方向。 打破“验证集崇拜”和迭代迷信:在AI优化中,我们往往认为“带有验证集的闭环迭代搜索”永远优于“单步操作”。但这篇论文在理论和实践上都证明了,在数据受限的情况下,迭代搜索会陷入严重的“门控过拟合(Gate-overfitting)”——因为验证集太小,为了迎合验证集而保留的修改往往是噪音。这时候,基于全量数据的单次深度洞察,反而具有更好的泛化性。
一句话总结: 本文创新性地提出,无需昂贵的迭代搜索与环境交互,只需让编码智能体通过编写代码对静态轨迹语料库进行一次全局统计分析,即可直接蒸馏出极具性价比且能替代昂贵测试时推理的高质量提示词。
Search-based prompt optimizers improve prompts through iterative search: they propose edits, execute fresh rollouts, score the resulting trajectories, and retain only edits that improve a validation metric. We show that this optimization loop is unnecessary. Given only a static corpus of agent trajectories, an off-the-shelf coding agent can directly synthesize an optimized prompt, requiring neither environment access nor validation data. We call this approach Coding-Agent Skill Distillation (CASD). The key insight is reflection scope. Rather than reasoning over a small batch of trajectories at each optimization step, the coding agent writes and executes analysis code to compute corpus-wide statistics, identifies systematic failure modes, inspects representative episodes, and distills the resulting insights into behavioral rules. Across four agentic benchmarks (ALFWorld, τ 2-bench retail and telecom, and SpreadsheetBench-Verified), under matched data access, a single CASD pass outperforms GEPA, a state-of-the-art reflective prompt optimizer, on three of four benchmarks and outperforms validation-gated reflective search (SkillOpt) on all four, improving the unoptimized baseline by 16.6 percentage points on average versus 10.9 for GEPA and 5.3 for SkillOpt. Because CASD performs a single offline analysis pass rather than iterative search, producing an optimized prompt costs approximately $1.60—over 22× cheaper than validation-gated search. Even when competing methods are granted additional validation data and unrestricted environment access, CASD remains ahead on two of four benchmarks. These results suggest that corpus-scale statistical reflection is a viable alternative to iterative search for prompt optimization.
https://arxiv.org/abs/2609.26261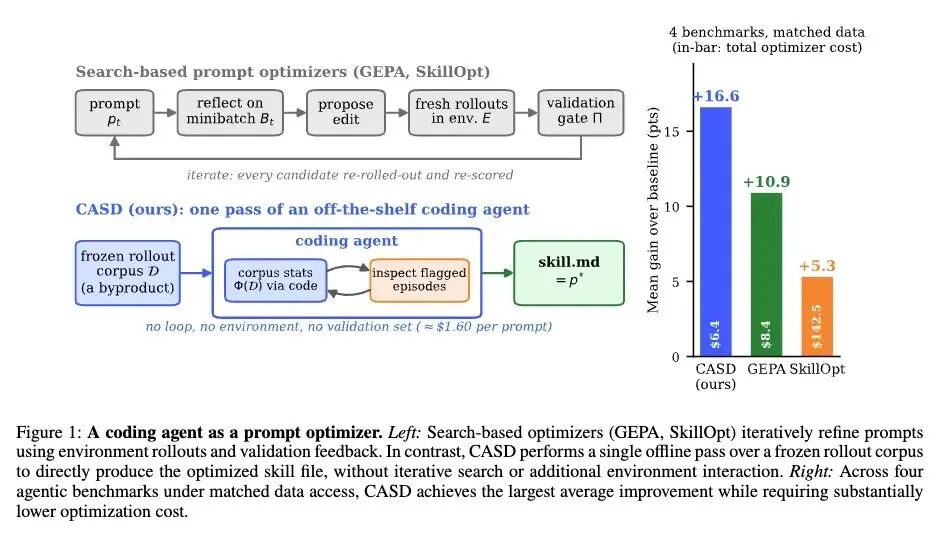
5、[CL] Matryoshka attribution: Learning to attribute language model outputs to representations and weights
A Arora, K Acharya, N Hu, Y Zhang…
[Stanford University]
套娃式归因:将语言模型输出关联至表示与权重的学习方法
要点:
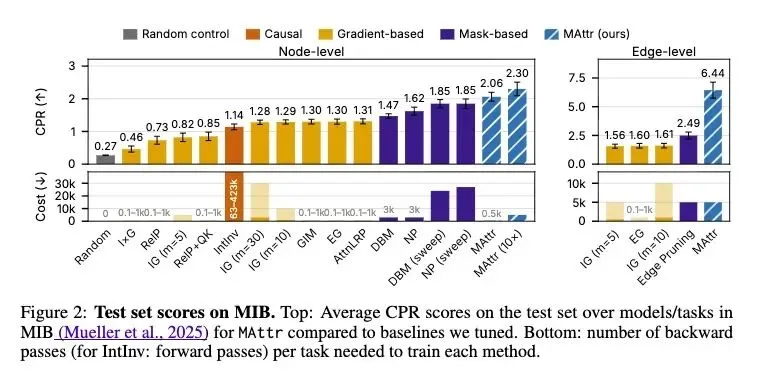
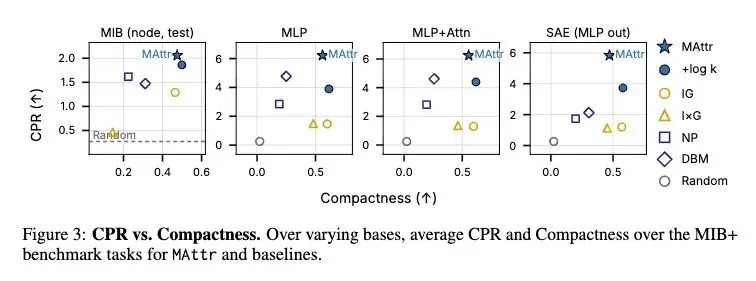
挑战了基于梯度的归因方法的“不可能性定理”(该定理认为满足完备性和线性公理的方法在局部反事实推理中会失效),MAttr通过直接优化下游任务损失而非依赖公理约束,成功规避了这一理论陷阱。 提出了套娃归因(MAttr),使用简单可导的 sigmoid top-k 算子来参数化掩码(Mask),彻底消除了传统掩码学习中不稳定的 L0 稀疏性惩罚项或复杂的直通估计器(Straight-through estimators)。 通过在每次训练迭代中随机化掩码预算 k,实现了在所有稀疏度下的联合训练,自然生成了因果重要性组件的嵌套(套娃式)排序。 揭示了深刻的理论联系:在 SGD 优化器下,MAttr 的第一步梯度更新在数学上等价于路径重加权的积分梯度(Integrated Gradients, IG),优雅地桥接了掩码学习和梯度归因方法。 在机械可解释性基准(MIB)上取得了绝对的 SOTA,得分为 5.6(远超第二名的 1.95),同时优化了神经回路的忠实度(CPR)和紧凑性(Compactness)。 极具反直觉的实证结果:通过结合强化学习(GRPO),MAttr 揭示了只需将指令微调大模型(Llama 3.1 8B Instruct)中仅仅 1% 的权重恢复到基础模型(Base model)状态,就足以彻底消除模型的安全拒绝行为,同时完美保留其通用能力。 证明了 MAttr 具有极高的通用性,不仅能用于内部表示(激活值)的归因,还能直接用于跨检查点(Checkpoints)的模型参数归因。
主旨: 解决大语言模型在机制可解释性(Mechanistic Interpretability)研究中,现有归因方法(因果干预、梯度方法、掩码学习)面临的计算成本过高、难以发现真实因果计算节点、以及超参数调节困难和训练不稳定的痛点,致力于精准定位导致模型特定输出或行为的内部表示和权重。
创新:
随机化预算机制(Matryoshka 技巧):在训练的每一步随机采样掩码预算 k,使得模型能够一次性学习到所有稀疏度下组件的重要性排序,无需像以往方法那样对不同稀疏度分别训练。 可导的 Sigmoid Top-k 掩码:摒弃了硬掩码和非连续操作,利用可导的 sigmoid top-k 函数直接控制稀疏性,从而抛弃了难以调参的 L0 正则化项。 结合强化学习进行无梯度参数归因:创新性地将 MAttr 与群组相对策略优化(GRPO)结合,使得该方法能在仅有不可导奖励(如裁判模型的评分)的情况下,定位导致特定行为(如拒绝回答)的参数变化。
贡献:
理论贡献:证明了 MAttr 的底层逻辑与积分梯度(IG)的数学等价性,并从理论和实证上打破了长期以来阻碍梯度归因发展的“不可能性定理”。 方法贡献:提出了一种统一、高效、且训练极其稳定的归因框架(MAttr),既能用于激活值层面的回路发现(Circuit Discovery),也能用于权重层面的行为溯源。 实证贡献:不仅在 MIB 基准上刷新了 SOTA,更在对齐(Alignment)研究中做出了重大发现,量化证明了 LLM 的安全微调(Safety-tuning)在权重空间中是高度稀疏和局部化的。
提升:
准确性与紧凑性:在 MIB 榜单上,CPR(神经回路忠实度)指标从 1.95 飙升至 5.6(提升超过 180%),同时在 Compactness(紧凑性,即发现最小有效回路的能力)上显著优于此前的掩码搜索方法。 计算效率:相比于因果干预方法(需 次前向传播)或多稀疏度扫描的掩码方法,MAttr 仅通过一次训练即可获得所有稀疏度的排序,大幅降低了计算和时间成本。 反解构能力:在消除模型拒绝行为(Ablating Refusal)的实验中,传统方法需要修改超过 27% 的权重,而 MAttr 仅通过定位并回退 1% 的权重,就达到了相同的解除安全限制的效果,且未损害模型的通用能力(如 GSM8K、MMLU 跑分)。
不足:
静态归因的局限:目前 MAttr 学习到的是针对整个数据集的静态标量归因分数,而不是针对特定输入动态生成的归因(论文指出未来可通过训练元模型/特征提取器来解决)。 优化器敏感性:在更细粒度(如 MLP 神经元级别)的归因时,使用 Adam 优化器如果采用默认的 值会导致效果退化,需要仔细进行超参数调节(尽管 SGD 表现稳定,但效率较低)。 数据依赖性:依然需要高质量的配对反事实数据(Counterfactual pairs)或可靠的奖励模型(用于强化学习),在缺乏此类数据的复杂开放域任务中应用受限。
心得:
用“深度学习”做“可解释性”是未来的大趋势:过去的可解释性研究往往依赖于事后分析(如探针、线性近似)或暴力的因果干预。MAttr 的成功启示我们,可解释性本质上也可以被定义为一个可导的优化目标。只要设计出平滑的算子(如 sigmoid top-k)和巧妙的训练策略(如随机化 k),梯度下降本身就是理解黑盒模型最强大的手术刀。 对齐微调的“1% 幻象”与安全隐患:论文发现只需回退 1% 的权重就能彻底破坏大模型的安全拒绝机制,这是一个极其反直觉且令人细思极恐的结论。它表明人类花费巨大代价进行的 RLHF/SFT 安全对齐,在模型庞大的参数空间中只是非常表层、局部的一层“外衣”。这不仅解释了为何开源模型极易遭受“越狱”或微调攻击,也提示我们未来的模型安全研究必须走向更深层的分布式概念绑定,而非简单的行为抑制。 打破对数学公理的盲目迷信:此前学术界曾用“不可能性定理”判了梯度归因方法的“死刑”,理由是它们满足某些公理(如完备性和线性)就必然在反事实推理中失败。MAttr 的巧妙之处在于,它根本不追求这些严苛的数学公理,而是直接去优化下游任务的真实损失。这深刻提醒研究者:在 AI 这种高度复杂的非线性系统中,实用主义的、目标导向的优化往往比僵化的公理化定义更能逼近真相。
一句话总结:
本文提出了一种基于随机化掩码预算和可导 Top-k 算子的“套娃归因(MAttr)”算法,不仅在神经回路发现上刷新了 SOTA,更惊人地揭示了只需回退大模型 1% 的特定权重即可彻底瓦解其安全对齐限制,证明了将可解释性转化为端到端优化问题的巨大潜力。
Attributing language model outputs to their internal computations is an open problem in interpretability. Existing methods, which use causal interventions, gradients, or learnable masks, either are infeasibly expensive or struggle to identify actual causally-important internal computations. We propose framing attribution as the problem of identifying nested subsets of internal components which minimise a downstream loss. To learn this task, we introduce Matryoshka Attribution (MAttr), a mask learning method that parametrises the mask with a simple differentiable sigmoid top-kk operator. We supervise training over all sparsities simultaneously by randomising kk over training, resulting in a learned ordering of components by attribution score. MAttr achieves number 1 on the official leaderboard of the Mechanistic Interpretability Benchmark (Mueller et al., 2025); our method identifies sparse and task-transferrable circuits across varying circuit bases. As a practical application, we show that MAttr can be trained with reinforcement learning to identify weight changes responsible for downstream behaviours in LLM finetuning. We train MAttr on refusal judge scores and find that restoring 1%1% of Llama 3.1 8B Instruct's weights to their base model state is sufficient to remove refusals while maintaining capabilities. We view MAttr as a successful formulation of interpretability into a learnable objective that we can tackle with gradient descent, and encourage future work along these lines.
https://arxiv.org/abs/2609.25518