ARTICLE · 1069413
AI 写了代码,对话怎么像 Commit 一样被 Review?
AI 写了代码,对话怎么像 Commit 一样被 Review?
Cursor、Claude Code 写一下午,改动进了 Git。
对话呢?
往往只活在本机。换台电脑就没了,想让同事看「AI 为什么这么改」,也翻不出来。
代码能 Review,对话不能 Review——这个缺口,越来越碍事。
entire CLI 给了一个很干脆的答案:把一次 Agent 会话打成 Session / Checkpoint,推进仓库专属分支。本地够用了。
平台化是另一件事:成千上万个仓库,页面一点就要出列表。真相可以在 Git 里,读路径不能每次都去 git 树里散步。
本文讲:Agent Session 是什么,我们怎么做成平台可读服务,以及社区场景下故意做了哪些容量与失败取舍。只谈定下来的骨架,不谈口号。
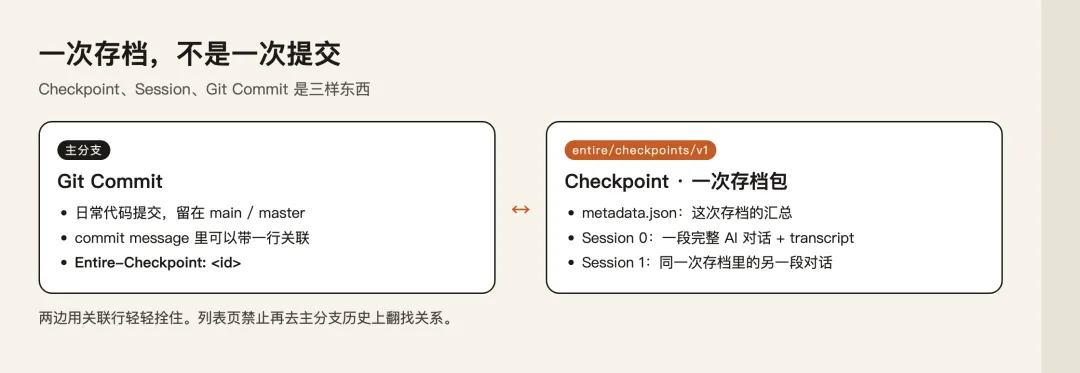
一、先把三个词拆开
| Git Commit | |
| Checkpoint | |
| Session |
CLI 不替代 Git,也不改你的主分支工作流。你照常提交;它额外把「聊了什么、动了哪些文件」收成存档,落在分支 entire/checkpoints/v1。
实践里,主分支某个 commit message 末尾常带一行:
TEXT
Entire-Checkpoint: <checkpoint_id>
代码提交和那次对话存档,用这一行拴住——它们不是同一个对象。
本地:CLI 读写这条分支就够。
平台:要在仓库页打开 Entire,回看 Session;数据格式不改,真相仍在 Git。难的是读。
二、平台化难在哪?
难不在「能不能存」,而在「能不能快读、稳读」。
几个典型坑:
1. 列表每次 walk git / revwalk:仓库一多,页面先死在 IO 上。
2. 网关里顺便解析 Git:权限和读逻辑缠在一起,多实例后锁、缓存、索引版本要谈两遍。
3. 还在克隆就当失败:用户狂刷,队列被打爆。
4. 盘当第二套源:副本堆满;或者全局并发计数器一泄漏,全员空等。
下面几条,是我们后来舍不得改的骨架。
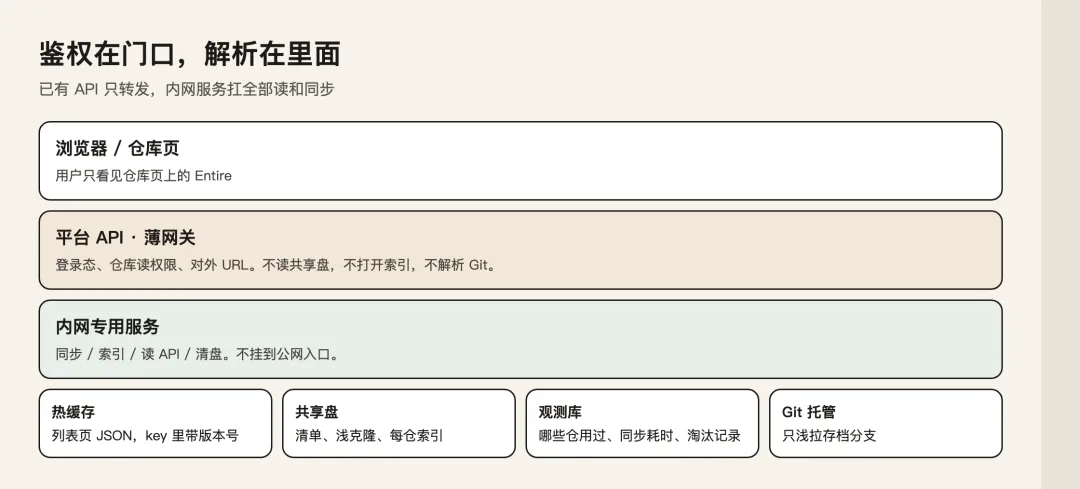
三、认人在门口,解析在里面
曾经有个省事想法:已有 API 层直接读盘,后台只负责拉仓。
共享盘、本地索引、多实例一上场,这个想法就站不住。读逻辑一旦拆到两个进程,失效和版本就要谈两次。
所以边界定死:
• 门口:登录态、仓库读权限、对外 URL。核对完转发。不读盘,不打开索引,不解析 Git。
• 里面:同步、建索引、读接口、清副本。只走内网,不挂公网入口。
权限不拆两份,解析也不塞进网关。门口认人,里面干活。
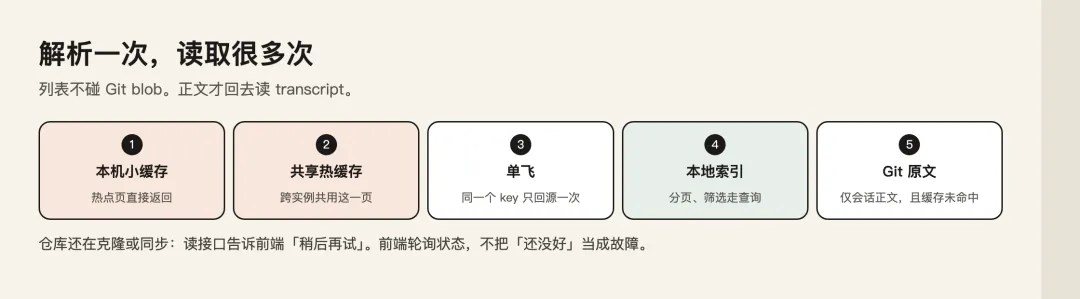
四、解析一次,读取很多次
写和读的节奏完全不一样。
同步可以慢:冷却拉取;有人往存档分支 push,再及时拉。打开页面必须快。
做法就一句话:
Git 留原文,索引留目录,缓存留热页。
同步完成后,把散落的元数据解析进该仓本地索引。列表、分页走索引。正文仍在 Git,只有打开 Session 详情、且缓存未命中,才读原文。
热页 JSON 放进跨实例缓存;同一页同时打空,只允许一个回源。列表不塞大段对话。
克隆也克制:只浅拉存档分支,不把主分支全部历史拖回家。
那为什么不把对话双写进数据库?
平台化时最容易想到的捷径是:同步时把 transcript 抄进库,列表和详情都查库。
我们没这么做。不是做不到,是账算不过来:
一句话:平台做的是「可读的缓存与索引」,不是「第二套存档系统」。 存的职责交给 Git 和 CLI;平台只解决「很多人、很快、看摘要」这件事。
五、还没好,就老实说还没好
第一次打开某个仓,盘上可能还没有副本。
这时如果回「失败」,前端当故障,用户狂刷,同步队列跟着炸。
正确姿势:
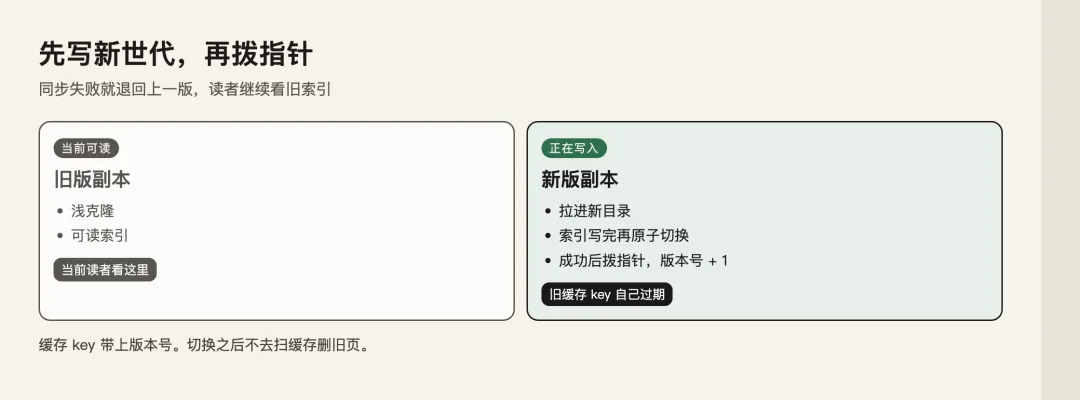
• 同步进行中:告诉前端「稍后再试」,轮询状态;读路径立刻返回,不阻塞后台。有旧副本也不在同步中当「已就绪」糊弄过去——避免读到半成品。
• 同步失败、且盘上还有上一版:状态退回可读,继续看旧索引;后台下次再试。
• 同步成功:写入新目录,索引写完再拨指针。缓存 key 带版本号——换代后旧页自然失效,不必扫缓存做删除。
这是很朴素的蓝绿思想:先写新世代,再拨指针;拨之前,读者要么等,要么看已确认就绪的上一版。
六、盘是缓存;限额跟着进程死
共享盘上的副本会满。路径按仓库稳定 ID 排布;淘汰看「多久没人看」和磁盘水位——不靠全盘扫目录找谁该删。
删的是热副本。Git 上的存档还在,下次打开再拉。
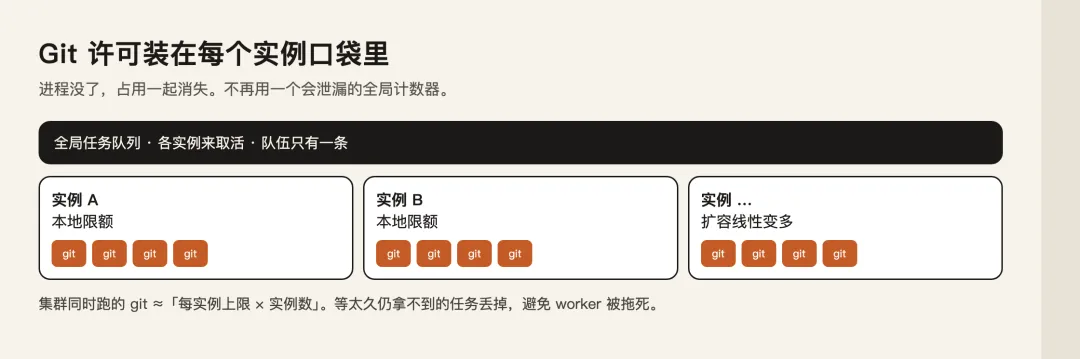
同步要跑 git,不能无限开。
全局共享一个计数器?实例挂掉,占用容易泄漏,后面全员空等。定时清零更糟:分不清泄漏还是在用,一清就超卖。
改成:每个实例自己限流。进程没了,占用一起没。排队太久仍拿不到许可,任务直接丢弃——系统过载时,worker 不能被拖死。
私仓短期凭证只在内存里喂给 git,不写进清单、日志、缓存。盘可以被拷走,上面不该躺着能再克隆一遍的钥匙。
七、社区平台的取舍:有上限,且快速失败
企业内网一个仓、几个人看,和社区平台「仓库海量、访问稀疏、偶发尖峰」不是同一类问题。
后者有两条铁律:
容量必须有天花板;失败必须尽早、说清楚。
否则一次热门仓库打开,会拖死整盘、整队列、整页体验。
容量:故意不全收
page=99999 | ||
这些不是偷懒,是用产品边界换系统存活。
社区场景里,绝大多数仓库很久才被点开一次;真正被频繁回看的,永远是那一小撮。热副本、热页、近期索引,够用了。副本被淘汰后,下次打开再拉、再建索引——慢一点,总好过把共享盘堆满后全站一起慢。索引本身也只保留最近一批:更早的 Checkpoint 仍在 Git 里,但列表不承诺「全历史无限翻」。
同步也故意低频:默认冷却一段时间再拉;有人真往存档分支 push,再及时跟上。读多写少,不能让「多刷几次页面」变成「多打几次全量 fetch」。
快速失败:别让用户猜,也别让队列堵死
社区流量的特点是:冷启动多、无效仓多、用户手快。
所以失败要分层,而且要快:
1. 业务上没有 Entire 数据(比如根本没有存档分支)→ 明确告诉前端「不可用」,不要挂着转圈装忙。这是硬失败,越早越好。
2. 还在克隆 / 同步 → 不是故障,是「稍后再试」。前端轮询;读路径立刻返回,绝不阻塞 worker。这是软等待。
3. 系统已经过载(等 Git 许可太久)→ 直接丢弃这单,记失败、发告警。用户过会儿再打开会重新入队。宁可这一次失败,也不让 worker 无限挂死。
4. 半成品克隆超时 → 当僵尸清掉,释放锁和盘,别让坏状态常驻。
对照一下两种错误姿势:
社区平台要的是:该等的等、该拒的拒、该丢的丢。边界清晰,前端才好做体验;队列才不会被长尾拖垮。
一句话:
单仓体验可以「最终一致」;平台稳定性必须「有界 + 快速失败」。
八、小结
Agent Session 要像 Commit 一样可 Review,关键不是再发明一种存储,而是:
1. CLI 负责把对话收进 Git;平台负责让很多人能快读。
2. 认人和解析分开。 门口做权限,里面一个服务做完读和同步。
3. 解析一次,读取很多次。 Git 留原文,索引留目录,缓存留热页——不做 transcript 双写。
4. 还没好就说还没好。 同步中可重试,不要伪装成故障。
5. 版本写进缓存 key;限额跟着进程死。 换代自然失效,崩溃不留幽灵占用。
6. 容量有天花板,失败要分层。 不全收、不硬扛深分页;无效仓快拒,过载任务快丢。
AI 编程的对话,最后应该和代码一样,能被同事打开、能被以后的自己翻到。
平台要做的,是让这件事在很多仓库上仍然站得住——而不是在每一次点击里,再把 git 树走一遍。
适用与不适用
适用:仓库多、访问稀疏、要在页面上回看 Agent Session;愿意接受「列表只保证近期索引、正文按需读 Git」。
不适用:要求平台永久保存全量 transcript 副本、深度翻页到几年前每一条、或把对话当独立业务库强一致查询——那就该另做存档系统,而不是可读缓存。
写在最后
这套骨架我们落地时也踩过坑:一度想过「网关直接读盘」「transcript 双写进库」「全局计数器限 git」——后来都证明,社区仓库量级下撑不住。
如果你也在做 Agent Session / AI 编程可 Review,欢迎把你的取舍留言说说;转给正在踩坑的同事也行。
欢迎关注「码畜生活」,我们继续聊工程落地,不聊口号。
本文基于 2026 年平台化工程实践原创整理;CLI 数据格式参考 entire CLI。