ARTICLE · 1069691
NextAI丨文档解析,企业RAG真正的地基
你花了半小时扫描一份重要文件,兴冲冲地扔给AI让它总结要点,结果它回你一段“看起来很有道理但完全不对”的废话。也不能全怪AI,不同文件需要不同处理!
跨页大表切一半,表头和数据分家,图文混排的工程图纸,关键信息全在图里,文字提取一个不剩,这些文档,人看着都费劲,更别说让AI准确理解了。
文档解析这一步,是整个知识智能平台的“地基”。地基打不好,后面所有花哨的功能都是空中楼阁。
“检索质量的上限,在文档进库那一刻就已经定了。后面的向量模型再好、提示词再精巧,也补不回解析阶段丢掉的表格结构和图注。”
不押单一引擎,搞了个”解析能力位”
很多产品遇到解析问题,第一反应是“上一个最强的OCR引擎就行”。
但NextAI的做法是:不押注单一引擎,把解析做成可选可换的”能力位”。
为什么?因为不同文档适合不同的引擎。平台已适配十余家主流模型供应商家族,含Azure、阿里、百度、智谱、DeepSeek、Kimi、OpenAI兼容网关,以及客户自建的本地推理服务。新增一家按固定配方接入,不需要重构既有实现。
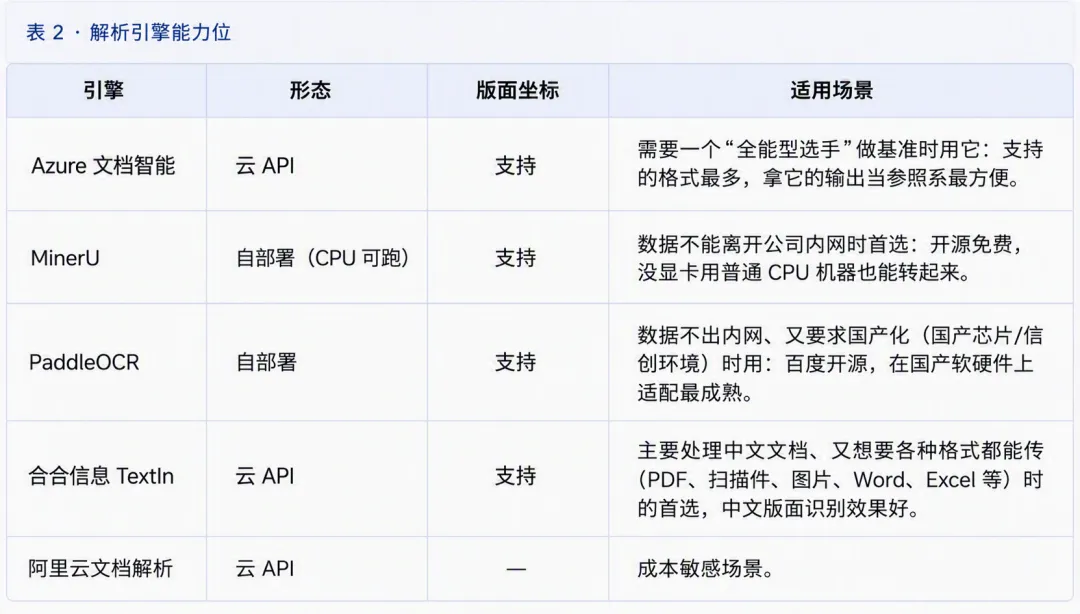
具体来说,平台集成了这些引擎:
Azure文档智能——参考实现,格式覆盖最广
合合信息TextIn——中文版式表现好,格式覆盖广
阿里云文档解析——成本敏感场景
MinerU——自部署CPU可跑,数据不出内网的首选
PaddleOCR——数据不出内网,国产化环境
这就像你去医院看病,不是所有病都挂同一个专家号。NextAI会根据文档类型自动选择最合适的解析引擎,做不到“一招鲜吃遍天”,但能做到“对症下药”。
解析三要素:保结构、标页码、留坐标
光有引擎还不够,解析出来的东西也得有用才行。
NextAI每次解析,同时产出三样下游要用的东西:
保结构的正文——标题层级、表格以结构化形式保留,而不是拍平成一段文字。
页码定位标记——正文中埋入不可见的页序标记,使得后续每个语义片段都能回答”我来自第几页”。
版面坐标——每个文本块/表格/图形在页面上的归一化矩形,支撑后文的”片段区域高亮”与自动裁图。
AI不仅要“读懂”你的文档,还得知道“这段话在第几页”、“这个表格长什么样”、“这张图在什么位置”。这样后续检索的时候,才能精准定位,而不是给你一堆散乱的文本。
图片不是被丢弃,而是连同语境一起理解
很多解析工具的做法是:图片直接丢弃。
NextAI不这么干,它会把图片连同语境一起理解:抽取图片时会一并取到图注、上方文本、下方文本与来源文件名,四条语境喂给视觉模型生成描述,再连同描述一起进入检索池。
什么意思呢?就是你上传一张设备故障照片,AI不仅能“看到”这张图,还能结合图注和上下文理解这张图说明了什么,然后在你对"设备故障”提问时,把这张图的相关描述也检索出来。
Excel和CSV不走寻常路
说到表格,很多RAG系统的做法是:不管什么格式,全部切成语义片段做向量检索。听起来合理?实际效果很灾难。
你想问”哪个季度销售额最高”,结果系统把两万行台账切成碎片,向量检索给你一堆不相关的片段,AI只能瞎猜。
NextAI的做法是:Excel与CSV走完全独立的一条管道——不做OCR、不做分块,而是还原成真正的数据表并落进一个查询引擎,后续由模型写只读SQL取数。
“把一张两万行的台账切成语义片段再做向量检索,既答不准’哪个季度最高’,也算不了合计。”
十余种分块策略,总有一种适合你的文档
文档解析完之后,下一步是“分块”——把长文档切成检索单元。
这一步在RAG领域有个说法:最被低估,但最决定效果。
切得太碎,答案缺上下文;切得太粗,检索命中率下降且提示词爆炸。
NextAI提供了十余种分块算法,按文档体裁选择:
通用类——递归切分、固定长度、滑动窗口、Markdown/HTML结构切分。
父子层级类——段落-句子结构、层级切分、Markdown 父子。子片段用于向量匹配(粒度细、命中准),命中后自动带出父片段作为上下文(信息完整);父片段只用于理解,不能被单独引用。
版面高保真类——借助版面坐标按真实排版结构切分,并为每个片段自动裁出对应的原文图像区域。
除了通用算法,平台针对几类高频文档体裁做了专门的切片策略:
手册切片——针对说明书、运维手册这类图文混排文档,按真实排版结构切分,并为每个片段自动裁出对应的原文图像区域。命中时片段能直接带出"第几页、哪个区域",答案可标注"见第 N 页",图文混合回答有据可依。
论文切片——摘要独立成片、标题与作者作为片段属性下挂、目录与参考文献降噪,并内置双栏阅读顺序回正。
演示文稿切片——按版面坐标保留每页幻灯片的真实结构,标题、正文、图表各归其位,图片连同图注与上下文一起理解后进入检索池,"这页片子讲了什么"也能被问出来。
表格感知——大表按行带拆分且每片重复表头,避免"表头和数据被切散"。Excel/CSV 则干脆不做分块,直接还原成数据表进查询引擎,由模型写只读 SQL 取数——两万行的台账切成语义片段再向量检索,既答不准"哪个季度最高",也算不了合计。
按真实Token计数切分——中文一个字约合1.3个token,按字符数设阈值会静默超出向量模型上限被截断,这一算法按真实token计数并保证硬上限。
另外还有智能分块建议:对文档抽样+统计特征,由模型推荐分块方法与参数,服务端对推荐值做范围钳制与白名单校验后再执行。
说白了就是:你不用自己折腾选哪种分块方式,系统会帮你推荐,但最终的”边界”由平台来守。
立即扫码获取免费账号
联系我们
杨女士
电话 Tel:021-33680778
邮箱 Mail:marketing@qinchengsoft.com
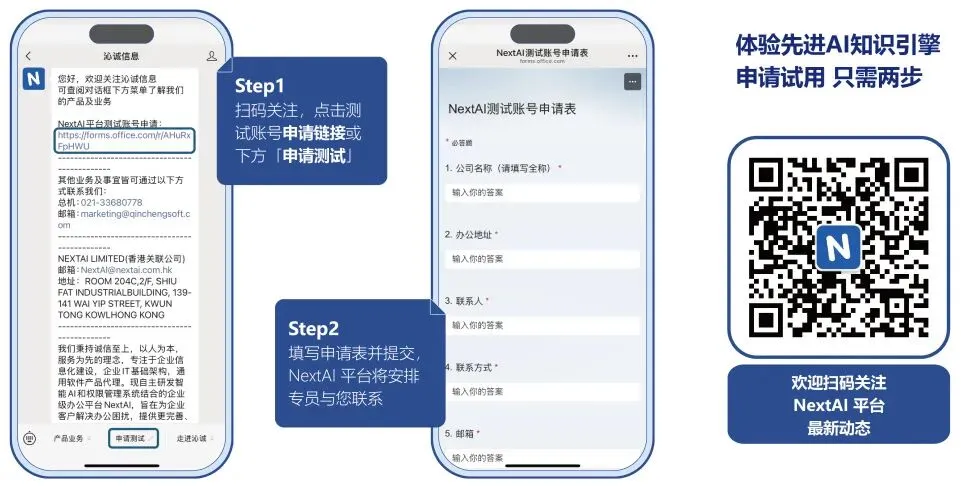
点击下方👇阅读原文抢先体验AI落地!