ARTICLE · 1075779
1+5文档包:医疗数据库从建设到发布的标准交付物清单
1+5文档包:医疗数据库从建设到发布的标准交付物清单
这两年,医院、药企、数据公司都在建库。专病库、高质量数据集、多中心研究平台,名字各不相同,走到最后都会遇到同一个问题:库建好了,拿什么证明它能用? 审稿人会问,CDE 会问,数据交易所和资产评估师也会问。问法不同,他们要看的是同一类东西:一套把数据库交代清楚的文档。 这篇文章把这套文档拆开来讲。国际上怎么要求,MIMIC 怎么做,国内建库团队怎样一次写好、多处复用。 01 先分清两类文档 讨论"数据库要写什么报告"时,很多人会把两件事混在一起。 第一类描述数据库本身,业内叫 data descriptor 或 data profile。目前国际上还没有像 CONSORT 那样被普遍采用的数据库报告指南,但事实标准是有的:Scientific Data 的 Data Descriptor 文章体例,数据仓储对元数据、版本和 DOI 的要求,再加上 OHDSI 社区的质量检查工具。 第二类描述用这个库做出来的研究。这一类有明确规范,就是 RECORD 系列。 MIMIC 能被全球研究者信任,一方面是第一类文档做得非常扎实,另一方面,它通过准入协议和引用要求,让每个使用者写论文时都得按第二类的规范来。 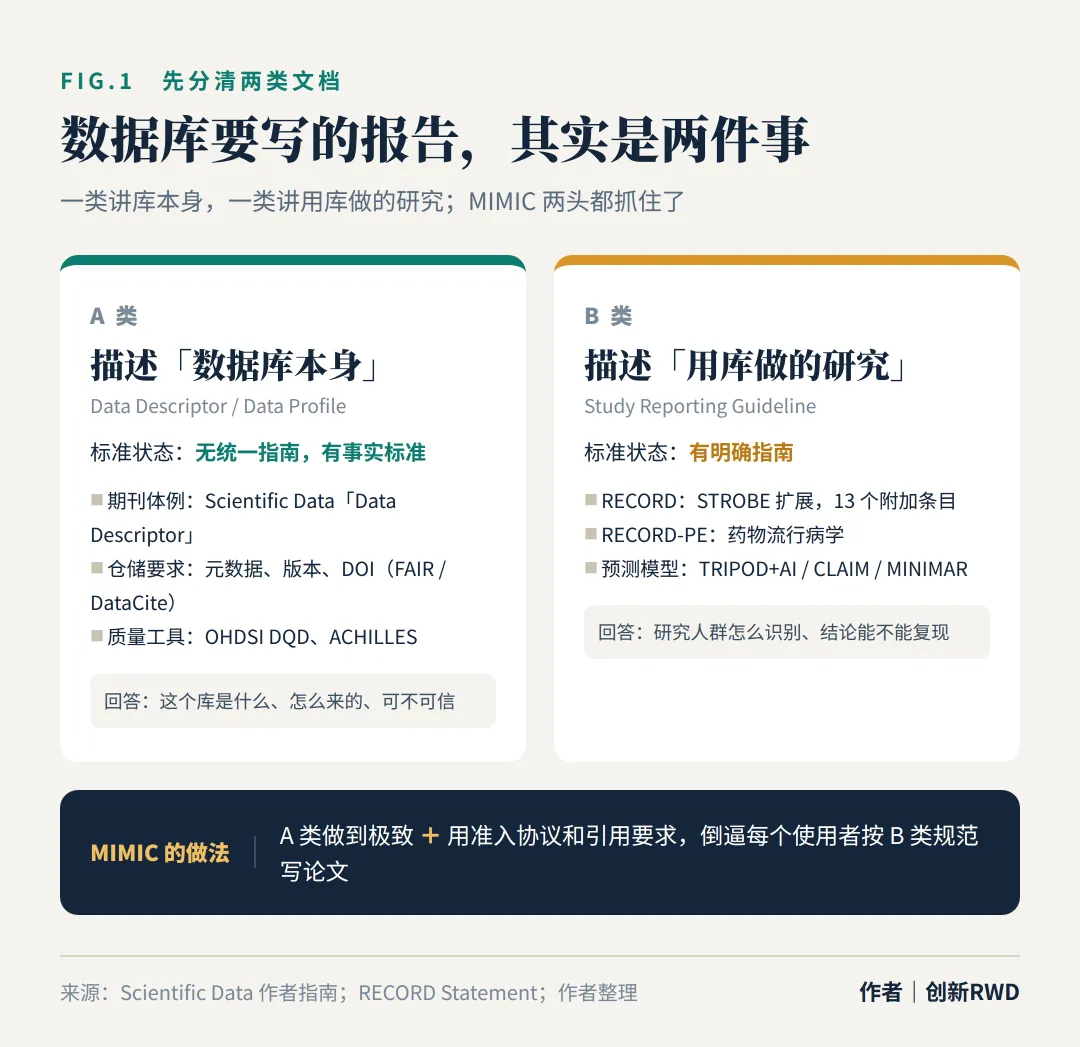
02 五层清单:哪一层不做,会卡在哪里 把国内外的强制要求和事实标准叠在一起,一个面向研究和流通的医疗数据库,交付物大致可以分成五层。 第一层,合规底线 伦理批件或豁免、去标识化方案及执行留痕、数据分级分类和安全评估、来源合法性证明;涉及人类遗传资源的,还要有审批或备案;对外开放时,需要数据使用协议(DUA)和用户凭证机制。依据是《个人信息保护法》《涉及人的生命科学和医学研究伦理审查办法》《人类遗传资源管理条例》,技术上可以参照 GB/T 37964-2019《信息安全技术 个人信息去标识化指南》。这一层缺了,库根本不能发布。 第二层,数据本体说明 数据字典与元数据、ETL 映射规则、纳入排除标准、时间轴定义、版本号与 DOI、技术验证、使用说明。Scientific Data 的 Data Descriptor 把 Technical Validation 列为必备章节,MIMIC-IV 就是按这个体例发表的(Sci Data 2023;10:1)。这一层没做好,论文发不出去,别人也不敢用。 第三层,质量报告 国内可以按 GB/T 36344-2018《信息技术 数据质量评价指标》的六个维度出报告:规范性、完整性、准确性、一致性、时效性、可访问性。国际上,OHDSI 的 Data Quality Dashboard(DQD)按 Kahn 框架跑 3300 多项检查,再配合 ACHILLES 做数据画像。在 EHDEN 这类协作网络里,这基本就是入网门槛。 第四层,研究应用报告 用库做研究时,要交代研究人群是怎么通过编码或算法识别出来的、编码有没有经过验证、多源链接的成功率和流程图、数据覆盖有哪些缺口。对应的规范是 RECORD(STROBE 的扩展,13 个附加条目,PLOS Medicine 2015);药物流行病学研究加用 RECORD-PE(BMJ 2018);预测模型研究看 TRIPOD+AI、CLAIM、MINIMAR。这一层写不清楚,审稿人会直接卡住。 第五层,监管与资产化 走注册路径,要对齐 CDE《用于产生真实世界证据的真实世界数据指导原则(试行)》(2021 年第 27 号),从相关性和可靠性两方面做适用性评价,可靠性又细分为完整性、准确性、透明性、质量保证和可追溯性。这份指导原则还专门讲了数据治理计划、通用数据模型、质量管理体系和监管沟通,说它是监管版的数据库报告指南也不为过。 走资产化路径,中评协《数据资产评估指导意见》(2023 年 10 月 1 日起施行)要求评估人员关注数据的信息属性,数据字典就明确列在其中。各地的数据知识产权登记则要提交来源说明、结构说明、处理规则、样例数据和合规承诺。以广东为例,审核用样例数据不少于 50 条,公示用不少于 3 条;北京的要求是审核 50 至 100 条、公示 2 至 5 条。具体以当地规则为准。 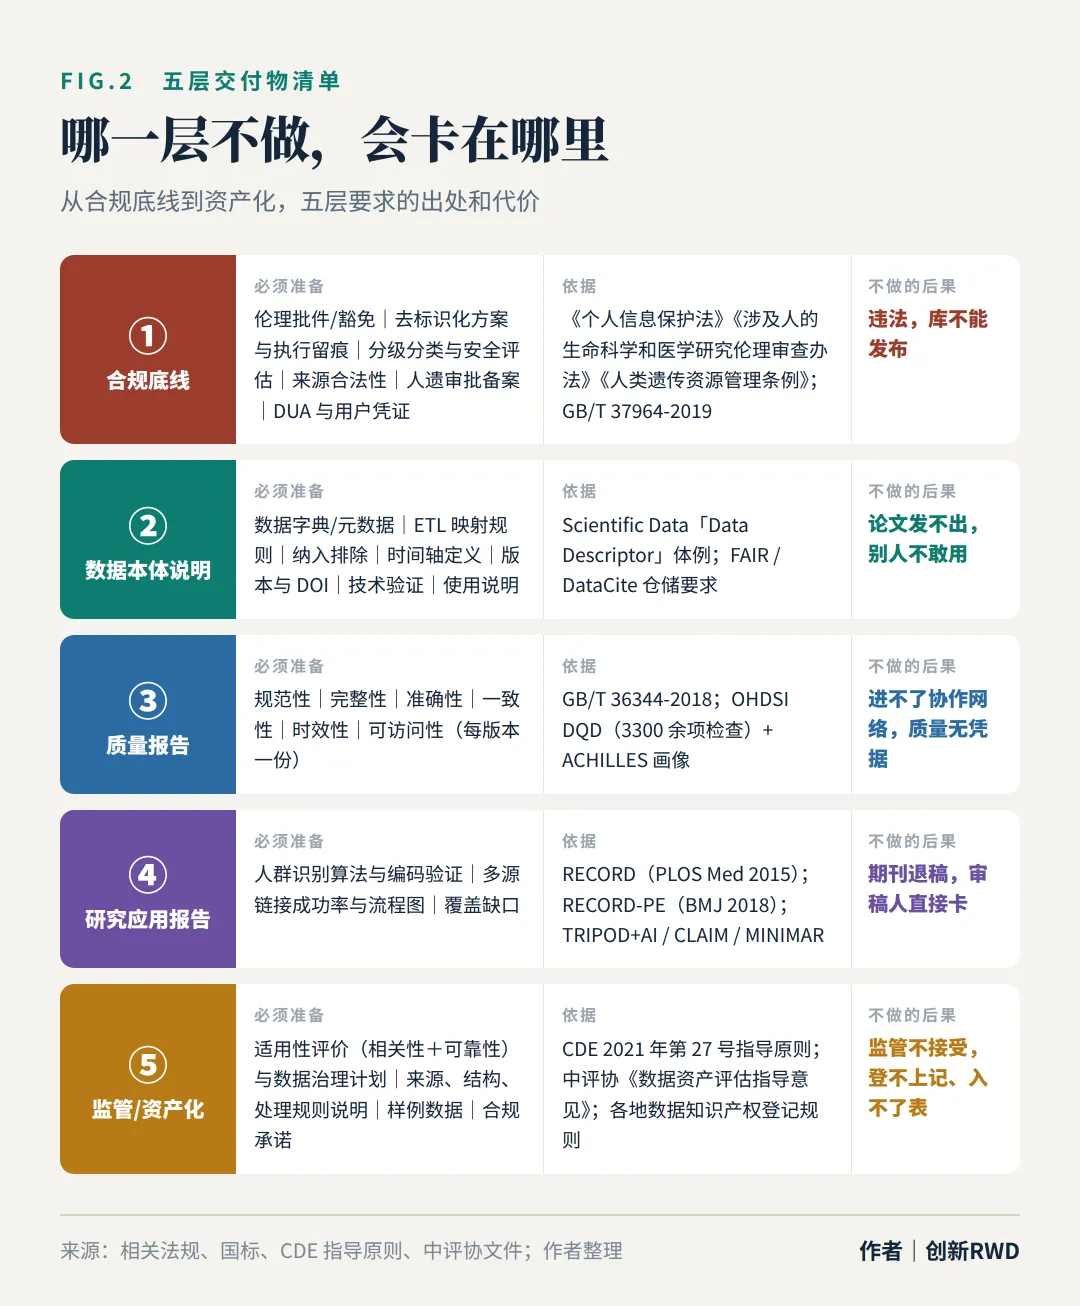
03 MIMIC 的做法,可以直接对标 MIMIC 从发布到被使用,每个环节都有对应的文件或机制兜底。 发布 放在 PhysioNet 仓储,每个版本有独立的 DOI(例如 MIMIC-IV v2.2 是 10.13026/6mm1-ek67),并规定了引用格式。 论文 以 Data Descriptor 形式发表,Methods、Data Records、Technical Validation、Usage Notes 几个部分都有。 准入 使用者要签署 Credentialed Health Data Use Agreement,完成 CITI 培训,并通过身份核验。 去标识 按 HIPAA Safe Harbor 处理,日期按患者随机平移,自由文本用规则加算法混合脱敏。说明文档里明确写了一条使用禁区:不同患者之间的日期不能直接比较。 衍生管控 衍生数据集要按同一协议共享,建议以 MIMIC-IV-Ext 开头命名。大模型普及以后,PhysioNet 又专门发文重申:数据使用协议禁止把数据交给第三方,经 API 发给在线大模型服务也算在内;确需使用,只能选择不留存数据的服务,或者在本地部署模型。 MIMIC 的文档并不算多,难得的是每条规则都落在一份具体的文件里。使用者能查到边界在哪,违规了也能追溯。 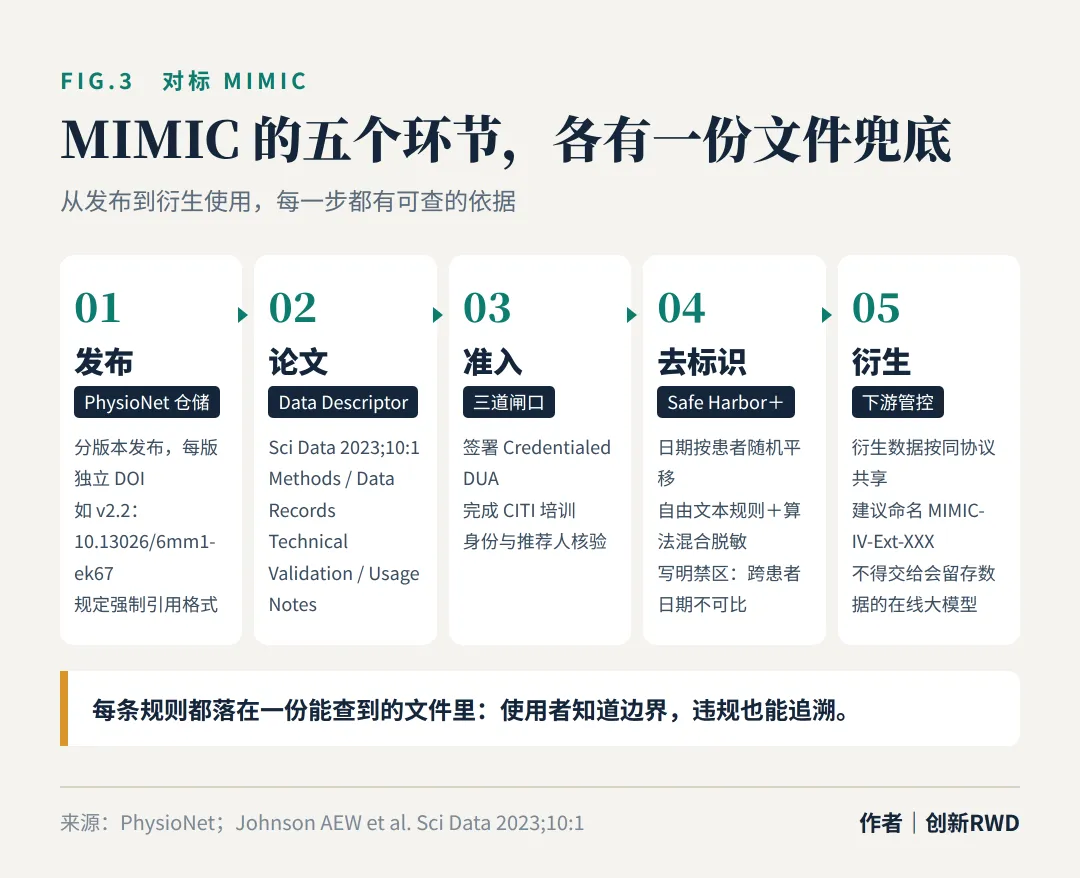
04 1+5 文档包:一次建设,多处裁剪 对国内建库团队来说,不管是医院做数据类科技成果转化,还是企业做数据知识产权登记和合规咨询,最省力的办法都是在建库过程中同步产出文档,别等到要用了再补写。我们把它归纳成"1+5"。 1 份核心:《数据说明书》 章节依次是:数据来源、纳入排除、采集与治理流程、去标识化方法、时间轴口径、数据字典、版本沿革、已知局限与使用禁区。其余五份文档,大部分内容都从这里裁剪出来。 5 份配套: 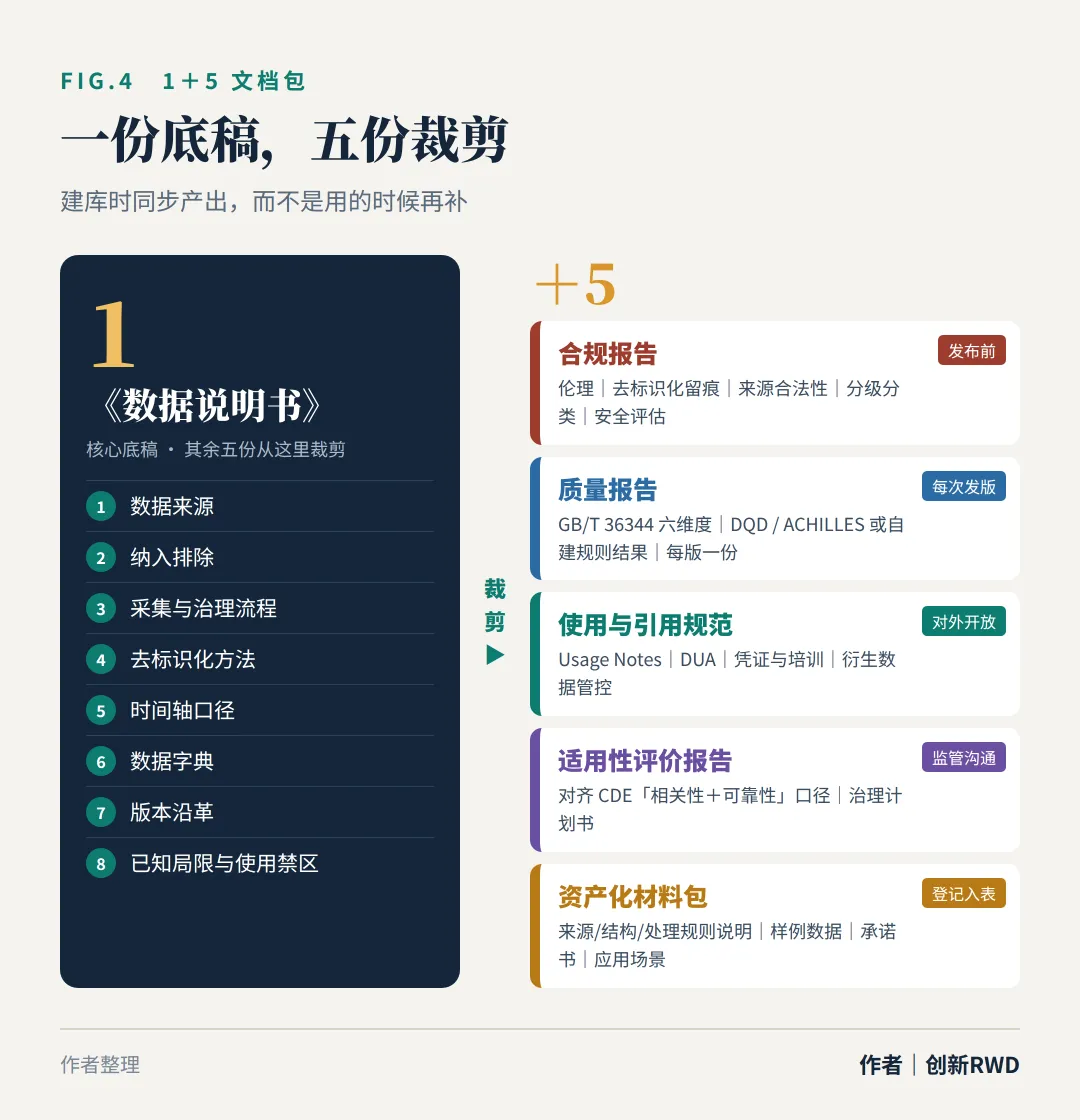
这样安排,最大的好处是改一处、同步多处。比如数据字典更新了,质量报告里的规范性检查、适用性评价里的透明性部分、资产化材料里的结构说明,跟着底稿改一次就行,不用在三份文件里分别改。 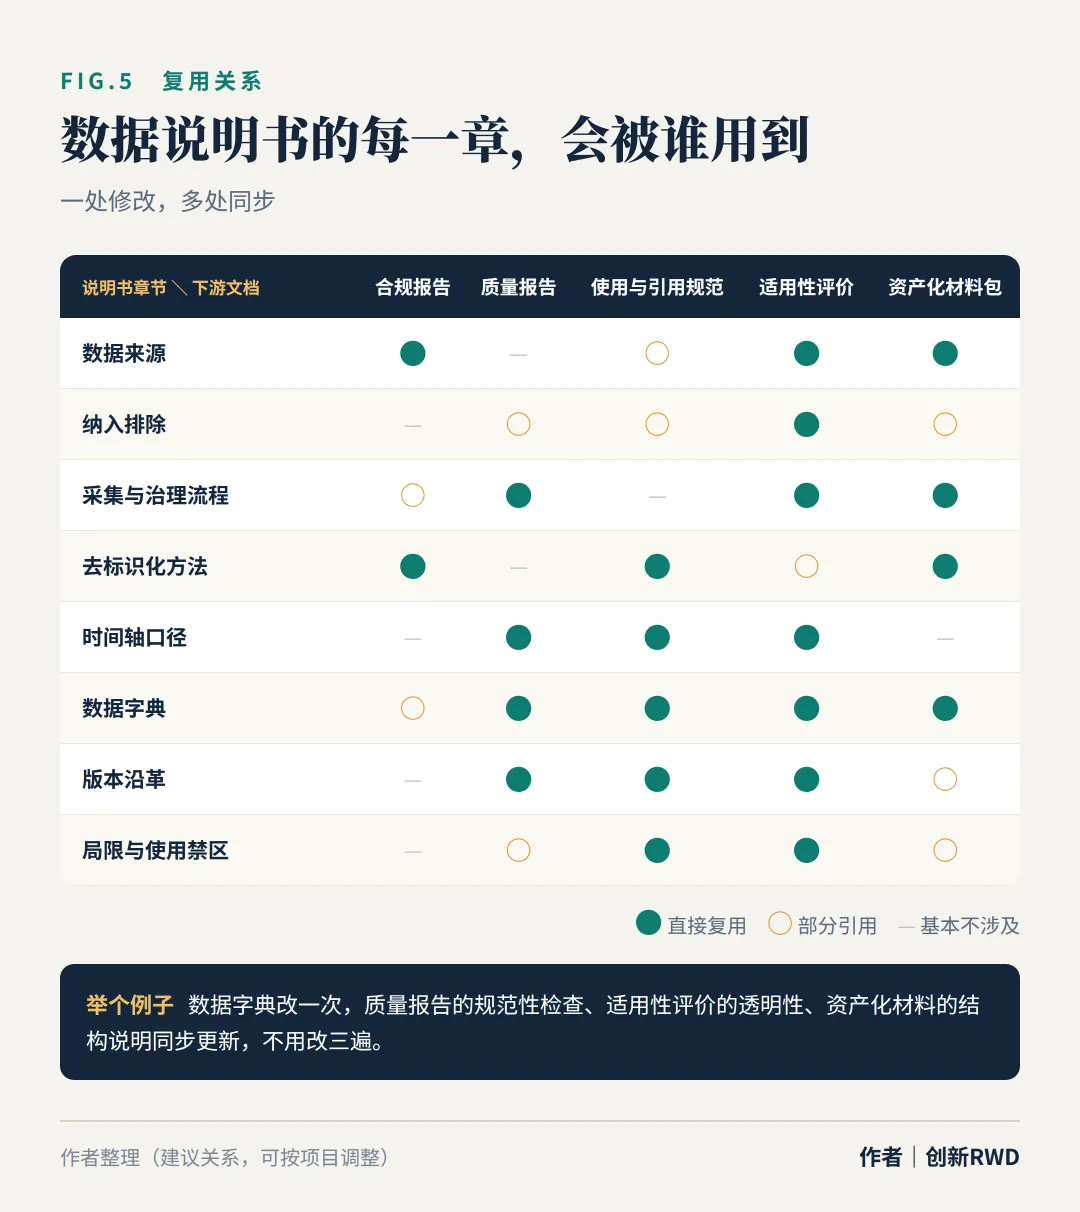
05 最容易踩的坑:两处留痕,事后补不回来 一处是去标识化留痕,一处是 ETL 映射留痕。 去标识化用了什么规则,哪些字段做了泛化或删除,日期怎么偏移,由谁在什么时间执行,如果当时没有记录,事后只能凭回忆,很难自证。ETL 也一样:源系统字段怎么映射到目标模型,编码怎么转换,哪些记录在转换中丢掉了,过几个版本就说不清了。 偏偏这两处是监管沟通、登记审核和同行评审最常追问的地方。 我们的建议是,把 OHDSI 的 WhiteRabbit 扫描报告和 Rabbit-in-a-Hat 映射文档直接作为交付物存档,去标识化则按批次保留执行日志。花的功夫不多,后面所有文档都要用到它们。 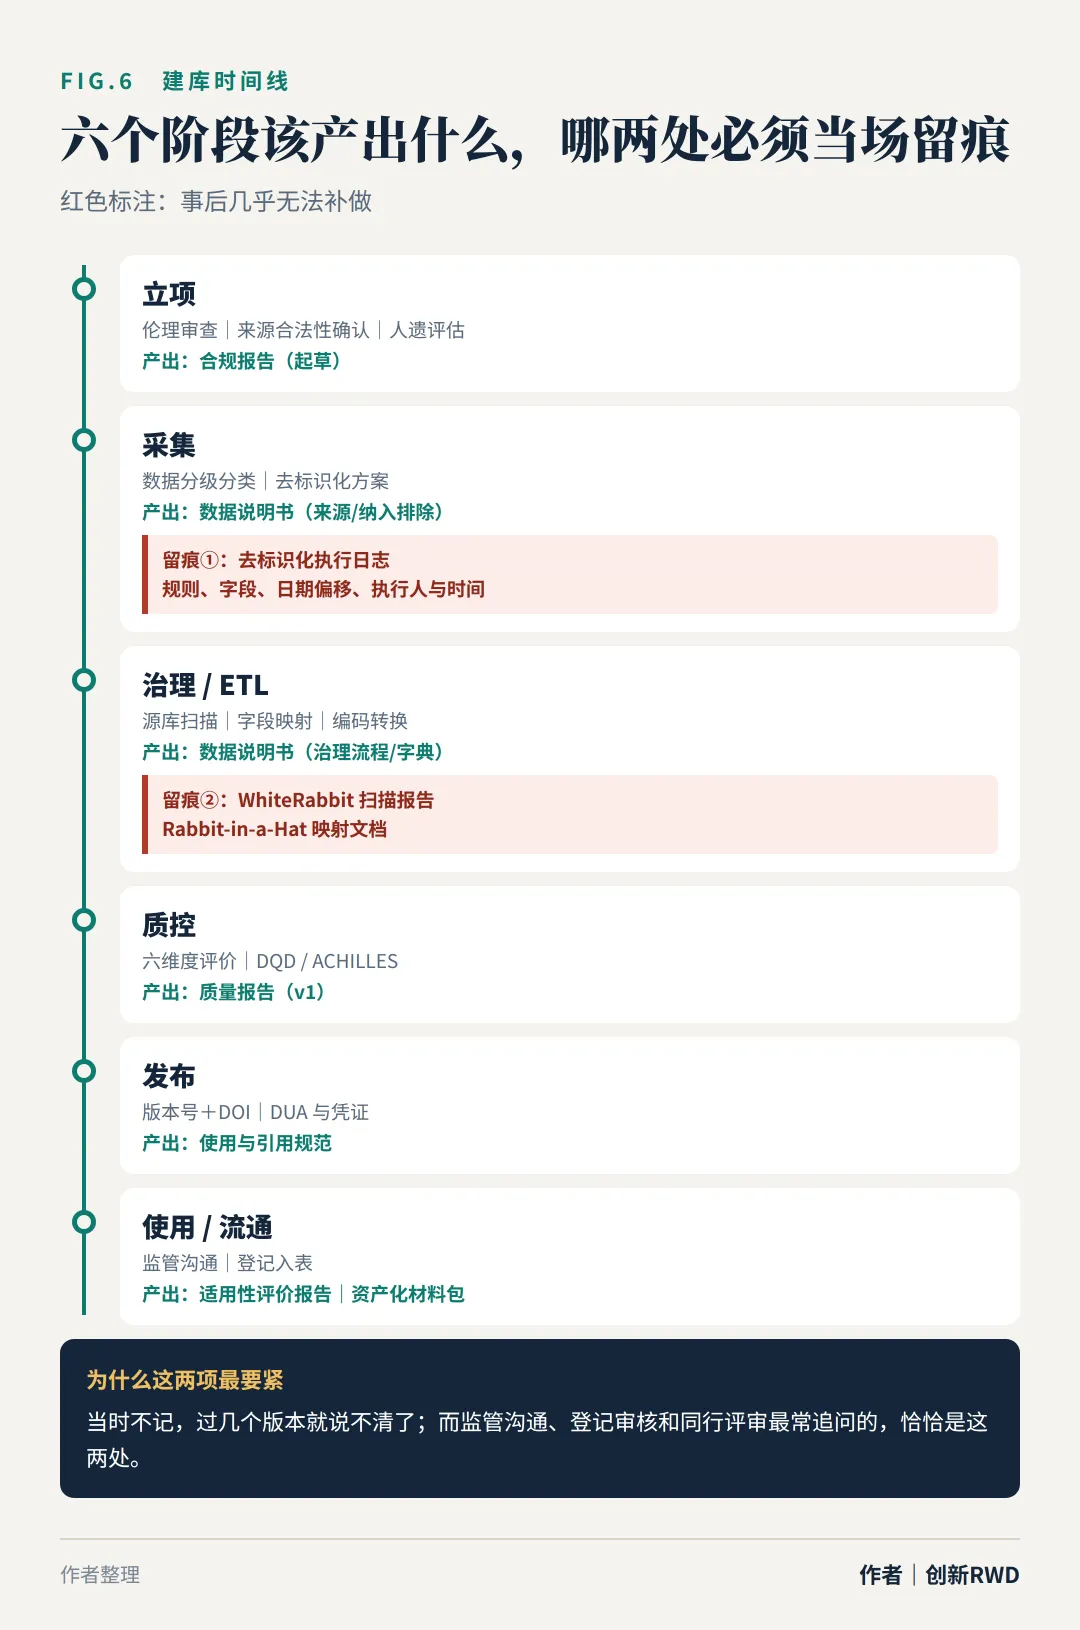
06 建库第一天,就把目录建好 一个数据库有没有价值,最终取决于别人愿不愿意相信它。审稿人、监管机构、交易所、评估师各看一个角度,但他们要的都是一套前后对得上的文档。 与其每来一个需求就补写一份,不如在建库第一天就把"1+5"的目录建好,边建边填。等到发布那天,这些文档已经齐了。 你在建库时,最头疼的是哪一份文档?欢迎在留言区聊聊。
《合规报告》:伦理、去标识化留痕、来源合法性、分级分类、安全评估。 《质量报告》:按 GB/T 36344 六个维度出具,附 DQD/ACHILLES 或自建规则的运行结果,每发一个版本出一份。 《使用与引用规范》:使用说明、DUA、凭证和培训机制、衍生数据管控条款。 《适用性评价报告》:监管版,严格对齐 CDE 的"相关性 + 可靠性"口径。 《资产化材料包》:来源说明、结构说明、处理规则说明、样例数据、承诺书、应用场景。