ARTICLE · 1075860
企业知识库图谱实战 01|文档能搜到却串不起来,什么问题值得用知识图谱解决
1. 文件都接进来了,为什么问题还是答不全
假设一家企业已经接入制度 PDF、报销 FAQ、流程图和工单,关键词和向量检索也能把“差旅住宿标准”找出来。真正卡住的问题是:华东新规何时替换旧规?它影响哪些报销字段、审批节点和出差人员?某个例外到底是集团规则、区域补充,还是失效的历史通知?
本文使用假设案例,不代表某家企业的线上实测。场景有四个约束:内容来自多个来源,新旧版本同时存在,政策要落实到不同系统,答案还必须回到原文。在这些约束下,先找准用户卡在哪一步,比先决定是否购买图数据库更重要。
2. “搜得到”与“串得起”差了什么
员工问:“王敏下周去杭州,住宿上限是多少,报销单里该选哪个费用标准?”一次普通检索可以返回《2026 年华东差旅办法》第 3.2 节,也可能同时返回旧版集团制度和一篇报销培训稿。若员工愿意阅读、比较日期、确认职级,系统已经完成了一个有价值的“找资料”任务。
但若问题变成“华东新规影响了哪些报销字段与审批规则,哪些人需要重新培训”,答案需要跨越制度、区域、岗位、费用标准、表单字段、流程节点和培训通知。这里的难点不是再找一段更相似的文字,而是确认对象是不是同一个、关系从哪里来、关系在什么时间内有效,以及每一步能否回到证据。
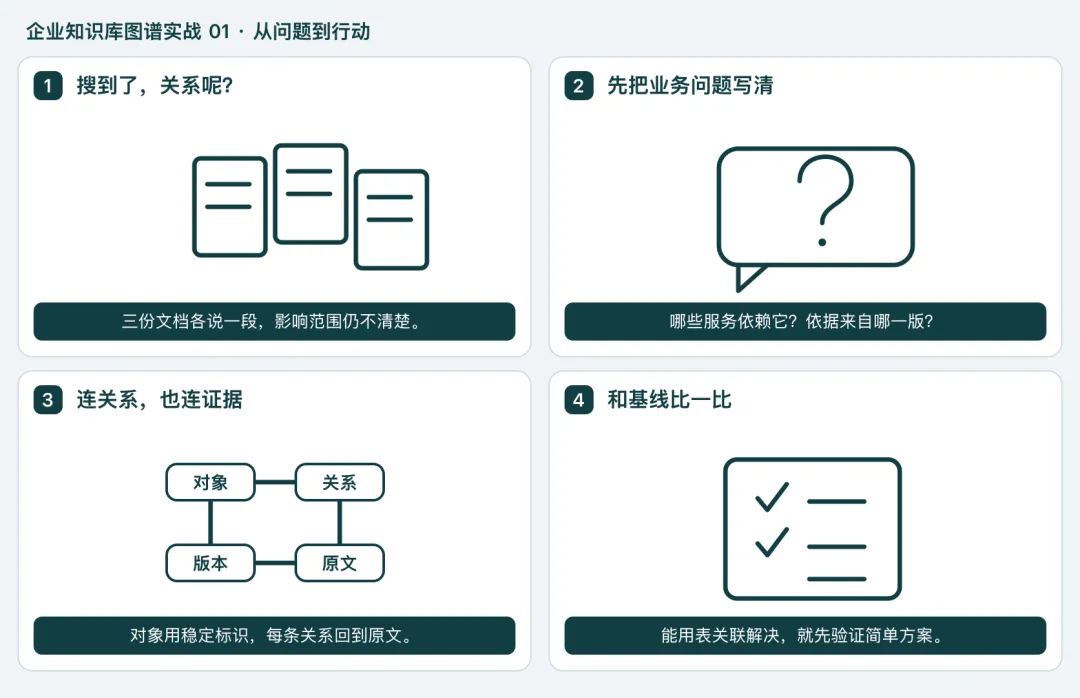
知识图谱的增量价值,恰好是把这类可识别对象和关系组织起来;它不是把所有句子改写成三元组,更不是把“相关”自动变成“事实”。Hogan 等对知识图谱的综述把图、标识、语义和查询放在同一问题域中,也提醒我们:不同实现对“知识图谱”的边界并不相同。[1]
3. 先别冤枉 SQL:多跳不等于必须用图
“多跳”常被当作上图的充分理由,其实不是。若报销系统里已有 policy_version、region、grade、form_field 和明确外键,一条 SQL join 完全可以得到“此规则影响哪些字段”。关系型数据库擅长事务、精确过滤、聚合和稳定的主数据;已经维护良好的表关系,不应为了视觉上像图而复制一套复杂系统。
图的优势出现在关系类型不断增加、路径不是预先固定、对象跨多个源系统,且查询本身要解释路径时。比如“从某项区域政策出发,找所有仍在生效、会影响报销系统且涉及外包员工的依赖链”,关系方向、时间、来源和中间节点都属于答案。此时图查询可以让路径成为一等对象;但它仍需与 SQL、全文和原文证据协作。
因此,第一条工程纪律是:能用现有表和受控 join 清楚回答的,不因“多跳”盲目迁图。图谱应该承担已有表示不易维护或不易解释的增量部分,而不是替换一切。
4. 向量检索解决相关性,不负责保存事实
RAG 的原始工作把语言模型与可检索的非参数记忆结合,展示了外部检索可让知识更新和检查成为可能。[2] 这为企业知识库提供了很重要的一层:用户换一种说法,系统仍有机会找到语义相近的段落。但向量分数表达的是某个嵌入空间中的接近程度,不是“这条规定依赖那张表单”的受控事实,也不包含唯一身份、适用时间或撤销链。
在连续案例中,向量可以找出“住宿上限”“差旅标准”“酒店费用”等候选文本;它不能单独判定两篇同名《差旅管理办法》是否同一版本,也不能证明“华东补充规则覆盖集团规则”的优先级。把向量当事实库,常见后果是旧版文本仍然相似、同名实体被混在一起、生成答案把两段话拼成一条并不存在的规则。
正确的组合不是“向量或图谱”,而是原文提供证据、元数据做权限和时态过滤、向量召回表达相近的内容、图保存经治理的实体与关系。每一层都要明确自己不负责什么。
5. GraphRAG 也不是一键变准
Edge 等人提出的 GraphRAG 方法会从文本构建实体关系图和社区摘要,用于回答面向整个语料的全局归纳问题;其第 6.1 节是在两套各约 100 万 token 的语料上,以 LLM-based 评价报告特定数据和任务设置下的结果,而不是所有企业问答的通用收益。[3] 它的启发是:如果业务真正问“这批制度里反复出现哪些依赖模式”,图结构和社区摘要可能比逐段检索更合适。
回到“王敏的住宿标准”,这是一个具体对象和具体规则的问题。首先应走权限过滤后的原文、元数据和局部关系路径;不能因为用了 GraphRAG 就跳过规则版本核验。若要问“过去半年哪些区域政策更新最常牵动报销流程”,再把它列为全局归纳试题,和混合检索基线一起比较。
图不会自动更准。错误实体链接会让错误关系聚合,自动摘要会放大上游遗漏,社区划分也不是业务组织结构。GraphRAG 是一条成本更高、准备更重的检索与上下文组织路径,不是“知识图谱已建成”的同义词。
6. 用四个问题决定是否值得试
不要先问“我们有没有图数据库”,先让业务和知识架构师共同回答四个问题。第一,问题是否反复需要稳定对象 ID,例如同一制度、系统、人员或项目在多源材料中的对应?第二,答案是否必须展示两步以上且不固定的关系路径?第三,是否需要处理冲突、有效期、来源或关系约束,而不是只给一段相似文本?第四,问题的价值是否足以覆盖实体治理、抽取、审核和增量更新的持续成本?
四项都是否时,优先改善内容质量、元数据和混合检索。只有第一项为是时,先补主数据、别名和映射表。出现第二、第三项时,才值得设计一个局部图试点。第四项不能回答时,不应把试点扩展到全库:这通常说明问题没有被业务验收,而不是技术栈还不够新。
试点应先用少量高风险、高频、跨源的问题验证关系层,不把节点数和边数当成成果。
7. 一个最小试点怎样落地
第一期只选择“差旅政策变更影响报销流程”这一条链。业务产品负责人提供十个真实但脱敏的问题和业务后果;制度负责人确认规则、例外与生效时间;数据工程师给出文档版本、报销字段和流程节点的稳定 ID;知识架构师定义 appliesTo、supersedes、affectsField、requiresApproval 四类关系;搜索工程师负责把图路径与原文片段共同交给回答层。
输入不是“所有文档”,而是已确认的制度版本、区域补充、字段字典和流程配置。输出也不是一张漂亮网络图,而是可查询的发布断言:每条断言至少有主体、关系、客体、来源文档、版本、原文定位、有效期和审核状态。模型抽取只能产生候选;候选先过类型、时间和来源门禁,再由领域负责人抽样或审核后发布。
这些关系可以用 RDF 的主语、谓语、宾语表达[4],也可以采用属性图;存储形式不会自动补上缺失的来源与有效期。责任划分是为了追错而不是制造流程:制度负责人对规则含义负责,数据工程对 ID 和同步负责,知识架构对关系语义负责,搜索团队对检索与引用呈现负责。谁都不应以“模型给的”为理由把事实责任交出去。
8. 反例比演示更能决定要不要继续
试点必须包含几类故意为难系统的反例。第一,同名的集团旧版和华东新版并存,系统不该静默合并。第二,某条培训通知提到“执行新标准”但没有规则正文,它不能凭措辞生成覆盖关系。第三,报销字段改名而 ID 未变,系统应标出映射而非当作新增字段。第四,制度已经废止,任何路径都不能把它作为当前依据。
还要保留一个“不该用图”的问题:“华东地区住宿上限是多少?”若它在单篇当前制度中即可有明确定位,图路径不能比原文路径更慢、更难解释、更容易越权。把这类负例留在评估集中,能防止团队只挑适合图谱的题目庆功。
9. 验收看路径、证据和代价,不看图有多大
首批验收集应为每个问题保存允许的实体、关系路径、原文定位和拒答条件。建议至少报告四个口径:路径正确率,即关键关系方向和中间节点是否正确;证据覆盖率,即发布关系能否回到对应版本和原文位置;错误合并率,即不同对象被错误视为同一对象的比例;增量维护时延,即文档更新到旧断言撤销、索引更新完成的时间。
再把图路径与现有混合检索放在同一问题集上,按问题类型分别比较。若跨文档影响分析的路径正确率提高、引用仍可核验、人工审核分钟数在可承受范围内,才说明图层有边际价值;若单文档问答没有改善或成本明显上升,就应收缩范围。这不是失败,而是避免把本该留给原文和 SQL 的任务搬进图里。
指标还要锁定分母。路径正确率可以定义为“经人工核验全部关键跳均正确的返回路径数 / 抽检返回路径数”,同时报告应该返回却遗漏的路径,防止只返回一条最容易的路径就拿到高分。证据覆盖率以抽检发布断言为分母;错误合并率以抽检的已合并实体对为分母,并单列涉及权限、金额的严重错误。维护时延则记录每次更新的起止事件,不混用文件上传时间与政策生效时间。
评估样本应与调试样本分开。团队可以先用一批问题完善模型,再在未参与调试的问题上复测;规模不足时就如实报告样本数和逐题结果。少量试题的满分不等于全库可靠,但足以决定是否继续投入下一轮。
10. 小结:图谱是关系证据层,不是企业真相机器
知识图谱最值得解决的,是“资料分别都找得到,但对象、关系、时间和责任串不起来”的问题。普通 SQL 可以多跳,向量可以召回,GraphRAG 可以组织某些全局问题;它们都不是图谱的对立面。真正的判断标准是:是否存在可验证的跨源关系问题,是否能维护稳定 ID 和来源,是否愿意持续承担更新与审核。
下一篇从“要不要建图”继续往下走:原文、表格、向量与图谱如何各司其职,避免把一种表示误当成全部知识。
参考文献
[1] Hogan, A. et al. Knowledge Graphs. 2021. https://arxiv.org/abs/2003.02320
[2] Lewis, P. et al. Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. 2020. https://arxiv.org/abs/2005.11401
[3] Edge, D. et al. From Local to Global: A Graph RAG Approach to Query-Focused Summarization. 2024. https://arxiv.org/abs/2404.16130
[4] W3C. RDF 1.1 Concepts and Abstract Syntax. 2014. https://www.w3.org/TR/rdf-concepts/