ARTICLE · 1078859
AI互连(二):Scale-up,如何把多颗GPU组织成一个计算域?
最简单的情况,是由一颗GPU独立完成整个计算任务。
但单颗GPU的算力和HBM容量都有物理边界。随着模型规模、上下文长度和并发增加,一颗GPU可能装不下整个模型;即使能够装下,也可能无法满足训练速度或推理延迟的要求。
于是,一个完整的计算任务开始被拆到多颗GPU上共同完成。
当原本发生在一颗GPU内部的计算和数据依赖被拆到多颗GPU之间,GPU之间的通信就开始成为计算的一部分。
Scale-up,就是为了解决这个问题。
一、什么时候需要Scale-up
使用多颗GPU,并不一定需要Scale-up。
如果8颗GPU分别处理8个完全独立的任务,它们之间几乎不需要通信。增加GPU,只是增加了8份独立计算资源。
真正需要Scale-up的,是多颗GPU共同完成同一个计算任务。
比如Tensor Parallel(张量并行)会把同一层矩阵运算切到多颗GPU。每颗GPU只计算其中一部分,只有把不同GPU产生的中间结果重新组合,才能继续下一层计算。
Expert Parallel(专家并行)则把不同Expert放在不同GPU上。一个Token经过Router以后,需要被发送到对应Expert所在的GPU,计算完成以后再返回,因此一个MoE层可能产生大量All-to-All通信。
Context Parallel(上下文并行)会把过长的上下文拆到不同GPU,Attention计算过程中也需要继续交换中间结果。
这些并行方式虽然切分对象不同,但都会产生同一个问题:
一颗GPU产生的数据,可能是另一颗GPU继续计算所必须等待的输入。
这和多颗GPU分别处理独立任务完全不同。在独立任务中,一颗GPU慢了,通常不会阻止其他GPU继续计算;但在模型并行中,如果GPU A的结果没有及时到达,依赖这个结果的GPU B就只能等待。
因此,模型被拆到更多GPU以后,性能不再只取决于每颗GPU能算多快,还取决于这些GPU之间的数据能不能足够快地到达下一步计算的位置。
Scale-up首先要解决的,就是:
让共同完成一个计算任务的多颗GPU之间,通信尽可能不成为计算的瓶颈。
这也解释了为什么并不是所有AI任务都需要很大的Scale-up计算域。
如果一个模型能够放进单颗GPU,或者推理吞吐可以通过运行更多独立副本扩展,那么增加GPU并不一定要求它们形成一个巨大的紧耦合计算域。
二、什么才算Scale-up
两颗GPU要连接起来,最基本的问题只有一个:
GPU A能不能把数据发送给GPU B?
如果可以,它们就已经具备了基本的点对点通信能力。
但从“能够通信”到形成一个Scale-up计算域,至少还要解决两类问题。
第一类是:一颗GPU能不能高效获得另一颗GPU产生的数据,并知道这些数据什么时候可以使用。
比如GPU A计算出的结果需要交给GPU B继续处理,那么系统不仅要把数据传到GPU B,还要知道数据应该写到哪里、什么时候已经完整到达,以及GPU B什么时候可以开始下一步计算。
第二类是:几十颗GPU能不能共同完成一个计算任务。
GPU数量增加以后,系统还需要解决不同GPU之间的数据如何流动、同时通信时如何避免相互争抢,以及一次需要多颗GPU共同参与的计算如何协调完成。
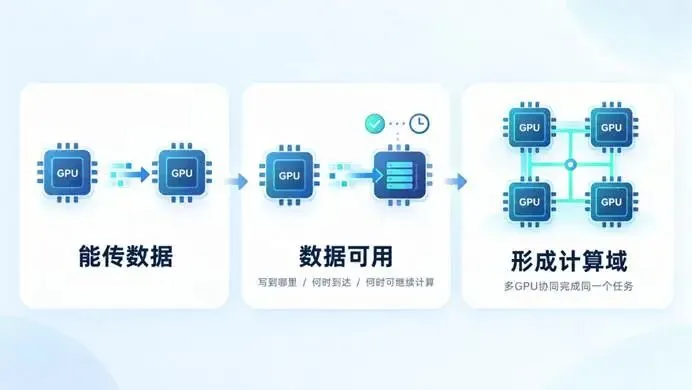
所以,Scale-up并不是简单地把更多GPU连接起来。它需要把两颗GPU之间的数据访问和同步关系扩展到几十颗GPU,让这些GPU能够在同一个计算任务中持续协同。
这并不意味着几十颗GPU真的变成了一颗GPU。
每颗GPU仍然拥有自己的计算单元和HBM,数据也仍然分布在不同GPU上。
Scale-up要做的,是尽可能降低这些物理边界对计算的影响:
让分布在多颗GPU上的数据及时到达需要它的位置,让相互依赖的计算继续执行。
三、Scale-up如何把几十颗GPU组织起来
两颗GPU最容易,GPU A和GPU B直接连接即可。
但GPU数量继续增加以后,完全直连很快失去可扩展性。
如果N个GPU全部两两直连,需要的连接关系数量为:
N ×(N−1)÷ 2
8颗GPU对应28对,72颗GPU对应2,556对。
这个数字并不是说NVL72实际需要2,556根线,而是说明:如果每颗GPU都直接连接所有其他GPU,连接关系会随着GPU数量近似平方增长。
现实中的物理限制更加直接。
一颗GPU的封装边缘有限,能够放置的SerDes和高速端口有限;线缆、连接器、功耗、装配和维护也不可能随着GPU数量无限增加。
因此,当GPU从两颗增加到几十颗以后,问题就从:
GPU A怎么连接GPU B?
变成:
每颗GPU只有有限数量的端口,怎样让几十颗GPU都能够互相通信?
一种常见的扩展方式,就是引入Switch。
在交换式架构中,GPU不再分别连接所有其他GPU,而是先接入Switch,再由Switch把数据转发到目标GPU。NVSwitch解决的就是这一类问题。
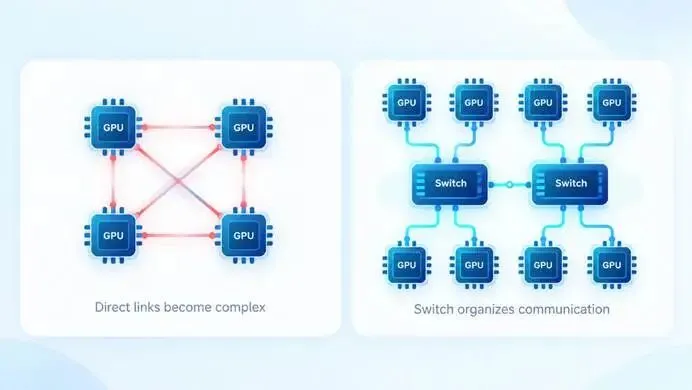
但Switch只解决了“更多GPU能不能互相到达”,并没有消除通信资源本身的限制。
几十颗GPU同时交换数据时,仍然需要共享有限的链路和Switch容量。于是,这些GPU和Switch怎样连接在一起,开始直接影响通信性能。
这就是Topology,也就是连接拓扑。
不同GPU之间的通信路径并不一定一样。有些GPU之间距离更近,数据需要经过的链路和Switch更少;有些GPU之间则需要经过更多节点。不同GPU之间的通信还可能同时经过同一组共享链路。
即使每颗GPU本身都有很高的互连带宽,某些共享链路仍然可能成为整个系统的瓶颈。
比如把整个计算域分成规模相近的两组GPU。
如果两组GPU之间需要同时交换大量数据,那么真正限制通信速度的,并不是所有GPU端口带宽加起来有多大,而是连接两组GPU的这些链路能够同时承载多少数据。
这类跨越网络切面的通信能力,可以用Bisection Bandwidth,也就是二分带宽来衡量。
所以,一个系统公布的总互连带宽很高,并不代表几十颗GPU同时通信时,也一定能够获得同样高的带宽。
真正影响大规模通信的,是这些带宽在整个计算域里怎样分布和共享。
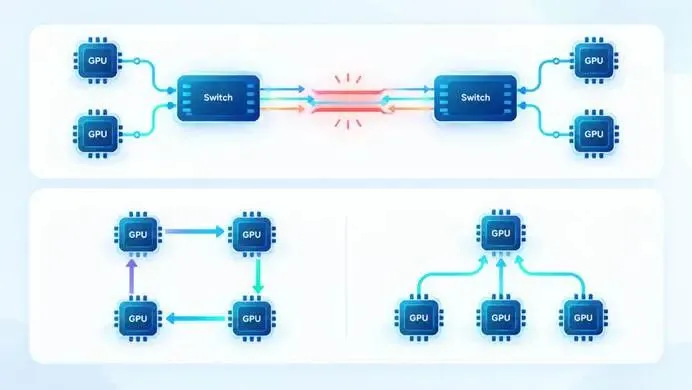
AI计算还有另一个特点:很多时候,并不是一颗GPU单独向另一颗GPU发送数据,而是多颗GPU需要共同交换数据,才能继续下一步计算。
比如4颗GPU共同完成一层计算,每颗GPU只算出其中一部分结果。下一步开始之前,它们可能需要拿到其他GPU的部分结果,或者先把各自的结果合并,再重新分发。
这类多颗GPU共同参与的数据交换,就叫集合通信(Collective Communication)。
Tensor Parallel中的All-Reduce、All-Gather、Reduce-Scatter,以及Expert Parallel中的All-to-All,都属于集合通信。
同一种集合通信,也可以有不同的执行方式。数据可以沿着不同GPU依次传递,也可以按照树状结构分层完成。不同方式需要经过的通信步骤不同,占用的物理链路也不同。
所以:
Topology决定“路怎么修”,集合通信决定多GPU通信“怎么走这些路”。
NCCL和RCCL的一个核心作用,就是根据GPU之间真实的连接关系,把All-Reduce等集合通信映射到硬件拓扑上,并选择合适的通信算法和执行方式。
这一层可以简化为:
Link负责传输数据;Switch让更多GPU能够互相到达;Topology决定这些连接怎样组织;Collective决定多颗GPU怎样利用这些连接共同通信。
因此,判断一个Scale-up系统的性能,不能只看一条Link有多快。
还要看这些高速链路怎样被组织,以及多颗GPU能不能真正高效地使用它们。
四、Scale-up为什么是一套系统能力
不同公司可以用不同的技术路线构建Scale-up。
后面的技术名词很多,但只需要记住一点:
Scale-up不是某一种协议,而是把多颗加速器组织成一个计算域的系统能力。
NVIDIA采用的是高度专用化的路线。
GPU之间通过NVLink通信,GPU数量增加以后再通过NVSwitch扩大连接域,上层由NCCL等软件把集合通信映射到真实的硬件连接上。
从早期DGX-1的8颗GPU,到HGX H100的8-GPU NVSwitch系统,再到GB200 NVL72的72-GPU机架,NVIDIA扩展的已经不只是一条NVLink的带宽,而是包括NVSwitch、连接拓扑、集合通信和系统管理在内的一整套Scale-up体系。
Google采用了另一条路线。
TPU通过ICI、规则的连接拓扑、Optical Circuit Switch以及XLA等软件,把Scale-up计算域扩展到了数千颗芯片。
TPU v4可以组成4,096颗芯片的系统,Ironwood进一步把这一规模扩展到9,216颗芯片。
Scale-up计算域并不天然以一台服务器或者一个机架为边界。
但这种大规模计算域建立在Google高度垂直整合的体系之上:TPU、ICI、Topology、编译器和云端调度都由Google统一设计和控制。
因此,Google说明Scale-up计算域可以被扩展到很大规模,但并不意味着开放的GPU生态也能用同样的方式实现。
AWS Trainium3则更能说明为什么Scale-up不能简单等同于某一种协议。
一种常见理解是:
PCIe只是普通的System I/O,所以Scale-up必须依赖NVLink这类专用协议。
但Trainium3并不是这样做的。
AWS在144颗Trainium3芯片组成的UltraServer中,使用PCIe Gen6 Switched Fabric作为Scale-up的底层连接。
它并不是把普通PCIe直接拿来连接更多芯片,而是在PCIe之上继续加入地址路由、远端HBM访问和硬件同步等能力,再由Neuron软件栈统一管理。
比如一颗Trainium芯片需要把计算结果交给另一颗芯片时,系统不仅能够把数据送到正确的位置,还能够确认数据已经写入完成,让下一步计算继续执行。
PCIe可以成为Scale-up的底层连接,但普通PCIe系统本身并不等于Scale-up。
判断一个系统是不是Scale-up,关键不在于它使用NVLink、PCIe还是其他协议,而在于:
它能不能把多颗加速器组织成一个紧耦合计算域,让跨芯片的数据访问、同步和多芯片通信持续支撑计算。
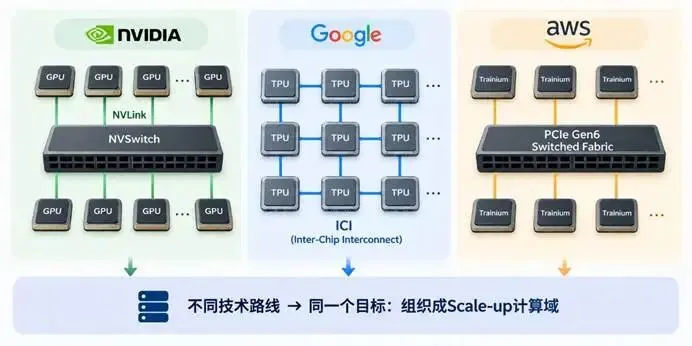
既然Scale-up是一套系统能力,其中一部分能力也可以被标准化。
UALink就是沿着这个方向出现的。
它试图把高速连接、Switch路由、远端内存访问、同步和管理等能力变成多厂商可以共同遵循的规范,让过去主要存在于专有体系中的部分Scale-up能力逐渐走向标准化和开放化。
无论采用专有体系还是开放标准,最终决定Scale-up能力的,都不是某一条Link,而是整套系统能否把多颗加速器真正组织成一个高效的计算域。
五、Scale-up为什么不能无限扩大
既然更大的Scale-up计算域可以让更多GPU高速协同,为什么不把几千甚至几万颗GPU全部放进同一个计算域?
因为计算域扩大以后,收益和成本会同时增加。
更大的计算域可以容纳更多GPU和HBM,也可以让更大的模型并行组继续留在低延迟、高带宽的Scale-up网络里,避免过早进入Scale-out。
但成本也在增加。
每颗GPU能够提供的I/O端口不会因为计算域变大而自动增加。节点超过单级Switch能够承载的规模以后,需要更多Switch和交换层级;大量GPU同时通信时,二分带宽也可能成为约束。
更多线缆、连接器、SerDes和Switch会消耗更多功率,更多设备共同参与一个计算任务,也意味着更大的故障面。
系统越大,软件也越复杂:任务放到哪些GPU上、网络怎样分区、集合通信怎样执行、节点发生故障以后怎样恢复,都需要处理。
而且,更大的Scale-up计算域并不一定带来同等程度的性能提升。
如果一个模型已经可以在较小的计算域内高效运行,继续增加GPU未必能够带来明显收益。
如果Tensor被切得越来越细,每颗GPU承担的计算越来越少,而GPU之间仍然需要频繁交换数据,通信开销反而可能开始吞噬增加GPU带来的收益。
MoE也类似。如果大量Token集中到少数Expert,即使整个计算域拥有很高的总带宽,局部链路仍然可能成为瓶颈。
所以,72颗、144颗或者1,024颗加速器,都不是天然更优的答案。
Scale-up需要寻找的是一个平衡:
让足够多的加速器留在同一个高速计算域里,使跨芯片通信不至于成为主要障碍;同时又不能让这个域大到交换、功耗、故障和软件复杂度开始吞噬扩展带来的收益。
因此,Scale-up的竞争不再只是GPU或者某一条高速Link。
GPU、Switch、高速连接、Topology、Collective和系统软件必须共同工作,才能让更多加速器真正发挥出整体算力。
Scale-up的本质,不是让更多GPU接上一条更快的线,而是让分散在多颗GPU上的计算、内存和同步依赖,在一个计算域里尽可能高效地继续推进。
但这个计算域终究存在边界。
当一个任务需要使用超过单个Scale-up计算域所能提供的计算资源,或者需要把更多相对独立的计算域组成更大的集群时,就要进入另一层互连。
这就是AI互连的下一层:
Scale-out。