ARTICLE · 1079879
你缺的不是更多 AI 工具, 是一个编了号的同事
混沌学园 · 组织进化 系列 25
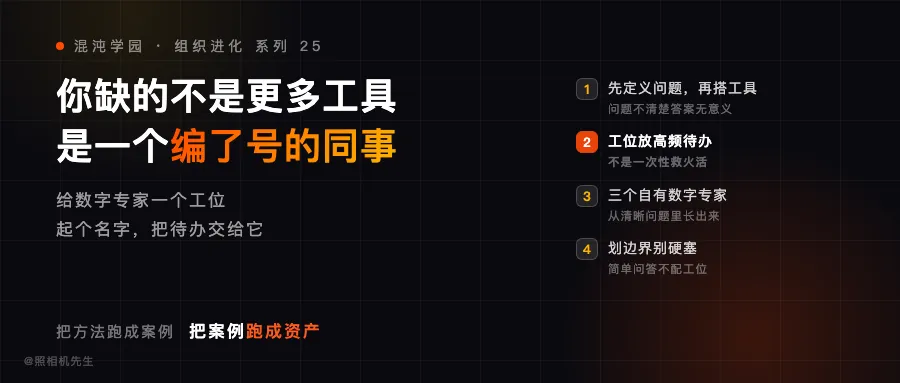
你缺的不是更多 AI 工具,
是一个编了号的同事
FDE 系列第 25 篇 · 认知调剂 · 整理自混沌学园上海分社胡凌的分享
引子:被碎片活淹掉的那个人
一个人手头总有一堆高频但碎的活。每天被它们撕成碎片:对账、周报、线索初筛、待办整理……哪一件单独看都不难,合在一起就把人淹了。
老板说:要不要招个人?
他说:招不到,也养不起。
然后他打开另一个 AI 工具,又把那一堆活重新做了一遍。
问题不在工具不够多。问题在于,那一堆活从来没「属于」过谁——每次都是临时抓一个工具来救火,救完就散了,下一次从头再来。
换个思路:如果那个「人」不占编制、不交社保、24 小时在线,只固定干那一类活呢?
这就是数字专家,和它该有的样子——一个虚拟工位。
一、虚拟工位不是又一个聊天窗口
先说清楚虚拟工位是什么。
给企业里的 AI 数字专家,设定一个专属的虚拟工位:起个名字、配个工位牌,放在真实同事旁边。把岗位里高频重复的待办任务,直接交给这个工位上的「人」。
注意,这不是「再开一个 AI 聊天窗口」。开窗口是临时的、随机的、跟人走的;工位是固定的、有名字的、跟岗位走的。
把 AI 当成一个编了号的同事,比你多开一个聊天窗口管用得多。
区别就在这四个字:编了号。一旦它有了名字和工位,一类活就「固定」给了它——它才接得上经验,长得出资产。不然 AI 永远是你工具箱里又一件趁手的锤子,用完了放回原处。
编了号还有一层好处:责任有了归属。一个没有名字的窗口,干错了你怪工具;一个有了名字的工位,干错了你会去改它的规则——前者是消耗,后者是沉淀。
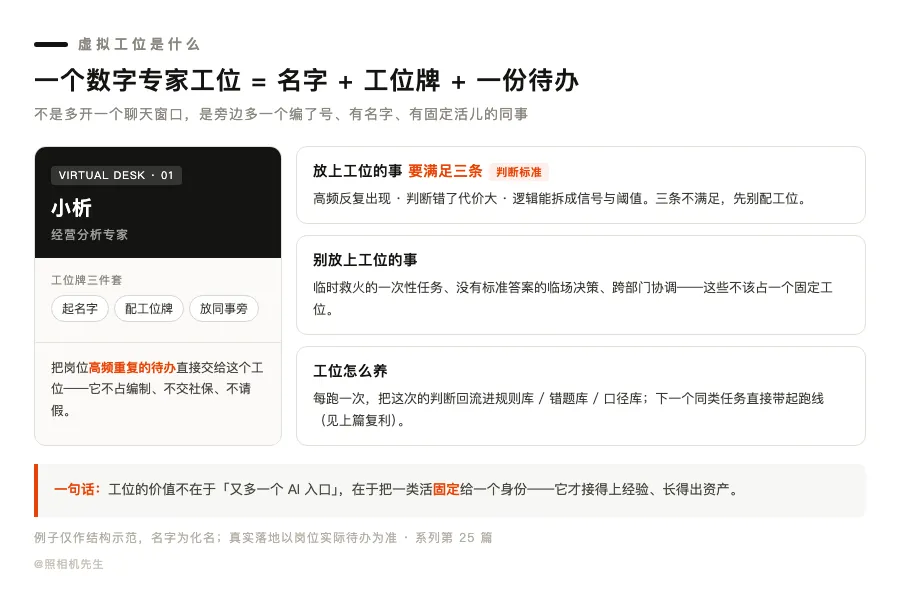
▲ 一个数字专家工位 = 名字 + 工位牌 + 一份待办,不是又一个聊天入口
二、第一步永远是定义问题,不是搭工具
这是最容易反着来的地方。
很多人一上来就问:这个专家用什么工具搭?提示词怎么写?其实错了顺序。
素材里有一条被反复强调的原则:问题定义不清楚,答案毫无意义。所有数字专家,都从清晰定义岗位核心问题开始——这个岗位最该被解决的,究竟是哪一件事?
招一个数字专家,先别问他能干什么,先问他该解决哪个问题。
为什么顺序这么要紧?因为工具是无限的,问题是具体的。先定问题,工具才有锚点;先选工具,多半会搭出一个「看起来什么都能干、其实哪件都靠不住」的东西。它的工位上第一天该放的,是那个最痛、最高频、最值得被固定的活,而不是你最想炫耀的那项能力。换句话说,工位不是能力的秀场,是问题的收容所。
三、工位上放什么:高频重复待办,不是一次性救火
工位不是垃圾桶,不能什么活都往里丢。
放上工位的,应该是岗位里高频重复的待办——经营数据滚动看板、线索分层、邀约名单筛选这类。判断标准很实在:高频反复出现、判断错了代价大、逻辑能拆成信号与阈值。三条满足,才配进工位。
不该放的是另一类:临时救火的一次性任务、没有标准答案的临场决策、跨部门协调。这些要么不重复,要么每次都不一样,放进工位只会让它越干越乱,反过来污染它积累的规则库。
工位要「专」不要「满」。一个工位只接一类高频、有明确标准的活,比一个工位啥都干,更能长出资产。
反例很常见:有人把周报、对账、客户分诊全塞给同一个专家,美其名曰「全能助理」。结果三类活的标准互相打架,规则库里一会儿按汇报口径、一会儿按财务口径,谁都对不齐。拆成两个工位之后,各自的标准才立得住。这也说明工位不是能力的秀场,是问题的收容所——放进去的,是值得被长期固定的那一个问题。
这也呼应了上一篇讲的逻辑:工位每跑一次,就把这次的判断回流进规则库、错题库、口径库;下一个同类任务直接带起跑线。工位越专,回流越干净,复利越明显。
四、三个自有数字专家:它们怎么长出来的
混沌上海自己先跑了三个数字专家,安全可写,不涉及任何客户:经营分析专家、课程销售专家、营销获客专家。
它们不是被统一设计出来的,是从一个个清晰定义的问题里,逐个长出来的:
- 经营分析专家
,接的是经营数据的滚动看板、异常波动预警、周月季报初稿——高频、口径固定、错了影响决策,最适合沉规则库与口径库; - 课程销售专家
,接的是线索分层、跟进话术生成、意向判定——重复性强、信号清晰、容错有兜底,适合先沉淀错题库; - 营销获客专家
,接的是邀约名单筛选、触达文案、回复分诊——量大、节奏密、需对齐口径,适合跑通后规模化复制。
三个专家的起点一模一样:先说清这个岗位最该解决哪个问题,再决定工位上放什么。
我们自己的三个数字专家,不是设计出来的,是从一个个清晰定义的问题里长出来的。
我们之所以先在自己身上跑通这三个,再拿来讲给别人——一是它们不涉及任何客户,写出来没有合规顾虑;二是「自己先用起来」本身就是一个判断:连自己的高频活都沉淀不下来,就没资格教别人怎么沉淀。混沌上海的经验是,自有案例先把坑踩一遍,对外讲的时候才有底气说「这一步我们真干过」。
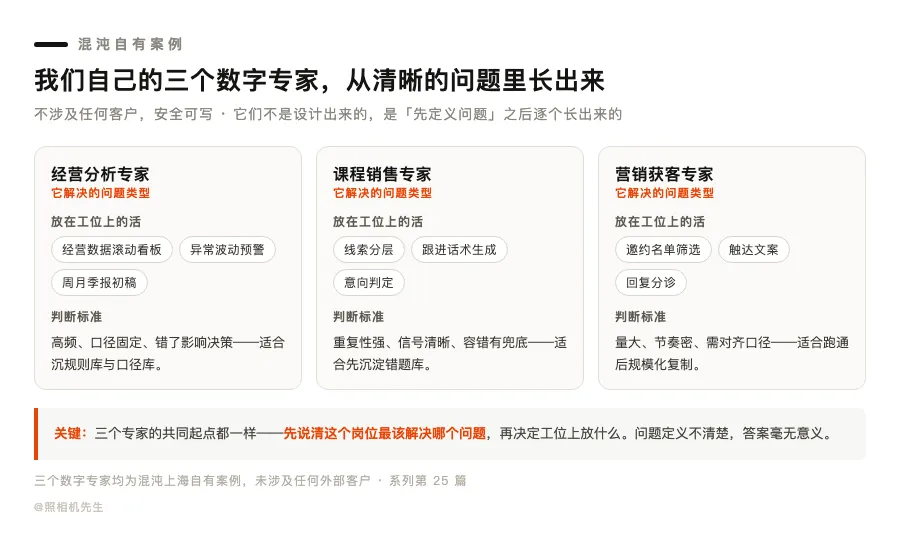
▲ 混沌自有三个数字专家:起点都是「先定义问题」,再决定工位放什么
五、边界:什么不该放进工位
主动划边界,比多铺工位更重要。
- 简单问答、信息查询类,不配工位。
同事打开工具跟 AI 对话写周报,那属于个人提效,用基础 RAG 方案成本更低,不必动用完整的角色结构与资产沉淀。 - 跨部门协同的复杂活,不配单人工位。
一级只覆盖单一岗位、不涉及跨部门协同;要跨部门的,得上到双人协同甚至三人团完整闭环,不能拿岗位级方案硬套。 - 专业级场景不进通用工位。
图生图、生视频、测绘一类不在一级范围,需要单独立项、配专门技术角色。 - 问题没定义清楚的,不碰。
问题定义不清楚,答案毫无意义。先把五步法第一步业务诊断(含基因分析)做扎实,问题写清楚了,再给它配工位。
边界划清楚,工位才跑得完——这和前面每一条线是同一个道理:不划边界,定级也好、配工位也好,最后都会变成一场往上堆数量的竞赛。
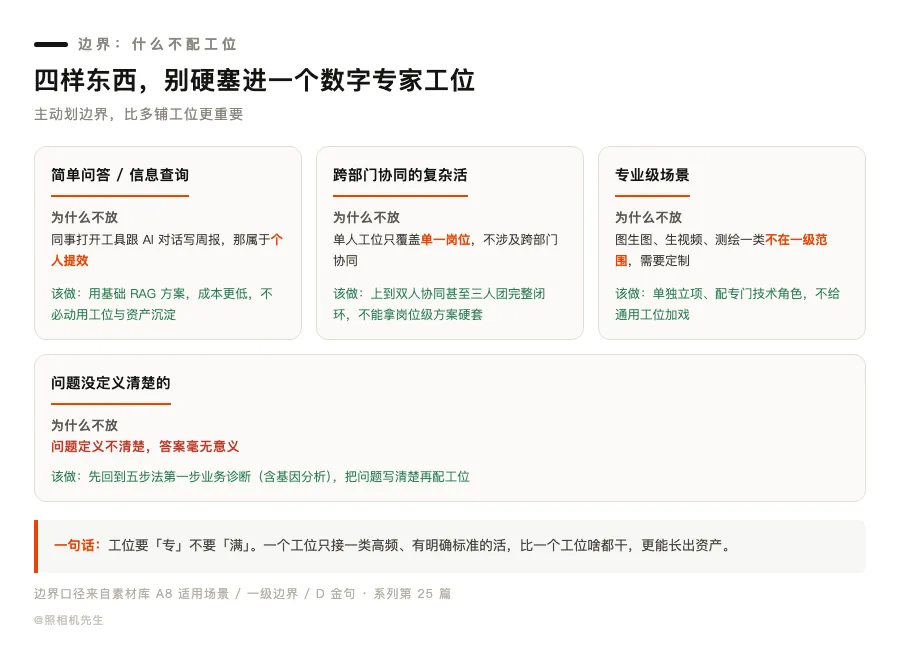
▲ 四样东西别硬塞进工位:简单问答 / 跨部门复杂活 / 专业级场景 / 没定义清楚的问题
六、回到引子
那个被碎片活撕碎的人,如果给其中一类活起个名字、配个工位,会发生什么?
头一周,它干活、你复核;一个月后,它开始把判断回流成规则;半年后,那一类活你几乎不用再碰——它成了组织里最不请假、最不难招的那一个同事。
它不占编制,但它在。它跟着岗位走,不跟着人走。
这一步其实很轻:起个名字、拉一份待办、配块工位牌,半天就能开张。难的是后面三个月的回流与对齐——把每一次判断攒回规则库,把每一个坑记进错题库。开张容易,长胖难。
给数字专家一个工位,真正改变的不是你多了个工具,是那一类活终于有了主人。
把方法跑成案例,把案例跑成资产
先给它一个名字,那一类活才有人接
混沌学园 · 组织进化系列 第 25 篇
整理自混沌学园上海分社胡凌的分享 · @照相机先生