ARTICLE · 1082195
从内部实践到企业服务, 我们如何建设 AI 软件工程体系?
从内部实践到企业服务:我们为什么开始建设 AI 软件工程体系?
这不是一篇宏大的技术宣讲,而是红创科技从2025年至今,在多个真实、复杂的一线企业级项目中,一步步踩坑、修正认知、沉淀方法后写下的一份工程记录。
最初的想法,其实非常朴素
我们并不是从一开始就立项要建设一套“AI 软件工程体系”,也不知道AI在编程领域能发挥多大作用。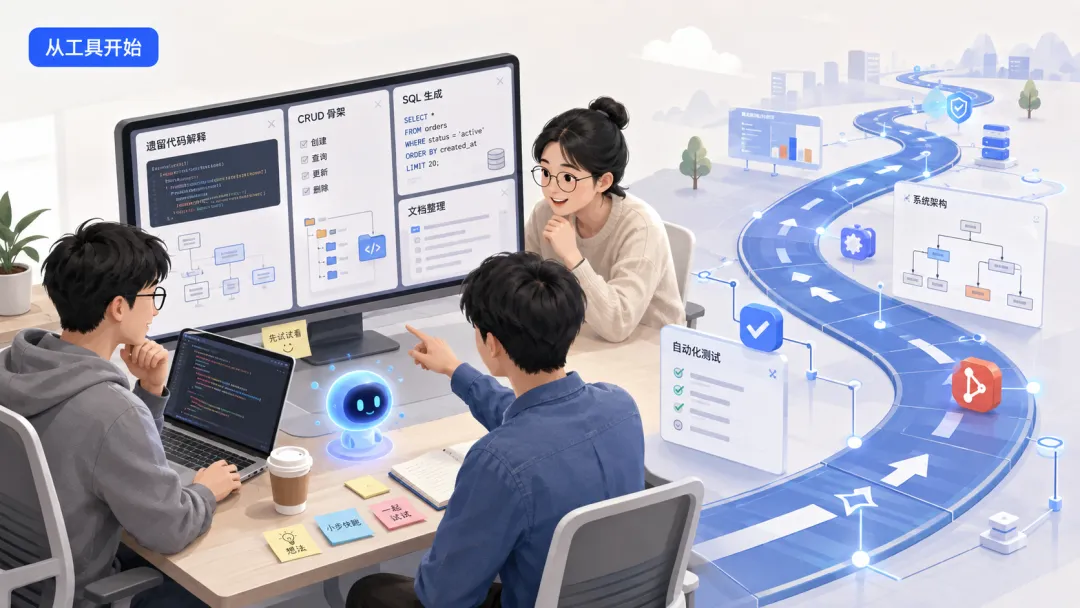 2025 年初,大模型能力的快速演进让整个行业感到兴奋。我们最初的想法非常朴素:既然模型已经能够理解代码、解释报错、生成接口甚至编写单元测试,那么它能不能直接帮我们的工程师更快地把项目做完?
和绝大多数软件团队一样,红创也是从“个人配置好工具”开始的。工程师在 IDE 里装上插件,在遇到陌生的遗留代码时让 AI 解释,在写重复的增删改查页面时让 AI 生成骨架,或者用它辅助编写 SQL、正则和整理文档。
局部的提速很快显现出来:那些过去需要反复查阅文档和搜索的碎片时间被明显压缩;原型能够以更短的周期跑起来;工程师进入不熟悉业务模块或技术栈时的心理门槛大幅降低。
如果只停留在这些单点指标上,结论似乎显而易见:企业只需要采购一批 AI 工具账号,给每位程序员配上最好的助手,研发效能自然就会翻倍。
然而,当这些工具真正脱离“个人练习”,深度进入客户复杂系统的交付现场时,一连串前所未有的工程撞墙期开始了。
| 01 | 蜜月期后的“工程撞墙”:我们踩过的三个真坑 |
从2025年到今天,我们经历了从Trae、Copilot 到 Claude Code、ChatGPT,再到更自主的 Agent、上下文工程以及当前 Harness 约束体系的完整演进。
这并不是一段轻松的工具升级史,而是几次极其深刻的认知修正:
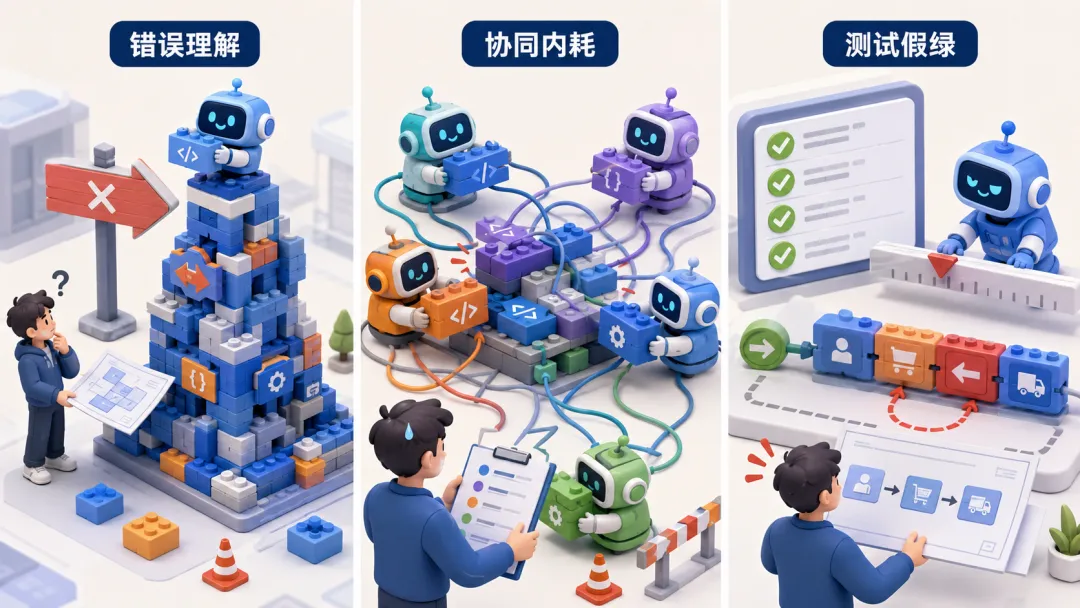
⚠️ 坑一:模型越强,越可能以极高智商把“错误理解”贯彻到底
我们曾经以为换上更强的模型就能更快。但在复杂项目中,如果上下文不完整,越强大的模型越会极其严密、完整且自圆其说地写出一整套偏离真实业务意图的代码,排查成本反而成倍上升。
⚠️ 坑二:盲目并发多个 Agent,换来的不是吞吐量而是“管理税”
没有精细边界约束的多 Agent,很快会在共享模块中产生任务冲突、状态不同步和相互覆盖。团队反而把大量时间消耗在 Agent 之间的协同内耗上。
⚠️ 坑三:测试全部通过,并不等于业务意图被正确实现
AI 非常擅长让单元测试变绿。在缺乏严格规格约束时,AI 甚至会悄悄修改测试用例的断言条件来迎合其错误实现。代码能跑通,业务却改坏了。
💡 这段历程留给我们的核心认知:AI Coding 的上限,模型本身只是其中的一个变量。【项目上下文】决定了 AI 能否真正理解项目;【工程约束】决定了 AI 能否在安全边界内稳定交付。
| 02 | 效率拐点:当提效从“个人体感”穿透到“项目结果” |
在痛定思痛、把工程约束建立起来之后,另一个同样真实的事实展现在我们面前:AI 带来的整体交付效率提升,是极其巨大的。
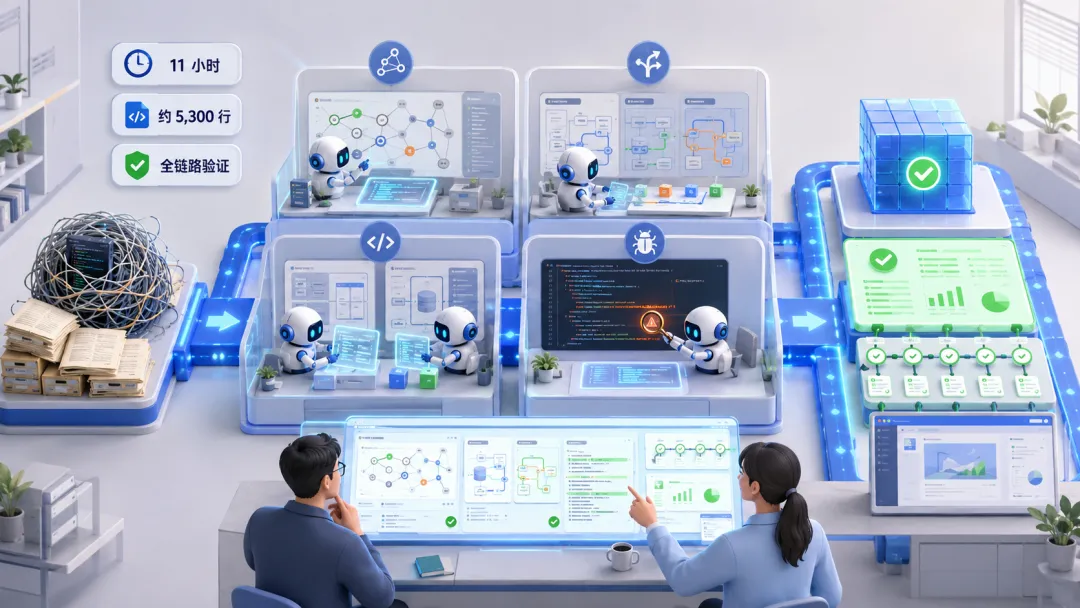
而且这种提升,不再局限于敲代码的几分钟,而是穿透到了研发交付的全链路:
- 需求与遗留代码理解
:数万行缺乏文档的老代码在数小时内理清调用拓扑与核心逻辑; - 架构方案多路径探索
:多个 Agent 在隔离沙箱中并行验证不同技术选型并输出对比证据; - 端到端功能交付
:前后端联调、接口映射与自动化测试用例生成同步推进; - 缺陷定位与自愈
:基于真实运行日志与调用栈快速锁定根因并提供精准修复。
| 03 | 效率越被放大,我们反而越敬畏“工程约束” |
当 AI 每次只生成 10 行代码时,工程师靠肉眼逐行检查尚可应付。但当 AI 开始以几十倍的速度同时修改十几个模块、甚至并行推进多任务时,靠人盯住每一步不仅不现实,而且根本无法形成可复制的组织能力。
具有概率性特征的 AI,在工程上是否天然不可控?我们在实践中得到的答案非常笃定:AI 不需要被要求永远不犯错,它需要在一套严谨的工程体系中受控工作。
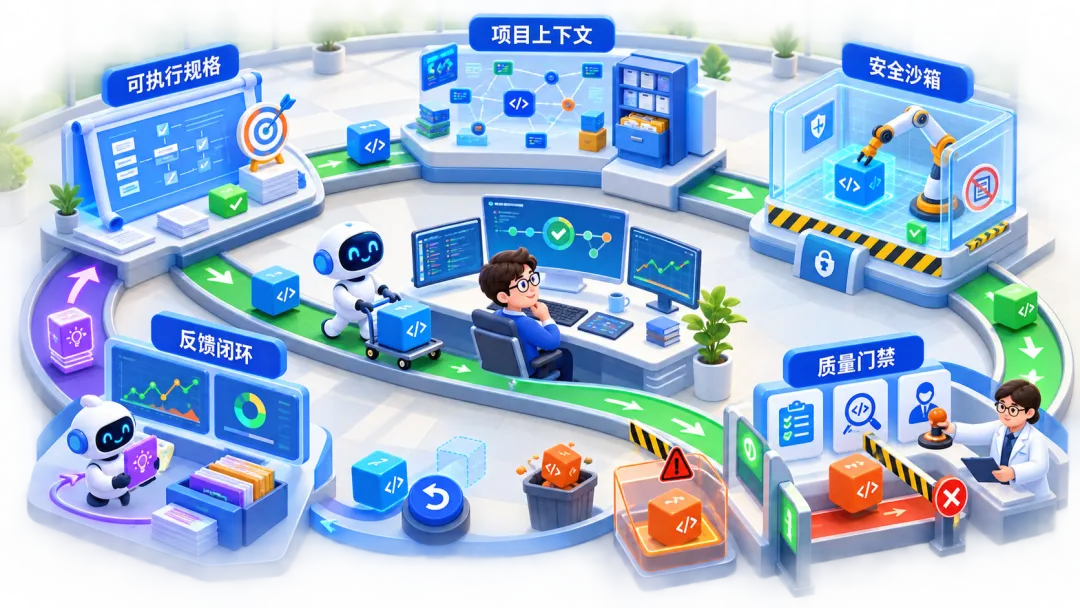
🛠️ 红创实践沉淀的“五大工程治理支柱”:
01 告诉 AI 什么是完成(Spec)
拒绝模糊提示词。用可执行规格与前置验收用例明确交付标准,从源头杜绝意图跑偏。
02 理解历史与真实边界(Context Engine)
建立代码库深度图谱与架构依赖关系,让 AI 真正理解既有系统背景,消除理解盲区。
03 限制读取与修改范围(Security Sandbox)
配置细粒度读写权限与隔离环境,敏感数据脱敏,工具调用受控拦截,保证环境安全。
04 决定代码能否入主线(Quality Gate)
自动化测试、静态分析扫描结合专家 Sign-off,确保代码安全入库并保留完整责任链。
05 新知识沉淀回体系(Feedback Loop)
结合生产监控与交付效能分析,把每次踩坑的新增用例沉淀回测试库,让体系持续进化。
在这样的体系中,AI 依然会犯错,但错误会被立即隔离在沙箱内、被测试门禁拦截、被一键安全回退。这就是我们所定义的 AI 软件工程体系(AI Software Engineering System)。
| 04 | 走出内部:把走通的路,变成面向企业的技术服务 |
在与众多企业技术管理者交流时,我们发现大家正在经历极其相似的迷茫:采购了工具,但除了写写小函数,面对复杂遗留系统和核心业务依然无从下手;担心源码与商业数据泄露不敢放开;管理层看不到清晰的 ROI,团队碎片化严重。
我们走过的弯路、踩过的坑,不应该让每家企业都重新经历一次。而在当前,广大技术公司普遍采用AI进行编程时,如何约束AI,将个人效率转化为团队效率显得更为突出。
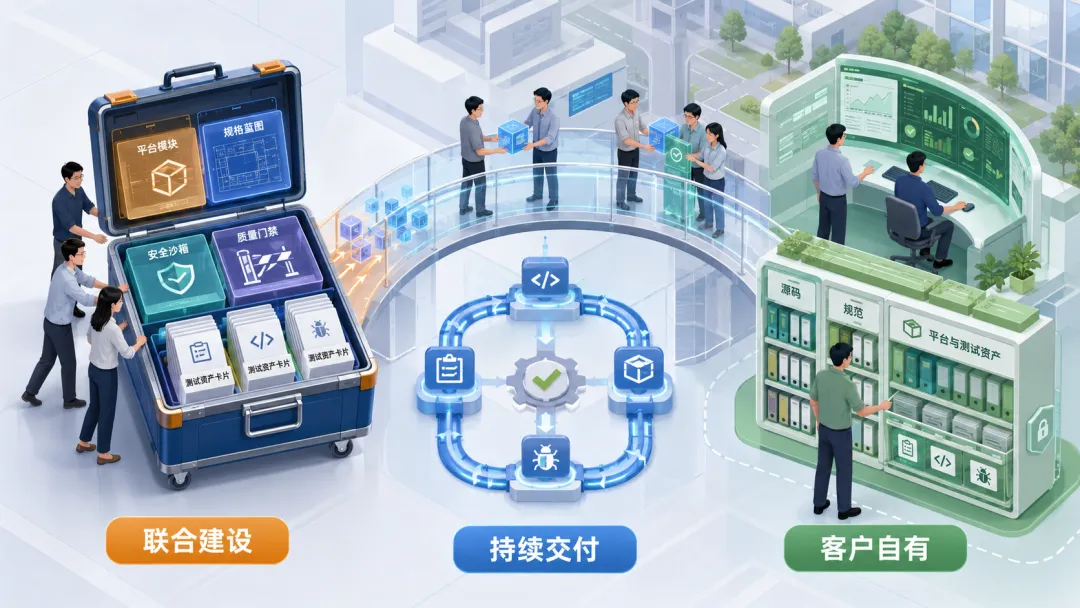
越来越多的客户,希望我们在交付系统的同时,能够同时交付AI编程平台,Spec文件,Agent.md等AI工程文档,共同建立可以持续运维,迭代的AI-Coding体系。
因此,红创正在把内部经过高强度项目验证的方法论、平台产品与实战经验,整理为面向企业的技术服务与联合落地,帮助企业搭建可控交付闭环,并最终把工程平台、规范与测试资产沉淀在客户自己的团队内部。
| 05 | 诚挚邀约:红创AI Coding Workday |
我们深知,AI 软件工程没有放之四海皆准的标准答案,模型与 Agent 技术每天都在高速演进。
与其听一套空泛的通用培训,不如拿出一个真实的业务场景,大家坐在一起,用一天时间把问题真正看清楚。
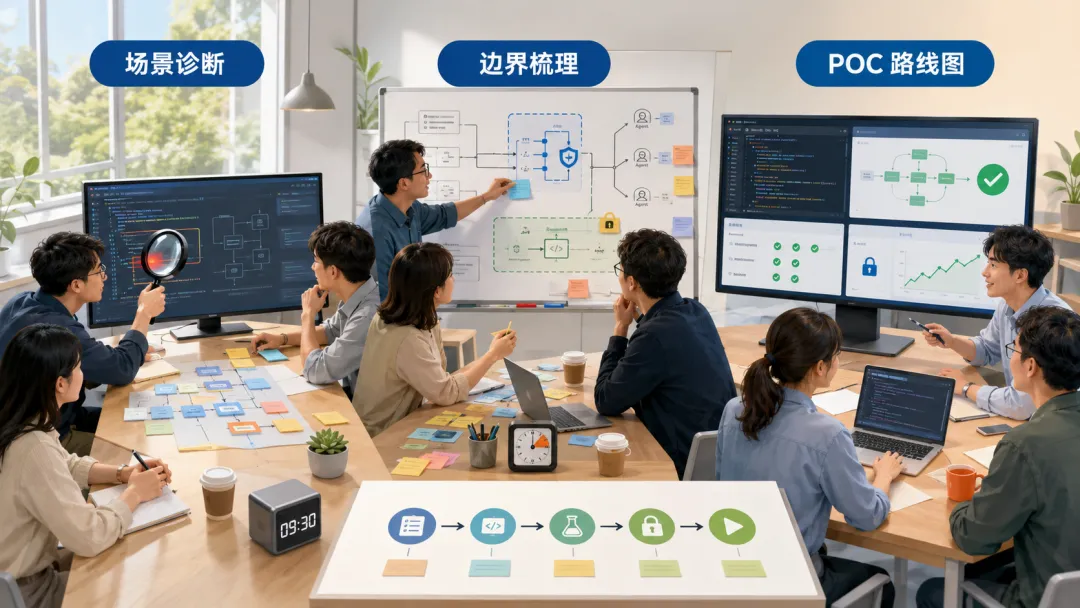
🤝 什么是 AI Coding Workday 联合共创工作日?
01 场景定位与痛点诊断:
深入评估当前研发瓶颈(遗留系统维护难、测试不足、新功能上线慢),锁定最适合作为突破口的真实场景。
02 上下文与安全边界梳理:
梳理代码架构拓扑、数据安全与私有化要求,设计合理的 Agent 接入节点与门禁规范。
03 输出最小验证闭环建议:
共同制定一份切实可行的落地路线图,明确验证指标与预期效果,留下可以直接执行的明确下一步。