ARTICLE · 1082187
AI名词越学越多,却还是不知道怎么用?从一句“帮我做个视频”出发,一次讲清大模型、上下文、、技能和智能体如何配合,把事情做完
AI名词越学越多,却还是不知道怎么用?从一句“帮我做个视频”出发,一次讲清大模型、上下文、、技能和智能体如何配合,把事情做完 刚开始接触 AI,最容易遇到的麻烦,是名词越来越多。 昨天还在学怎么写提示词,今天又看到上下文、知识库、MCP、Skill、Agent。每个词单独查一下,似乎能明白;放在同一篇文章里,反而不知道它们是什么关系。 先给自己留一个问题:当我把一件事交给 AI,究竟是谁在理解、谁在找资料,又是谁真的动手? 我们顺着这个问题,走完一项具体任务。下面的小林是个虚构的新手创作者。他想把收藏的资料,做成第一条让普通人也能看懂的知识视频。文章里的配图与同题白板视频使用同一套场景,方便对照着看。 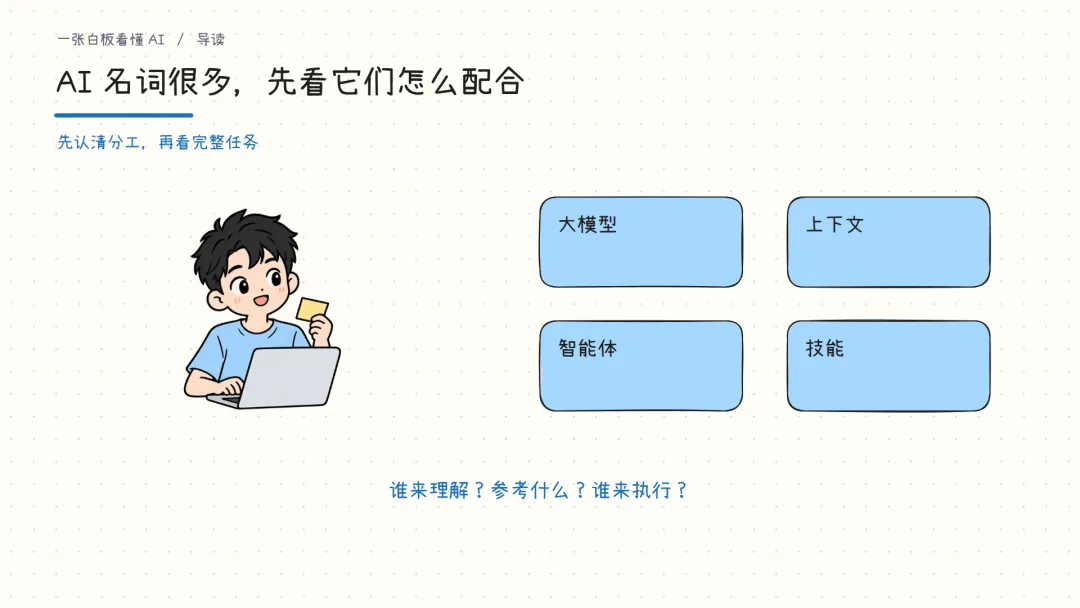
图 1先认识分工,再看这些能力怎样配合 先说清楚 你要让 AI 帮你做什么 周日晚上,小林终于决定开始做视频。 资料收藏了一堆,剪辑软件还没打开。他把材料交给 AI:“帮我做一条讲 AI 的视频。” AI 很快回了一篇稿子。小林读完第一段,发现里面尽是专业词,连自己都得停下来查。 这时先别急着找更厉害的工具。我们把刚才发生的事拆开看。 负责处理语言、组织回答的,是 LLM,大语言模型。你可以暂时把它理解成这位搭档负责理解和写作的部分。Model,模型,则是更大的类别,语言模型只是其中一种。 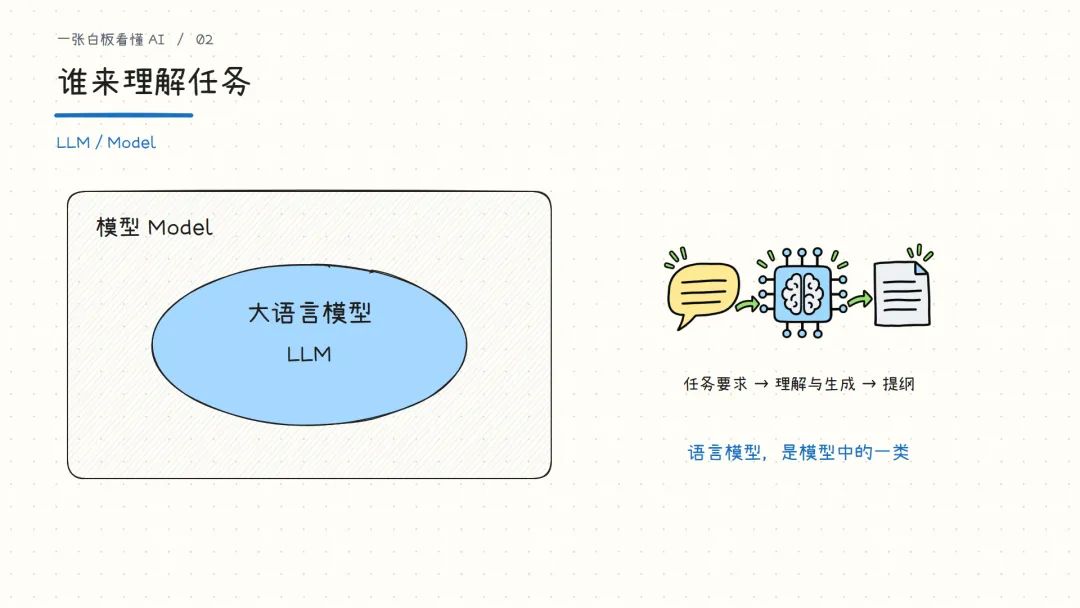
图 2模型与大语言模型,以及输入和输出的关系 小林交给它的那段任务要求,叫 Prompt,提示词。这个词听起来很技术,落到日常使用里,就是你把事情怎么交代给它。 “帮我做视频”少了不少信息:给谁看?讲到什么程度?先交脚本,还是直接生成文件? 小林重新说了一遍:“给完全没接触过 AI 的人看,用生活里的例子。先给我故事提纲,别一上来就塞一堆定义。” 要求具体了,检查结果也有了依据。写完之后,可以直接判断:有没有照顾零基础观众?有没有讲出故事? 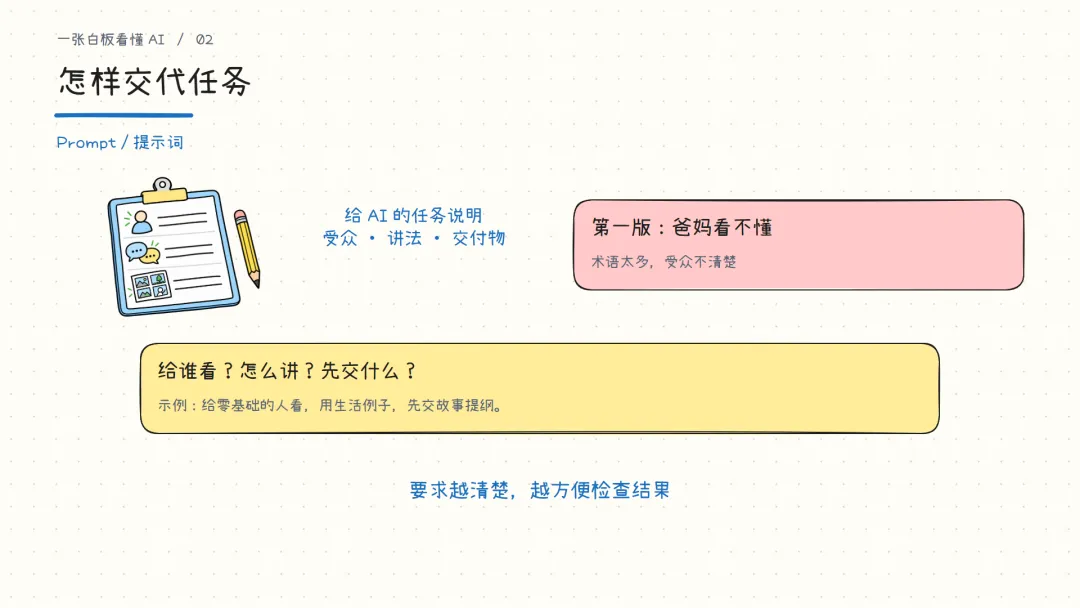
图 3把受众、表达方式和交付物写进任务说明 刚才说好的 它这次还看得见吗 提纲改了几轮,小林说:“第三段,就照我们刚才定的改。” 这句话能不能被理解,取决于“刚才定的内容”有没有被交到模型面前。 模型这次能参考的信息,叫 Context,上下文。它可能包括当前任务、相关对话、参考文件、工具返回的结果。可以把这些信息想成摆在工作桌上的材料。 小林指着“刚才那一页”说话,但桌上已经没有那一页,搭档就可能理解错。实际应用会帮你组织对话历史,不过它到底带上了什么,仍然取决于具体实现。 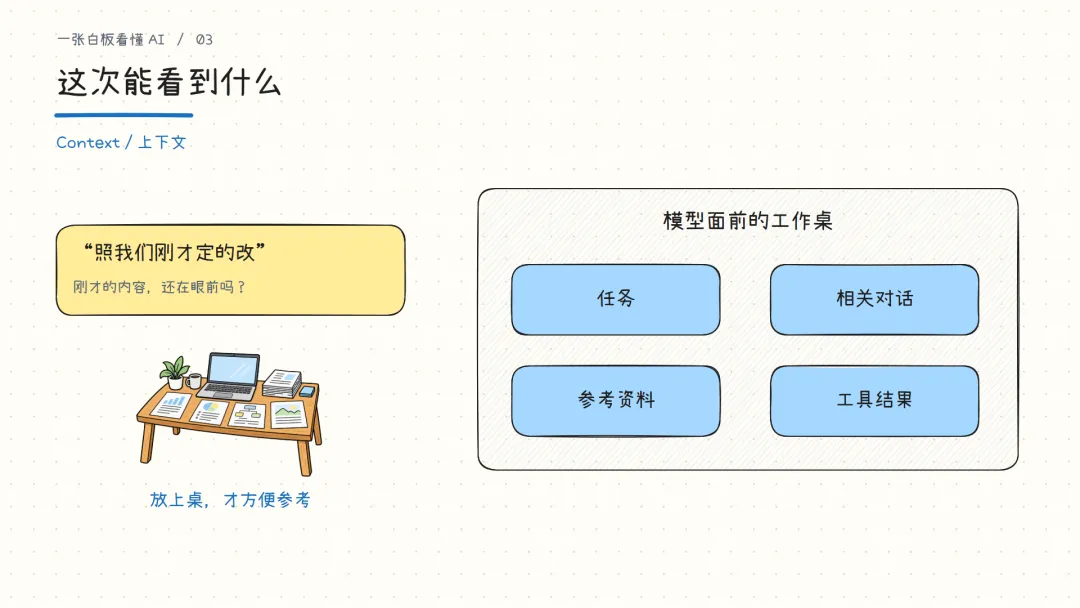
图 4上下文像这次任务的工作桌,材料摆上来才能参考 还有两个词与这张桌子有关。 Token,词元,是模型处理文本时使用的单位。它可能对应一个字、一个词的一部分或标点,切分方式也会因模型而异。别把“一个 Token”直接换算成“一个汉字”。 Context Window,上下文窗口,是单次请求可处理的上下文容量上限。材料太多,应用可能会筛选、压缩,或者直接提示超出限制;不同模型对输入、输出等内容的容量计算也有具体规则。 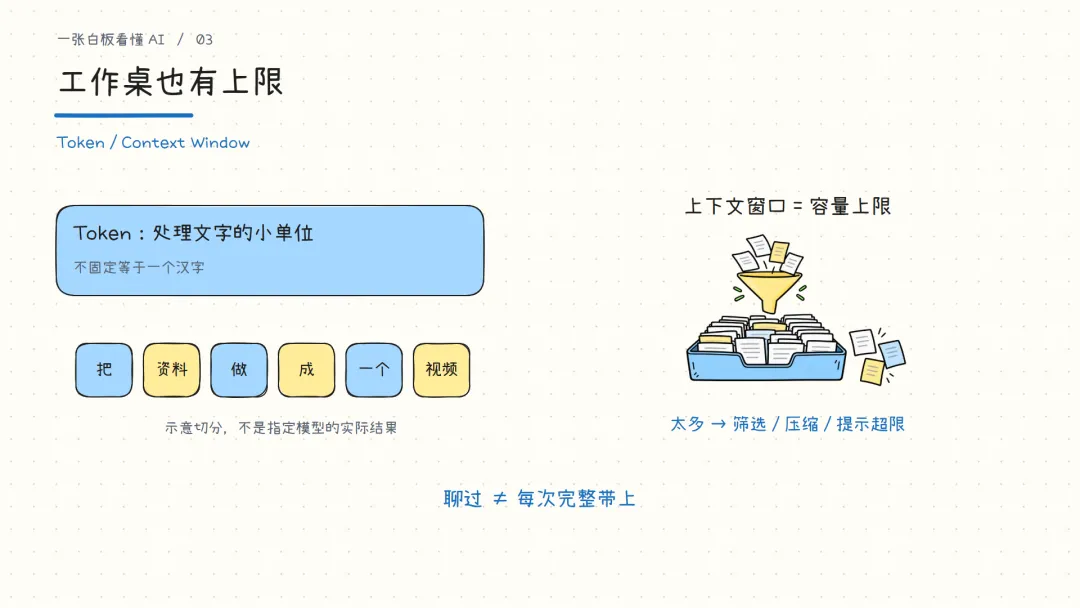
图 5词元是处理单位,上下文窗口是容量限制;图中切分仅作示意 这次的工作桌 和留给下次的笔记 小林又想到一个问题:“下次做视频,还要重说一遍受众和风格吗?” 可以把稳定的偏好记下来:面向新手,多用短句,采用白板画面。之后需要时,把这些内容找出来,再放进当前任务的上下文。 这类保存和取用信息的机制,可以叫 Memory,记忆。实际产品的记忆可能存在文件、数据库或其他存储里。 到这里,两个词就好区分了:上下文讲的是“这一次参考什么”,记忆讲的是“哪些信息保存下来,留待取用”。 存了一本笔记,不代表每次开工都会把整本笔记摊在桌上。信息还得在需要的时候被找出来。 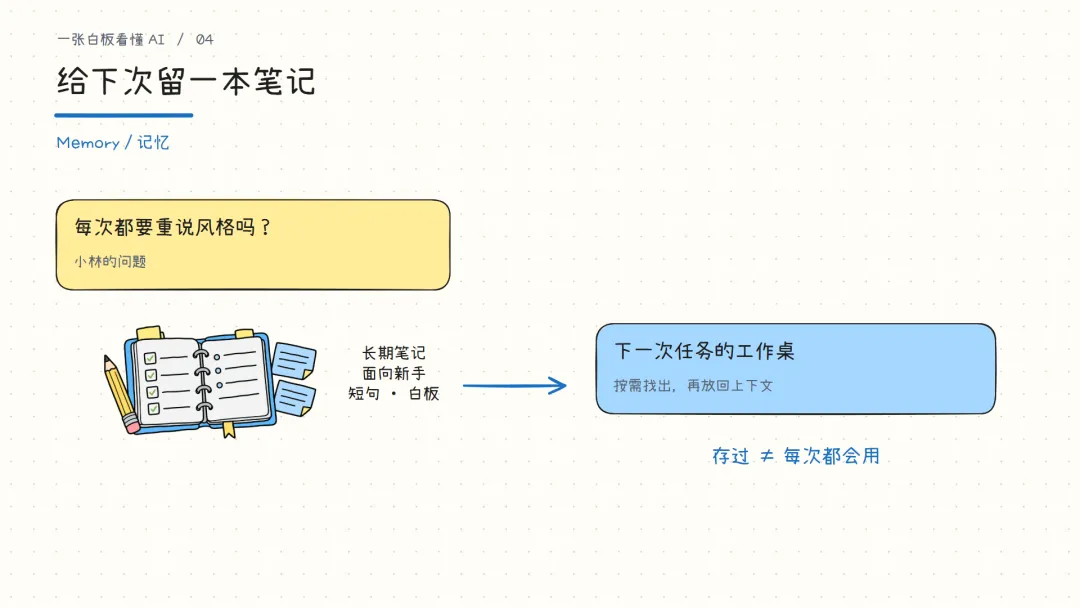
图 6保存偏好,再按任务需要放回上下文 稿子写得顺 事实却不一定对 稿子里出现一句话:“所有 AI 都会永久记住用户。” 小林翻了材料,没找到这个结论。 模型有时会生成听起来合理、实际没有依据或存在错误的内容,这类问题通常叫 Hallucination,幻觉。看到一句说得很肯定的话,仍然需要看它的依据。 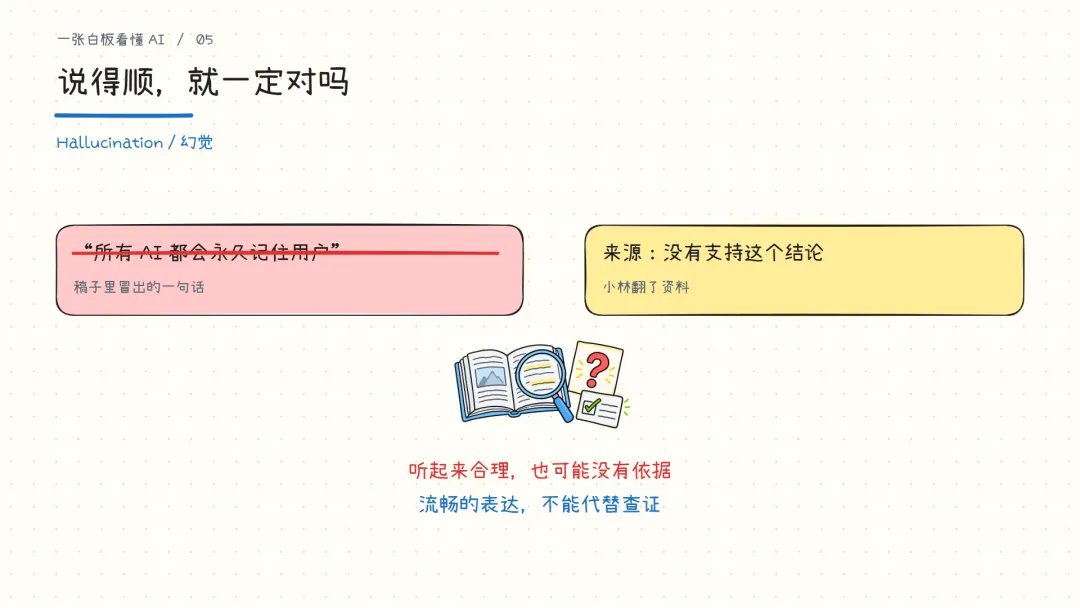
图 7把稿子里的结论,与来源逐项对照 为了方便查,小林把官方说明和核对过的材料集中整理起来。这样的可查询资料集合,就是这里所说的 Knowledge Base,知识库。 当稿子讲到记忆功能,系统先检索相关内容,把找到的段落放到模型面前,再让它结合这些材料组织回答。这条路径叫 RAG,检索增强生成。 拿资料柜打个比方:柜子里可以存很多书,写这一段时,只需要取出有关的几页。 但“找来几页”与“这些页支持当前结论”是两件事。找错资料、漏掉条件,照样会把稿子写偏。小林最后还是要核对出处。 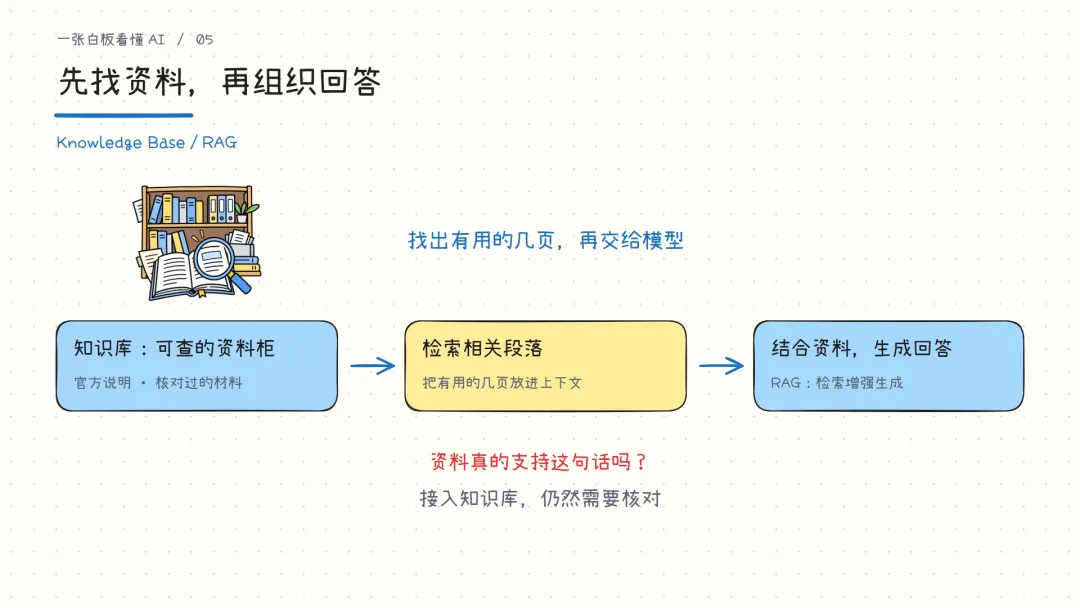
图 8知识库保存资料,RAG负责找到有关内容再辅助生成 一张图 一段录音 也是输入 小林接着递过来一张流程图和一段录音,希望 AI 一起参考。 文字、图片、声音、视频,是不同的信息形态,叫 Modality,模态。能够处理多种模态的模型或系统,具有 Multimodal,多模态能力。 具体支持什么输入、能输出什么结果,要看所用模型和应用。能看图片,不意味着这套应用一定能听录音;能理解视频内容,也不意味着它已经接好了视频制作工具。 所以交任务时,不妨具体一点:“请参考这张流程图和这段录音。”然后检查它是否确实读到了这些内容。 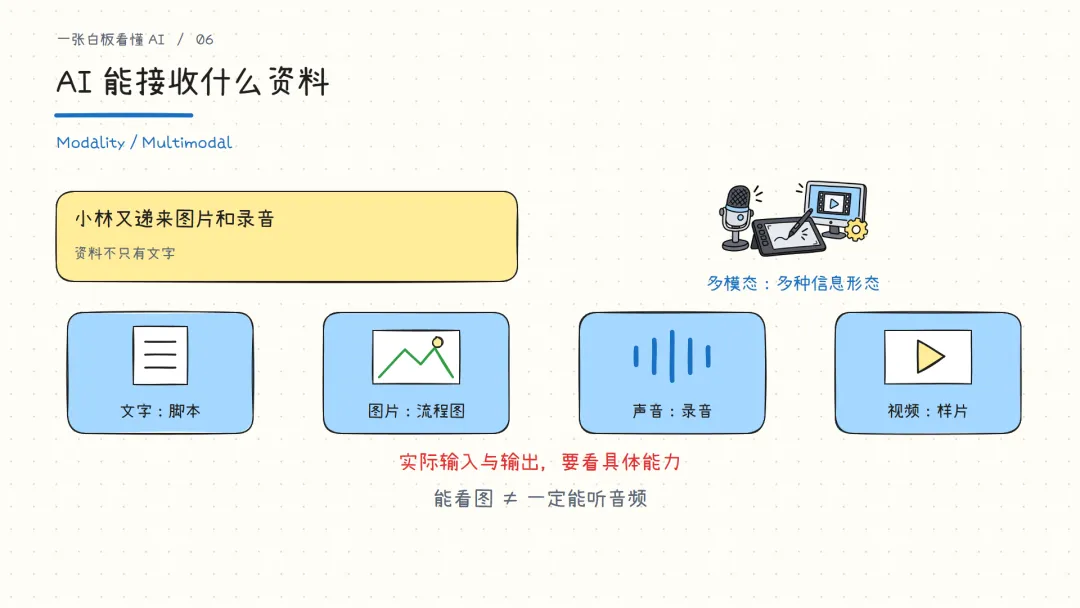
图 9文字稿、流程图、录音和样片,对应不同的信息形态 写出了制作步骤 视频文件在哪儿 脚本终于能用了。小林打开文件夹,里面依然没有成片。 视频还需要配音、绘图和合成程序去执行。这些外部能力叫 Tool,工具。它们可以查询信息,也可以执行动作。 以配音为例:模型组织好旁白和声音参数,提出调用请求;运行环境把请求交给配音程序,程序完成后返回音频。模型拿到结果,再决定接下来做什么。 这个过程就是 Tool Calling,也常写作 Tool Use,工具调用。 看到 AI 写出“接下来生成配音”,还不够。小林要找的是生成后的音频文件,或者工具实际返回的结果。 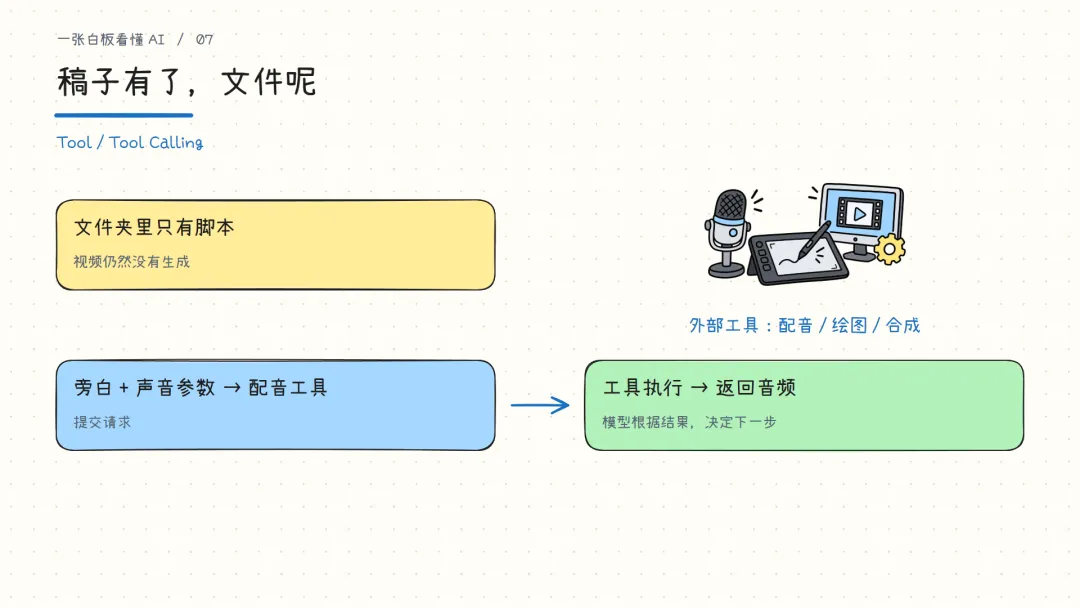
图 10工具调用要走完请求、执行、返回结果的过程 工具很多 怎样接到一起 工具来自不同地方,连接方式也可能不同。AI 应用得知道怎样请求它们、怎样接收结果。 MCP,模型上下文协议,提供一套开放的连接标准,让 AI 应用能用统一方式对接外部工具、资源和提示。可以把它理解成大家约定好的一类接口与通信规则。 在小林的任务里,配音程序负责生成声音;MCP 可以承担一种接入方式。服务是否支持、是否已安装、账号有没有权限、参数是否配置正确,都还得落实。 知道插口叫什么,并不会让桌上自动多出一台机器。 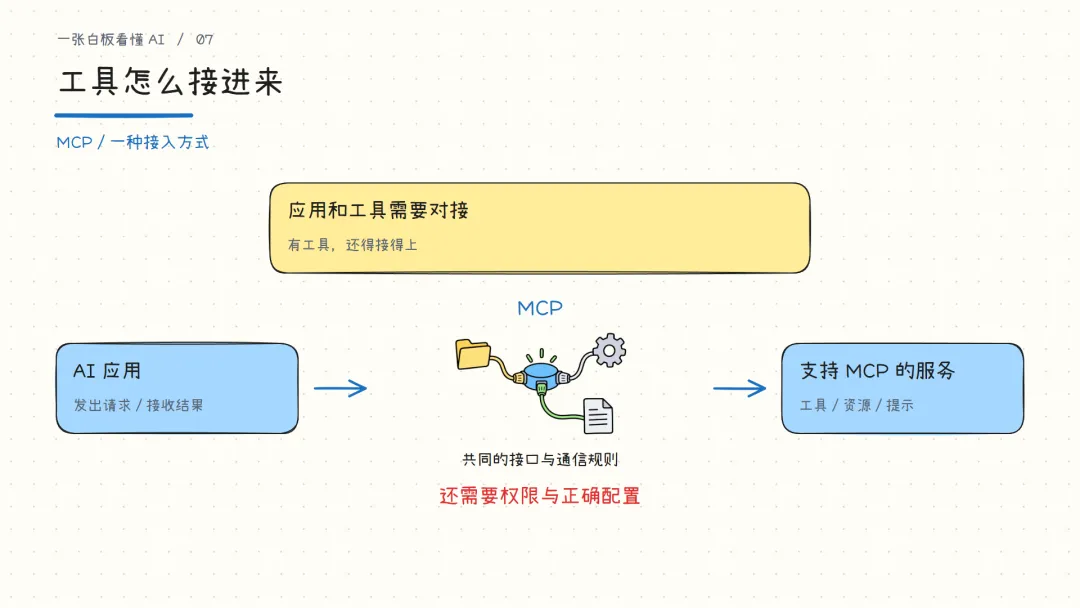
图 11统一连接方式之后,工具仍需安装、配置并取得相应权限 做成一次以后 把方法留下来 第一条视频做出来了。小林想,下次总不能再从头解释一遍制作过程。 他把方法整理成一个任务包:怎样核对来源、怎样写旁白、画面用什么模板、字幕怎么检查,以及哪些脚本可以直接运行。 这类按需读取的可复用任务说明与资源,可以组织成 Skill,技能。在开放的 Agent Skills 格式中,核心是说明文件,还可以包含脚本、参考资料和素材。 Skill 和 Tool 很容易混在一起。放回这次任务就清楚了:手册告诉搭档怎样组织制作,工具负责执行配音、绘图和导出。手册里可以带脚本,但运行脚本需要的环境和服务仍然要具备。 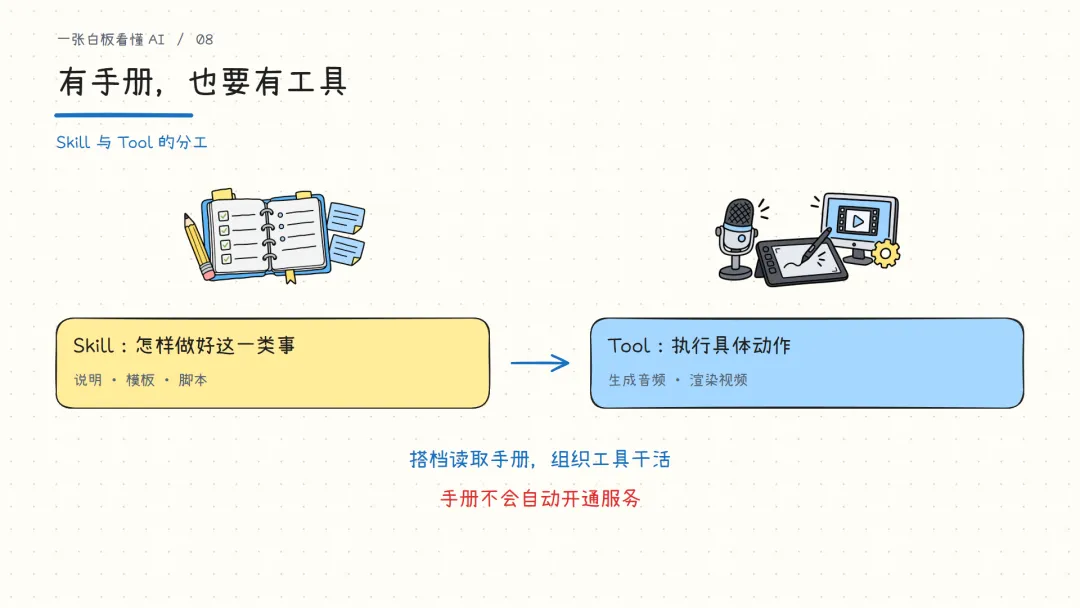
图 12Skill组织做事的方法,Tool承担具体执行 做着做着发现问题 能不能自己改 小林希望进一步省心:“目标是把视频做好,接下来该做什么,你自己安排。” 搭档先把事情拆成核资料、写稿、做样片、检查和出整片。这个环节涉及规划,有时由称作 Planner,规划器的组件承担,也可以直接由模型完成。 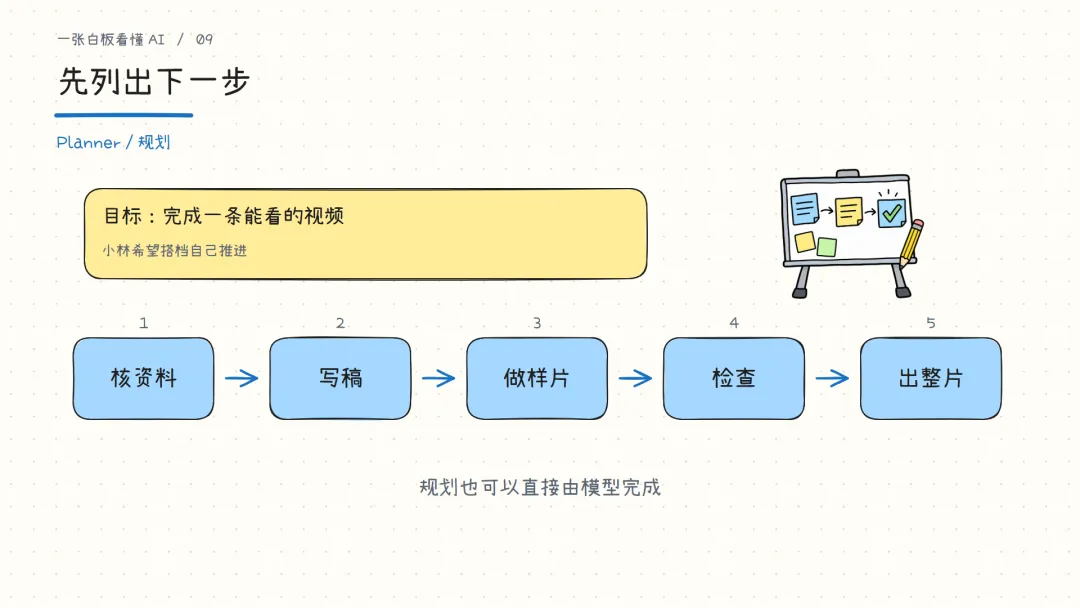
图 13把目标拆成可以执行和检查的步骤 样片出来,字幕挡住了图。搭档查看画面,调整布局,再生成一次。 做一步,看结果,判断下一步要不要改变,这种反复推进的过程叫 Loop,执行循环。循环需要停止条件:结果达标就交付;做不下去、资源用完或遇到需要人决定的事,也应该停下来处理。 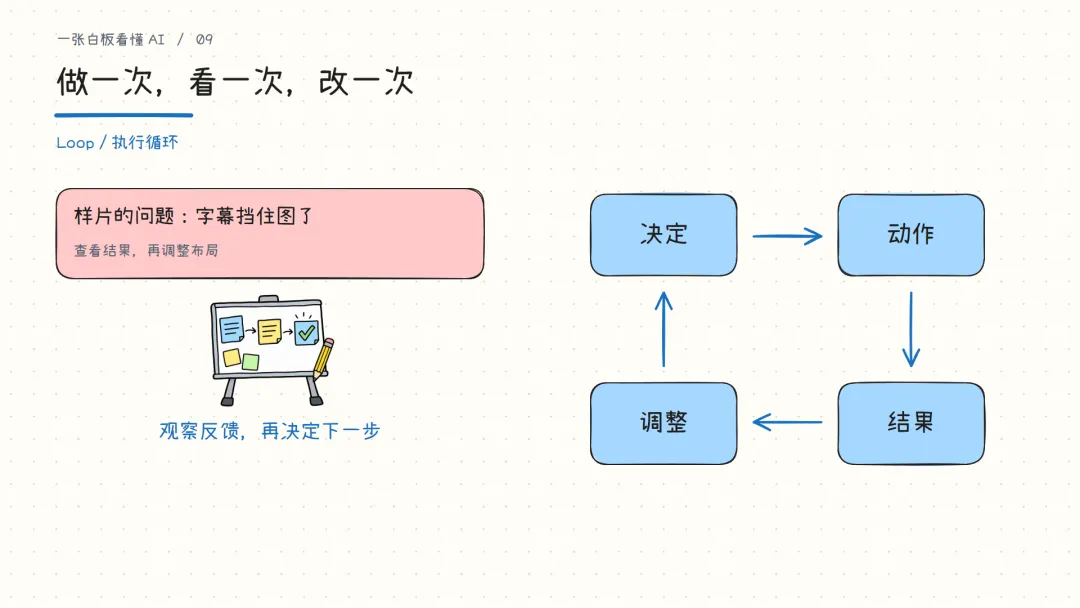
图 14决定、动作、观察结果、调整,形成有反馈的循环 模型和工具之间 还需要一套运行支撑 这个过程不会只靠一句“继续努力”自动发生。 模型调用要有人组织,工具返回的内容要传回去,任务上下文要管理,执行权限和停止条件也要落到运行环境里。 围绕模型搭起的这套运行支撑,常被叫作 Harness。在这篇文章里,我们用“工作台”帮助理解它。不同项目使用这个词的范围不完全相同,它通常不只指沙盒或权限设置。 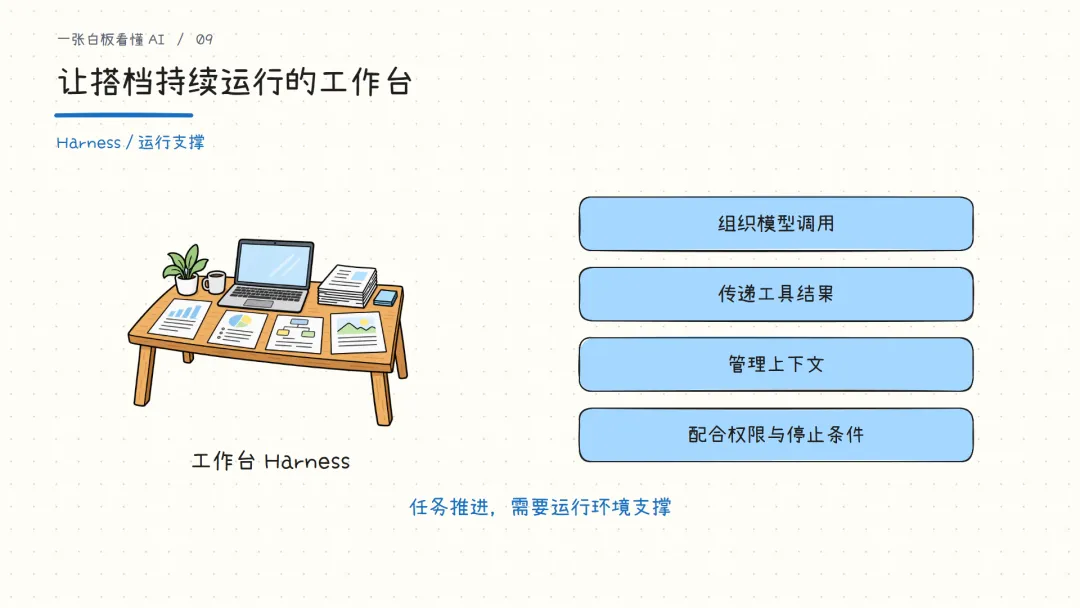
图 15Harness把模型调用、工具结果、上下文与执行边界组织起来 这时 我们才把整套系统叫作 Agent 搭档能够围绕目标选择步骤、调用工具,再根据结果调整,讨论的就已经是一套 Agent,智能体系统了。 理解这个词,重点是看任务如何推进。流程可能很简单,也可能需要多轮尝试。它可以使用记忆、检索、技能等能力,但没有一张必须凑齐“六个零件”的固定配方。预先写死的流程与由模型动态决定后续步骤的系统,也有区别。 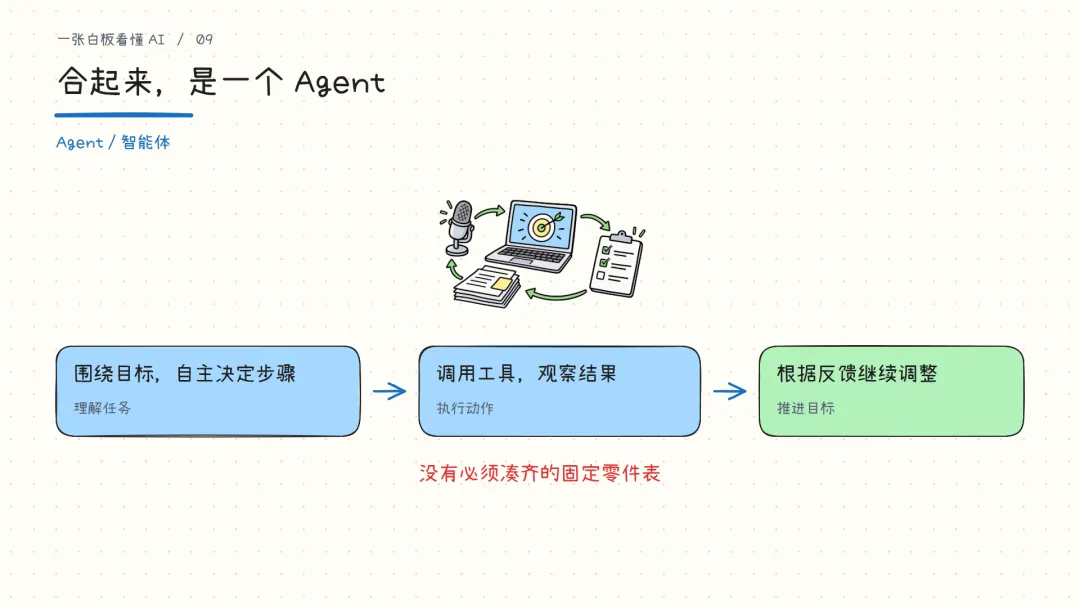
图 16围绕目标安排步骤、调用工具,并根据反馈继续调整 回到小林面前,最后还是那个可以打开的视频文件。 他要看的很具体:普通人能不能听懂?引用的材料支持稿子吗?字幕有没有挡图?这样的成片,自己愿不愿意发布? 学会这些名词之后,再看到一个“AI 能替你做事”的介绍,就可以沿着任务往下问:它读到了什么信息,接了哪些工具,留下了什么结果,遇到问题又会怎样处理。 这些问题,能帮你判断这位搭档到底做到了哪一步。 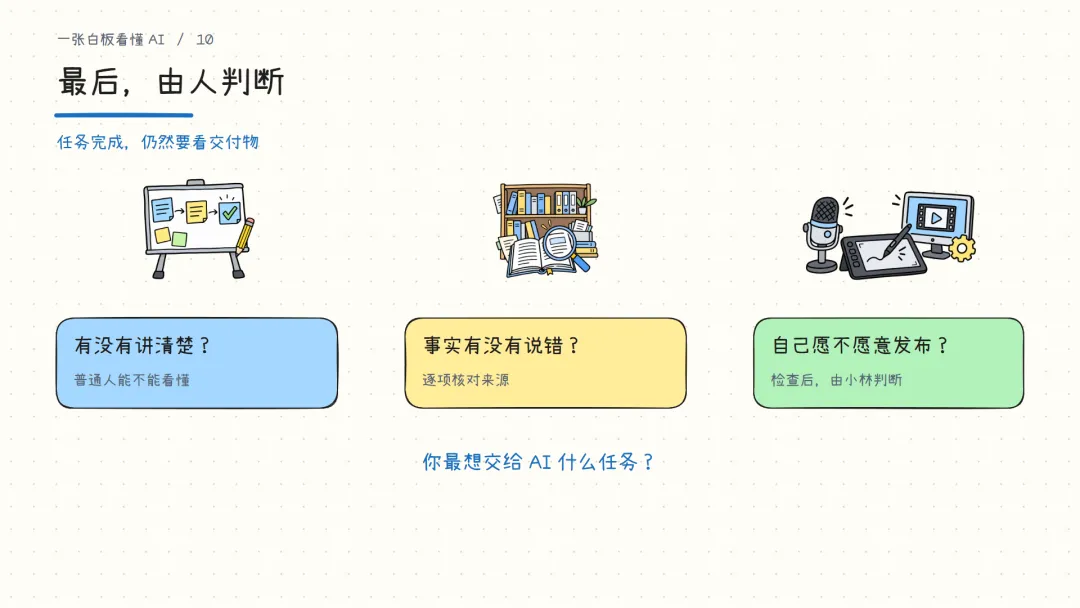
图 17最后回到交付物,由人检查表达、事实和发布意愿 20 个名词 放回各自的位置
关注
重播 分享 赞
关注
重播 分享 赞
名词 | 中文 | 在这项任务里看什么 |
Model | 模型 | 使用哪类模型处理任务 |
LLM | 大语言模型 | 理解语言、组织文本 |
Prompt | 提示词 | 受众、要求和交付物是否说清楚 |
Context | 上下文 | 当前任务实际参考了哪些信息 |
Token | 词元 | 文本被处理和计量的单位 |
Context Window | 上下文窗口 | 单次请求的容量限制 |
Memory | 记忆 | 什么被保存,之后怎样取用 |
Hallucination | 幻觉 | 结论是否缺乏依据或存在错误 |
Knowledge Base | 知识库 | 可检索的资料放在哪里 |
RAG | 检索增强生成 | 是否先找相关材料再辅助生成 |
Modality | 模态 | 输入是文字、图片、声音还是视频 |
Multimodal | 多模态 | 实际支持哪些信息形态 |
Tool | 工具 | 哪个外部程序执行动作 |
Tool Calling / Tool Use | 工具调用 | 请求、执行和结果有没有走通 |
MCP | 模型上下文协议 | 应用怎样统一对接外部能力 |
Skill | 技能 | 可复用做法、模板和脚本怎样组织 |
Planner | 规划器 | 目标怎样拆成步骤 |
Loop | 执行循环 | 是否根据结果继续调整 |
Harness | 运行支撑 | 调用、结果、上下文和边界怎样管理 |
Agent | 智能体 | 系统怎样围绕目标自主推进 |