ARTICLE · 1086643
腾讯 WeKnora 实测:不讲安装教程,只谈它为什么可能是最完整的知识库RAG 方案
一个能把"一堆文档"变成"会自己长知识的 Wiki"的开源项目 | AI工具实测系列
今天上午,我把腾讯开源的知识库引擎 WeKnora 部署到自己电脑上。
这篇文章不讲繁琐的安装教程,只回答两个问题:WeKnora 是什么?它能干什么?
一、WeKnora 是什么?一句话讲清
大白话版:一个"读过你全部文档的 AI 图书管理员"。你随口问,它随答,还给你翻到页码。
专业版:腾讯开源的知识库引擎(RAG 架构),把你的 PDF、Word、网页切片、向量化、建索引,让大模型回答问题时有据可查——每句答案自动标注来源出处,点引用直达原文段落。
对我最关键的一点:完全开源(MIT 协议),可以整套装在自己电脑上,数据不出门。
二、它能干什么:三大模式,一张图看懂
WeKnora 不是"一个功能",而是三种不同类型的活,共用同一个知识库:
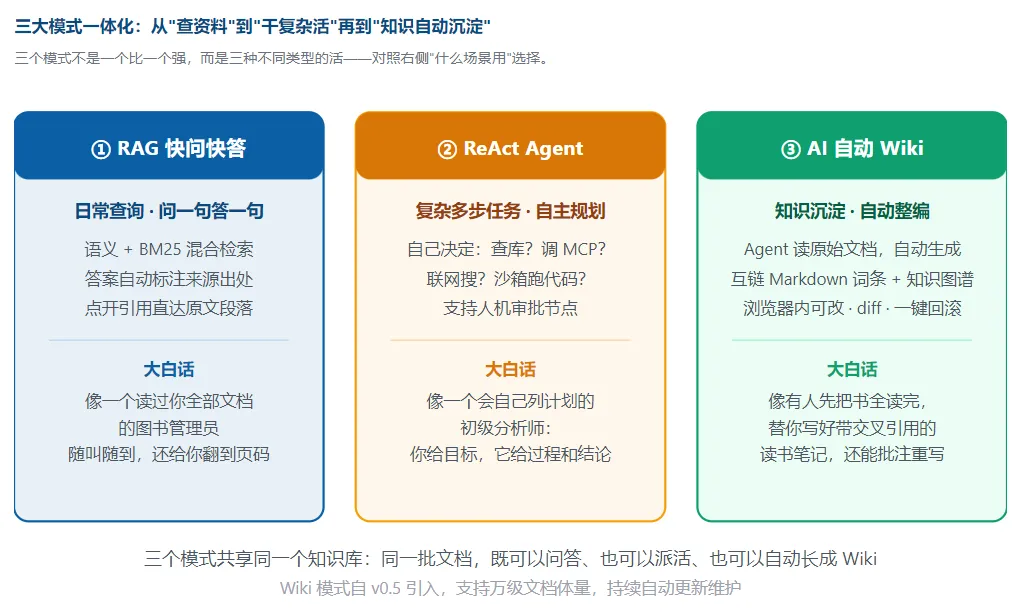
用我整理的"三大模式"图:
① RAG 快问快答(图书管理员)——日常查询,问一句答一句,答案自动标来源。
② ReAct Agent(会自己列计划的初级分析师)——复杂多步任务,它自己决定:查库?调工具?联网搜?
③ AI 自动 Wiki(替你把书读完、写好交叉引用读书笔记的人)——这个最有意思:Agent 替你把原始文档读完,自动生成互相链接的词条 + 知识图谱,浏览器里能改、能看 diff、能一键回滚。
三、最打动我的两个细节
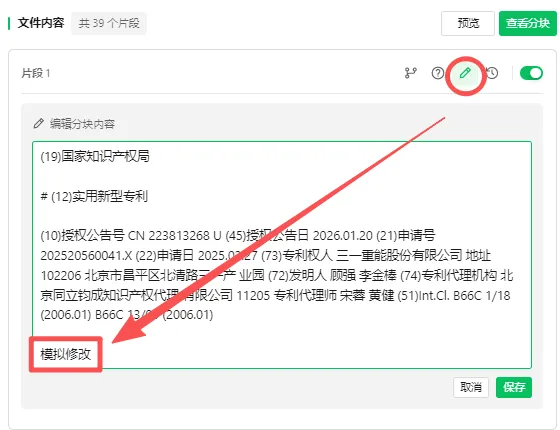
①细节一:切错的"卡片"能改
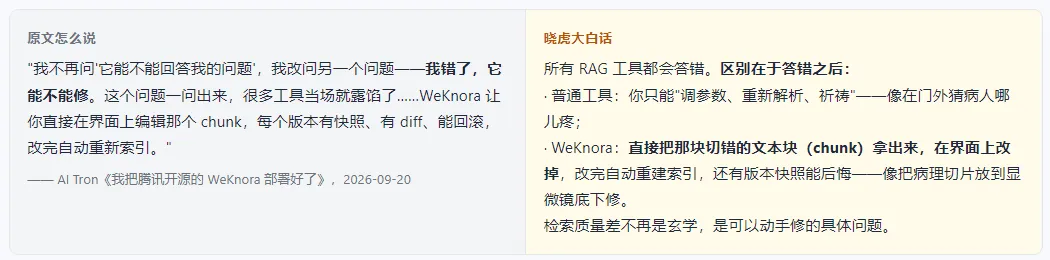
玩过知识库的人都懂一个痛:文档切片(chunk)切得不好,答案就答非所问。大多数工具你只能"调参数、重新解析、祈祷"。
WeKnora 让你直接在界面上编辑那个 chunk,每个版本有快照、有 diff、能回滚,改完自动重新索引。
就像病理切片放错了,你不是重做整张玻片,而是拿到显微镜底下直接修那一片。检索质量差不再玄学,是可以动手修的具体问题。
②细节二:它会自己长出"知识地图"
我喂给它一百多篇公开技术文档(本人实测),它自动完成了三件事:
· 每篇文档自动写摘要;· 从正文里抽出关键实体——人名、机构、技术名词,自动分类;· 把这些实体连成一张知识图谱。
实测数据:自动生成摘要 18 条、实体 97 个,图谱 500 个节点、24 种类型。点开任何一个节点,关联的文档、相关实体一目了然——相当于它替你把整个库读完了,还画了张地图。
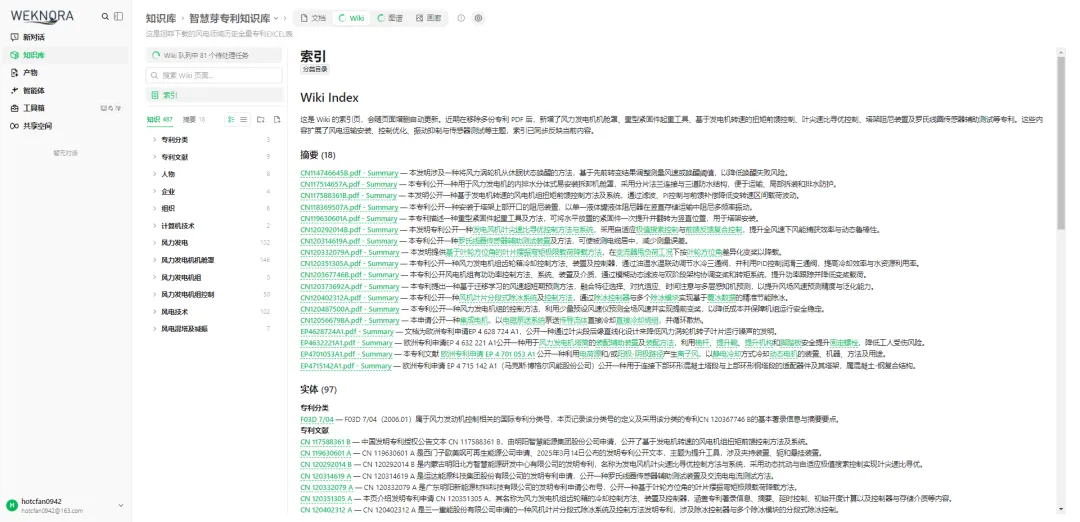
摘要 18 + 实体 97,左侧按类型自动归档(人物/组织/技术分类…)
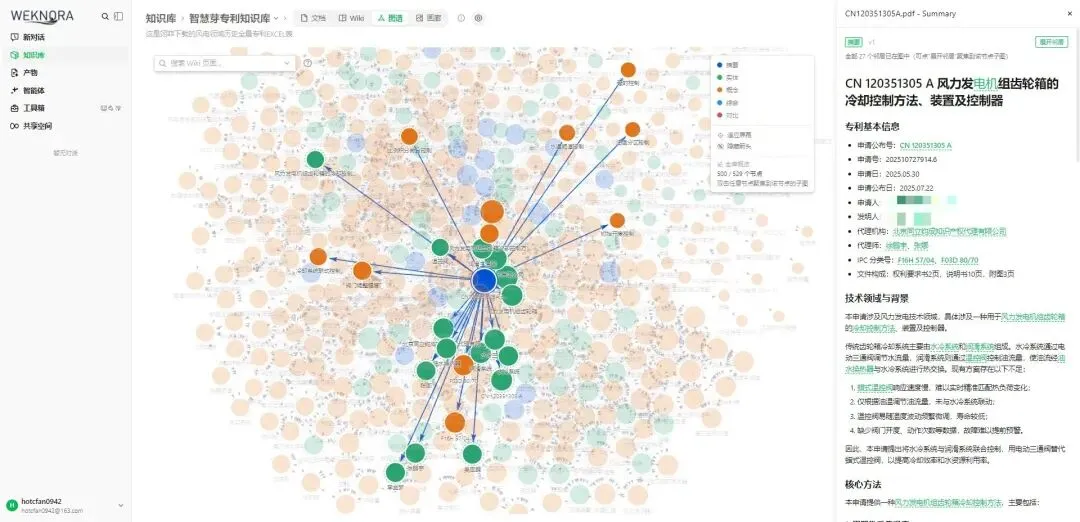
500 节点 / 24 类型,点节点展开关系网,右侧带结构化信息卡
四、安装经历
4.1 经验
安装过程就下面一句话,全程使用workbuddy 辅助安装——安装工程耗时两个小时,总体挺顺利。 
4.2 踩坑
官方镜像国内拉不到——多个加速源都没有缓存,最后用源码编译解决。虽说是个坑,只要workbuddy自己能解决,我无非只是多等一会;
嵌入模型的配置——配置模型的时候,模型的名称一个字也不能错,否则报错。
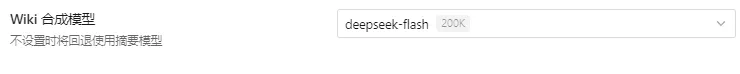
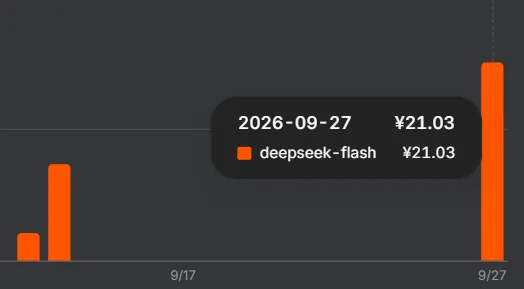
有一丢丢烧钱——基础问答LLM和Wiki合成模型,我是用的自费的DeepSeek模型,一上午花了21.03元(解析了100篇公开专利)
五、谁适合用?
✅ 文档很多、检索靠翻的团队✅ 想让数据不出本机的个人✅ 受够了"答非所问还查不了来源"的 RAG 用户
项目地址:github.com/Tencent/WeKnora(MIT 开源,可商用)。Wiki 模式自 v0.5 引入,官方称支持万级文档体量。
一上午的体验:它不一定是最强的,但可能是"开箱即得"最完整的——问答、干活、沉淀知识,一套全包。
本文仅代表个人观点,与任职机构无关。