ARTICLE · 1090499
每天一个AI项目之CrewAI — 多智能体团队协作编排框架
一、项目概述
1.1 项目简介
CrewAI 是一个开源的 Python 多智能体编排框架,由 João Moura 于 2023 年创立、2024 年 1 月正式开源。它采用"团队即编排"(Crew as Orchestration)的设计哲学,让开发者像组建人类团队一样定义多个 AI 智能体角色、分配任务、协作完成复杂工作。
截至 2026 年,CrewAI 在 GitHub 上已获得超过 44K Star,是目前最流行的多 Agent 框架之一,月执行智能体数超过 4.5 亿,广泛应用于金融、营销、科技等行业。
1.2 核心定位
- 角色化多Agent:每个 Agent 有明确的角色、目标、背景故事和工具,像真实团队成员一样分工协作
- 声明式编排:通过 Agent、Task、Crew 三层抽象,用最少代码定义复杂的多智能体工作流
- Crews + Flows 双模式:Crews 负责自主协作执行,Flows 负责精确的事件驱动流程控制
- 生产就绪:内置记忆系统、工具协议(MCP/A2A)、异步并行、Crew Studio 可视化构建
1.3 维护团队
CrewAI 由 CrewAI Inc. 开发维护,开源版本采用 MIT 协议,同时提供 CrewAI Enterprise 企业版(托管云平台、RBAC、审计日志)。项目社区活跃,贡献者超过 300 人。
二、项目架构
2.1 整体技术架构
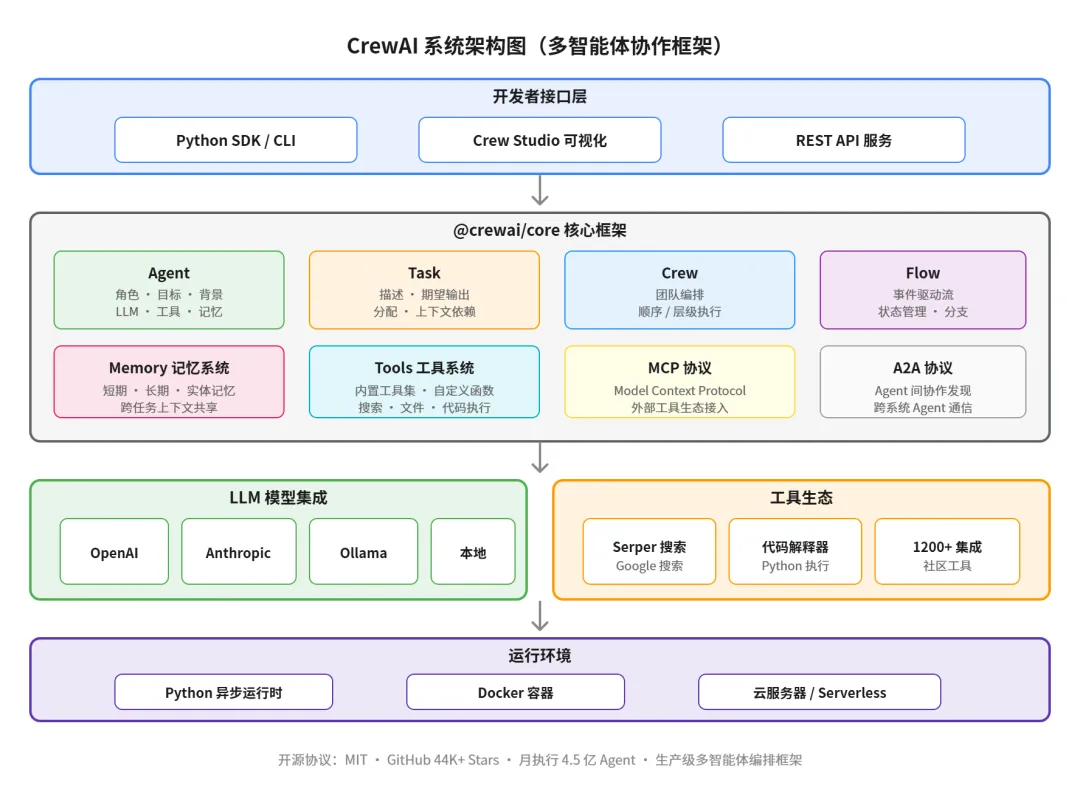
CrewAI 采用分层架构,从上到下分为声明式定义层、编排控制层、工具协议层和模型运行时层。下图展示了其完整架构:
2.2 核心抽象概念
| 概念 | 说明 |
| Agent | 智能体角色,定义 role(角色)、goal(目标)、backstory(背景)、llm、tools、memory |
| Task | 任务,定义 description(描述)、expected_output(期望输出)、assigned_agent、context(依赖任务) |
| Crew | 团队,由一组 Agent 和 Task 组成,process 指定 sequential(顺序)或 hierarchical(层级)执行模式 |
| Flow | 事件流,通过 @start、@listen、@router 装饰器定义状态机式的精确工作流控制 |
2.3 技术栈说明
- 语言:Python 3.10+
- LLM 集成:通过 LiteLLM 统一接入 OpenAI、Anthropic、Ollama、本地模型等
- 异步:基于 asyncio 支持并行任务执行和流式输出
- 协议:支持 MCP(Model Context Protocol)和 A2A(Agent-to-Agent)协议
- 可视化:Crew Studio 提供低代码构建和调试界面
三、核心功能
3.1 多Agent协作执行
- 顺序执行(Sequential):Agent 按顺序执行任务,前一个任务的输出作为后一个的上下文
- 层级执行(Hierarchical):自动创建 Manager Agent 分配任务、协调进度、汇总结果
- 任务上下文传递:通过 context 参数声明任务依赖,自动注入前置任务输出
3.2 Flow 事件驱动流
- 状态管理:Flow State 跨节点共享数据,支持条件分支和循环
- @start / @listen / @router:装饰器定义节点触发关系,精确控制执行路径
- Human-in-the-loop:支持在流程中暂停等待人工审批后继续
3.3 记忆系统
- 短期记忆:当前对话/任务的上下文缓存
- 长期记忆:跨任务持久化存储 Agent 的经验和实体知识
- 实体记忆:自动提取和追踪任务中涉及的关键实体信息
3.4 工具生态与协议
- 内置工具集:Serper 搜索、文件读写、代码解释器、XML 解析等
- MCP 协议:接入 Model Context Protocol 生态,复用海量 MCP Server 工具
- A2A 协议:支持跨 Agent、跨系统的 Agent 发现和协作
- 自定义工具:用 @tool 装饰器将任意 Python 函数包装为 Agent 工具
3.5 可观测与调试
- 执行追踪:记录每个 Agent 的思考、行动、观察全过程
- Crew Studio:可视化调试、实时观察 Agent 协作过程
- 集成 LangSmith:对接主流 LLM 观测平台
四、应用场景
4.1 典型使用场景
| 场景 | 说明 |
| 市场调研团队 | 研究员Agent搜集数据、分析师Agent整理趋势、撰写Agent生成报告,多角色协作完成深度调研 |
| 内容创作流水线 | 选题Agent、写作Agent、校对Agent、SEO优化Agent组成内容生产团队 |
| 软件开发团队 | 产品Agent定义需求、开发Agent编写代码、测试Agent验证、审查Agent做代码Review |
| 客户服务自动化 | 分类Agent识别问题类型、查询Agent检索工单系统、回复Agent生成解决方案 |
| 金融研究助手 | 数据采集Agent、财务分析Agent、风险评估Agent、报告生成Agent协作完成投研报告 |
4.2 适用人群
- AI 应用开发者:构建多Agent系统,替代复杂的单Agent提示工程
- 自动化工程师:将多步骤业务流程自动化,减少人工干预
- 数据分析师 / 研究员:自动化调研、数据汇总、报告生成流程
- 企业架构师:设计可扩展的Agent协作系统,落地AI办公场景
五、项目价值
5.1 解决的核心问题
单个大模型 Agent 在处理复杂任务时容易"跑偏"和遗忘上下文。CrewAI 的价值在于将复杂任务分解给多个角色化 Agent,通过明确的分工、任务依赖和层级管理,让 AI 团队像人类团队一样可靠地完成多步骤、多领域的复杂工作。
5.2 优势亮点
- 极简API:几十行代码即可定义一个多Agent团队,学习曲线平缓
- 双模式灵活:Crews 自主探索 + Flows 精确控制,兼顾灵活性和可靠性
- 协议原生支持:MCP + A2A 原生支持,无缝接入 Agent 生态
- 生产级成熟:企业级可靠性,月执行4.5亿Agent,经过大规模验证
- MIT 协议:完全开源,无商业使用限制
5.3 与同类框架对比
相比 LangGraph 的图式编排,CrewAI 更注重角色抽象和团队协作的直觉表达;相比 AutoGen 的对话式交互,CrewAI 的任务导向设计更适合生产环境的确定性输出。它是目前"多Agent团队"范式中最简洁、最易用的框架。
六、入门使用教程
6.1 环境要求
- Python 3.10 及以上版本
- OpenAI API Key(或兼容 OpenAI 接口的模型服务,如 Ollama)
- pip 包管理工具
6.2 安装 CrewAI
# 创建虚拟环境(推荐)python -m venv crewai-envsource crewai-env/bin/activate # Linux/Mac# crewai-env\Scripts\activate # Windows# 安装 CrewAIpip install crewai crewai-tools# 配置 API Keyexport OPENAI_API_KEY="sk-your-api-key-here"6.3 第一个多Agent团队
from crewai import Agent, Task, Crew, Process# 定义 Agent:研究员researcher = Agent( role="行业研究员", goal="搜集并整理 AI 行业最新趋势和关键数据", backstory="你是一位资深行业分析师,擅长从多个来源搜集数据并提炼洞察", verbose=True, allow_delegation=False)# 定义 Agent:撰稿人writer = Agent( role="技术撰稿人", goal="将研究成果写成一篇清晰易懂的中文分析文章", backstory="你是一位优秀的科技作者,擅长把复杂技术话题讲得通俗有趣", verbose=True)# 定义任务:研究任务research_task = Task( description="调研 2026 年 AI Agent 领域的三大技术趋势,列出关键数据和代表项目", expected_output="一份包含三大趋势、数据点和代表项目的中文研究摘要", agent=researcher)# 定义任务:写作任务(依赖研究任务输出)write_task = Task( description="根据研究摘要,写一篇 800 字的中文分析文章,面向技术从业者", expected_output="一篇结构完整、有观点、有数据的中文分析文章", agent=writer, context=[research_task])# 组建 Crew 并执行crew = Crew( agents=[researcher, writer], tasks=[research_task, write_task], process=Process.sequential, verbose=True)result = crew.kickoff()print(result)6.4 使用本地模型(Ollama)
from langchain_ollama import ChatOllama# 定义本地 LLMlocal_llm = ChatOllama( model="qwen2.5:7b", base_url="http://localhost:11434")# Agent 中指定 llmresearcher = Agent( role="行业研究员", goal="搜集并整理 AI 行业最新趋势", backstory="你是资深行业分析师", llm=local_llm)七、典型 DEMO 开发示例
DEMO 1:市场调研自动化团队
目标
构建一个自动化市场调研团队:搜索Agent搜集竞品信息 → 分析Agent对比优劣势 → 报告Agent输出结构化调研报告。整个流程自动执行,无需人工干预。
完整代码
from crewai import Agent, Task, Crew, Processfrom crewai_tools import SerperDevTool, WebsiteSearchTool# 工具初始化search_tool = SerperDevTool()web_tool = WebsiteSearchTool()# Agent 1:竞品搜索专家research_agent = Agent( role="竞品搜索专家", goal="搜集目标 AI 产品的最新信息、定价策略和用户评价", backstory="你擅长网络信息检索,能快速从多个来源定位关键数据", tools=[search_tool, web_tool], verbose=True)# Agent 2:竞品分析师analyst_agent = Agent( role="竞品分析师", goal="对比分析竞品的功能差异、定价策略和市场定位", backstory="你是经验丰富的产品分析师,擅长从数据中提炼战略洞察", verbose=True)# Agent 3:报告撰写人report_agent = Agent( role="市场报告撰写人", goal="将分析结果整理成结构清晰、数据详实的中文调研报告", backstory="你是专业的商业报告撰稿人,逻辑严谨、表达简洁", verbose=True)# 任务 1:搜集竞品信息research_task = Task( description="调研 Notion AI、飞书智能伙伴、钉钉 AI 助理三款产品的最新功能、定价和用户评价", expected_output="一份包含三款产品功能清单、定价对比表和主要优缺点的中文摘要", agent=research_agent, tools=[search_tool])# 任务 2:分析对比analysis_task = Task( description="基于搜集到的信息,分析三款产品在功能、价格、目标用户上的差异化定位", expected_output="一份结构化的竞品对比分析,包含优势矩阵和差异化洞察", agent=analyst_agent, context=[research_task])# 任务 3:撰写报告report_task = Task( description="将分析结果写成一份完整的市场调研报告,包含执行摘要、竞品对比表、趋势判断", expected_output="一份 1500 字左右的中文市场调研报告 Markdown 文档", agent=report_agent, context=[analysis_task])# 组建团队crew = Crew( agents=[research_agent, analyst_agent, report_agent], tasks=[research_task, analysis_task, report_task], process=Process.sequential, verbose=True)# 执行result = crew.kickoff()print(result)运行结果
三个 Agent 依次执行:搜索Agent 先联网搜集三款产品的公开信息 → 分析Agent 对比功能和定价 → 报告Agent 输出完整 Markdown 调研报告。最终输出可直接用于产品决策参考。
DEMO 2:软件开发团队(Flow 模式)
目标
使用 CrewAI Flow 构建一个受控的软件开发流程:需求解析Agent → 代码生成Agent → 代码审查Agent → 条件判断(通过/打回重写)→ 交付。使用 @router 实现质量门禁。
完整代码
from crewai import Agent, Task, Crew, Flowfrom crewai.flow.flow import start, listen, routerfrom pydantic import BaseModel# 定义 Flow 状态classDevFlowState(BaseModel): requirements: str = "" code: str = "" review_result: str = "" approved: bool = False# Agent 定义pm_agent = Agent( role="产品经理", goal="将用户需求拆解为清晰的技术开发任务", backstory="你是严谨的技术产品经理,擅长把模糊需求转化为明确的开发规格", verbose=True)dev_agent = Agent( role="Python 开发工程师", goal="根据开发规格编写高质量、可运行的 Python 代码", backstory="你是资深 Python 开发,代码规范、注释完整、注重边界处理", verbose=True)reviewer_agent = Agent( role="代码审查员", goal="审查代码的正确性、安全性和规范性,给出通过或打回结论", backstory="你是严格的代码审查员,关注边界条件、错误处理和最佳实践", verbose=True)classDevFlow(Flow[DevFlowState]): @start()defparse_requirements(self):"""步骤1:解析需求""" task = Task( description=f"将以下需求拆解为开发规格:{self.state.requirements}", expected_output="一份结构化的开发规格,包含功能点、输入输出和边界条件", agent=pm_agent ) crew = Crew(agents=[pm_agent], tasks=[task]) spec = crew.kickoff()return {"requirements": spec} @listen(parse_requirements)defwrite_code(self):"""步骤2:编写代码""" task = Task( description=f"根据开发规格编写 Python 代码:{self.state.requirements}", expected_output="完整的可运行 Python 代码,包含注释和错误处理", agent=dev_agent ) crew = Crew(agents=[dev_agent], tasks=[task]) code = crew.kickoff()return {"code": code} @listen(write_code)defreview_code(self):"""步骤3:代码审查""" task = Task( description=f"审查以下 Python 代码的质量:{self.state.code}", expected_output='JSON 格式:{"approved": true/false, "issues": "问题描述"}', agent=reviewer_agent ) crew = Crew(agents=[reviewer_agent], tasks=[task]) result = crew.kickoff()import json parsed = json.loads(result)return {"review_result": result, "approved": parsed["approved"]} @router(review_code)defquality_gate(self):"""质量门禁:通过则交付,否则打回重写"""ifself.state.approved:return"deliver"return"rewrite" @listen("deliver")defdeliver_code(self):print("代码审查通过,交付最终版本:")print(self.state.code) @listen("rewrite")defrewrite_code(self):print("代码审查未通过,打回开发团队重写...")# 运行流程flow = DevFlow()flow.state.requirements = "写一个 Python 函数,输入数字列表,返回其中的质数"flow.kickoff()运行结果
流程按受控路径执行:PM 解析需求 → 开发写代码 → 审查员给出 JSON 结论 → router 判断是否通过。通过则交付,不通过则标记打回。这种模式比纯自主 Crew 更可控,适合对输出质量有严格要求的生产场景。