ARTICLE · 1104900
咳嗽AI辅助结核病诊断
结核病是全球传染病里致死人数最多的病,2023 年全世界大约有 1080 万人得病,125 万人因此去世,这里面还包括 16.1 万艾滋病毒感染者。疫情本来一直在慢慢好转,但新冠这几年把进度打断了,发病率和死亡率又开始往上走。更让人头疼的是,这个病的重灾区大多在中低收入国家,医疗资源本来就紧,诊断还特别慢—— 很多人直到拖到晚期才被发现,边治边传染给身边人。
现在查结核主要靠痰检,涂片、培养、核酸扩增这些方法,在实验室里还行,一到基层就抓瞎。痰涂片灵敏度低,儿童、艾滋病人、肺外结核这些群体尤其容易漏诊;痰培养要等好几天甚至几周;核酸检测得有专门设备和人,社区根本配不起。胸部 X 光加上电脑辅助诊断算是个进步,但还是得有机器、有会看片子的医生。说白了,当前控制结核最大的瓶颈就是诊断太慢、漏诊太多。
那咳嗽呢?咳嗽是结核最常见的症状,几乎每个病人都咳。手机现在人人都有,录个咳嗽声不用花钱、不用耗材、不用抽血吐痰,拿起来就能录。科学家就琢磨:能不能让 AI 听咳嗽声,直接判断这个人有没有结核?这个方向最近几年发展特别快,已经从实验室概念走到了手机试点。
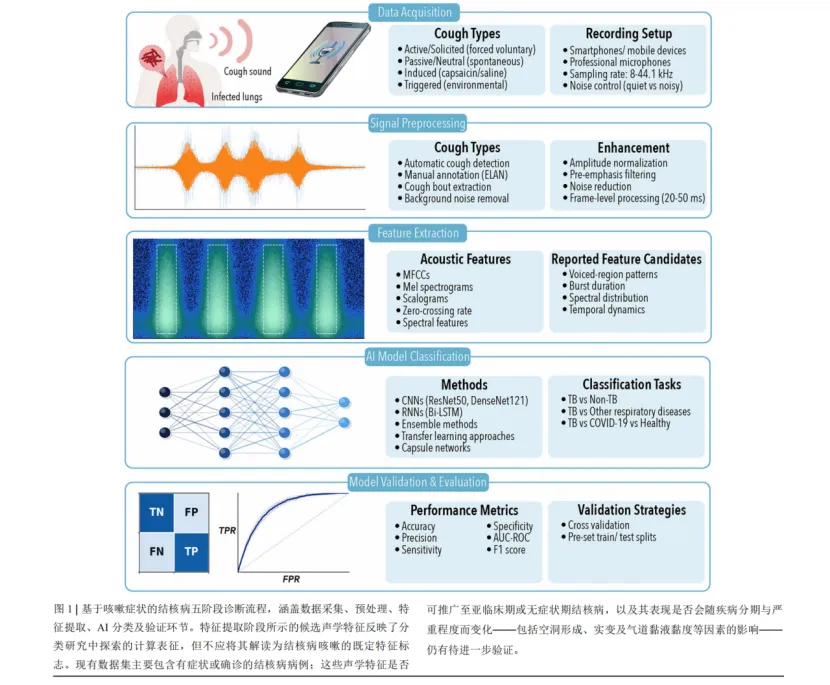
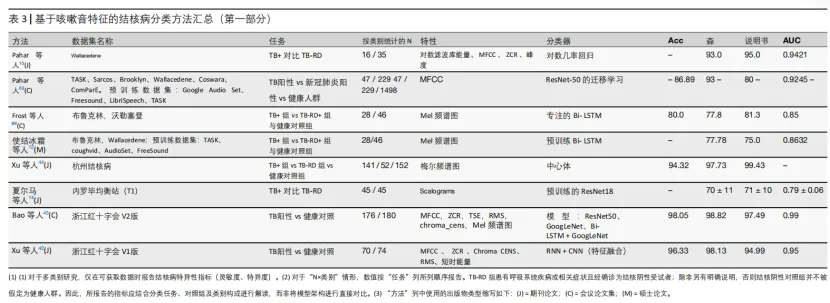
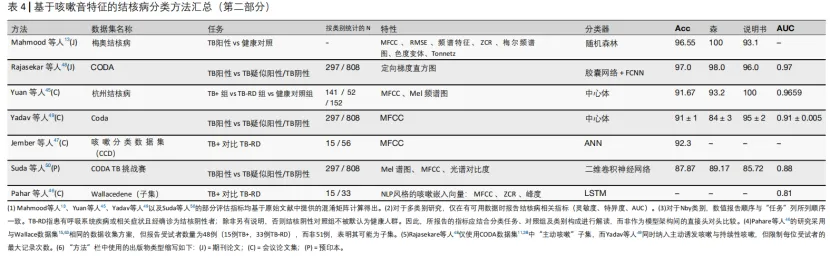
这篇综述梳理了 123 项相关研究,其中 40 项是直接用人工智能做咳嗽和结核诊断的。技术上其实不复杂,五步走:先录咳嗽声,再把信号洗干净、把咳嗽片段切出来,然后提取声音特征,喂给 AI 模型训练,最后拿数据验证准不准。录音设备从专业麦克风到普通手机都行,采样率8到44.1千赫不等;特征提取最常用的是梅尔频率倒谱系数,简称MFCC,简单说就是把咳嗽声拆成人耳敏感的频率成分;模型用得最多的是卷积神经网络,把声谱图当图片来认,ResNet和DenseNet是常客,也有不少用循环神经网络、随机森林的。
效果到底怎么样?数据其实挺亮眼。南非的Swaasa TB数据集上,对数几率回归做到了95%的准确率,AUC达到0.9421;中国杭州的数据集上,RNN加CNN特征融合的方法准确率96.33%,灵敏度98.13%,特异度94.99%;浙江红十字V2版数据上,GoogleNet加LSTM的组合准确率冲到98.05%。但这里有个大坑—— 这些数字都是在特定数据集上跑出来的,换个地方、换批人,可能就垮了。
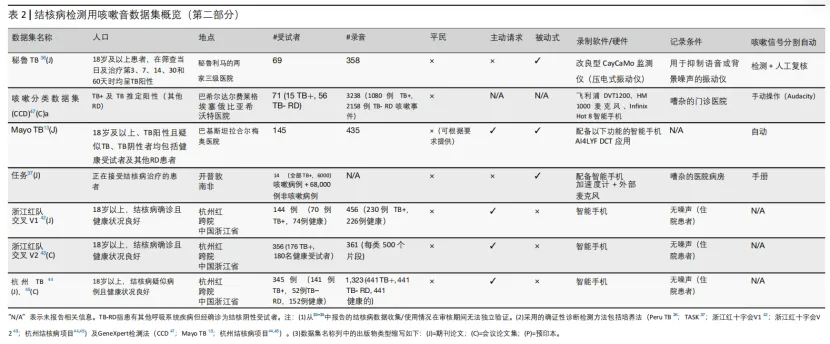
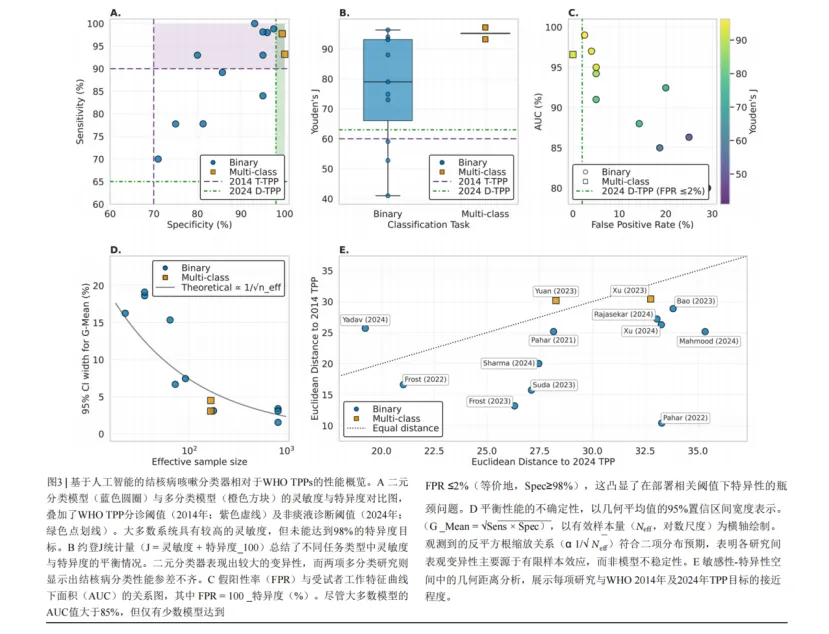
世界卫生组织 2014 年定的目标是灵敏度不低于 90%、特异度不低于 70%,2024 年又加严了,出了个非痰诊断的版本,要求灵敏度和特异度都不低于 98%。对照老标准,13项研究里有8项灵敏度达标、全部13项特异度达标;但对照新标准,只有2项研究达到了98%的特异度要求。换句话说,现在的模型拿来做筛查粗筛还行,真要当确诊依据,假阳性还是太多—— 一千个人里错判二十个,在社区大规模筛的时候根本扛不住。
问题出在哪?综述掰开揉碎讲了好几个硬伤。
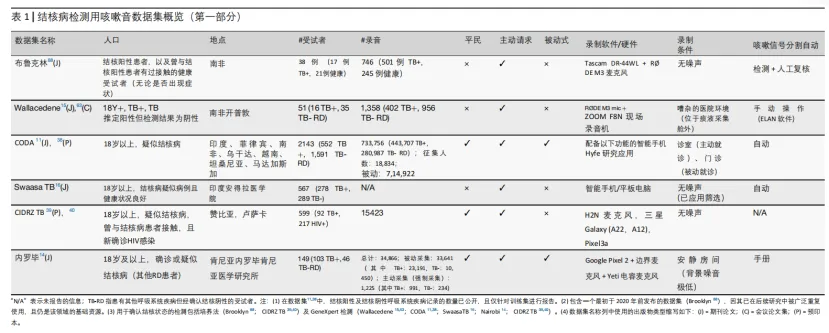
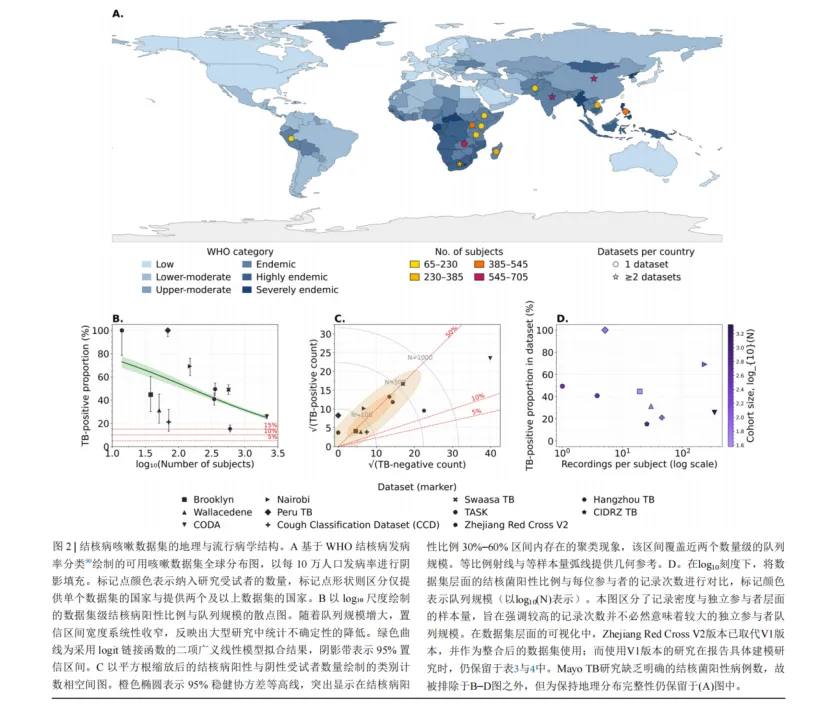
第一个是数据。现在公开的咳嗽结核数据集,绝大多数来自南非少数几个研究中心,中西亚、东南亚这些高负担国家的数据几乎是空白。样本量也小,大部分数据集参与者不到 200 人,真正公开能下载的只有 3 个,剩下的要么得申请要么根本拿不到。更关键的是阳性率偏得离谱 —— 数据集里结核阳性的比例动不动 30% 到 60%,可真实社区里结核患病率连 1% 都不到。拿这种"病人堆出来"的数据训模型,到了真实人群里,假阳性会炸锅。
第二个是录音环境。几乎所有数据都是在安静房间里、医生让你"咳一下"录出来的主动咳嗽,真正在大街上、家里、地铁里自然咳的声音几乎没有。可真到社区部署,背景全是人声、车声、小孩哭,手机麦克风位置也歪歪扭扭,模型在这种环境下能不能扛住,谁也不知道。被动咳嗽录音倒是更贴近真实,但问题是——你得等到他真的咳出来才行,没症状的人你总不能守着他录一天。
第三个是模型自己的毛病。深度学习是黑盒,你不知道它到底是听懂了咳嗽里的病理特征,还是学会了认录音设备的底噪、或者抓了某个无关的巧合信号。医生不敢用一个自己都说不清 "凭什么判断" 的模型,监管也批不了。而且模型在自家测试集上跑分高,换个医院、换批人群、换个手机,准确率就掉下去,这种泛化性差的问题到现在没解决。
第四个是人群偏倚。现在研究收的都是已经有症状、来医院看病的人,真正没症状、早期、临床前期的人几乎没被纳入过。可社区筛查要找的恰恰是这些人—— 你拿有症状病人的数据去筛没症状的人,从根上就不对。
那这事还能不能做?综述给出的答案是能,但得一步步来。
第一步,得建一个真正大规模、标准化、覆盖全球的咳嗽数据库,不能再各干各的了。世界卫生组织和遏制结核病伙伴组织(FIND)已经在推这个事。录音不能只在安静实验室录,得包含基层诊室、家里、户外半公共场所各种真实场景。儿童、艾滋病人、糖尿病人、老人这些弱势群体都得覆盖到,不然模型永远偏向健康成年男性。
第二步,模型得学会适应新环境。不能换个地方就得从头训。领域自适应、迁移学习这些方向已经有进展—— 拿大规模通用语音数据预训练,再用少量结核数据微调,效果不错,但还得继续磨。
第三步,得让AI"开口解释"。用注意力机制、特征归因这些方法,告诉医生:模型之所以判阳性,是因为咳嗽里某段频率、某个时间点有异常,而不是瞎猜。这样临床才敢用,监管才敢批。
第四步,也是最关键的一步——真正的前瞻性临床试验。现在所有数据都是回顾性的,拿历史录音跑模型。但模型真放到社区、放到诊所、放到穷人区,能不能扛住?会不会增加医生负担?成本划不划算?这些都没人知道。目前全世界没有任何一个国家把咳嗽AI正式纳入常规结核筛查流程,所有系统都还在研究或试点阶段。
综述还提了一个很实在的思路:别指望咳嗽单打独斗。呼吸声、肺部听诊、皮肤传感器、电子健康档案里的风险因素—— 年龄、性别、既往病史、HIV 状态、合并症 —— 把这些拼到一起做多模态诊断,效果肯定比单听咳嗽好。南非已经有研究把咳嗽特征和 X 光结合,做多病种分类,方向是对的。
伦理和公平也绕不开。咳嗽声是生物识别数据,跟指纹、人脸一样,谁有权存、谁能用、用了多久,都得有规矩。而且数字工具本身会加剧不平等—— 老人、穷的人、不会用智能手机的人会被排除在外。设计的时候就得想着怎么让这些人也能用,而不是做完了再补丁。
从监管角度看,美国 FDA 已经把这类软件归为 "软件作为医疗器械"(SaMD)管理,世界卫生组织也出了 AI 伦理治理指南。但模型是会变的 —— 数据更新、算法迭代,怎么持续监管?这个问题全世界都还在摸索。