ARTICLE · 1104890
AI 安全与内容审计:上线前,必须守住的三道防线
AI 安全与内容审计:上线前,必须守住的三道防线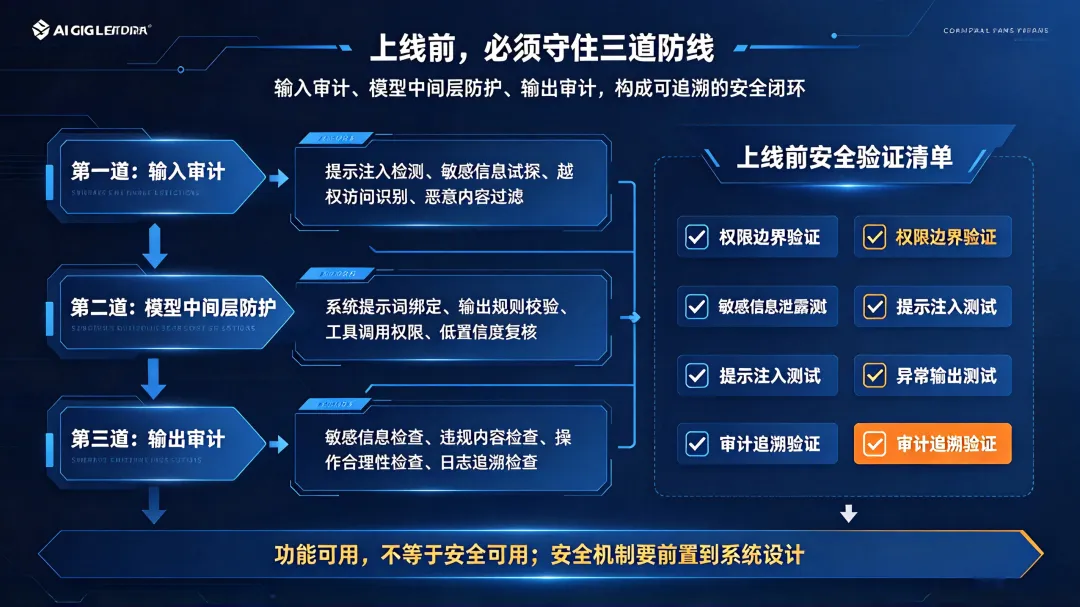
很多企业在评估 AI 应用时,主要关注效果指标,比如回答准确率、任务完成率、用户满意度。但真正上线后,风险往往出现在效果指标之外。 比如,用户通过诱导性提问获取内部资料;模型把训练或检索到的敏感信息直接带入回答;智能体在未授权情况下执行关键操作;输出内容涉及违规表述、歧视性语言或不当建议;系统没有完整日志,出问题后无法追溯。这些问题一旦发生,影响可能远超 “回答不准确”。 因此,企业 AI 系统不能只做功能测试,还要做安全测试、权限测试、边界测试和审计能力验证。 输入审计发生在用户请求进入模型或智能体之前,目标是识别风险请求并决定是否放行、拦截或转人工处理。 输入审计重点关注四类风险。第一是提示注入攻击,用户试图通过特殊指令绕过系统设定,让模型忽略原有角色和规则。第二是敏感信息试探,用户诱导模型泄露内部文档、客户资料、系统配置或未公开方案。第三是越权访问尝试,用户尝试访问超出自身权限的数据或功能。第四是恶意内容输入,包括违法、违规、暴力、诈骗等风险内容。 企业可以在输入层建立规则过滤、意图识别、敏感词检测、权限校验等机制。对高风险输入,不一定全部拒绝,但至少要做到拦截、标记、日志记录和人工复核。 模型中间层防护,是指在模型调用前后建立安全控制,避免模型成为风险出口。 这一层的核心措施包括:第一,系统提示词安全绑定,防止用户覆盖模型角色和业务边界;第二,输出前的规则校验,检查是否包含敏感信息、违规内容或越权操作;第三,工具调用权限控制,智能体调用接口时,必须验证动作、对象、范围和用户权限;第四,幻觉与编造检测,对高置信度内容自动处理,对低置信度内容提示复核。 模型中间层防护的目标,不是让模型 “更会回答”,而是让模型 “更守边界”。 输出审计发生在模型结果返回给用户之前或之后,重点检查最终内容是否可安全流出。 输出审计至少应覆盖五类检查:一是敏感信息检查,判断是否泄露客户隐私、内部资料、密钥或未公开信息;二是违规内容检查,判断是否存在违法、违规、歧视、暴力或诈骗风险;三是格式一致性检查,判断输出是否符合系统要求,是否存在异常篡改;四是操作合理性检查,判断智能体建议或执行动作是否符合业务规则;五是日志追溯检查,判断关键请求、模型输出、工具调用和人工处理是否完整留痕。 对于企业级应用,输出结果不能 “裸奔返回”。重要场景应建立 “模型生成 + 安全校验 + 人工复核 + 日志追溯” 的闭环。 第一,权限边界验证。验证不同角色用户是否只能访问权限内的数据和功能,确认越权尝试是否被有效拦截。 第二,敏感信息泄露测试。模拟用户诱导、文档引用、上下文泄露等场景,检查模型是否输出敏感信息。 第三,提示注入测试。尝试覆盖系统角色、绕过业务规则、诱导模型执行非预期操作,验证输入层和中间层防护是否生效。 第四,异常输出测试。测试模型在信息不足、冲突资料、复杂指令、恶意输入下的输出表现,确认是否会编造、附和风险内容或执行异常动作。 第五,审计追溯验证。确认关键请求、模型输出、工具调用、人工处理结果都有日志记录,且可按用户、时间、类型、结果进行追溯。 企业 AI 应用上线,不能只看效果演示。功能可用,不等于安全可用。输入审计、模型中间层防护和输出审计三道防线,应成为企业 AI 系统的标准配置。 建立安全与审计机制,不是为了限制 AI 能力,而是为了让 AI 更稳定、更可信地进入真实业务流程。越早把安全边界、权限控制和审计追溯纳入系统设计,后续项目越容易合规落地。
01 AI 系统的风险,不只是 “回答错了”