ARTICLE · 1111768
美议员称绝不能让中国AI赢
当美国议员说"绝不能让中国赢":一句口号,和它背后那台真实的机器
一、先把事情说清楚:一句极端的话,和一份很长的清单
2026年春天,美国国会吵的并不是税收或医保,而是要不要给AI踩刹车。无党派参议员伯尼·桑德斯与众议员奥卡西奥-科尔特斯提出《人工智能数据中心暂停法案》,主张在国会通过严格监管规则前,全面暂停全美AI数据中心的建设与扩建。理由很具体:电费上涨、社区资源被挤占、收益只流向少数人。桑德斯的原话是"得让民主追上来"。
反击来得很快。参议员费特曼直接在社交平台X上定性:"暂停就是'中国优先'(A moratorium is China First)。"犹他州共和党参议员、参议院能源与自然资源委员会主席迈克·李则把话说到了极致——"这场仗绝不能让中国赢,若我们输了,全人类就都输了。" 他还将任何让美国减速的主张等同于"通敌"。同一时期,财长贝森特在右翼媒体活动上称"如果中国赢了AI竞争,美国将没有后天";特朗普也在高尔夫球场对记者表示"谁赢了超级智能,谁就赢了"。
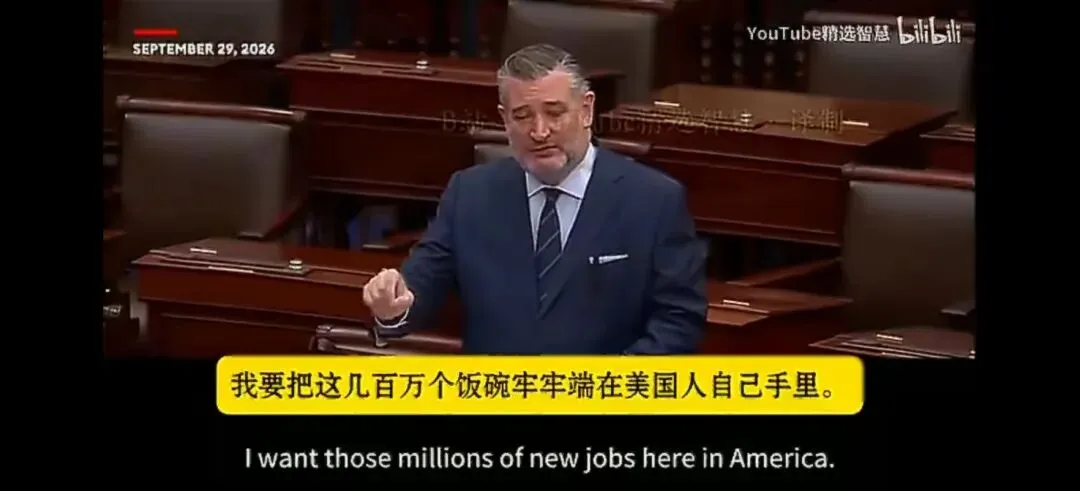
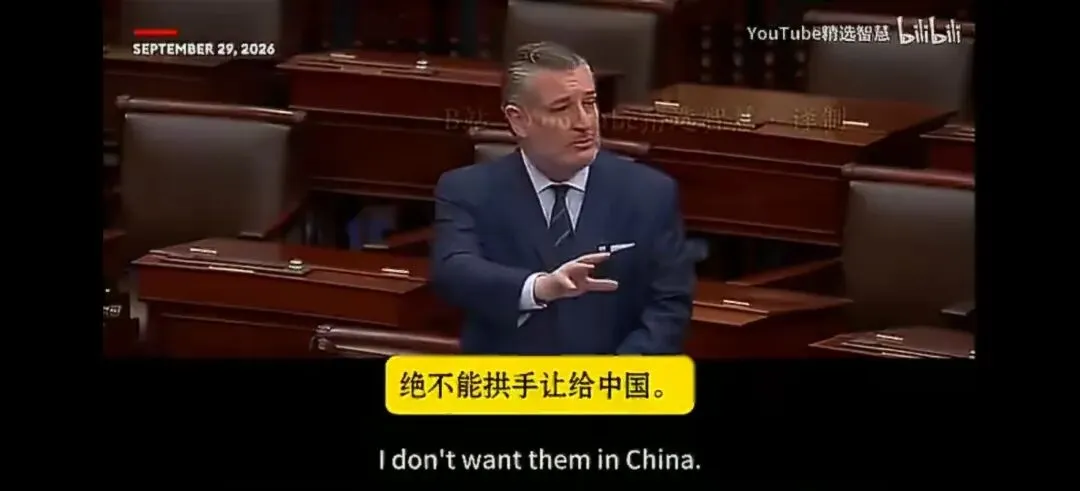
这句话之所以值得细读,是因为它并非孤立的情绪宣泄,而是一整套政策动作的修辞外壳。把它摊开来看,清单长得惊人:
- 算力层:BIS自2022年起多次收紧对华高端AI芯片出口,2026年1月起部分产品由"推定拒绝"改为"逐案审查",同时附加严苛条件;5月起明确"母公司穿透"原则,堵死经第三国子公司采购的路径;众议院还推动将云端远程访问纳入管制授权。
- 制造层:联合日荷协调设备出口,拟禁DUV浸没式光刻机及售后支持;实体清单与所谓"涉军企业清单"持续扩容。
- 模型层:以"蒸馏""窃取知识产权"为由威胁制裁中国企业,参议院提出BLADE法案;6月还把顶级模型纳入出口管制范围。
- 供应链层:两党议员提案禁止敏感联邦系统使用中国制造的光收发器,点名中际旭创、新易盛——尽管美国业界自己警告这会拖慢本国数据中心建设。
- 资本与人才层:限制美资投资中国AI与半导体;收紧签证,斯坦福报告显示移居美国的AI学者数量较2017年大幅下降。
与此同时,美方内部其实正在剧烈撕裂:桑德斯与奥卡西奥-科尔特斯要暂停数据中心,费特曼骂他们"递刀子";特朗普一面把AI风险警告斥为"骗局",一面又拉着科技巨头签"道德约束"式的自律协议;参议院一项旨在防止数据中心推高居民电价的法案,因程序性投票未达60票门槛而受阻。数据中心议题的政治广告支出已达数千万美元量级,成为中期选举的真问题。
我的判断很朴素:AI只是工具,远没到封神的地步;但我们绝不能因此放弃发展它,因为从长远看,这是一场工业革命级别的通用技术扩散,而不是一场谁先撞线谁通吃的短跑。
佐证恰恰来自美国人自己的数据。斯坦福大学HAI发布的《2026年AI指数报告》显示,截至2026年3月,中美顶尖模型的性能差距已缩小到2.7%,自2025年初以来双方多次交替登顶——这意味着"绝对领先"在客观数据上早已不成立。但同一份报告也指出:美国2025年私营部门AI投资约2859亿美元,远超中国;美国拥有5427个AI数据中心,中国为449个;中国在AI论文、专利以及工业机器人装机量(约占全球54%)上占优。差距并没有消失,而是换了地方:美国差在电力、电网、社会共识和人才流入;中国差在先进制程芯片。 换句话说,这场竞争的胜负手,早就越出了"谁的模型更聪明"的范畴。
二、把技术讲透:它从哪里来,卡在哪里,下一步往哪走
要判断"谁赢谁输"这种说法有多少分量,得先看清这台机器本身的脾气。
它是怎么来的。 AI的故事远比大众想象的漫长:1950年图灵提出"机器能思考吗",1958年罗森布拉特做出感知机,1986年反向传播算法普及,随后经历两次"AI寒冬"。真正的转折发生在2012年AlexNet凭借GPU拿下ImageNet,接着是2017年谷歌提出Transformer——"注意力机制"取代了循环网络,成为今天几乎所有大模型的共同骨架。此后,Kaplan等人提出的缩放定律(scaling law)与DeepMind的Chinchilla计算最优结论,把"堆算力、堆数据、调参"变成了一条可工程化的路线;再叠加RLHF(人类反馈强化学习)、混合专家模型(MoE),以及2025年前后以DeepSeek-R1为代表的强化学习后训练路线,模型从"会接话"走向"会推理",并在2026年进入以智能体(Agent)主动执行为标志的新阶段。
为什么偏偏是这条路胜出。 核心在于三个条件同时具备:互联网积累了海量无标注文本,让自监督学习绕开了昂贵的人工标注;GPU把矩阵乘法变成了廉价的大规模并行运算;Transformer架构恰好能把这两样东西高效地吃进去。于是,"预测下一个词"这个看似简单的目标,在足够大的规模下涌现出了泛化能力。这不是谁灵机一动,而是算力、数据与算法三者的历史巧合。
它到底难在哪。 今天的瓶颈早已不在"能不能训出来",而在于四个硬约束:算力与能源(训练与推理的电费和机柜是真金白银)、高质量数据的天花板(公开语料快被吃干,合成数据闭环还在验证期)、长程可靠性(多步任务每一步99%的准确率,连做一百步就会崩)、评测与安全对齐滞后于能力(基准测试被刷爆、泄露、污染已是行业常态)。
最容易出问题的地方,业内有个贴切的名字:锯齿前沿(jagged frontier)。 同一份斯坦福报告给出了极具戏剧性的对照:顶尖模型在博士级科学问题、竞赛数学上追平甚至超越人类,SWE-bench代码成绩一年内从约60%冲到近100%;但它读模拟时钟的正确率只有50.1%(人类约90%)。机器人在仿真环境里的操作成功率可达89.4%,放到真实家庭里洗碗叠衣,立刻掉到12%左右。实验室和厨房之间,差了七十多个百分点。这就是为什么"AI马上取代一切"和"AI全是骗子"两种说法都站不住脚——它的能力分布凹凸不平,而且凹凸的位置每个版本都在变。
对比过去,变化是结构性的。 过去我们做的是判别式、任务专用的模型,一个模型干一件事,成本主要在软件和标注;现在是生成式通用底座,一个模型干一万件事,成本重心搬到了算力、电力和机房。过去工程师写规则,现在工程师定义目标、设计评测、管住数据。过去AI是企业IT项目,现在它是基础设施——这解释了为什么美国国会要为数据中心该不该建吵到中期选举,也解释了为什么中国的优势落在制造业落地场景而不是单卡峰值。
未来的发展方向。 几个方向已经比较清晰:一是从"训练时烧钱"转向"推理时烧钱",用更多的推理步数换取更小的模型;二是智能体与具身智能从演示走向可交付,但这恰恰是真实世界成功率最低的那一块;三是开源权重生态继续扩张(中国模型在全球开源份额中的占比已具规模),与闭源高价服务形成价格锚的对峙;四是"主权AI"化,拥有国家支持超算集群的国家已增至四十多个,本地部署、本地合规、本地数据成为刚需;五是能效与电价反过来塑造技术路线,小模型、专用模型、端侧模型的性价比重新被重视。国内外趋势的分野大体是:美国押注资本、算力与闭源;中国押注开源、场景与制造业闭环——两条路都能走,也都各有软肋。
这些事跟从业者有什么关系。 关系很直接,而且多半不浪漫。第一,岗位结构在变:报告中提到美国22—25岁开发者就业自2024年起下滑约20%,资深岗位反而增加。AI先替代的是入门级执行,而非有经验者的判断——这意味着新人的入行门槛被抬高了,而不是消失了。第二,核心竞争力从"会不会调API"变成"会不会定义问题、组织数据、设计评测、把不确定性关进流程里"。第三,合规成了硬技能:2026年9月发布的《人工智能安全治理框架3.0》把智能体风险、具身智能风险单独列出,划出开源使用的禁止性红线,强调供应链与运行时的持续管理;再加上个人信息保护法、数据出境评估,"跑通一个demo"和"能上线运营"之间隔着一整套制度。第四,算账能力变得至关重要:token的单位经济、缓存命中率、长上下文的边际收益,这些才是决定项目生死的东西。
三、那我们该怎么做:几件值得做的,几件千万别做的
值得做的。
一是坚持效率路线。DeepSeek当年用远低于同行的训练成本做出可比性能,意义不在于省了多少钱,而在于证明了"算力不足可以用算法和组织补"这条路径走得通。这对我们是战略级的启示:被卡住的地方,往往也是逼出系统级创新的地方。
二是把开源生态当成公共品来养。Qwen、GLM等开放权重模型能在海外拿到海量下载和衍生模型,靠的不是宣传,而是持续可用的权重、文档和社区响应。开源是中国在国际AI格局里少数几张"别人主动来找你"的牌,值得长期投入,而不是当作短期营销。
三是往场景深处走,尤其是制造业。中国工业机器人装机量占全球一半以上,电力、港口、矿山、医疗影像、政务办事这些"脏活累活"场景,恰恰是模型能力够用、数据可控、付费意愿真实的交集。WAIC 2026在上海举行,29国签署成立总部设在上海的世界人工智能合作组织协定,方向也是把能力建设导向应用和普惠,而不是单纯比拼榜单分数。
千万别做的。
一是别把AI当外包大脑。2024年加拿大航空公司的聊天机器人向乘客提供了错误的退改签政策,公司被裁定须为此负责——法院的逻辑很清楚:企业对自家对外承诺的内容负责,哪怕那句话是模型说的。国内同样如此,生成内容出错、智能体擅自下单、自动外呼违规,责任主体永远是人。
二是别拿幻觉赌专业场景。早年美国有律师用ChatGPT生成判例提交法庭,被查出全是编造的,遭到严厉处罚。这类事故的共同点是:使用者既没有核验能力,也没有设置核验环节。
三是别把希望全押在一条外部供给上。无论是单一的外部API、某一家云,还是某一款进口芯片,断供、涨价、条款变更都是真实发生过的商业风险。冗余、可替换、可降级,这三件事在设计第一天就要考虑。
四是别跟着情绪内卷。重复造十个差不多的底座模型,不如把一个模型在一个行业里做到可验收、可审计、可追责。美国的教训在前:砸下两千多亿美元,模型差距却只剩2.7%,剩下的钱大多变成了电费账单和地价。
几条实操上的提醒。 上线前问自己五个问题:这个任务失败了代价有多大?有没有人在环上(或至少在环外被及时通知)?输入数据有没有权属和出境问题?输出能不能追溯到人、时间和版本?如果明天这个服务不可用,业务能不能降级运行?答不上来的,先别急着规模化。另外,守住《人工智能安全治理框架3.0》划出的红线,尤其是智能体的决策权限边界、开源组件使用和供应链来源管理——合规不是创新的敌人,它是你能不能活到下一轮融资的前提。
四、最后说一句
"绝不能让中国赢"这句话,最耐人寻味的地方并不在于它说了中国什么,而在于它暴露了说话者自己的处境:一个国家的电价涨不上去、电网建不动、内部谈不拢,最后却要把这些矛盾打包成"人类存亡",压在一场对外竞赛上。技术本身没有国籍,但叙事有。我们不必陪着演这出戏,也不必被它带节奏。
真正值得盯住的指标很朴素:你的模型能不能在自己的行业里稳定跑满一年?你的团队能不能招到并留住人?你的系统在被断供一半零件时还能不能降级运行?这些问题的答案,比任何一句口号都更能决定十年后的位置。
每日学一个英语单词:moratorium /ˌmɔːrəˈtɔːriəm/
词性与含义:名词,指(官方或法律意义上的)暂停、暂缓期、禁令期,常用于政策、金融、环保语境。它不同于一般的 pause,带有"正式宣布、有一定期限、附带条件"的意味。
常见搭配:
- impose / declare a moratorium on sth.(对……实施暂停)
- lift a moratorium(解除暂停)
- a moratorium on new data center construction(新建数据中心暂停令)
- a debt moratorium(债务缓付期)
记忆提示:来自拉丁语 mora(延迟)。同根词还有 demur(迟疑)。注意拼写中间是 -tor-,不要写成 moraterium。
例句:
1. Several U.S. lawmakers called for a moratorium on the construction of new AI data centers until federal rules are in place.
(几名美国议员呼吁暂停新建AI数据中心,直到联邦监管规则到位。)
2. The company agreed to a six-month moratorium on layoffs while it restructures its AI division.
(该公司同意在重组AI部门期间,实施为期六个月的裁员暂缓。)
3. Critics argue that a blanket moratorium would hand the advantage to competitors abroad.
(批评者认为,一刀切的暂停令会将优势拱手让给海外竞争对手。)
延伸一句:文中西方政客常用的另一个关键词是 zero-sum(零和的),a zero-sum game 即"零和博弈"。可以对比造句:Treating AI development as a zero-sum game only invites more moratoriums nobody can enforce.(把AI发展当成零和博弈,只会招来更多谁也执行不下去的暂停令。)