ARTICLE · 1113271
AI写代码越来越快,软件项目为什么反而更容易失败?
以前做一个新系统,最先被抱怨的是开发太慢。
需求评审一周,设计一周,开发排期两个月。老板看着计划表,觉得这么多人写几行代码,为什么要这么久。
现在不一样了。
一个页面半小时,一个接口两小时,一个小系统几天就能搭出来。
老板终于等到了他想要的速度。
然后新的问题来了:系统出来得越来越快,项目为什么没有更容易成功?
有些项目甚至比以前更容易失败。
这听起来反常,其实很好理解。
你开车从上海去北京,速度慢的时候,走错路半小时,最多多绕几十公里。
现在速度提高十倍,但方向没有看清楚。等你发现不对,人已经到了福建。
AI解决的是速度。
项目成功依赖的却不只是速度。
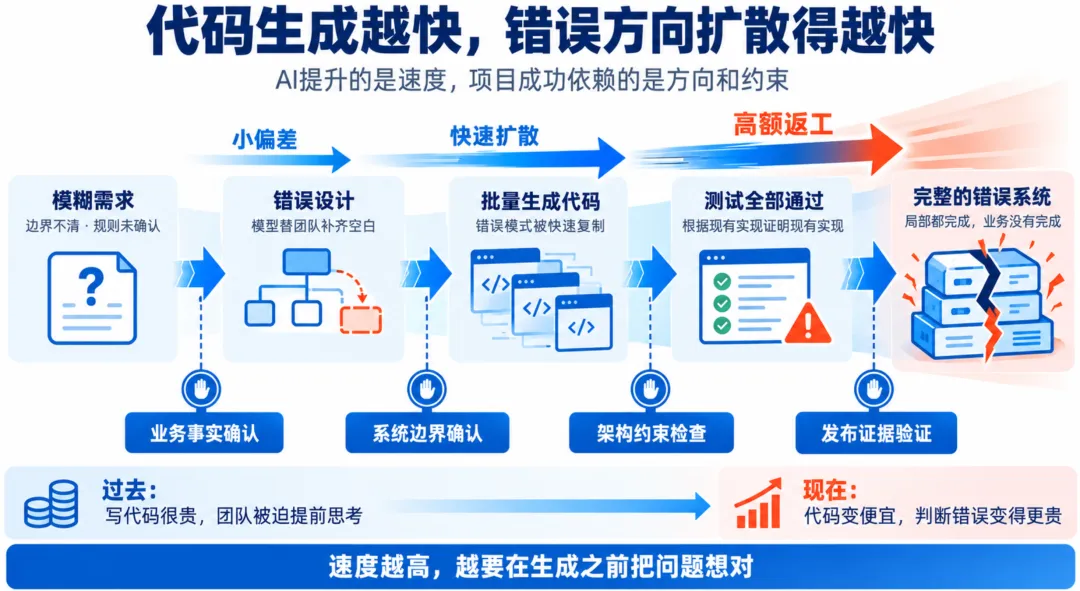
很多团队过去有一个隐形的保护机制,叫做“做起来太贵”。
因为写代码很慢,所以大家会在开发之前多问几句。这个需求到底给谁用?审批失败怎么办?数据归谁负责?旧系统怎么兼容?
不是所有人突然变严谨了,而是返工太贵,逼着大家提前想。
AI把代码变便宜以后,这个保护机制消失了。
现在最常见的一句话是:先做出来看看。
这句话对原型没问题,对正式系统很危险。
需求里写“支持灵活审批”,AI不会嫌这句话含糊。它会替你补出角色、流程、页面、接口和数据库表。
而且补得很完整。
问题是,完整不等于正确。
业务想要的灵活,可能是金额超过五万元时增加一级审批。AI理解的灵活,可能是让管理员自由配置任意流程。
前者是一个业务规则。
后者已经是一套流程平台。
如果人没有先把边界讲清楚,AI会用它见过的常见答案填满空白。演示时大家还会觉得很专业,等真实业务进来,才发现做的是另一件事。
这类错误过去暴露得慢,现在扩散得快。
第一段代码把业务规则写进了控制器,后面的 Agent 会照着写。
第一个页面把权限判断放在前端,后面的页面也会照着做。
一个不合理的模式,只要被放进上下文,就会迅速长成整个项目的默认结构。
人写错一段代码,可能只是一个缺陷。
AI沿着错误模式继续生成,最后得到的是一套结构完整的错误系统。
更麻烦的是,它能运行。
软件行业有一个很容易误导人的时刻:页面打开了,按钮能点,接口返回成功,会议室里所有人都松了一口气。
仿佛项目已经完成了八成。
其实往往只完成了最容易展示的那部分。
日志够不够?权限能不能审计?外部服务失败后怎么补偿?数据错了谁来修?高峰期扛不扛得住?发布失败怎么回滚?
这些东西不适合演示,也不会因为你在需求里写了一句“系统应稳定可靠”就自动长出来。
AI很擅长完成主路径。
企业软件真正昂贵的部分,经常藏在主路径以外。
测试也会制造一种错觉。
现在生成几百条测试用例很容易。管理者看到数字,觉得质量有保障。
可如果这些测试是根据现有代码生成的,它们很可能只是在证明:代码确实按照代码自己的逻辑运行。
需求错了,测试跟着错。
设计漏了库存释放,测试也许只会验证订单状态变成“已取消”。页面绿了,接口绿了,测试报告也是绿的,仓库里的库存却一直被占着。
每个局部都完成了,业务没有完成。
所以项目失败,通常不是因为某一段代码写得差。
真正贵的是,从需求开始就有一个小偏差,经过设计、开发、测试以后,被包装成一个看起来很完整的结果。
AI只是把这个包装过程加速了。
这也是为什么AI时代,架构师、产品负责人和测试负责人不会变得不重要。
他们的价值不再是亲自写更多内容,而是尽早识别哪些事情不能让模型替大家猜。
业务事实没有确认,就不要生成正式方案。
系统边界没有决定,就不要铺开大量代码。
接口和数据责任没有说清楚,就不要让多个 Agent 并行开发。
上线条件没有证据,就不要因为演示顺利宣布完成。
有人把这些叫质量闸门。
名字不重要。
重要的是团队得知道,什么时候可以追求速度,什么时候必须停下来做判断。
AI最适合接手的是那些已经说清楚、可以验证、失败后能够恢复的工作。
最不应该直接交给AI的,是那些信息不完整、影响范围很大、做错以后很难回头的决定。
可现实中,很多团队正好反过来。
越是模糊的需求,越希望AI快速给方案;越是赶时间,越省掉评审;越是代码生成得多,越不愿意回头检查最初的判断。
最后代码确实写快了,项目也确实更快地走到了错误答案。
所以,AI写代码越来越快,并不自动提高项目成功率。
它只是让方向的重要性变得更高。
过去,判断错了,团队还有几周时间发现。
现在,可能一个周末以后,一整套系统都站在错误判断上等你验收。
代码正在变便宜。
真正昂贵的,是在代码出现以前,把问题想对。