ARTICLE · 1118402
arXiv被AI灌水逼出"投稿硬限额",40,363篇/月创纪录
学术界最开放的那个预印本平台,开始限制你每个月能投几篇论文了。
10月1日,arXiv 宣布更新速率限制政策:从这一天起,每个提交者每月最多提交2篇,同时最多有3篇"活跃提交"在系统中。
这听起来有点反直觉—一个以"开放获取"为使命、几十年来几乎不设门槛的平台,为什么要给作者定投稿额度?
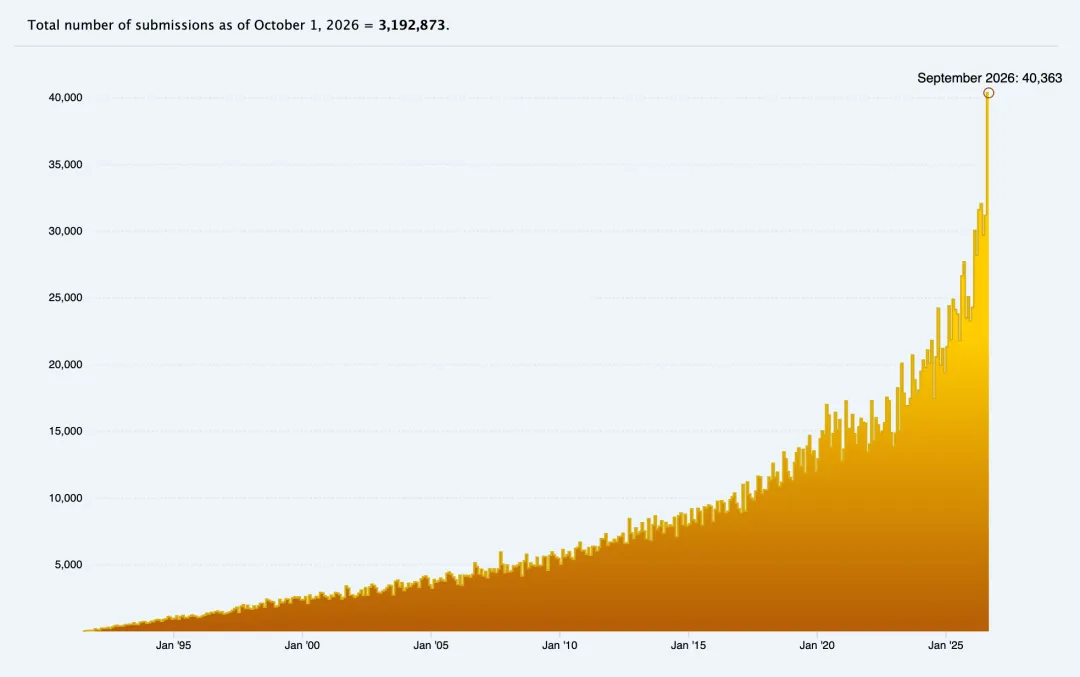
答案藏在两个数字里:今年9月,arXiv收到了 40,363 篇投稿,创了历史纪录;而在两年前的9月,这个数字是 20,569;再往前推十年,2016年9月,是 9,869。
十年涨了四倍,两年翻了一倍。而且,这波增长的主要推手,官方点名了:AI 工具。
一、数字背后的"投稿大爆炸"
先把这条增长曲线摆清楚。
arXiv 是1991年成立的预印本平台,作者可以把还没正式发表的论文先挂上去,供同行免费阅读。它的审核不靠编辑部,靠一群志愿者按学科分头把关。
过去,这个模式运转得还算顺。原因是:一个人认真写一篇论文,从做实验、分析到写作,天然就慢,一个月能憋出一两篇已经是高产。这个"人的精力上限",无形中给平台的总量踩了刹车。
但 AI 工具普及之后,这条刹车线松了。
官方给出的月度投稿数:2016年9月:9,869 篇2024年9月:20,569 篇2026年9月:40,363 篇(新纪录)
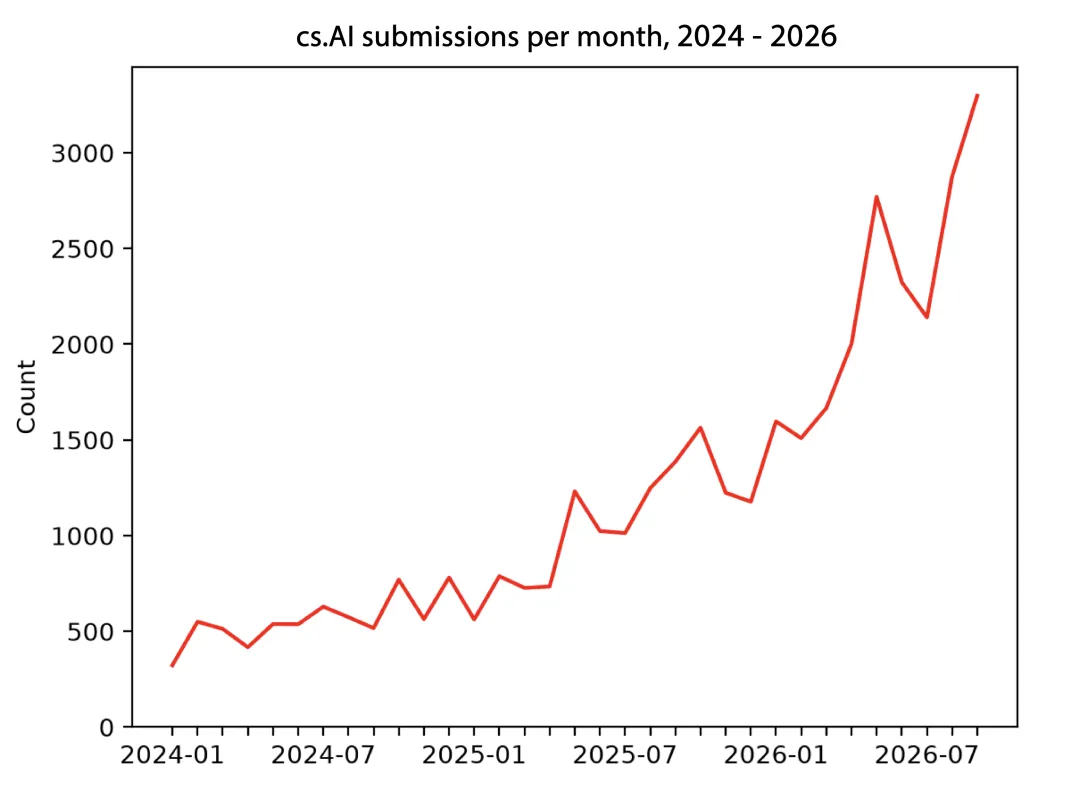
两年时间,总量翻倍。而最夸张的是具体学科—计算机科学下的"人工智能"类(cs.AI),两年里增长了超过6倍。
伴随暴增的还有负担:今年9月那40,363 篇投稿,给 arXiv 的工作人员带来了接近9,000 个支持工单。也就是说,差不多每4到5篇投稿,就衍生出一个需要人工处理的请求。
二、AI 打破了"自然限速"
官方在说明里讲了一个很实在的观察:在 AI 出现之前,独立作者能多快产出论文,是有一个"实际可辨认的上限"的;过去如果有人远超这个上限,志愿者会手动限制他。
但现在,"一个月到底能写多少篇"这个上限,变模糊了。
AI 工具让研究的某些环节变得更快、更容易—文献梳理、初稿撰写、格式排版,都能让 AI 搭把手。这本是好事,前提是论文仍满足学术标准。但官方承认,现在收到的很多投稿,并不满足。
于是出现了一个结构性问题:AI 降低了"写"的门槛,但没降低"做研究"的门槛。结果就是,写出来的东西变多了,其中值钱的比例却可能被稀释。
三、三种被点名的"水论文"
官方明确点出了三类正在增多的低质投稿:
第一类,薄论文。范围窄、内容单薄,本来可以并入更大的工作里,却单独投了出来。
第二类,salami 论文(切片论文)。把一项完整的研究切成好几块,分别包装成多篇小论文投出—行话叫"萨拉米切片",意思是像切香肠一样把成果一点点零卖。
第三类,密集的 AI 代写论文。大量依靠 AI 生成、读起来密密麻麻但缺乏实质推进的文稿,正被轻松地批量灌进 arXiv 和其他存储库。
官方口径说得很直白:AI 工具让作者向arXiv 等平台"洪水般"地倾倒低价值论文,变得前所未有地容易。
四、政策本身:每月2篇,活跃3篇
新政策的核心就两条,自2026年10月1日起全类别生效:
每个提交者,每个自然月最多提交 2 篇;任意时刻,最多有 3 篇"活跃提交"(即已投出但尚未正式公告的论文)在系统中。
这里有个背景:其实"同时最多3篇活跃提交"这个限制,从2024年就已经有了;这次新增的,是"每月2篇"这个月度硬上限。
而围绕这两条,官方还配了一份 FAQ,几条值得单独拎出来:
其一,被拒也算数。限额计的是"提交次数",不是"成功发布次数",是提交这个动作本身。一个月投了2篇,不管收不收,都得等下个月才能再投。言下之意是:希望你投稿前三思,只投真正有分量的。
其二,跨学科也累计。不管你投的是物理还是生物还是计算机,2篇的月度上限是跨所有类别合并计算的。
其三,on hold(暂挂)的论文,不占下月的"月度2篇"名额,但占"活跃3篇"的上限。
其四,合著者不受影响。限额只针对"提交者"本人。你作为提交者挂了一篇多作者的论文,只扣你自己的额度,不影响合作者。
其五,公告前删除可豁免。如果你投完发现漏了重要东西、在论文正式公告前删掉了,这篇不计入你的任何额度。
五、为什么要限:一场关于"公平"的账
把政策逻辑拆开,它其实是在算一笔公平的账。
arXiv 识别低质论文的核心,是一群志愿者—他们每天无偿捐出时间和专业判断。但官方观察到:相对少的一部分作者,提交了数量不成比例的低质论文,占用了不成比例的时间。
代价由谁承担?是那些持续投高质量论文的作者—他们的稿子可能因为被低质投稿淹没,而被拖延数天甚至数周。
所以这个2篇/月的限额,名义上是"公平分配的时间",实质上是用硬上限,替那套已经失灵的"靠自律 + 人工discretion"的老机制兜底。
顺带一提,arXiv 编辑咨询委员会的相关负责人也公开支持了这次调整的方向,认为在 AI 工具大量进入科研流程的当下,平台有必要重新定义"最佳实践"。
六、这件事值得往深想一层
孤立看,这是 arXiv 的一次运维调整。但放在更大的图景里,它其实是 AI 冲击知识生产生态的一个缩影。
第一,它暴露了一个矛盾:当"写"的成本趋近于零,"判断什么值得写"反而成了最稀缺的能力。AI 能帮你把论文写得更顺、更快,但它不会替你决定"这项研究是否真的新、真的有意义"。而后者,恰恰是学术筛选体系存在的理由。
第二,它揭示了开放平台的脆弱性。arXiv 的开放,建立在"大多数作者自觉"的默契上。当默契被部分人打破,平台要么收紧,要么被低质内容淹没。这次限流,是开放与质量之间一次被迫的再平衡。
第三,它提出了一个尚无答案的问题:AI 时代的"学术贡献"该怎么计数?如果一个团队用 AI 辅助,一个月能稳定产出更多合格论文,2篇/月的硬上限会不会反而误伤正当的高产研究?政策发布方也承认,这只是"权宜之计(stopgap)",目的是争取时间改进工具和流程,之后再定"最佳实践"。换句话说,今天这道闸,未必是明天的最终形态。
来源与免责声明 本系列所有信息均来自公开渠道(官方博客、开发者文档、新闻媒体、HuggingFace、GitHub、Hacker News 等)的公开发布内容,经人工筛选与摘要整理,仅作资讯传递与学习交流之用,不构成任何投资、技术或商业建议。摘要可能存在简化或理解偏差,引用具体数字或原话前请回第三方原文核对。原文版权归原作者或发布主体所有。若认为内容涉及侵权或不宜转载,请私信联系,确认后将在 24 小时内下架或调整对应条目。
资讯数据来源:arXiv官方链接内容。