ARTICLE · 1121266
AI 把活干完了,你却看不懂:四级格式阶梯与去 AI 味清单
AI 把活干完了,你却看不懂:四级格式阶梯与去 AI 味清单
2026-10-03 · 热点走公开资讯检索,非易撰榜单口径
10 月 2 日,Andrej Karpathy 在 X 上发了一段不算长的帖子,核心是一句判断:我们会花越来越多的时间,去理解语言模型的输出。他给出的解法不是换个更强的模型,而是换一种输出格式——从受限英语,到图,到可交互网页,再到按需生成的讲解视频,一级比一级好读。
差不多同一时间,营销分析机构 Graphite 发了一份研究:他们比对了 1 万篇 ChatGPT 问世之前的人类文章和模型改写稿,找出 13000 个在 AI 文本里出现频率至少两倍于人类的短语。结论有点扎心——破折号这类老痕迹被压下去了,新的痕迹立刻补位。
这两件事说的是同一件事:AI 干活的边际成本在往下走,人验收的边际成本在往上走。 产出越来越多,能读懂、能判断是否可用的那部分,成了新的瓶颈。
一、瓶颈从"做"移到了"看懂"
过去两年,我们讨论 AI 的姿势基本是"它能不能做出来"。现在这道题在很多场景里已经有答案了,剩下的问题变成了三连:它做得对不对、我能不能在合理时间内确认对不对、我怎么把结论交给下一个人。
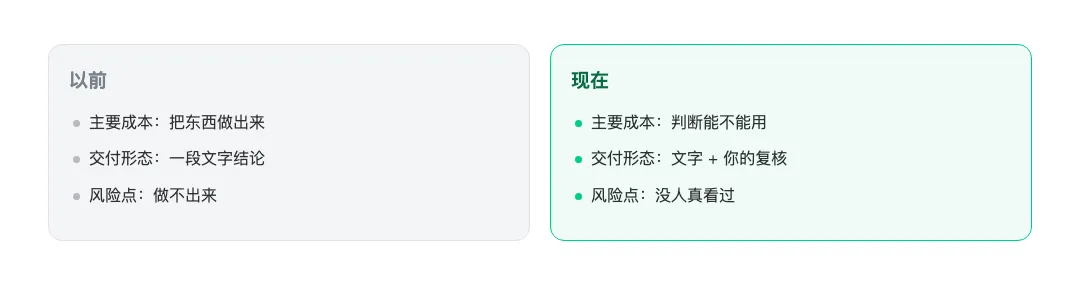
Karpathy 那句"我们会花更多时间理解模型输出",说的就是这张表的下半行。而 Graphite 的数据指向另一半:如果输出是一段读起来很顺、但充斥着模型惯用句式的文字,人的复核往往会退化成"扫一眼觉得没问题"。
所以真正要改的不是模型,是你要输出的方式。
二、四级阶梯:一级一级往上要
Karpathy 给了一个从低到高的阶梯,每上一级,单位信息量的理解成本就降一截。下面四步都能直接用。
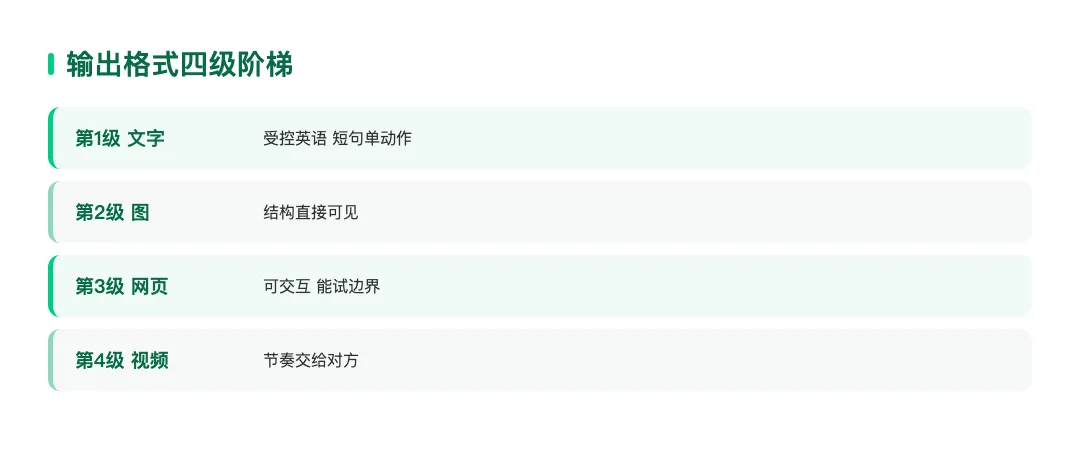
第 1 步:让文字先瘦下来
操作:在提问末尾加一句格式约束,要求用 ASD-STE100 来解释。ASD-STE100 是一套受控英语规范,最早用于航空维修文档:一句程序不超过 20 个词,一段不超过 6 句,约 900 个批准词,一个词只对应一个意思。
复制即用:
用 ASD-STE100 解释「什么是向量数据库的 HNSW 索引」。
要求:主动语态,一句一个动作,不省略冠词,
不出现「utilize / commence」这类长词。
如果规范限制太死,就做到「80% of the way to ASD-STE100」。
这一步的作用:把复合长句拆成单动作短句。模型爱写的那种"不仅是 A,更是 B"的套式,在这套约束下会被强制拆开,可读性的提升主要来自这里。
提示:规范本身相当严格,全量执行读起来会有点硬。Karpathy 自己的做法是只要"八成像",这个折中值得照抄。
第 2 步:别要文字,要图
操作:同一个问题,把"解释一下"换成"画一张图"。
复制即用:
画一张图说明 HNSW 的层状跳表结构。
要求:节点用方框,层与层之间用箭头标方向,
每层标注「进入条件」和「退化条件」,图例单独放右下角。
这一步的作用:文字是线性的,结构是靠读者在脑内重建的;图把结构直接摆出来。判断"这一步对不对",看图比看段落快得多——尤其是流程、分层、依赖这类内容。
第 3 步:要一个能点的 HTML 页
操作:明确要求输出 HTML,而不是 Markdown 或纯文本。
复制即用:
把上面的内容做成一个单文件 HTML,内联所有 CSS 和 JS。
要求:顶部三个 Tab(概览 / 分层结构 / 参数影响),
参数影响页放两个滑动条(efConstruction、M),
拖动时实时重绘右侧的召回率-耗时曲线示意图。
数据用示意值即可,但要在页脚注明是示意。
这一步的作用:交互把"被动读"变成"主动探"。滑动条的意义不在好看,在于你可以用它快速试边界——把 M 拉到最大看看曲线怎么走,这比读三段文字更快建立直觉。
在 WorkBuddy 里这一步有个额外好处:生成的 HTML 会落在本地,可以在产物面板直接打开预览,确认没问题后,用资料库的「以链接分享」生成一个在线链接发给同事,对方不用装任何东西就能打开。
第 4 步:按需生成一段讲解视频
操作:要求生成一个针对该主题的讲解视频,风格可以指定。
复制即用:
生成一个 3Blue1Brown 风格的讲解视频,主题是 HNSW 的层状结构。
时长 90 秒,配音用我提供的 ElevenLabs API key;
如果没有 key,就用本机可跑的免费 TTS 方案替代。
每 15 秒一个章节,章节标题打在画面左上角。
这一步的作用:视频把节奏也交给了对方——你不用自己控制阅读速度。代价是生成最慢,且依赖配音来源,所以 Karpathy 自己把它放在"值得试"而不是"日常用"的位置。
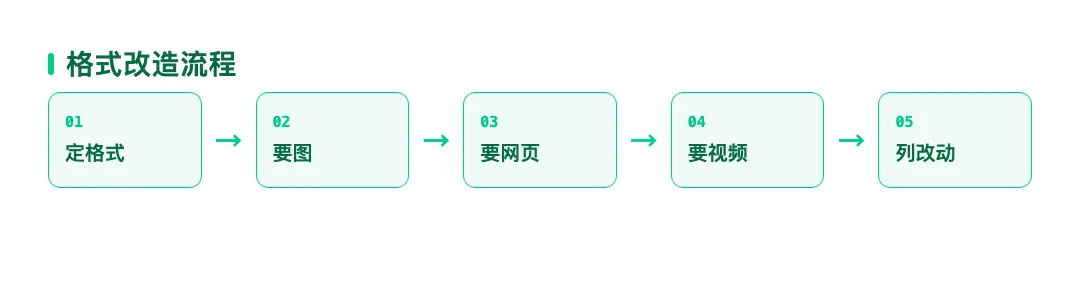
三、另一半问题:输出好看了,但一眼假
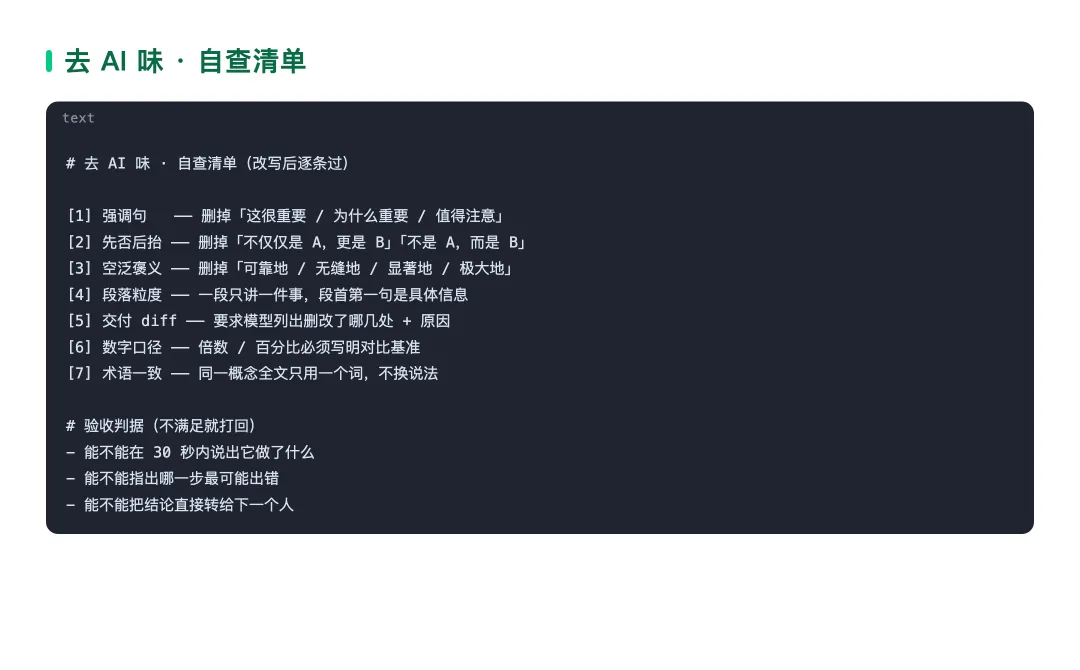
格式改造解决的是"读得快",还有一半是"读起来像不像人写的"。Graphite 的数据值得抄一份清单:
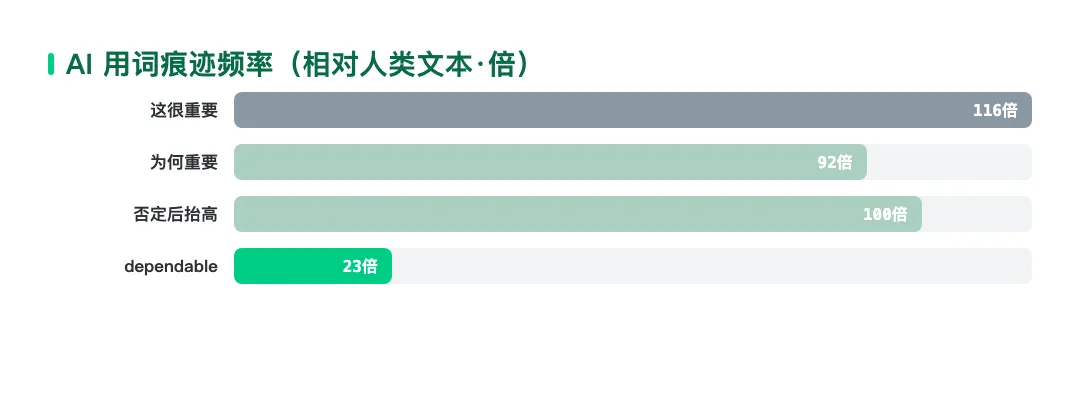
有意思的是破折号:Opus 5.5 的使用频率比上一代降了 99%,Astra 比人类样本低 88%,Gemini 3.1 Pro 几乎不用了。但痕迹总量没降——Graphite 首席 AI 官 Greg Druck 的说法是,最出名的那批被清掉了,新的立刻冒出来,而且每个模型版本都有自己的一套。
这给出一个很实际的用法:不要试图"让 AI 写得像人",而要把模型的习惯用法列成禁用清单,显式写进约束里。
复制即用:
下面这段文字请改写一版,要求:
1. 删除所有「这很重要 / 为什么重要 / 值得注意」式的强调句;
2. 删除「不仅仅是 A,更是 B」这类先否定后抬高的句式;
3. 删除「dependable / 可靠地 / 无缝地」这类空泛褒义副词;
4. 每一段只讲一件事,段首第一句必须是具体信息而不是总结句;
5. 改完列出你删掉了哪几处,说明原因。
第 5 条是关键。让模型交代它改了什么,检查成本就从"通读全文"降到"看几条 diff"。
四、三条能今天就用的结论
1. 先要格式,再要内容。 提问时把产出形态一起说清楚(短句 / 图 / HTML / 视频),比事后要求"再通俗一点"有效得多。WorkBuddy 官方的提示词实践指南给的顺序是「目标 → 资料 → 约束 → 产出 → 示例」,产出形态本来就该是提示词的一部分。
2. 输出要留可检查的痕迹。 让模型列出它删改了什么、依据是什么,把"相信结果"换成"核对几条"。这跟给 AI 开多大权限是两件事——前者决定你能不能验收,后者决定它可能闯多大祸。
3. 把偏好固化下来,别每次重说。 如果你有一套稳定的表达要求,与其每次粘贴,不如写进用户级记忆文件 ~/.workbuddy/MEMORY.md(跨项目生效);项目级的规范放工作区 .workbuddy/memory/。需要定期产出的,用定时任务把整套格式要求固化成一条流程,每周自动跑。
想要的话,在评论区留一句「资料」,后台会把 WorkBuddy 资料包发给你:保姆级图文手册、200 条可复制指令、500 个场景目录、30 个完整实战案例、20 份进阶专题、10 组输入输出对照、以及 FAQ 与排错手册,一共 8 类。 另外也欢迎留言说说「最想拿 AI 搞定哪件事」,我会挑有代表性的写进后面的文章。
汇智面试题 · 前端面试真题 · 按知识点分类刷题
前面这套"先定格式、再验收"的思路,其实和准备技术面试是同一件事:你知道答案没用,得能在有限时间里把结构讲清楚。如果你正在准备前端面试,可以试试小程序「汇智面试题」——题目按知识点分类,每道题配解析,适合通勤时刷几道、睡前复盘一轮,把"看过"变成"讲得出来"。
本文涉及版本:WorkBuddy 参考文档 01-architecture v1.2(2026-06-09)、10-interaction-modes v1.1(2026-08-13)、11-memory-system v1.0(2026-06-04)、09-prompting-best-practices v1.0(2026-06-04)、04-automation-patterns(5.5.4 起「自动化」更名「定时任务」);视频生成 5.3.3 起默认 720P,1080P 保留,4K 入口已于 5.2.6 关闭。
热点来源:Karpathy X 帖子(2026-10-02,多家媒体转载);Graphite《AI writing tells》研究(TechCrunch 2026-10-01 报道);ASD-STE100 规范说明(ASD 官方 FAQ 与二手解读)。
待核实:①Karpathy 帖子浏览量各来源口径不一(46.9 万 / 160 万),未采用具体数字;②Graphite 研究中 Astra 的 "does not establish" 一项,有来源称 275 倍且对比基准为 Claude 生成文本而非人类文本,本文未采用;③ASD-STE100 的句长与词表规模来自二手解读,具体条款以 ASD 官方发布为准;④本文所举 HNSW 仅为示例主题,不涉及任何性能结论。