ARTICLE · 1124789
AI时代,有件事不能悬置:责任
QUOTE
它能把“外圈损伤、中后期”说得很准,也能把一句闲话说得很动人。同一套参数,两种输出,一样流畅。这不是它的本事,这是它的性质。
—— 郑官维
01
ONTOLOGY
它是什么:关于世界的文本,还是世界的模型
先看一个实验结果,它比很多理论讨论都更有说服力。
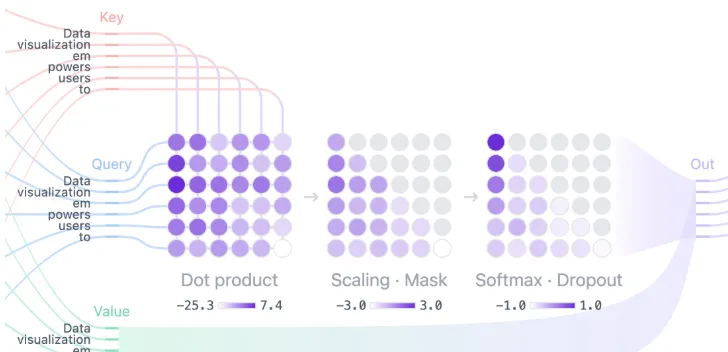
有研究者只让一个 Transformer 读奥赛罗棋的走子记录,不告诉它棋盘,不告诉它规则,只给合法的走法序列。训练完,研究者在这套网络内部读出了一张完整的棋盘:某个中间层的激活值,可以线性地还原出当前的棋子分布。没有人教它棋盘,但棋盘是预测下一步的必要条件,它自己长出来了。
这条思路被概括成一句被反复引用的话:把“预测下一个词”做到足够好,就等于理解了生成这些词的那个现实。学理上的背景是所罗门诺夫归纳与最小描述长度:最好的预测器,也是最紧的压缩器。
如果结论停在这里,那是一件令人兴奋的事。但它还有另一半。
语言学里有一条更早的假设。弗斯在 1957 年写过一句后来被引滥的话:“一个词的意义,由它身边的词决定。”维特根斯坦在《哲学研究》第四十三节说得更干脆:意义即用法。大语言模型是这条假设有史以来规模最大的一次实验,而且实验大体上是成功的。
成功的是“用法”。问题在于,用法不等于所指。
哈纳德在 1990 年提出“符号奠基问题”:一个符号系统,如果它的符号只由别的符号定义,它的脚就永远踩不到地面。模型心里的“轴承”,由语料里所有关于轴承的说法定义;它从没有碰过一只真的轴承。本德尔和科勒在 2020 年用过一个更直观的比喻:一只只读文本的章鱼,它把文本的统计结构学得完美无缺,但它从未接触过文本所谈论的那个世界。
中文古典里有一句话,比很多论文说得都准。《易传·系辞》讲“书不尽言,言不尽意”:写下来的不等于说出来的,说出来的不等于想说的。模型学的是“书”,我们要的是“意”,中间隔着一层。
所以对“它是什么”,我给出的回答是:它是“关于世界的文本”的模型,不是世界的模型。文本确实是世界的投影,但投影不是原物。这句话不贬低它,它只是划出了它的脚下踩的是什么。
02
EPISTEMOLOGY
它能知道什么:拟真是求真的很好替代品,但仍然是替代品
大语言模型会“幻觉”,这几乎是常识。但把它当作缺陷,是把工程问题和哲学问题混在一起了。
它的训练目标是:给定前文,什么词最可能被写下来。这是一个关于“像不像”的目标,不是一个关于“是不是”的目标。一个从未被要求求真的系统,说出不真的话,是它目标函数下的正确行为,不是故障。
中文里“真”和“像”是两个词,哲学里对应的是 truth 与 verisimilitude。模型优化的是后者。它的输出标准是“这番话看起来像是一个懂行的人会说的”,而不是“这番话对应的事实成立”。
普特南讲过一个思想实验:缸中之脑,一个从未接触过世界、只接触过关于世界的描述的头脑。大语言模型是缸中之脑的工程实现,唯一的区别是它从未对此抱怨过。
但这不等于它一无所知。它掌握的是结构性的知识:它知道“外圈通过频率的谐波列加边带调制”通常与“外圈损伤”共现。这是知其然。它不知道的是其所以然:滚珠滚过损伤点产生冲击,冲击激发轴承座的共振,共振被加速度传感器拾取,能量转到解调谱上。这条因果链它没有,它只有共现的强度。
有人会说,多测几次、多给数据,总能分辨出它是真有因果模型,还是高级的相关性记忆。原则上做不到。蒯因讲“翻译的不确定性”时举过一个例子:面对一只跑过的兔子,土著的“gavagai”到底指兔子、兔子的某个部分,还是“兔子的集合”,你从行为上永远分不清。同一批行为数据可以被多种理论解释。这是逻辑上的不确定性,不是实验上的。
对现场的推论只有一句:可以拿它做症状匹配,不能拿它做因果裁决。
03
PHILOSOPHY OF LANGUAGE
它算不算懂:规则遵循问题,两千多年了还没有公认答案
维特根斯坦在《哲学研究》第二百零一节提过一个悖论:任何有限的行为序列,都可以被无穷多条规则解释,“规则”并不能唯一地决定下一步。克里普克把它形式化成一个更锋利的例子:我一直在做加法,凭什么说下一步该按加法算,而不是按某个只在前若干步与加法重合的“卡加法”算?
人类给出的答案是共同体与约定:“我们都是这么算的”。模型给出的答案是统计外推:“语料里绝大多数是这样的”。
这两个回答,是不是同一件事的两种说法?这是当代语言哲学最没有定论的地方之一,我不打算在这里假装解决了它。
另一条更早的争论来自塞尔。1980 年他提出“中文屋”:屋子里的人按规则搬运符号,输出完美的中文答复,但他一个字也不懂。结论是句法不等于语义。系统回复说:懂的是整个系统,不是屋子里那个人。这场争论至今没有公认胜方,2023 年乔姆斯基仍然站在“不懂”这一边,把这类系统称为对语言的近似。
我的判断说得克制一点:它掌握的是用法,不是所指。用法足以支撑大量实用任务:分类、检索、初判、写报告初稿。但用法不足以支撑“担保”。
写到这里,我想到《庄子·天道》里轮扁斫轮那一段。老匠人说,做轮子的分寸“得之于手而应于心,口不能言”,他说不出来,但他会。模型的情形恰好相反:说得出,但不在手上。这几乎是符号奠基问题的中国古代版本。
04
THE ONE THING NOT SUSPENDABLE
有一件事不能悬置:责任
对“它有没有心智”,我的建议是采取丹尼特的意向性立场:把它当作一个有心智的对象去预测,因为这样预测最有效。至于它内部有没有“体验”,这个问题既无法验证,也不改变你怎么用它。悬置它,是务实,不是回避。
但有一件事不能悬置,那就是责任。
责任必须落在一个能承担后果的主体上。这不是伦理修辞,它由三个前提合成:主体要有意向,知道自己正在做什么;行为要可归因,是它自己做的;后果要可承受,能被追责。大语言模型三条都不具备,尤其第一条:一个没有求真承诺的系统,无法“知道自己正在做什么”。
所以“模型出错谁来负责”在哲学上是个伪问题。它没有答案,因为前提不成立。能负责的只有人。
这也顺带解释了一件工程上的事:为什么在关键设备上,模型的结论后面永远需要一个签字的人。这不是流程保守,是这个系统的本体论属性决定的。
05
BACK TO THE FLOOR
回到车间:三条可执行的推论
把上面这些落成现场能用的东西,就三条。
第一条,把“像”和“是”分开用
让模型做模式匹配、初判、从几百张谱图里挑可疑样本,它在这方面强得惊人。不要让它做因果裁决和最终定论。它的目标函数里没有“真”,把它放到需要“真”的位置上,是使用者的排布错误,不是模型的能力问题。
第二条,把可信度重新标定
模型输出的“92%”,是它在语料分布下的自信度,不等于在你这台设备上的正确率。每一次落地都要用现场数据重新校准。这不是不信任,这是理解它的性质之后的正常动作。
第三条,责任留在一个具体的人身上
签字的理由前面已经说了,是哲学的,不是行政的。
观为做 MechAI 的路线,恰好是这三条的工程回答:工业机理 + 机器学习算法。机理提供因果骨架,也就是知其所以然;算法提供模式能力,也就是知其然。两条腿走路,是因为我们清楚,只靠统计还走不到“担责”那一步。
∞
THE END
写在最后
三年前有人问,模型这么强,我们这些做诊断的人以后做什么。
现在我的回答和那时不太一样:它的边界不在能力上,在性质上。它可以把“像”做到极致,但“是”和“责”这两件事,它没有入口。
哲学看上去离车间很远。但在真实的工作里,它决定一件很具体的事:你把系统放在流程的哪一格。放错一格,工具越好,风险越大。
互动话题:你们单位在引入 AI 工具时,有没有专门讨论过“最后谁来签字”这件事?留言区聊聊。
联系我们
设备体检与诊断服务预约:18115388870(微信同号,周老师)
ISO 18436-2 国际振动分析师培训咨询:同一号码,或留言说明您的行业与设备类型。
郑官维
本文部分图片来源于网络或由AI创作,如涉及知识产权问题,可联系我们删除。我们长期做工业装备的预知性维护与故障诊断,也一直在思考AI到底把这一行带向哪里。这个栏目,专门讨论这类必须想清楚的问题。
如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见。