ARTICLE · 1124791
AI Engineering from Scratch:狂揽 523 节的开源神仙教程,我抽了三段硬核代码跑给你看
现在的 AI 学习者普遍面临一种诡异的“认知断层”:
收藏夹里塞满了反向传播的数学公式,可一到写 Agent 时,依然只会调现成的 API 库;能依样画葫芦拼出一个 RAG 的 Demo,但向量检索、排序打分、Prompt 与大模型之间到底怎么协作交圈,脑子里全是一团浆糊。
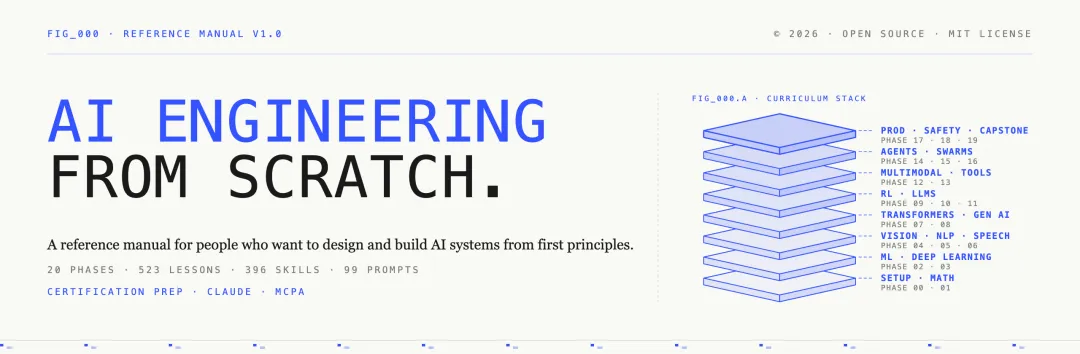
GitHub 上的这个开源项目 AI Engineering from Scratch,试图用最简单粗暴的方式把这条断裂的链路重新缝合起来:它一口气把数学底座、机器学习、深度学习、Transformer 架构、Agent 循环一直到生产级工程编排,整整齐齐地塞进了 523 节教程里。不仅配有白话讲解,每一节还几乎都给了可执行的代码、测验和小产物。
GitHub 仓库: github.com/rohitg00/ai-engineering-from-scratch项目官网: aiengineeringfromscratch.com配套延伸 Agent 教程: https://yunpan.plus/f/93开源协议:MIT License | 发起人:Rohit Ghumare 及全球开源贡献者
面对 523 节的庞大体量,大多数人的第一反应往往是“先点个 Star 扔进收藏夹吃灰”。为了看看它究竟是真有硬通货还是又一个拼凑概念的目录党,我把仓库的特定提交(3be078b)拉到了本地,挑出了自动求导、自注意力机制和 Agent 任务循环这三段最具代表性的核心代码实测跑了一遍。
一、先打破焦虑:523 节课,千万别从头硬啃
在当前的稳定提交中,仓库整整包含了 20 个学习阶段、523 篇课文(docs/en.md)。虽然项目规划了 Python、TypeScript、Rust 和 Julia 多语言实现,但并非每门课都面面俱到。
翻看它在官网规划的 Learning Paths 会发现,官方整理的 LLM Product Engineering 学习路线非常务实:主线直接聚焦在任务契约、评估指标(Eval)、调用成本和上线防护上。
这意味着你完全没必要为了做一个业务级应用,先把自己困在几个月的纯数学推导里。针对你当下的技术卡点去挑对应的模块即可。
通常每一个独立课时的目录结构极其规整,建议大家不要只在网页看概述,直接钻进这四个核心文件夹:
phases/<阶段序号>/<课题名称>/ docs/en.md # 核心理论、设计意图与配套练习 code/ # 最有价值的部分:极简的机制实现源码 quiz.json # 核心概念的自测检查题 outputs/ # 可直接拿去复用的 Prompt、Schema 等工程产物这套教程的核心思想是 “Build It / Use It”(先手写极简机制,再看成熟库如何抽象)。这种视角能帮你彻底撕下底层技术的“黑盒感”。
二、三段代码实测:它是怎么把黑盒扒开的?
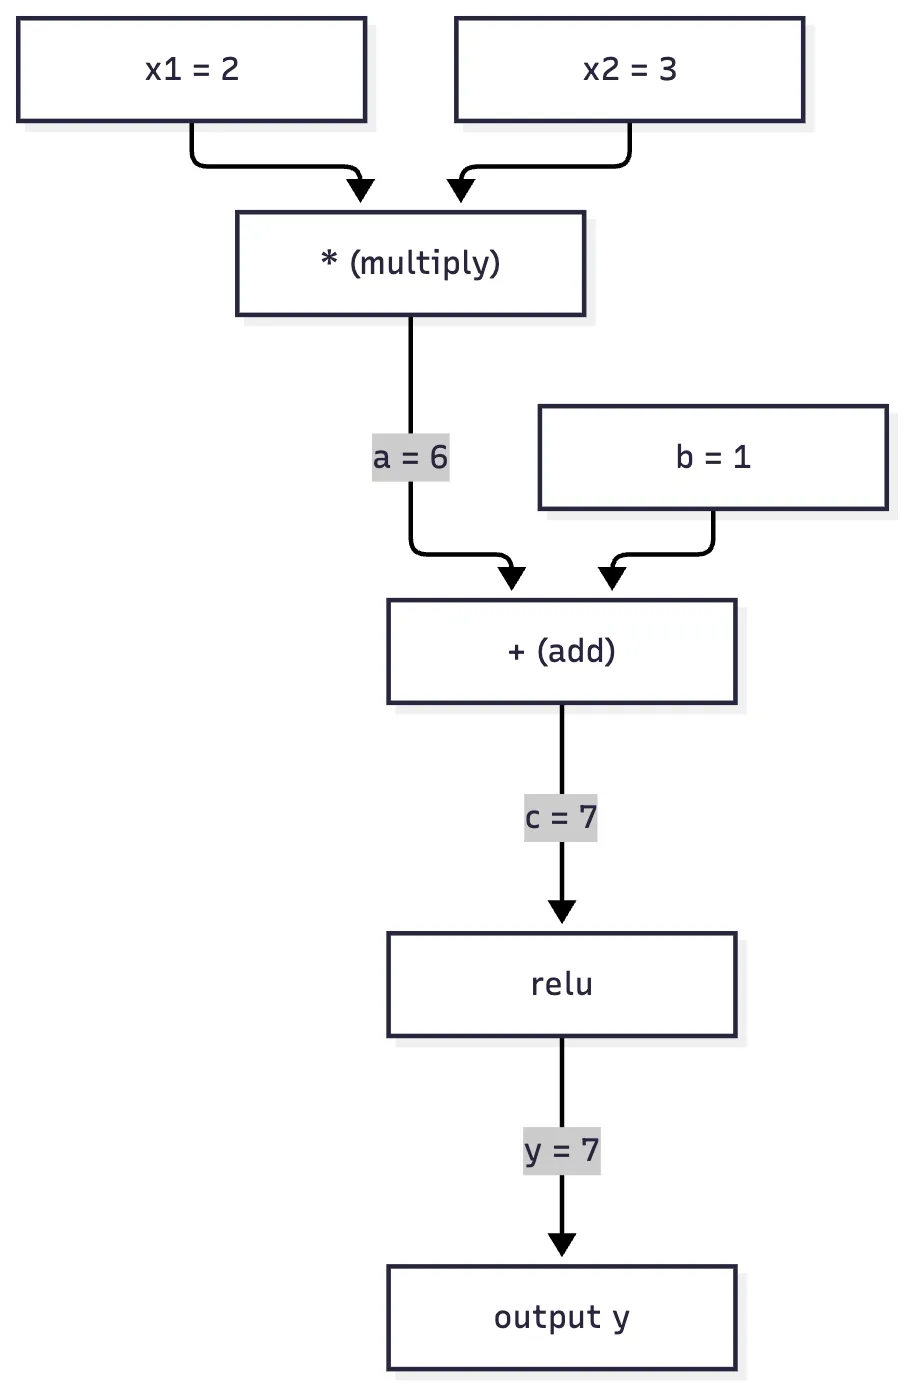
1. 自己造轮子:一个不到 100 行的自动求导引擎
源码位置: phases/01-math-foundations/05-chain-rule-and-autodiff/code/autodiff.py
这段代码实现了一个极简的 Value 类,封装了数值、累积梯度、计算图父节点以及每一步的反向求导闭包。
在经典的乘法反向传播实现里,有两行非常精妙的代码:
# 原仓库 __mul__ 中的核心实现:保留梯度累加语义self.grad += other.data * out.gradother.grad += self.data * out.grad注意这里的 += 操作符——这是整个自动求导的灵魂所在:当一个变量沿着计算图的多条路径共同影响最终输出时,各路径回传的梯度必须在此处汇总累加,而不是被后一条路径直接覆盖覆盖。
在本地运行测试时:
5 组表达式的自动微分与数值梯度比对全部断言通过; 一个用于拟合异或(XOR)的小型两层 MLP,训练损失从最初的 4.149 一路平稳收敛到 0.178,输出符号与真实目标完全吻合。
(注:该脚本末尾附带了与 PyTorch 的比对,若本地未装 PyTorch 会被脚本逻辑正常跳过。虽然这只是个教学微型玩具,但用来理解 loss.backward() 到底在内存里干了什么,比死看两小时公式生动得多。)
2. 把自注意力机制(Self-Attention)拆到只剩矩阵形状
源码位置: phases/07-transformers-deep-dive/02-self-attention-from-scratch/code/self_attention.py
去除掉框架层层包裹的包装类,核心计算其实被提炼成了极其干净的几行 NumPy 矩阵运算:
scores = Q @ K.T / np.sqrt(dk)weights = softmax(scores)output = weights @ V虽然代码短,但工程细节处理得很地道:比如在做 Softmax 时,代码严格执行了“先减去每行最大值再算指数”的数值稳定性保护操作,防止指数爆炸溢出。
本地脚本针对 6 个 Token 模拟了双头自注意力运算,稳稳吐出了 (6, 16) 的特征矩阵。
给你的实操建议:动手复现时,先别急着看热力图,试着手动改一改输入的 Token 长度,或者故意把 d_model 设成不能被头数整除的奇数。亲手触发一次报错,搞清楚矩阵相乘时到底是哪一个维度咬合不上,你对 Transformer 维度的理解就算彻底通透了。
3. 一个真正能单机离线跑通的 Agent 最小闭环
源码位置: phases/14-agent-engineering/01-the-agent-loop/code/main.py
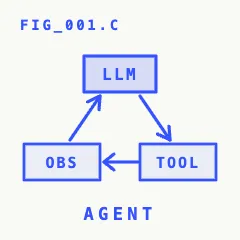
代码注册了简单的计算器(calculator)和键值存取(kv_get / kv_set)三个基础工具,完整实现了一套“接收指令 → 决策动作 → 调用工具 → 观察结果 → 检查终止”的受控循环。
在本地跑下来,程序精准完成了 5 次工具级联动作,正确给出了计算结果。我顺手做了两项边界压力测试:
将调用回合预算强行压低至 1 轮,程序立刻触发 budget exhausted并体面熔断;故意传入一个未声明的虚假工具,系统准确定位出 unknown tool并优雅报错。
⚠️ 但在实操时,必须看清两个工程真相:
教学里的 ToyLLM是个预设的脚本逻辑,并不是真实的大模型。它验证的是状态机的编排逻辑和任务熔断体系,并不能代替你在真实模型上遇到的输出不稳定、格式漂移等玄学问题;教学代码中的计算器工具直接用了 Python 的 eval并加字符白名单。在做教学演示时足够直观,但如果你在生产线上敢这么写,分分钟会引发远程代码执行(RCE)的惨烈漏洞。真实业务上线时,外围必须套上隔离沙箱。
三、3 分钟本地复现指南
你不必为了这几个演示,把仓库 requirements.txt 里庞杂的重型依赖全部装完。只需准备一个干净的 Python 独立虚拟环境,装一个 NumPy 即可跑通本篇测试:
# 1. 克隆代码并检出本文实测的稳定提交点git clone https://github.com/rohitg00/ai-engineering-from-scratch.gitcd ai-engineering-from-scratchgit checkout 3be078b37ffd8f0c04953c0678e48f5c6d0c7775# 2. 建立轻量级隔离环境python3 -m venv .venvsource .venv/bin/activate # Windows 用户请使用 .venv\Scripts\activatepip install numpy# 3. 逐个执行三段核心代码python phases/01-math-foundations/05-chain-rule-and-autodiff/code/autodiff.pypython phases/07-transformers-deep-dive/02-self-attention-from-scratch/code/self_attention.pypython phases/14-agent-engineering/01-the-agent-loop/code/main.py四、带着批判的眼光看开源:Issue 才是真实课堂
翻看仓库的 Issue 讨论区,能让你在满屏的赞美声中保持冷静:
Issue #434 指出了部分 Julia 实现中关于分类阈值和空预测集处理上的边界漏洞; Issue #528 则有开发者严肃提出,大而全的目录目前缺少能真正拿去当作求职亮点的 Capstone 综合大项目。
这恰恰说明:再庞大完整的开源教程,也不等于直接可以拿来就用的工业级标准。
在学习过程中,如果读全英文课文感到吃力,或者更习惯对着中文视听讲解建立全局架构感,也可以参考云栈社区整理的这套 AI 工程落地视频课:https://yunpan.plus/t/27929。
它的公开目录完整覆盖了从深度学习反向传播、Attention 机制到底层 RAG 与 Agent 架构设计的全过程,很适合用来在动手敲代码之前先扫清概念盲区。
结语
这个仓库最大的功劳,不是它整理了 523 篇文档,而是它敢于把一切被神话的概念,还原成几行最朴实的 Python 矩阵和循环。
别被 523 这个数字吓跑,也别让它沦为收藏夹里吃灰的谈资。
真正的掌握往往始于一个极其微小的动作:今天下午花 15 分钟克隆下代码,在终端里亲手跑一下自注意力的维度变化。能写出一个被你彻底掌控的小程序,远比收藏一千张看似宏伟的“知识图谱”有用得多。