ARTICLE · 1125224
“AI文本检测”的认识论悖论: Pangram与AI水印的技术逻辑
这篇文章,我五月动笔,当时是高校毕业季,亲历和听闻了“AI文本检测”的各种乱象。后搁置,至7月末爆发《Daggermouth》新闻。重新开写,至八月中旬,又逢Anthropic新Claude模型添加水印技术消息,就有了现在这篇——针对“后验特征检测”和“前置标记检测”两类“AI文本检测”技术,提出并论证“所有AI文本检测技术都必然遭遇认识论悖论”。
从文本检测的计量文体学起源,到以Pangram为代表的“后验特征检测”技术,到包括Green–Red List和Tournament Sampling在内的“前置标记检测”水印技术,在充分梳理AI检测技术的演化历程、合理分析其整体技术逻辑的基础上,尽可能严谨论证了为什么这项技术必然遭遇认识论悖论这一观点。
一方面,当下AI垃圾泛滥成灾是不争事实,另一方面,当人们试图通过检测尽可能降低垃圾生成速度时,却不能不正视AI检测技术本身的合法性危机。这将使得我所提出的认识论悖论显得更为深重。既然“魔盒”已经打开,无论是百般挑战还是希望犹存,都是人类命运。
全文过长,约23000字,期待你的耐心阅读、点赞、评论与转发,让我们共同见证这个神奇的技术时代。
(由于微信公众平台不支持LaTex,文中数学符号和公式排版均显示Unicode 数学字符格式)
2026年7月27日,一部连续数月霸榜《今日美国》畅销书单、在亚马逊Kindle “科幻爱情”类别中排名第一、且在TikTok上爆火的反乌托邦、暗黑、重口味爱情小说《Daggermouth》,在实体书上市的前一天,因美国《大西洋月刊》的一篇文章,被一款AI检测工具推上了风口浪尖。
这款工具名为Pangram,2026 年以来主流平台和研究机构对其集体背书,被公认为是当下最先进、最具技术权威性的AI检测器(之一,或许可以没有)。Pangram检测显示,《Daggermouth》约60%的文本被标记为“AI生成”或“中度AI辅助”。
其后,作者坚决否认,读者和出版商也纷纷力挺作者,直指《大西洋月刊》在搞毫无实质证据的“推测性诽谤”。也难怪,这篇文章的题目是“Is This What Comes After AI Slop?(“AI垃圾”就带来这玩意?)”,副标题是“Daggermouth could be the first best-selling novel partly written by a chatbot(《Daggermouth》可能成为首部部分由聊天机器人撰写的畅销小说)”。
我看这题目的第一反应是美国精英确实丝毫不掩饰对AI尤其是AIGC的深度抵触。与中文类似,英语新闻中,带有反问句“Is This...?”的标题往往不是真提问,更多是质疑和定性。至于“AI Slop”,则是近年贬义程度很高的网络用语,专门指代那些毫无营养东拼西凑的 AI内容。
不得不说,如此现象,就逻辑层面,2022年下半年ChatGPT横空出世的那个当下已预示其必然出现,事实确如,这几年尤其是今年,无论国外国内,AI检测尤其是文本检测相关事件层出不穷。
在已经过去的2026年中国高校毕业季中,多所大学引入“AIGC检测系统”,引发各种荒诞乱象。同一篇论文,不同平台检测结果常大相径庭。为了降AI率,学生要么自己改,要么交给AI查重机构改。自己改有时会越改越高。交给查重机构改则更显荒谬,本来要降AI使用率,结果得通过使用AI来降AI使用。如此,机构确实躺赢。
本文无意一一罗列荒诞事实,更不想渲染情绪,只想通过深入分析技术以显明我的个人观点:“AI文本检测”构成了一个无法解决的“认识论悖论”,后者正是AI技术本身的镜像。
一、Stylometry(计量文体学)及其与AI文本检测的技术关联
要说清AI检测工具的技术机制,得从Stylometry(计量文体学)说起。现代Stylometry利用统计学与计算机科学,对文本语言风格进行定量分析。粗糙地说,这是一门更多“关注你怎么写,而不是你写什么”的量化科学,它的底层逻辑是:任何人的写作都拥有一个极有可能连自己也察觉不到、且无法戒除的“语言指纹”或“作者DNA”。无论是词汇选择、标点符号密度、还是句子的长短交替,这些微观习惯在统计尺度下会形成一个独特且稳定的数学概率模型。
有意思且需要强调的是,作为文本中相对稳定、可量化的分布“风格”,很多最有效的特征往往是作者最无意识的微小习惯,例如介词、连词、代词和冠词的使用比例。正因为作者对这些高频“微”词的使用通常不是刻意的,它们才可能比“战争”、“和平”、 “爱”、“恨”等“重”词更能稳定反映个体语言习惯。
介绍一个相关经典案例——“关于《联邦党人文集》的作者之争”,以利于我们更清晰理解Stylometry。这也是计算机技术与统计学、历史学跨学科结合的里程碑式案例。当时媒体对这项研究的报道主要聚焦于“如何利用前沿计算机算力来解决历史和统计学难题”。之后,这项研究可以说是直接催生了现代“计算文体学(Computational Stylometry)” 以及“数字人文(Digital Humanities)” 等学科门类。
1787年,汉密尔顿、麦迪逊和杰伊,三人用统一的笔名“Publius”发表了85篇政论文章。由于手稿遗失,在汉密尔顿与麦迪逊的分配清单中,第49—58篇、第62—63篇以及第18—20篇共12篇文章的真正归属存在重叠和冲突。20世纪60年代,统计学家介入,对两人的写作习惯进行了大规模Stylometry分析。这个计量分析思路简单但挺有意思,比如有一项发现:汉密尔顿在写文章时,极其偏爱使用“while”,而麦迪逊则有一个戒不掉的语言习惯,他几乎只用“whilst”。最终结论是,那12篇争议文章系詹姆斯·麦迪逊独立或主笔创作。7
此案例的意义,不只解决了一桩文字公案,顺带还确立了现代作者归属的一个基本范式:已知作者语料→寻找区分性特征→建立概率模型→用已知文本校准→推断未知文本。
《联邦党人文集》案例中的研究者依赖的是精心挑选少量词语(只挑选了30个左右的虚词,如 upon, while, there)。之后,文体计量逐渐转向更大规模的特征集合。上世纪九十年代开始,互联网技术带来大量电子文本,作者归属问题成为机器学习问题。典型流程变成了:文本预处理→特征提取→训练分类器→在未见文本上测试。
到21世纪初,研究者基本抛弃了只寻找少数最具辨识力的词的方式,而是把文本塞进由数千、数万甚至数十万个特征组成的空间中。可以将一篇文本表示成一个数值向量:ϕ(x)=(f_1(x),f_2(x),…,f_d(x))。其中,x表示原始文本,ϕ是“特征提取函数”,d是总特征数,f_i(x)表示从文本中计算出的第i项特征。例如,ϕ(x)=( 逗号比例,平均句长,“但是”频率,“因此”频率,某个三字字符组合频率,……) 。于是,一篇文章不再只是一串等待解释的句子,而成了高维空间中的一个点。两篇文章的文体是否接近,就转化为了两个向量之间的距离或相似度问题。
文体计量为AI文本检测留下了两项重要思想遗产,第一是“特征”:可以把写作转化为词频、句长、复杂度等可计算变量;第二是“分类”:收集已知作者样本,训练分类器,再判断未知文本属于哪一类。后来以困惑度、句式变化、词汇分布和神经网络表示为基础的AI检测,都可视作这一思路在LLM时代的延伸。
文体计量学和现代AI检测,本质上都要把文本转换为可计算的数值表示。经典文体计量学通常依赖人工定义的少量显式特征,如虚词频率、句长或标点比例,形成低维、可解释的特征向量;现代神经网络检测器则把文本切分为Token,在多层网络中自动学习高维、稠密的上下文表征,进而完成分类。通俗说,前者由人决定“测什么”,后者则让模型自己从大量数据中学习一套难以逐个维度解释的“数字DNA”。
如此,两者的核心分类逻辑都是“统计判别”。 60年代解决《联邦党人文集》用的是贝叶斯概率模型,计算的是“给定这些词频,文章属于麦迪逊的概率是多少”。 当下AI检测器依然采用条件概率与统计分类,检测器实际计算的是“这段文本流的词序平滑度和预测性,在多大概率上更符合LLM的输出分布,而非人类的语料库分布”。它们给出的都不是硬证据,而是纯粹的概率判别。两者共享一种“统计归属”逻辑:从文本中提取可观察特征,再据此推断不可直接观察的作者或生成来源。它们提供的都是基于文本统计特征的来源推断,而不是对真实生成历史的直接证明。
二、AI检测工具演化的技术进程
如果把“AI文本检测”定义为“判断一段看似正常、连贯的自然语言文本究竟由人类还是由神经网络语言模型生成”,那么2019年可以视为现代AI文本检测的一个明确起点。在此之前,自动文本生成已有基于模板的规则式、概率式乃至神经网络等方法,但其实际应用仍局限于天气预报、商品描述等任务,其输出往往具有较强的“机器味”,因而,相关文本来源识别技术相对简单。2019年前后,以GPT-2为代表的神经网络生成模型开始生成有“人味”的文本。
AI能够大规模生成足以与人类文本混淆的内容,使现代AI文本检测真正成为一个独立问题——检测对象不再是明显的模板化机器文本,而是神经语言模型在自然、连贯的文本中是否留下了可统计识别的生成痕迹。2019年出现的GLTR与Grover,已清晰预示此后两条AI重要检测路线,GLTR从语言模型的token概率分布及统计特征中寻找生成痕迹,Grover则通过监督学习训练人类文本与机器文本的判别器。
GLTR并不简单判断某个词是否“像AI用词”,而是考察实际出现的token在语言模型预测分布中的概率排名。AI生成文本通常更集中于模型高概率、高排名的token,而人类写作往往包含更多模型难以预期的选择。GLTR把检测转化为对token概率排名分布的观察,其核心直觉可以概括为:AI生成往往表现出更强的高概率选择偏好。此后的困惑度、平均对数概率、token rank和log-rank检测,都可以视为这条思路的延伸——检测器试图反向观察生成模型对文本的“熟悉程度”。
同年出现的Grover代表另一条路线:不依赖少数人工统计指标,而是训练神经分类器,让模型从大量人类文本与机器生成文本中自动学习判别性差异。Grover原本是新闻生成模型,但研究者发现,将Grover本身训练为判别器后,它检测Grover生成新闻的效果反而优于其他强分类器。在相关里程碑论文《Defending Against Neural Fake News》中,Grover判别准确率约为92%,其他强分类器则约为73%。这一结果提示了一个重要现象:生成模型由于与文本生成过程具有相近的归纳偏置,往往更容易识别同类模型留下的生成痕迹。之于本文提出的“悖论”观,可以说Grover第一次清晰暴露了AI生成与AI检测的同源性——机器用概率制造文本,又用概率反向识别自己留下的痕迹。
Grover很大程度上证明了一个此后不断被重复验证的现象:最好的检测器,可能恰恰来自对生成过程理解最深的模型,越能刻画某类生成分布的模型,往往越有可能识别由这一分布产生的文本。它预示了将BERT、RoBERTa以及其他Transformer分类器用于AI检测的一条基本范式:q_θ(y=AI|x)。其中,x代表输入的文本序列,即待检测文本;y代表目标分类标签。在最简单的二分设置中,y∈Human,AI。q_θ代表参数为θ的判别模型,q_θ(y=AI|x)则表示模型根据文本x给出的“AI生成”类别概率估计。
这一基本范式可以更完整写成:ŷ=arg max_(y∈{Human, AI})q_θ(y|x),意思是,在 Human和 AI两个候选标签中,找出让 q_θ(y|x)最大的那个y,并把它作为最终预测结果ŷ。也就是说,分类器分析文本x中可用于区分来源的统计模式,并比较它属于不同类别的模型分数,最终选择得分最高的类别。例如:q_θ(Human|x)=0.3,q_θ(AI|x)=0.7,最大值是0.7,但arg max返回的不是 0.7,而是产生这个最大值的标签AI。实际系统可以设置阈值τ,q_θ(AI|x)>τ则将文本判定为AI生成。这里的τ可以被设定为0.5,也可以根据误报率、召回率等要求进行调整。
BERT、RoBERTa等本不是为AI检测而进行预训练的模型,一旦被用于检测任务,通常需要在人类文本与AI生成文本构成的标注数据集上进行微调,通过不断调整参数θ,使模型学习一条能够区分两类文本的统计判别边界。研究者不再预先规定究竟哪些特征代表“机器味”,而是让模型自己从大量样本中学习哪些高维模式最有利于区分Human与AI。
这一点也埋下了AI文本检测悖论的伏笔:检测器真正学到的,并不是某种永恒不变的“AI本质”,而是在特定训练数据、特定生成模型和特定时间条件下,人类文本与机器文本之间暂时存在的一条统计边界。
如此,两种检测范式开始成形。一是基于生成概率的统计检测;一是基于监督学习(采用“人类文本 vs AI文本”的对照数据)的神经分类检测。此后,统计检测进一步发展出扰动分析等方法,同时又出现了水印、检索溯源和写作过程验证等新的检测机制。尽管技术路线不断扩展,这两类方法至今仍构成AI文本检测的技术基础。
2022年末,随着ChatGPT的面世,AI文本生成突然从实验室技术变成普通人能直接使用的技术工具,文本检测变成社会需求,检测工具市场也随之爆发。
2023年1月,商业AI检测系统GPTZero公开发布,最初采用的统计检测方法中最具代表性的两个概念是“困惑度(perplexity)”和“突发性(burstiness)”。困惑度衡量一段文本在语言模型下的可预测程度,如果实际出现的词序大多属于模型容易预测的高概率选择,困惑度通常较低;突发性则衡量这种可预测性以及写作模式在整篇文本中的波动程度。AI生成文本更容易表现出相对稳定的统计特征,相比较而言,人类写作往往包含更多不规则变化。因此,较低的困惑度和突发性曾被GPTZero作为AI生成的重要统计信号。
不过,这种早期统计检测技术的局限也非常明显。“低困惑度”和“低突发性”除了能说明文本在某个语言模型看来相对稳定和可预测,显然不能直接证明此文本由AI生成。2023年的研究发现,当时的AI检测器大都容易将非英语母语者相对规整、词汇受限的英文写作误判为机器文本。与此同时,改写、词汇替换、结构调整等又能显著削弱包括GPTZero在内的检测器能力。也就是说,只要人类文本与AI文本在这些表面统计特征上发生重叠,原本清晰的判别边界就会迅速模糊。
之后,GPTZero逐渐从早期统计指标检测扩展为更复杂的监督学习系统。目前公开的技术说明显示,系统采用在人类文本和多种LLM生成文本上训练的端到端深度学习模型,进行句子级和文档级分类,同时加入混合文本识别、改写防御以及写作过程验证等机制。困惑度和突发性并未完全被抛弃,而是从核心判断依据退居为多种检测信号中的一部分。
从少数人工可解释指标,转向由模型从大规模对照数据中自动学习高维判别模式,其代价是,我们越来越难以明确模型究竟依据哪些具体文本特征作出了“AI”判断。
在GPTZero发布的同一个月,OpenAI也推出了一款通用AI文本分类器。与只针对单一生成模型的检测器不同,它使用来自OpenAI和其他机构的多种语言模型生成的文本进行训练,具有一定的跨模型检测能力。不过,OpenAI从一开始就对它的可靠性保持了谨慎,在官方挑战集上,它只将26%的AI文本正确标记为了“可能由AI生成”,同时有9%的人类文本被误判为AI。OpenAI因此明确强调,这类分类器不应作为判断文本来源的主要依据,只能作为其他证据的补充。
2023年7月20日,因准确率过低,OpenAI正式关闭该工具,并表示将转向更有效的文本来源溯源技术研究。这一关闭行为在AI检测史上具有标志性意义,连最接近生成模型内部机制的开发者,也未能仅凭最终文本建立一个足够稳定可靠的通用来源判别器。
三、Pangram4的技术机制
AI检测发展史来到了文章一开始提到的、当下几乎最厉害的AI检测工具Pangram。
Pangram的研发团队由来自谷歌、特斯拉和斯坦福大学的前资深AI机器学习科学家组成。以下对这项技术的解析主要基于2026年7月29日发布的38页的Pangram 4技术报告,而判定《Daggermouth》涉嫌60%AI生成的正是这款最新发布的Pangram 4。
Pangram 4试图解决的不再只是“这篇文章是不是AI写的”,而是一个更为细节的问题:文本不同部分更符合人类直接写作、AI辅助改写,AI直接生成这三者中的哪种统计特征。由此,它把传统的“人类—AI”二元分类进一步扩展为 Human、AI-Assisted、AI-Generated三类,并尝试定位这些类别在长文本中的分布。
Pangram 4采用一个已经训练好的、开放权重的 MoE作为基础模型进行参数微调,并在其上增加专门的文本来源分类模块。Pangram未透露此基础模型名称,只是说明研究者比较了多种开放权重的稠密模型和稀疏模型,最后选了其中之一。以下从五个层面具体分析Pangram 4的技术机制。
首先,Pangram 4重新定义了“AI 文本”,它并不把所有经过模型处理的文字都定义成 AI 文本,而是将检测对象限定为:模型针对开放式任务生成的、具有一定长度的自然语言文本。至于短回答、单一事实答案、代码、数学内容、目录、参考文献、技术手册以及不足 50 词的文本,原则上都不属于其适用范围。它甚至规定,如果模型只是压缩或复述人类提供的内容,没有贡献足够的“原创 token”,这类输出也不被视为AI 生成。
这意味着,Pangram 4检测的并不是一个客观存在、边界明确的属性,而是自己制定的一套操作化作者来源标准。其三类标签分别是:Human,即由人类撰写,或者 AI参与低到可以忽略,类似拼写纠正、轻微语法修改、字面翻译、浅层校对等;AI-Assisted,即思想、原始内容或部分表达来自人类,但 AI 对最终措辞、结构或表述进行了实质性重写;AI-Generated,主要内容和具体语言由 AI 原创生成,或者 AI 的贡献远高于人类。
其次,Pangram 4区分了两种完全不同的“混合写作”。它把混合文本分为两类。第一类是异质混合文本(heterogeneous mixed text),比如,作者先写两段,然后让ChatGPT接着写三段,每个句子或token原则上都有清晰来源,边界可以定位。第二类是同质混合文本(homogeneous mixed text)。比如,人类先写一段,然后让 AI 改写,人类再修改,再交AI 润色。最后的文本完全无法追溯每个词的单一作者。思想可能来自人类,措辞来自 AI,而语句可能是双方反复修改的结果。
如此,Pangram 4 实际上同时承担了两项任务:一是寻找人类与 AI 的段落边界;二是判断某一段整体上是否经过了实质意义上的人机共同编辑。这也是它声称能在一次推理中同时检测 heterogeneous mixed 和 homogeneous mixed 文本的意谓。它不是笼统地给出全文一个AI概率,而是尝试还原文本的“生成谱系”。
第三,Pangram 4延续并强化了Pangram既有的名为“合成镜像(Synthetic Mirroring)”的数据构造方法。普通监督学习分类器很容易学到错误捷径。举个简单例子,如果人类文本训练集主要是文学作品和学术论文,而 AI 文本主要是产品说明书和营销手册,那么分类器可能学到的是“什么主题通常由 AI 写”,而不是“AI 是怎样写的”。 Pangram 采用合成镜像方法正是为对抗这种主题偏差。
“合成镜像”基本流程是:一,取一篇确认由人类写成的文章;二,让模型概括文章主题;三,随后再要求模型围绕同一主题新写一篇文章;四,将原始人类文章与同主题 AI 文章组成“训练对”。比如,人类文讨论“孤独城市”,AI 镜像文也讨论“孤独城市”。 这样,在主题大致保持一致的条件下,分类器较难单纯依靠“文章在讲什么”完成分类,而必须更多依赖与文本生成来源相关的统计差异。
一句话概括“合成镜像”数据生成的目的:让分类器学习“How was this text written”,而不是“What is this text about”。 这可以算作Pangram 技术路线中最有价值的思想之一——尽量固定语义主题,把“作者来源”作为主要变量,构造“受控对照式数据”。需要指出的是,考虑到AI 镜像文本仍然是通过特定提示词和特定模型生成的,它完全有可能带有Pangram数据生成管线自身的规律,也就是说,模型学到的既包括一般AI写作特征,也完全有可能包括“Pangram如何让AI写作”的特征。指出这一点是因为这个特征也隐含着AI技术的终极“自指”悖论。
关于文本处理,有必要说明pangram4的一个重要技术细节——困难负样本挖掘(Hard Negative Mining)。所谓“困难负样本”,指的是那些虽然确实由人类写成,却容易被当前版本检测器误判为AI的文本。在pangram4的训练中,先用一批人类文本和AI文本训练初始分类器,用分类器扫描大规模人类文本库,找出被错误判成AI的人类文本,把这些误判样本加入训练集,为这些人类文本生成相匹配的AI对照文本,然后重新训练模型,重复这一循环。Pangram的技术报告称,困难负样本挖掘显著降低了误报率。这就意味着,Pangram4并不是只学习“典型人类”与“典型AI”之间的差别,它重点学习边界附近看起来最像AI的人类文本。
第四,关于AI-Assisted 标签的算法机制。纯人类文本和纯AI文本容易获得清晰标签,真正困难的是如何给AI改写后的文本标注每个部分的来源。Pangram4使用了一个名为 “Soft N-Grams”的自动化标签程序。以下简要梳理其算法逻辑。
第一步切分文本。设原始人类文本为S,经AI编辑后的文本为T,系统先把两个文本切成从句。切分成从句的原因是AI在编辑或改写过程中可能会插入、删减、或调换句子的顺序,如果直接按整篇文章或整段对比,很难精准捕捉到哪些字句被改动了。系统将 S和T切细,确保比对的颗粒度小到即便在一句话里,AI 只改写了后半句,也能被单独拎出来。
第二步跨文本搜索。对于AI编辑后的文本T中的每一个从句 y,算法会遍历人类文本S,寻找一个在字面和语义上最可能和它“对应”的片段 x。这样做的目的是建立对齐映射。哪怕 AI 把原书第三段的话挪到了第一段,这个机制也能把它抓回它最初的“人类模板” x。
第三步是“双指标相似度”计算。这一步是该算法被称为“Soft(软)” N-Grams 的关键,相应的是普通或传统的“硬”N-Grams,一种纯粹基于字面的“精确字符或词频”匹配,不具备理解人类语义的能力。
举个例子,假设人类文本中的一个片段x为“小明喜欢踢足球”, AI 改写后的文本y换了同义词,变成“小明热爱踢足球”, 如果我们使用普通的 2-Gram去匹配它们,系统会把文本切分成两两组合的词组: x的2-Grams 集合{("小明", "喜欢"), ("喜欢", "踢"), ("踢", "足球")}, y的 2-Grams 集合{("小明", "热爱"), ("热爱", "踢"), ("踢", "足球")}。由于 AI 仅仅把“喜欢”换成了同义词“热爱”,导致原本连续的词组全部断裂。在 3 个 N-Gram 中,只有 ("踢", "足球") 1 个能匹配成功,匹配率直接暴跌(从 100% 降到 33%)。如果 AI 改写得再彻底一点:y’= “小明对绿茵运动充满痴迷”。此时,普通的 N-Gram 匹配度直接变为 0%。但作为人类,你一眼就能看出它们说的是同一件事。
硬匹配中,“喜欢”和“热爱”的二进制编码完全不同,算法根本无法得知这两个词在人类认知中指向同一个概念。还有,硬匹配对语序调整极度敏感,如果把“我昨天买了一本书”改成“一本书昨天我买了”,字面上的词完全没变,但因为相邻词的顺序变了,无论是2-Gram还是3-Gram),匹配都会大面积失效。
硬匹配这种弊端显而易见地会被“洗稿软件”利用,后者的核心原理就是利用同义词库去随机替换句中的关键词。普通AI 检测器高度依赖字面N-Gram 重合度,简单替换就能轻松“骗过”传统的硬匹配检测。
正因如此,pangram4采用了双匹配机制,在保留词汇相似度L(x,y)硬匹配的基础上,引入了基于向量嵌入的语义相似度 E(x,y)软匹配。将片段 x和y传入向量模型,计算它们在高维空间中的余弦相似度。在向量空间中,"喜欢"和 "热爱"、"足球"和 "绿茵运动"会被压缩到彼此非常接近的坐标位置。即便 AI 把整句话的词汇全换了,语义向量的夹角余弦值依然会非常高。如此,补齐了硬匹配的短板,洗稿和同义词替换不再有效。
事实上,这种双指标交叉比对主要是为了精准识别出那些“洗稿、润色、换汤不换药”的 AI-Assisted文本。在 Pangram 4 的标签程序中,双匹配之后的标签判定通过一个二维象限逻辑来为文本片段打上最终标签。为L(x,y)和 E(x,y)各自设定一个阈值(这是一个根据语种等因素所作的动态设定,限于篇幅,具体细节不再展开),分为“高”和“低”,演化出四个核心标签:Human、AI-Assisted、AI-Generated和Anomalous。
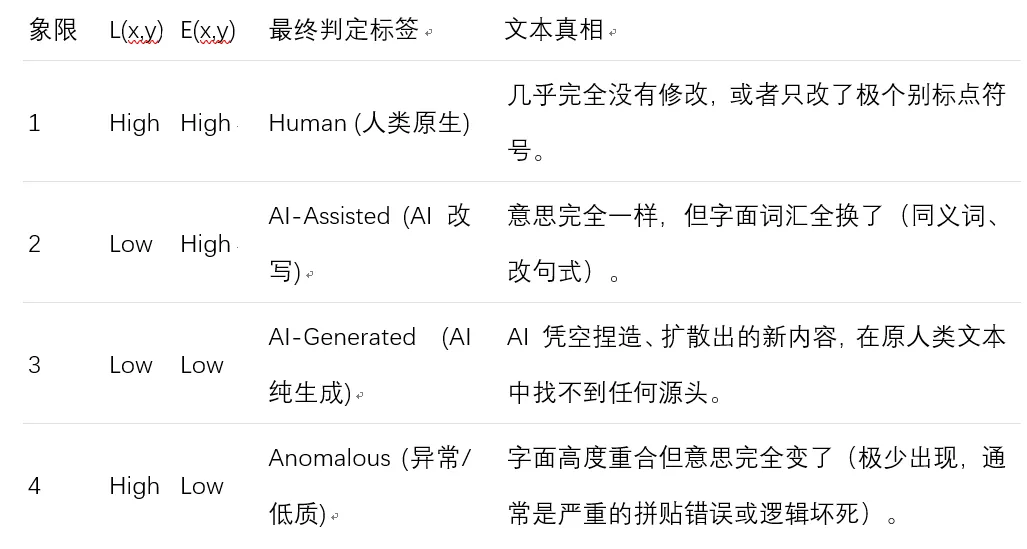
在“Soft N-Grams(词汇+语义双指标)”标签判定基础上,接下来进行的是加权公式f_AI=(0.5C_AA+C_AG)/(C_H+C_AA+C_AG)的计算。C_AA、C_H、C_AG分别代表AI-Assisted、Human、AI-Generated的字符数。这个公式的精妙之处在于它打破了“非黑即白”的二元论,f_AI计算的是“AI 渗透率(AI Infusion Rate)。它之所以巧妙,体现于以下三个工程层面的思考:
一,将 AI-Assisted 按 0.5 计入,这算核心创新。若一篇文章每个字都被 AI 润色过(全篇都是 AI-Assisted),但核心思想全是人类的,粗暴地将它算作 100% AI 文,对人类作者不公平,但若算作 100% 人类文,又掩盖了 AI 润色的事实,按 0.5 折算,承认人类贡献了一半(思想),AI 贡献了一半(文笔),这种“灰色地带”的量化基本符合实际的人机协同场景;
二,以字符数为统计基准:作为字符数,公式里的C_AA、C_H、C_AG是一个加权平均的动态分值。一篇文章里,哪怕只有一句话是 AI 纯生成的,或者只有几句是 AI 润色的,都会以字符长度为权重,精确反映在最终的f_AI数值中;
三,输出一个连续的百分比。最终的f_AI不是一个“是或否”的标签,而是一个连续的数值。例如一篇论文,经过计算得到f_AI= 27%,这就给后续的评测或过滤提供了极高的灵活性,比如团队可以设定f_AI > 30%的数据为“过度 AI 渗透”并进行拦截。如此,被判定f_AI超60%的《Daggermouth》,显然就是AI重度渗透了。
由“Soft N-Grams(词汇+语义双指标)”支持的底层数据,加上f_AI加权公式,这整个计算过程是Pangram 4 论文中的顶层数学应用,构成了目前可说是最优雅的AI-Assisted文本的量化方案。
第五,Pangram 4采用了MoE加四个分类头的模型架构。Pangram 4 使用一个未公开具体名称的、开放权重的稀疏MoE因果语言模型作为其骨干网络,总参数量约为Pangram前一版本Pangram 3.3 的六倍。这个MoE不负责生成文本,而是专门用于提取高维与深刻的上下文隐藏表征,在它上面,挂载了4 个定制的分类头并行工作。
Token溯源头(Tokenwise Provenance Head)负责将骨干网络输出的每个Token表征映射为三种类别(Human、AI-Assisted、AI-Generated)。如前所述,它回答的是:这个位置的文字,更像是人类直接写的、AI在人类内容基础上改写的,还是 AI 原创生成的?单个Token层面的含义较为模糊,通常需要一段连续Token进行实质解释。
片段级评估头(Segment-Level Head)是一个15类分类器,以滑动窗口方式整体估计AI参与程度。与Token溯源头逐个判断Token来源不同, 片段级评估头观察整个(最多512-token)窗口,预测该窗口的加权AI比例f_AI落在哪个区间,其回答的是:从整体上看,这一片段处于从纯人类写作到高度AI参与这一连续谱上的什么位置。对长文本进行推理时,Pangram会使用重叠滑动窗口获得这些片段级判断。
Token 溯源头可能在局部位置产生误判,而片段级头则可以告诉系统“整段文字总体上到底更像哪一种状态”。举个不算特别严谨但易于理解的例子,比如,Token 溯源头汇报:“报告!在这个片段里,我发现了 3 个字属于人类,5 个词属于 AI 改写,还有 2 个标点是纯 AI 生成的!”片段级头反驳:“不对,我从宏观语境、句法连贯性和上下文的语义密度来看,这一整段文字的整体特征有95%吻合人类表达习惯,你那几个判定为 AI 的点,只是人类写了句大白话,是局部噪声,抹除就是了。”
混合作者检测头(Mixed-Authorship Head),专门用于判断一个文本窗口内部是否存在具有实际意义的来源混合。混合作者检测头与Token溯源头负责判断具体位置属于Human、AI-Assisted还是AI-Generated、片段级头负责估计整体AI参与程度不同,它并不精确定位混合内容,也不计算AI占比,而是提供一个额外信号——这个窗口是否包含不可忽略的多种来源状态。可以把这个头理解为一个专门的“来源混合报警器”。
Humanizer Head。这里的Humanizer不太好翻译,在AI检测语境中有翻译为“AI去痕”的,指专门把 AI 文本改得更像人类文本、以绕过检测的工具或处理方式,这些方式包括同义词替换、句式改变、故意加入拼写错误、增加不规则表达等。Humanizer头则专门识别和对齐此类被洗稿工具故意加入的特殊片段,判断文本是否具有这种AI 生成后又被人为伪装过的特征。
补充说明下,humanizer头独立训练。Pangram 4使用了“停止梯度(stop-gradient)”方式,也就是允许这个头读取模型的隐藏表征,但不让这个任务的误差反向改变骨干模型参数。这样做是为避免模型为了识别 humanizer,过度学习“错别字、不规范表达等于‘伪装’”这一特征,进而误伤英语学习者或文风不规则的人类作者。总之,humanizer 头的主要功能很明确,就是专门检测被改写、伪装或扰动过的 AI 文本。
如此,一个头看“每个位置像谁写的”,一个头看“整段有多少AI”,一个头看“是否人机混合”,一个头看“是否经过伪装处理”。多个头不是重复判断,而是从不同尺度和不同风险类型观察同一篇文本。最后,系统把所有头的结果综合起来。比如,Token溯源头认为后半段像 AI,片段级头认为整段有较高AI比例,混合作者头又判断存在明显混合,系统就有理由把后半部分标记为AI-Generated,同时把整篇文章判断为Mixed。
关于Pangram 4的技术机制,还有很多重要技术细节,比如在选定的MoE骨干模型基础上进行的LoRA(低秩适应,Low-Rank Adaptation)微调机制等,都为Pangram 4的性能跃迁提供了显见的技术支持。限于篇幅不再一一展开。
基于2026年7月底Pangram 4对外发布的技术报告与公开测试,在针对52万个全AI 输出的基准测试中,Pangram 4 正确识别了 99.66% 的纯 AI 生成文档。其漏报率(FNR)直接降至 0.3396%,相比前代 Pangram 3.3 实现了近6倍的能力提升。在针对 100 万篇人类原生语料(English FineWeb)的测试中,Pangram 4 将误判率(FPR)死死锁在了 0.0041%。这意味着每24300 篇人类文章平台才可能不小心误杀 1 篇。得益于前述提及的给C_AA按 0.5 降权折算的精妙设计,Pangram 4把AI深度改写文章的“混合(Mixed)”状态召回(recall)率从前代的5.54% 暴涨到 55.01%。在不误杀轻度润色(误杀率仅 0.009%)的同时,以 92.02% 的Token级精准度告诉你“到底哪一句话是AI改的”。
在厘清Pangram 4这套由MoE骨干、多任务分类头、合成镜像、困难负样本挖掘与结构化后处理共同组成的技术体系后,可以认为,Pangram已经把后验式AI文本检测推进到了迄今最高的工程复杂度和细粒度。相比较而言,就目前公开的技术资料和有限产品观察言,国内主流AI检测工具,较Pangram 4,存在明显差距。
国内多数检测能输出“这段文本有多像AI”的风险分数,而Pangram4则进一步回答“这段文本属于人写、AI辅助还是AI生成”,并将这种来源判断细化到token和连续文本区段。这种差距在应对Humanizer(AI去痕) 时尤其明显。
Humanizer并不只是简单提高文本困惑度,而是通过词汇替换、句法扰动或生成式重写,使文本偏离检测器原先训练和校准时覆盖的AI文本分布,从而形成分布偏移,甚至跨越原有分类边界。Humanizer 可以削弱原始AI文本的表层特征,但未必能消除改写过程形成的新的“指纹”。Pangram4的优势在于它不仅学习“像不像 AI”,还能进一步学习这些规避性改写本身留下的规律性痕迹。据公开基准显示,在13种商业Humanizer处理后的文本中,Pangram4仍能在98.83%的样本中检测到AI参与。
四、AI“后验特征检测”的“认识论悖论”
行文至此,从文体计量学、AI检测技术发展历程到重点分析最新成果pangram4的技术机制,是为归于我在文章开始就亮明的核心观点——“AI检测工具”构成了一个无法解决的“认识论悖论”,此悖论本质上是AI技术本身的镜像。而这条路径整个进程中的所有工具,较之后面要重点分析的AI水印检测这类技术,我将其统称为“后验特征检测”,因为这类技术是在内容生成完成后,通过分析其可观察的文本以寻找与AI生成相关的统计模式,并据此推断其生成来源的检测方法,本质是基于结果特征反推生成历史的被动检测。而AI水印检测等相似技术,我称其为“前置标记检测”,指的是在内容生成之前,主动向生成内容中嵌入可验证标记,并在生成后通过检测该标记确认内容来源的检测方法。
之所以在具体论证观点之前简要交代了下国内现状,一方面是我们正在体验这类相对不成熟的检测技术之“荒谬”,“切身感”更利于理解观念,另一方面,我更想通过对比凸显:“厉害”如pangram4,面对的是同样的“认识论悖论”,这就让这项技术本质更显“荒谬”——“AI检测工具”是AI技术的镜像,无论怎样进化,永远无法解决“认识论悖论”。(细思,这是一个妥妥的“图灵停机”问题)
当然,我质疑整个检测生态的合法性,并非为否定其必要性,而是认为,只有在深刻认知其进化边界的前提下,才能有效且更“human”地探索其边界,无论是AI检测技术,还是AI技术本身。
一个清晰而冰冷的技术现实:AI检测工具并不是站在大模型之外的“法官”。生成式大模型从学习到的语言分布中正向采样文本,检测模型则根据最终文本逆向推断其来源,二者虽不共享同一个特征空间,但同属以高维统计表征学习语言规律的技术范式。问题就成了“以概率模型判别概率模型、以黑箱推断黑箱”的对抗循环。
先搁置逻辑死胡同问题,一个无法忽略的认识论边界实实在在摆着:当人类与AI能够产生相同或高度重叠的文本分布时,仅凭最终文本这一可观测结果,任何检测器都无法唯一恢复其真实生成历史。
我们可以换个更通俗的表达方式来解读这种试图“用魔法打败魔法”的循环悖论。
LLM的终极演进目标,是通过疯狂吐字和模拟概率,让自己显得“100%像一个真正的人”。而AI检测模型(哪怕是全球顶尖的 Pangram 4)在底层做的事情,是去寻找“高度符合常态人类文本分布特征”。这意味着,大模型进化到“欺骗奇点”时,正是检测器判定它100%是人类时。而另一面,如果一个真正的人类天才写出了一篇打破常规语序、充满前所未见的逻辑跳跃、甚至带有很多生造语法的独特作品(想想乔伊斯的《芬尼根守灵夜》,反正它至今仍像天书一样躺在我家最隐秘的书架层,我准备近期再次打开),检测器反而会因为该文本偏离了人类常态文本“概率流形”,无情判定其为AI文本或异质数据。
人类将“何为人类真实表达”的最高决策权,拱手让给了一个由“死”数据调教出来的机器判官。AI检测工具越是进化,越可能分不清“完美的造假”与“天才的原创”,越会将“平庸的追随”奉为人类的标准,而将“真的‘灵韵’(略不恰当挪用本雅明,毕竟,人类文本已经与‘灵韵’失联很久)”斥为机器制造的垃圾。
无论是国内的AIGC检测系统,还是Pangram 4,其基本方法都是以既有人类文本和AI生成文本作为标注样本,学习两类文本在高维表示空间中的统计差异。由此,“人类文本”实际上被操作化为人类历史语料中可学习的统计特征集合。问题正在于此,检测器能够识别的不是“人是否进行了自主创作”,而是当前文本在多大程度上符合模型从既有样本中学习到的“人类文本”表征。认识论上,这几乎等于将“符合历史数据分布的表达方式”与“活人的自由意志”强行划上了等号。
人类写作应是面向未来、不可预测的创造,而检测模型的任务是基于过去对现在进行概率检测。在这个逻辑闭环里,过去已经死去的文字,正在通过判别大模型的高维参数“圈养”未来活生生的思想。国内高校毕业季上演的魔幻现实,就是这个悖论的“具象”。真正独立书写的作者,很有可能为了通过“AIGC 率”审查,不得不主动在自己的纯正长文里插入别扭的错别字、赘词,或者故意把严谨通顺的学术表达改写得更口语化。
这是人类知识史和表达史上的奇观。人类为了向机器证明自己是活人,不得不主动在算法面前通过“自证低智”来迎合机器对人类平庸表达的刻板定义。机器没有被人类驯化,人类的思想和尊严,却率先在概率审判官的威权下“跪服”。当然,另一面,现代人类总体表达日趋平庸,不是刻板印象,是事实,不是人类迎合机器,是机器穿透人类真相。
这是AI检测工具的“悖论”,更是预训练大模型技术本身固有的“认识论悖论”。无论参数多么庞大,其“生成”就是在已知概率空间曲面内进行无限重组。当这种归纳性偏置成为“创生”基石,任何试图超越既定文本概率、包含深刻思想跳跃与逻辑异质性的真正原创,都有可能在底层逻辑上被扼杀。
如果上面几段论证文字属于带点情绪、并非足够严谨的哲学话语,下面我将引入我钟爱的贝叶斯公式从数学角度论证我的观点。
让我们来看下面这个公式:
P(AI|E)=(P(E|AI)P(AI))/(P(E))
我首先设定,这个公式作为理论起点,是pangram4的终点,因为这里的E代表证据evidence,即pangram4检测器观察到的AI证据。Pangram实际完成的是:x→E, 原始文本 x经过模型分析,得到检测结果 E。但更为重要的问题随之而来,它被浓缩在了这个贝叶斯公式中,它要回答E→P(AI|E),意思是:既然Pangram已经给出了这个检测结果E,那么这篇文章实际上由AI生成的概率究竟是多少?单独依靠检测器输出,Pangram4无法回答这个问题。
这是检测证据与最终指控之间一道不可逾越的鸿沟。我尝试采用贝叶斯公式进行理论推想,正是为了显明这一鸿沟。
假设Pangram4针对一段文本输出:q_θ(AI-Generated|x)=0.85,这个0.85是Pangram4根据自己训练出来的模型,对输入文本 x给出的分类分数。q_θ表示模型估计出来的分类分数,不是已经被证明的真实世界概率,所以q_θ(AI-Generated|x)=0.85, 不应该自动等同于作者实际使用AI率。
自然,pangram4算法不可能直接采用贝叶斯公式计算后验概率。贝叶斯生成式思路是:建模各来源如何产生证据→P(E∣C)→结合先验→P(C∣E),而Pangram4的判别式思路则是:大量带标签文本→直接学习“E→C”。E→C表示输入证据E,经过某个函数或模型后,被映射到类别C。作为一个判别式神经分类器,Pangram得到的“概率分数”不等于它执行了贝叶斯推断。比如,神经分类器最后经过softmax,输出类似(0.03,0.12,0.85)来分别对应 Human、AI-Assisted、AI-Generated,这个0.85是神经网络根据训练数据学习出来的分类分数,不是Pangram实际做了这样的运算(P(E|AI) P(AI))/(P(E))=0.85。
Pangram4没有直接使用贝叶斯算法和我用贝叶斯框架分析Pangram4的证据意义,两者非但不矛盾,甚至可以算作是一种认识论意义上的方法创新。贝叶斯定理是价值观、世界观,也是方法论。用这样的数学视角来拆解AI检测机制,我所要论证的“荒谬”一定程度上就有了科学依据。
让我们深入拆解这一公式P(AI|E)=(P(E|AI)P(AI))/(P(E))。
先看P(AI),它表示在还没有观察文本证据E之前,一篇文本由AI生成的基准率。在贝叶斯认识论中,P(AI)作为“先验概率”表示在看到证据E之前,我们对“文本由AI生成”这一命题的初始信念强度。就此意义层面,它必然具有主观性。例如,一位教师可能认为学生使用AI的概率是30%,另一位教师可能认为是70%,于是,即使面对完全相同的检测证据E,两人的后验判断可能极为不同。当然,如果存在可靠的现实统计数据,例如某类作业经过独立调查确认有20%使用AI,那么也可以把P(AI)=0.20理解为这类场景中的经验基准率。这时它就不只是个人主观判断,而是一个由总体数据估计出来的概率。所以,有必要区分P_belief(AI)和P_real(AI)。
而事实是,P_real(AI)通常不可知,机构决策者实际采用的先验概率,可能来自数据,也可能来自经验甚至主观怀疑,这正是我的悖论观可由贝叶斯公式支持的要点之一——由于现实中的P_real(AI)未知,而人在解释检测结果时又不可能完全没有先验,因此实际进入判断的P_belief(AI)或P_prior(AI)很容易受到社会环境和AI焦虑的影响。
生成式AI普及之后,一种机制层面的“先验膨胀”现象业已形成——既然人人都能使用LLM,那么看到一篇写得过于流畅、过于完整的文章,首先就会怀疑它使用了AI。而P_belief(AI)>P_real(AI),先验被抬高,同一份检测证据自然就会产生更高的后验怀疑。
基于我的“悖论观”,我将此现象命名为“先验污染悖论”:AI越普及,社会越容易预设AI无处不在,此预设又会提高检测结果被解释为AI证据的力度。如果真实基准率未知,而机构只是凭直觉设置一个隐含先验,那么所谓“AI概率”便带入了制度假设。检测器在不知道现实基准率的情况下学习出一个分类分数,一旦机构把这个分数进一步解释为“这篇文章事实上使用了AI的概率”,就从分类问题跨入了贝叶斯意义上的证据解释问题。此时,现实中的P(AI)先验问题无法不被重视。
接下来分析P(E∣AI)项,意思是假设这篇文本确实是AI生成的,那么我们观察到证据E的概率是多少。如果再次把E定义为pangram4所给出的高于某个阈值的 AI-Generated 检测结果,那么,P(E|AI)指的是在真正的AI文本中,有多大比例会被 Pangram 4 检测出这种高AI信号。例如,1000 篇已知确由AI生成的文本里,有970篇被Pangram4判为“高 AI 风险”,那么可以估计P(E|AI)≈0.97。所以它本质上是在问检测器的敏感度,P(E∣AI)=真AI被检测出来的概率。
表面看,P(E∣AI)这项似乎与“悖论”无关,但细究会发现,很大程度上,这项是悖论的真正“表征”。P(E∣AI)本身不是悖论,悖论来自我们必须把它视作一个稳定的量,如此AI检测才有意义,问题是AI技术发展恰恰在不断破坏这种稳定性。
要得到 P(E∣AI),首先必须定义“AI文本总体”。问题是它不是一种固定生成机制,它实际上包含GPT、Claude、Gemini、DeepSeek,……不同版本、不同提示词、不同采样参数,以及各种人工修改。更真实的写法应该类似:P(E|AI,t,M,p,h,…),其中t是时间,M是模型,p是提示方式,h是后期人工修改……。因此,今天测得P(E∣AI)=0.99甚至不意味着明天仍然是0.99。检测器需要一个相对稳定的“AI分布”,而检测对象本身恰恰在高速变化。这是第一重结构性矛盾。
第二重矛盾是,检测器的成功会反过来改变 P(E∣AI)。假设检测器发现某种特征E很能识别AI,即P(E∣AI)很高。但是一旦这种检测规律被知道,生成模型、humanizer或用户就会主动减少E。于是可能出现:Pt(E∣AI)=0.95,到了下一阶段:Pt+1(E∣AI)=0.65,再下一阶段:Pt+2(E∣AI)=0.40。如此,我们清晰地看到了一种无奈的反身性——证据特征越成功,消除这种特征的动力越强。
AI检测与普通医学检测不一样。病毒标志物不会因为医生发明了检测试剂,就主动修改自己以逃避检测。AI生成系统却可以通过训练、提示、改写和对抗优化主动改变输出分布。
于逻辑于事实,P(E∣AI)都很重要,但进一步思考会发现,此项重要性是通过其与P(E∣Human)的比值体现的。你想,即便P(E∣AI)=0.95,看起来检测能力极强,但如果P(E∣Human)=0.90,这意味着什么?意味着这个证据几乎没用,因为人类文本中也大量出现了同样的E。真正重要的是这个似然比:Λ(E)=(P(E|AI))/(P(E|Human))。如果:P(E∣AI)=0.95,P(E∣Human)=0.05,那么Λ(E)=19,这是很强的AI证据。但如果技术发展导致P(E∣AI)和P(E∣Human)越来越接近,Λ(E)趋向于1,这意味着检测出E与没检测出E,对于判断几乎没有区别。
悖论再次浮现:检测技术想做的事情是不断提高P(E∣AI),但生成技术想做的事情却越来越接近于PAI(x)≈PH(x)。检测器努力寻找稳定差异,生成器努力消除稳定差异,生成模型越成功,检测器赖以存在的“稳定AI特征”就越可能消失。
接下来要分析的是这个公式中作为分母的最后一项P(E)。在贝叶斯公式里,这一项是由其他概率共同决定的“证据总体发生率”。它表示,不管文本来自AI还是人类,在整个待检测文本总体中出现“高AI证据”的概率。所以,假设在最简单的 Human和 AI 二分情况下,准确表示是:P(E)=P(E|AI)P(AI)+P(E|H)P(H)。从这个表达式中,我们就可以看到P(E)把“人类文本也可能产生同样证据”放进了计算。
把贝叶斯公式完全展开为P(AI|E)=(P(E|AI)P(AI))/(P(E|AI)P(AI)+P(E|H)P(H))。如果AI式语言越来越进入日常写作,人类文本本身越来越具有所谓“AI式”统计特征,以至于P(E∣H)不断升高,那么总体中的P(E)也会随之升高。一种检测信号一旦从“AI特有现象”逐渐变成整个语言环境中的常见现象,它就会发生“证据通胀”。P(E)只是告诉你“这种语言现象本身有多常见”,而不再能够有效告诉你它究竟来自谁。证据真正的区分能力仍然由前面所论那个比值(P(E|AI))/(P(E|H))决定。
简明总结对整个贝叶斯公式的分析:AI越普及,P(AI)越可能上升;AI越进步,P(E∣AI)所依赖的稳定特征越来越难维持;AI语言模式越深入整个人类写作生态,P(E∣H)越可能上升, E本身越来越普遍,P(E)越有可能“证据通胀”。
于是,我们不得不面对这样一种局面:社会越来越有理由怀疑AI生成,但单凭最终文本,却越来越难获得、甚至再也无法获得具有排他性的AI证据。
五、AI“前置标记检测”技术及其“认识论悖论”
上述论述均基于pangram这类从最终文本反推生成来源的后验检测技术,那么前置标记验证技术、尤其是近几个月连续发布的AI水印嵌入生成检测技术,是否摆脱了我所提出的认识论悖论呢?以下我将论证AI“前置标记检测”技术并没有消除认识论悖论。
事实上,AI水印并非新技术,而是传统数字水印技术在生成式AI时代的一次重构式升级。
早期数字水印主要服务于版权保护和内容认证。Cox等人在1996—1997年提出扩频水印(spread-spectrum watermarking)概念,这项技术把信号分散嵌入图像、音频等数据中,信号需微弱到人眼难以察觉、但统计上可以检测,如此奠定了后来“不可感知+可检测+抗修改”的基本范式。
由于LLM的爆发,2023年生成式AI水印成为独立研究方向。水印不再只是“生成完成后往作品里隐藏信号”,而开始直接介入生成过程。2023年1月,Kirchenbauer等提出著名的LLM Green–Red List水印,用密钥将token动态划分为红绿两个集合,提高绿token的生成概率,之后再采用统计检验检测。同年3月,Stable Signature技术将二进制水印训练进扩散模型的潜在解码器,5月,Tree-Ring Watermarks被提出,这项技术把水印直接嵌入扩散模型的初始噪声,在其傅里叶空间注入特定的环状或圆形图案(这是它被称为“Tree-Ring”的原因)。
2023年8月,Google DeepMind 推出 SynthID技术,最初用于Imagen生成图像,把不可见水印直接嵌入AI图像,扩展到Lyria音频。2024年SynthID扩展到Gemini文本和Veo视频。SynthID-Text发展的Tournament Sampling(锦标赛采样)方法标志着文本水印从简单的logit偏置向更精细的采样控制发展。2025年Google 推出 SynthID Detector,使用户能够集中验证图像、音频、视频和文本中的SynthID信号。AI水印开始从模型内部的安全机制,变成面向公众和媒体机构的内容验证基础设施。
前文中我们提及,由于识别度和误判率都不尽如人意,OpenAI曾经在2023年7月撤下过自己开发的一款AI检测分类器,这一工具属于典型的后验式检测。紧接着,OpenAI公开表示正在研究更有效的 provenance techniques(来源溯源技术)。2024年初,OpenAI开始给DALL·E 3 生成和编辑的图像添加C2PA内容凭证,后者是一项跨平台、开放的数字内容来源认证标准,2022年1月首次发布,目前的最新版本是Content Credentials 2.3,实际应用成员和关联组织已超6000个。作为一项认证技术,C2PA把来源、编辑历史、生成工具等信息写进可验证的元数据凭证,并用数字签名保护完整性。
尽管OpenAI并未放弃后验式检测技术开发,但从撤下后验分类器到加入C2PA,并非是简单的产品替代,很大程度上体现出了OpenAI的内容识别从“后验概率判断”向“生成端主动标记与来源认证”的技术路线转变。
今年5月19日,OpenAI把SynthID加入ChatGPT、Codex 和 OpenAI API生成的图像中。SynthID不是图片边角的Logo,而是嵌入图像本身的不可见信号。7月31日,OpenAI在其生成音频中也开始加入SynthID水印。C2PA 和SynthID水印都需要生成方或编辑工具预先参与,但两者也有很大区别, C2PA标准主要依赖外附的签名元数据,水印则把信号嵌入内容本体。紧随其后,8月14日, Anthropic宣布,新Claude模型开始在生成文本中加入SynthID水印。
也就是说,从2026年至今,AI水印开始结合C2PA及其Content Credentials 等内容溯源机制进行运作。 C2PA 加 SynthID 水印,是一种更清晰的双层来源验证体系,而前验式AI检测,也正式开始走向跨公司、跨平台的溯源体系。
以上简要梳理了AI水印这一前置标记检测的发展概况。事实上,除了水印,前置标记检测技术还包括密码学签名、生成日志、远程证明(attestation)等。为更有效解析“前置标记检测技术仍构成认识论悖论”这一观点,我将选择分析两项有代表性的AI水印技术底层逻辑——Green–Red List水印和Tournament Sampling(锦标赛采样)方法,这是AI 文本水印(Text Watermarking)领域前后交替、互为改良的两代核心技术方法,后者是为了解决前者会破坏大模型文本质量这一核心痛点而研发出的高阶、几乎无损采样的替代方案。在详细理解这两项技术之前,有必要先大致理解下AI水印的底层数学原理。
如果说传统水印是后期“缝合”上去的,而AI水印是“生而自带”的,AI水印技术把一个可检测的统计信号主动嵌入生成过程,所以,数学上它是一个与密码学结合的概率分布问题,其本质可以概括为:在尽量不改变内容感知质量的前提下,把原始生成分布P0轻微改造成带有密钥相关结构的分布Pk,然后通过统计假设检验判断检测内容更可能来自P0还是Pk。 这是AI水印与 Pangram、 GPTZero 等后验 AI检测技术最根本的区别。
本文聚焦的是AI文本检测,但无论是文本还是图像、音频、视频,其底层的数学框架都是“生成→嵌入水印→统计检测”。
假设:原始生成内容x、秘密水印密钥k、需要嵌入的信息如模型ID、用户ID或“这是AI生成的”字样比特等、水印嵌入算法Ek、带水印内容y=E_k(x,m)、水印检测器D_k(y),检测实际上是在做两个假设之间的判断:H_0: y∼P_0(表示没有水印)和H_1: y∼P_k(表示存在由密钥 k产生的水印)。理论上最理想的检测器是似然比检验:,如果Λ(y)>τ,判定存在水印。τ是阈值。
所以,从统计学角度,AI水印首先不是一个“分类问题”,而是一个带有已知生成机制的假设检验问题,而它真正依赖的是一个“微小累积”的统计偏差,而不是单个token所产生的过于微弱的偏差。单独观察一次,P_k(x)≈P_0(x),几乎看不出来区别,但经过很多 token,x_1,x_2,…,x_T,这些微弱偏差会累积。如果每一步贡献一个微小统计信号s_t,那么总体检测统计量可以写成:Sₜ = ∑ₜ₌₁ᵀ sₜ。没有水印时E[S_T|H_0]=μ_0T,有水印时E[S_T|H_1]=μ_1T,其中μ_1>μ_0,而随机波动通常只以O(√(T))增长,因此信噪比大致随着√(T)提高。可见,AI水印确实不是在某一个词、某一个像素中藏一个明显标记,而是在大量微小选择中制造统计偏差,再让偏差累积成为证据。这就解释了为什么文本越长、图像冗余越大,通常越容易检测。
正常大模型在生成token时,实际输出的通常是一组logits,经过softmax得到词表中每一个token的概率,然后模型从这个概率分布中采样,而带水印的模型则会在采样之前动一点点手脚。以下开始详解两个案例,以呈现水印模型是如何动手脚的。
我们首先来看2023 年 Kirchenbauer 等人提出的Green–Red List 水印方案。它的核心思想是每生成一个 token,就秘密地把下一步词表随机分成“绿色 token”和“红色 token”,然后略微提高绿token被选中的概率。假设词表V={v_1,v_2,…,v_N},使用密钥k和前文 token计算r_t=H(k,x_(t-h),…,x_(t-1)),H可理解为带密钥的伪随机函数,然后利用r_t把词表随机分为:G_t∪R_t=V,其中|G_t|=γ|V|,比如γ=0.5意味着一半 token是绿色集合。假设原始logits为l_t(v),对于绿色token,v∈G_t,加入一个很小的偏置δ>0,即l~_t(v)=l_t(v)+δ 1(v∈G_t),然后重新softmax。δ 1是指示函数,意思是如果v属于green list,就给它的 logit 加上δ,如果属于red list,就不加。
这就是水印真正发生的地方。Kirchenbauer 等人相关论文中的软水印(soft watermark)正是通过给绿色列表token的logits增加δ来实现的。当然,普通读者不会知道哪些词属于绿色,只有掌握密码检测器k才能重新计算每一步的绿色集合。顺便说下,水印检验一般采用z-score检验。
只是,如果不掌握k,并不意味就不存在反水印技术。密钥提高的是攻击门槛,攻击者未必一定需要破解k。他可以做密钥无关攻击,例如改写、翻译、删改、重新生成等,使原有的统计相关性被削弱。对文本水印来说,这一点尤其重要,因为水印往往依赖具体token序列,一旦序列被显著改写,原来的统计信号可能衰减。
以Green–Red List 水印为例,某一步的绿色集合由G_t=F(k,x_(t-h),…,x_(t-1))决定,如果攻击者把前文中的一个 token 改掉,那么新的上下文变成x'_(t-h),…,x'_(t-1),于是检测器重新计算出的G'_t可能就和原来的G_t不一样。也就是说,一次修改不仅影响当前token,还可能影响后续若干步的绿色集合。无论是改写、翻译再译回、用另一模型重写、局部替换等,本质都一样,即便不破解水印规则,也可以通过重写内容来破坏水印所依赖的统计结构。
较文本水印,图像水印通常依赖连续、高维、冗余的信号空间:X ∈ ℝᴴ×ᵂ×ᶜ,同一视觉内容可以容纳大量微小变化。水印可以分散到很多像素、频率成分或 latent 特征中。当然这不是说图像水印不可攻击,而是说从信号结构上看,图像通常比文本拥有更大的鲁棒水印空间。
接下来要介绍的Tournament Sampling,正是8月Anthropic新发布Claude模型采用的SynthID水印的采样方式。顾名思义,Tournament Sampling意味着这种采样技术类似锦标赛,它采用了淘汰制的筛选方式。
如前所述,在文本水印中,当模型预测下一个Token 时,Green–Red List这类传统方法通常利用前文token与密钥k共同生成一个伪随机种子,再据此通过伪随机函数将词表划分为“绿名单”和“红名单”两个集合,随后对绿名单内词汇的 Logits施加正向偏置(Bias),强制模型更倾向于选择绿名单内的词。这种方法劣势比较明显,其一,强行给某些词加偏置,会打乱大模型原本合理的条件概率分布,导致生成的文本有可能变得生硬、不自然;其二,当攻击者对文本进行微小改动时,原本的绿红名单相关性容易被破坏进而导致水印失效。
Tournament Sampling比Green–Red List高明之处主要在于它更少扰动原始分布,能更好地平衡水印检测的鲁棒性与生成文本质量。它不给任何词汇的Logits直接加偏置,而是在不破坏原始Logits概率分布的前提下,通过多轮“两两对决”机制,筛选出既符合大模型原本预测概率又携带水印特征的 Token。
为说清Tournament Sampling的运作流程,以下将其分为四个步骤细述:
一,候选Token的采样与配对。 当大模型预测下一个 Token 时,首先得到原始模型的分布p_LM(·|x_(<t)),随后进入Tournament Sampling,也就是按照这一原始分布独立抽取若干候选Token,抽多抽少由提前设定的淘汰赛轮数m这个超参数以及每场比赛的侯选数N决定,一般为N^m,可以用M表示。比如两两对决,就抽取2^m个候选Token,M=2^m。由于是独立采样,同一Token可被重复抽中。随后这些候选Token被随机两两配对,进入第一轮淘汰赛。
二,秘密水印评分。与 Green–Red List 类似,Tournament Sampling 也需要根据当前上下文x_(<t)与密钥k生成当前步骤的伪随机种子r_t=f_r(x_(<t),k)。系统随后利用r_t和一组对应不同轮次的伪随机水印函数g_1,…,g_m,为候选Token生成秘密的g-value。原模型概率p_LM决定各Token 被抽入候选池的概率,而g-value则决定已经进入候选池的Token在各轮淘汰赛中的胜负。换言之,原模型概率使候选采样仍然受到原始语言分布的约束,而水印函数则通过使最终输出Token 持续偏向于当前秘密随机种子下评分较高的候选,从而在整个文本中形成可被检测器重建和统计检验的水印偏差。
三,多轮淘汰。第一轮中,每对Token根据g_1的评分决定胜者,获胜者重新配对,并在第二轮根据g_2决定胜负,如此逐层进行,评分相同则随机决定胜者。在两两对决下,经过m=log_2(M)轮后,从最初的2^m个候选中产生唯一的最终Token,并作为当前生成结果输出。
四,统计检测。检测阶段不需要恢复当时的全部候选 Token,也无需重新运行语言模型。检测器利用相同的密钥和观测文本重新生成每一步的r_t,计算实际输出Token对应的各层g-value,并考察整个文本中这些评分是否显著高于无水印情况下的随机基线。由于Tournament Sampling在生成阶段持续偏向较高g-value的Token,带水印文本会形成与不同轮次的g函数相关的统计偏差,检测器据此进行概率性水印判定。
无论是Green-Red List还是Tournament Sampling,水印问的不是“这段文本看起来像不像AI?”而是主动规定:只要是AI生成的,就让它携带一个人类正常生成过程中不存在的信号。后验检测存在的问题是:随着LLM所生成文本越来越接近人的语言,人机之间可检测的统计差异不断缩小。水印则改变了这一点,它不再等待AI自然留下特征,而是主动制造可检测的信号W。例如 Tournament Sampling 主动让g(x_t,r_t)在整段文本中呈现异常偏高的统计结构。
这实际上承认了一个很重要的事实——当AI与人的自然输出越发不可区分时,可区分性只能通过人为制造。但无可否认,AI水印虽是“前置植入”, “检测”本身仍然发生在生成之后,它仍然是在依据一个可观察信号,反推一个不可直接观察的生成历史。如此操作,认识论悖论问题并没有消失。作为一项前置标记验证,水印在绕开后验检测问题的同时,带来的是更深层的问题。
后验检测隐含的假设是AI文本本身存在某种“AI性”,水印放弃了这个假设,它的假设是内容本身未必能告诉你它是不是AI,你必须知道它从哪里来。于是,如何界定“人性”开始变得吊诡。
如果AI必须携带水印,那么实践中很容易形成“有水印就意味AI,无水印意味非AI”这样的观念。这就变成了只能通过“没有机器身份标记”来定义人的作品。说得惊悚些,人似乎成了未被机器认证系统标记的残留物。这样的AI检测路径,是在迫使人类通过机器建立的分类体系来证明自己是人。
还有一个至关重要的问题,水印只是把悖论从“认识问题”转化成了“制度问题”。如果添加水印与否是可选择的,那么就存在无水印模型、删除水印、改写和转译等各种规避现象,于是后验检测的困难重新回来。如果要真正解决这一问题,就必须使水印技术变成普遍、强制、标准化、不可轻易移除。问题接踵而至,谁负责编码?谁掌握密钥?谁拥有验证权?……技术问题最终变成了边界治理问题。
这意味着AI检测的终极问题不是“我们如何识别机器特质”,而是当机器越来越像人时,我们为什么仍然需要、又凭什么能够维持一条人机边界。
最后总结:AI检测表面区分“人写”与“机写”,深层暴露出AI技术自身结构性悖论:AI越努力逼近人的语言、行为与创造,人与机器在可观察特征上的边界就越模糊;检测技术越试图重新划清这条边界,越可能反过来把机器能够识别的“人类特征”转化为人需要遵循的规范。AI检测的悖论是AI技术自身悖论的一面认识论镜像:AI不断学习成为更像人的机器,人为了证明自己不是机器,反倒被迫把自己塑造成机器所定义的“人”。
问题终究只有一个——“我们该如何定义自身?”
部分参考文献
1. Is This What Comes After AI Slop? https://www.theatlantic.com/technology/2026/07/daggermouth-novel-bestseller-ai/688067/
2. GLTR: Statistical Detection and Visualization of Generated Text https://arxiv.org/abs/1906.04043
3. Defending Against Neural Fake News, https://arxiv.org/abs/1905.12616)
4. Perplexity, burstiness, and statistical AI detection https://gptzero.me/news/perplexity-and-burstiness-what-is-it/
5.Inside GPTZero AI Detectionhttps://gptzero.substack.com/p/inside-gptzero-ai-detection
6. 'Your AI Text is not Mine': Redefining and Evaluating AI-generated Text Detection under Realistic Assumptions https://arxiv.org/abs/2606.04906
7. Inference in an Authorship Problemhttps://www.jstor.org/stable/2283270
8. Pangram 4 Technical Reporthttps://www.alphaxiv.org/abs/2607.pangram-4